
Modelos e plataformas de IA
Dentro do o3 e o4-mini da OpenAI: Desbloqueando Novas Possibilidades por meio do Raciocínio Multimodal e Conjuntos de Ferramentas Integrados

 Adicione Unite.AI às suas fontes preferidas no Google
Em 16 de abril de 2025, a OpenAI lançou versões atualizadas de seus modelos de raciocínio avançado. Esses novos modelos, nomeados o3 e o4-mini, oferecem melhorias em relação aos seus antecessores, o1 e o3-mini, respectivamente. Os modelos mais recentes entregam desempenho aprimorado, novos recursos e maior acessibilidade. Este artigo explora os principais benefícios do o3 e o4-mini, descreve suas principais capacidades e discute como eles podem influenciar o futuro das aplicações de IA. Mas antes de mergulharmos no que torna o3 e o4-mini distintos, é importante entender como os modelos da OpenAI evoluíram ao longo do tempo. Vamos começar com uma visão geral breve da jornada da OpenAI no desenvolvimento de sistemas de linguagem e raciocínio cada vez mais poderosos.
Evolução dos Modelos de Linguagem Grande da OpenAI
O desenvolvimento de modelos de linguagem grande da OpenAI começou com GPT-2 e GPT-3, que trouxeram o ChatGPT para o uso mainstream devido à sua capacidade de produzir texto fluente e contextualmente preciso. Esses modelos foram amplamente adotados para tarefas como resumo, tradução e resposta a perguntas. No entanto, à medida que os usuários os aplicavam a cenários mais complexos, suas limitações se tornaram claras. Esses modelos frequentemente lutavam com tarefas que exigiam raciocínio profundo, consistência lógica e resolução de problemas em várias etapas. Para enfrentar esses desafios, a OpenAI introduziu GPT-4 e mudou seu foco para aprimorar as capacidades de raciocínio de seus modelos. Essa mudança levou ao desenvolvimento de o1 e o3-mini. Ambos os modelos usavam um método chamado chain-of-thought prompting, que lhes permitia gerar respostas mais lógicas e precisas raciocinando passo a passo. Enquanto o o1 é projetado para atender às necessidades de resolução de problemas avançados, o o3-mini é construído para entregar capacidades semelhantes de forma mais eficiente e econômica. Com base nessa fundação, a OpenAI agora introduziu o3 e o4-mini, que aprimoram ainda mais as capacidades de raciocínio de seus LLMs. Esses modelos são projetados para produzir respostas mais precisas e bem consideradas, especialmente em campos técnicos como programação, matemática e análise científica — domínios onde a precisão lógica é crítica. Na seção seguinte, examinaremos como o3 e o4-mini melhoram seus antecessores.
Principais Avanços em o3 e o4-mini
Capacidades de Raciocínio Aprimoradas
Uma das principais melhorias em o3 e o4-mini é sua capacidade de raciocínio aprimorada para tarefas complexas. Ao contrário dos modelos anteriores que entregavam respostas rápidas, os modelos o3 e o4-mini levam mais tempo para processar cada prompt. Esse processamento adicional permite que eles raciocinem de forma mais aprofundada e produzam respostas mais precisas, levando a melhorias nos resultados dos benchmarks. Por exemplo, o o3 supera o1 por 9% no LiveBench.ai, um benchmark que avalia o desempenho em tarefas complexas como lógica, matemática e código. No SWE-bench, que testa o raciocínio em tarefas de engenharia de software, o o3 alcançou uma pontuação de 69,1%, superando até mesmo modelos competitivos como Gemini 2.5 Pro, que marcou 63,8%. Enquanto isso, o o4-mini marcou 68,1% no mesmo benchmark, oferecendo quase a mesma profundidade de raciocínio a um custo muito menor.
Integração Multimodal: Pensando com Imagens
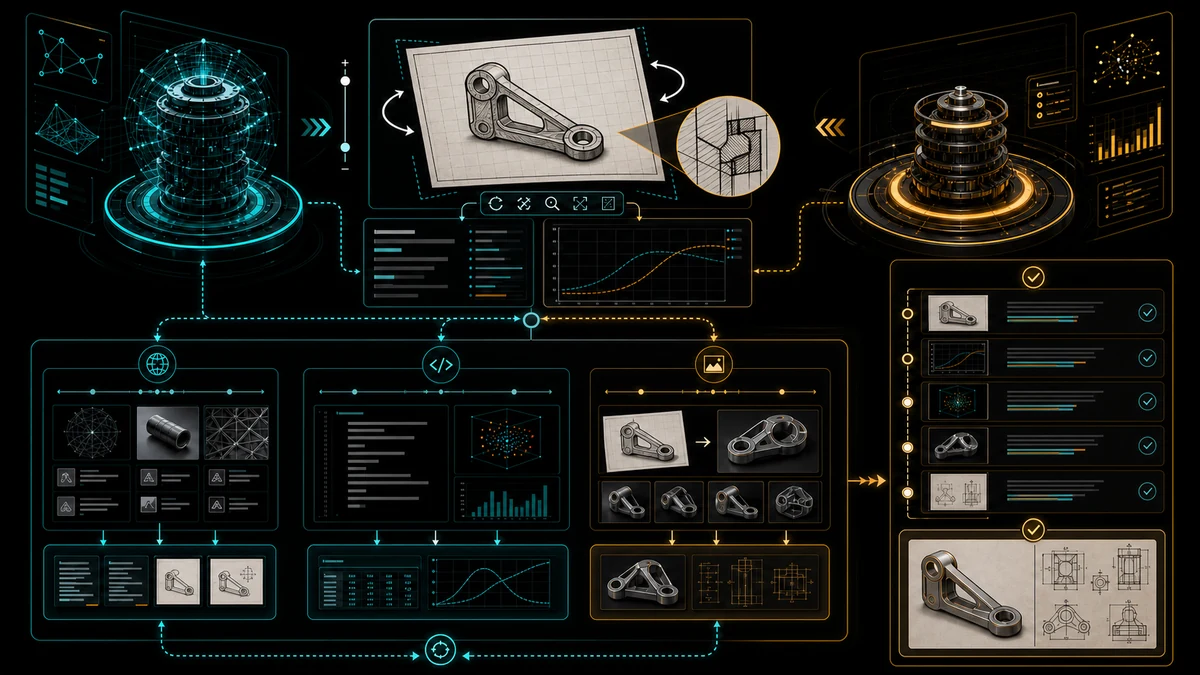
Uma das funcionalidades mais inovadoras do o3 e o4-mini é sua capacidade de “pensar com imagens”. Isso significa que eles não apenas processam informações textuais, mas também integram dados visuais diretamente em seu processo de raciocínio. Eles podem entender e analisar imagens, mesmo que sejam de baixa qualidade — como anotações manuscritas, esboços ou diagramas. Por exemplo, um usuário poderia carregar um diagrama de um sistema complexo, e o modelo poderia analisá-lo, identificar possíveis problemas ou até sugerir melhorias. Essa capacidade fecha a lacuna entre dados textuais e visuais, permitindo interações mais intuitivas e abrangentes com a IA. Ambos os modelos podem realizar ações como zoom em detalhes ou girar imagens para entendê-las melhor. Esse raciocínio multimodal é um avanço significativo sobre os antecessores, como o o1, que eram principalmente baseados em texto. Isso abre novas possibilidades para aplicações em campos como educação, onde auxílios visuais são cruciais, e pesquisa, onde diagramas e gráficos são frequentemente centrais para a compreensão.
Uso Avançado de Ferramentas
O o3 e o4-mini são os primeiros modelos da OpenAI a usar todas as ferramentas disponíveis no ChatGPT simultaneamente. Essas ferramentas incluem:
- Navegação na web: Permitindo que os modelos obtenham as informações mais recentes para consultas sensíveis ao tempo.
- Execução de código Python: Habilitando-os a realizar cálculos complexos ou análise de dados.
- Processamento e geração de imagens: Aprimorando sua capacidade de trabalhar com dados visuais.
Ao empregar essas ferramentas, o o3 e o4-mini podem resolver problemas complexos e multietapas de forma mais eficaz. Por exemplo, se um usuário fizer uma pergunta que exige dados atuais, o modelo pode realizar uma busca na web para recuperar as informações mais recentes. Da mesma forma, para tarefas que envolvem análise de dados, ele pode executar código Python para processar os dados. Essa integração é um passo significativo em direção a agentes de IA mais autônomos que possam lidar com uma gama mais ampla de tarefas sem intervenção humana. A introdução do Codex CLI, um agente de codificação leve e de código aberto que funciona com o o3 e o4-mini, melhora ainda mais sua utilidade para desenvolvedores.
Implicações e Novas Possibilidades
O lançamento do o3 e o4-mini tem implicações generalizadas em várias indústrias:
- Educação: Esses modelos podem ajudar estudantes e professores fornecendo explicações detalhadas e auxílios visuais, tornando o aprendizado mais interativo e eficaz. Por exemplo, um estudante poderia carregar um esboço de um problema de matemática, e o modelo poderia fornecer uma solução passo a passo.
- Pesquisa: Eles podem acelerar a descoberta analisando conjuntos de dados complexos, gerando hipóteses e interpretando dados visuais como gráficos e diagramas, o que é inestimável para campos como física ou biologia.
- Indústria: Eles podem otimizar processos, melhorar a tomada de decisões e aprimorar as interações com os clientes lidando com consultas tanto textuais quanto visuais, como analisar projetos de produtos ou solucionar problemas técnicos.
- Criatividade e Mídia: Autores podem usar esses modelos para transformar esboços de capítulos em storyboards simples. Músicos podem combinar visuais com uma melodia. Editores de filme recebem sugestões de ritmo. Arquitetos convertem plantas de andar manuscritas em plantas 3D detalhadas que incluem notas estruturais e de sustentabilidade.
- Acessibilidade e Inclusão: Para usuários cegos, os modelos descrevem imagens em detalhes. Para usuários surdos, eles convertem diagramas em sequências visuais ou texto legendado. Sua tradução de palavras e visuais ajuda a fechar lacunas linguísticas e culturais.
- Em Direção a Agentes Autônomos: Como os modelos podem navegar na web, executar código e processar imagens em um fluxo de trabalho, eles formam a base para agentes autônomos. Desenvolvedores descrevem uma funcionalidade; o modelo escreve, testa e implanta o código. Trabalhadores do conhecimento podem delegar a coleta de dados, análise, visualização e redação de relatórios a um único assistente de IA.
Limitações e O Que Vem a Seguir
Apesar desses avanços, o o3 e o4-mini ainda têm um corte de conhecimento de agosto de 2023, o que limita sua capacidade de responder aos eventos ou tecnologias mais recentes, a menos que suplementados pela navegação na web. Iterações futuras provavelmente abordarão essa lacuna melhorando a ingestão de dados em tempo real.
Também podemos esperar mais progresso em agentes de IA autônomos — sistemas que podem planejar, raciocinar, agir e aprender continuamente com supervisão mínima. A integração da OpenAI de ferramentas, modelos de raciocínio e acesso a dados em tempo real sinaliza que estamos nos aproximando de tais sistemas.
O Resumo
Os novos modelos da OpenAI, o3 e o4-mini, oferecem melhorias em raciocínio, compreensão multimodal e integração de ferramentas. Eles são mais precisos, versáteis e úteis em uma ampla gama de tarefas — desde analisar dados complexos e gerar código até interpretar imagens. Esses avanços têm o potencial de melhorar significativamente a produtividade e acelerar a inovação em várias indústrias.





