
Modelos e plataformas de IA
O GPT-4o da OpenAI: O Modelo de IA Multimodal que Está Revolucionando a Interação Humano-Máquina

 Adicione Unite.AI às suas fontes preferidas no Google

Pontos-chaveO GPT-4o combina nativamente texto, áudio e visão em um único modelo pela primeira vez.
Ver mais
- O GPT-4o combina nativamente texto, áudio e visão em um único modelo pela primeira vez.
- O GPT-4o detecta sinais emocionais e ajusta seu tom para responder com empatia.
- A OpenAI oferece gratuitamente a todos os usuários as capacidades centrais do GPT-4o.
A OpenAI lançou seu mais recente e avançado modelo de linguagem – o GPT-4o, também conhecido como o modelo “Omni“. Este sistema de IA revolucionário representa um grande salto para frente, com capacidades que desfiam a linha entre inteligência humana e artificial.
No coração do GPT-4o está sua natureza multimodal nativa, que permite processar e gerar conteúdo de forma transparente em texto, áudio, imagens e vídeo. Essa integração de múltiplas modalidades em um único modelo é inédita e promete redefinir como interagimos com assistentes de IA.
Mas o GPT-4o é muito mais do que apenas um sistema multimodal. Ele apresenta uma melhoria impressionante no desempenho em relação ao seu antecessor, o GPT-4, e deixa modelos concorrentes como o Gemini 1.5 Pro, Claude 3 e Llama 3-70B para trás. Vamos explorar mais a fundo o que torna este modelo de IA verdadeiramente inovador.
Desempenho e Eficiência Sem Precedentes
Um dos aspectos mais impressionantes do GPT-4o é sua capacidade de desempenho sem precedentes. De acordo com as avaliações da OpenAI, o modelo tem uma vantagem notável de 60 pontos Elo sobre o anterior líder, o GPT-4 Turbo. Essa vantagem significativa coloca o GPT-4o em uma liga própria, superando até mesmo os modelos de IA mais avançados atualmente disponíveis.
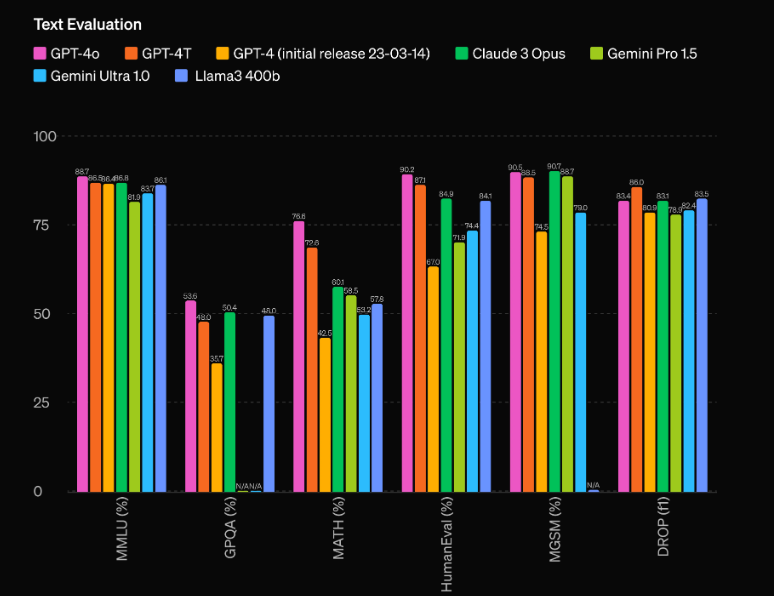
Mas o desempenho bruto não é a única área onde o GPT-4o brilha. O modelo também apresenta uma eficiência impressionante, operando com o dobro da velocidade do GPT-4 Turbo, enquanto custa apenas metade para executar. Essa combinação de desempenho superior e eficiência em termos de custo torna o GPT-4o uma proposta extremamente atraente para desenvolvedores e empresas que buscam integrar capacidades de IA de ponta em seus aplicativos.
Capacidades Multimodais: Mesclando Texto, Áudio e Visão
Talvez o aspecto mais inovador do GPT-4o seja sua natureza multimodal nativa, que permite processar e gerar conteúdo de forma transparente em múltiplas modalidades, incluindo texto, áudio e visão. Essa integração de múltiplas modalidades em um único modelo é inédita e promete revolucionar como interagimos com assistentes de IA.
Com o GPT-4o, os usuários podem se engajar em conversas naturais e em tempo real usando voz, com o modelo reconhecendo e respondendo instantaneamente a entradas de áudio. Mas as capacidades não param por aí – o GPT-4o também pode interpretar e gerar conteúdo visual, abrindo um mundo de possibilidades para aplicações que variam desde análise e geração de imagens até compreensão e criação de vídeo.
Uma das demonstrações mais impressionantes das capacidades multimodais do GPT-4o é sua capacidade de analisar uma cena ou imagem em tempo real, descrevendo e interpretando com precisão os elementos visuais que percebe. Essa funcionalidade tem implicações profundas para aplicações como tecnologias assistivas para pessoas com deficiência visual, bem como em campos como segurança, vigilância e automação.
Mas as capacidades multimodais do GPT-4o vão além de apenas entender e gerar conteúdo em diferentes modalidades. O modelo também pode mesclar essas modalidades de forma transparente, criando experiências verdadeiramente imersivas e envolventes. Por exemplo, durante a demonstração ao vivo da OpenAI, o GPT-4o foi capaz de gerar uma música com base em condições de entrada, mesclando sua compreensão de linguagem, teoria musical e geração de áudio em uma saída coesa e impressionante.
Usando o GPT0 com Python
[código language=”Python”]
import openai
# Substitua com sua chave de API real
OPENAI_API_KEY = “sua_chave_de_api_openai_aqui”
# Função para extrair o conteúdo da resposta
def get_response_content(response_dict, exclude_tokens=None):
if exclude_tokens is None:
exclude_tokens = []
if response_dict and response_dict.get(“choices”) and len(response_dict[“choices”]) > 0:
content = response_dict[“choices”][0][“message”][“content”].strip()
if content:
for token in exclude_tokens:
content = content.replace(token, ”)
return content
raise ValueError(f”Não foi possível resolver a resposta: {response_dict}”)
# Função assíncrona para enviar uma solicitação à API de bate-papo da OpenAI
async def send_openai_chat_request(prompt, model_name, temperature=0.0):
openai.api_key = OPENAI_API_KEY
message = {“role”: “user”, “content”: prompt}
response = await openai.ChatCompletion.acreate(
model=model_name,
messages=[message],
temperature=temperature,
)
return get_response_content(response)
# Exemplo de uso
async def main():
prompt = “Olá!”
model_name = “gpt-4o-2024-05-13”
response = await send_openai_chat_request(prompt, model_name)
print(response)
if __name__ == “__main__”:
import asyncio
asyncio.run(main())
[/código]
Eu tenho:
- Importado o módulo openai diretamente em vez de usar uma classe personalizada.
- Renomeado a função openai_chat_resolve para get_response_content e feito algumas alterações menores na sua implementação.
- Substituído a classe AsyncOpenAI pela função openai.ChatCompletion.acreate, que é o método assíncrono oficial fornecido pela biblioteca Python da OpenAI.
- Adicionei um exemplo de função main que demonstra como usar a função send_openai_chat_request.
Observe que você precisa substituir “sua_chave_de_api_openai_aqui” com sua chave de API real da OpenAI para que o código funcione corretamente.


