
Ângulo de Anderson
Um Avanço Notável em Vídeo de IA Dirigido por Humanos

 Adicione Unite.AI às suas fontes preferidas no Google
Nota: A página do projeto para este trabalho inclui 33 vídeos de alta resolução que se reproduzem automaticamente, totalizando meio gigabyte, o que destabilizou meu sistema ao carregar. Por esse motivo, não vou linkar diretamente para ele. Os leitores podem encontrar o URL no resumo do artigo ou no PDF, se assim o desejarem.
Um dos principais objetivos da pesquisa atual em síntese de vídeo é gerar um desempenho de vídeo completo dirigido por IA a partir de uma única imagem. Esta semana, um novo artigo da Bytedance Intelligent Creation delineou o que pode ser o sistema mais abrangente desse tipo até agora, capaz de produzir animações de corpo inteiro e semi-corpo que combinam detalhes faciais expressivos com movimento em grande escala preciso, além de alcançar uma melhor consistência de identidade – uma área em que mesmo os sistemas comerciais líderes muitas vezes falham.
No exemplo abaixo, vemos um desempenho dirigido por um ator (canto superior esquerdo) e derivado de uma única imagem (canto superior direito), que fornece uma renderização notavelmente flexível e ágil, sem os problemas comuns de criar movimentos grandes ou “adivinhar” sobre áreas ocultas (ou seja, partes de roupas e ângulos faciais que devem ser inferidos ou inventados porque não estão visíveis na foto de origem):
CONTÉUDO DE ÁUDIO. Clique para reproduzir. Um desempenho é criado a partir de duas fontes, incluindo sincronização labial, que normalmente é o domínio de sistemas auxiliares dedicados. Esta é uma versão reduzida do site de origem (ver nota no início do artigo – se aplica a todos os outros vídeos incorporados aqui).
Embora possamos ver alguns desafios residuais relacionados à persistência da identidade à medida que cada clipe avança, este é o primeiro sistema que eu vi que se sai bem em manter a identidade geralmente (embora não sempre) durante um período prolongado sem o uso de LoRAs:
CONTÉUDO DE ÁUDIO. Clique para reproduzir. Mais exemplos do projeto DreamActor.
O novo sistema, intitulado DreamActor, usa um sistema de controle híbrido de três partes que dá atenção dedicada à expressão facial, rotação da cabeça e design do esqueleto central, acomodando desempenhos dirigidos por IA onde nem o aspecto facial nem o corporal sofrem em detrimento do outro – uma capacidade rara, possivelmente desconhecida entre sistemas semelhantes.
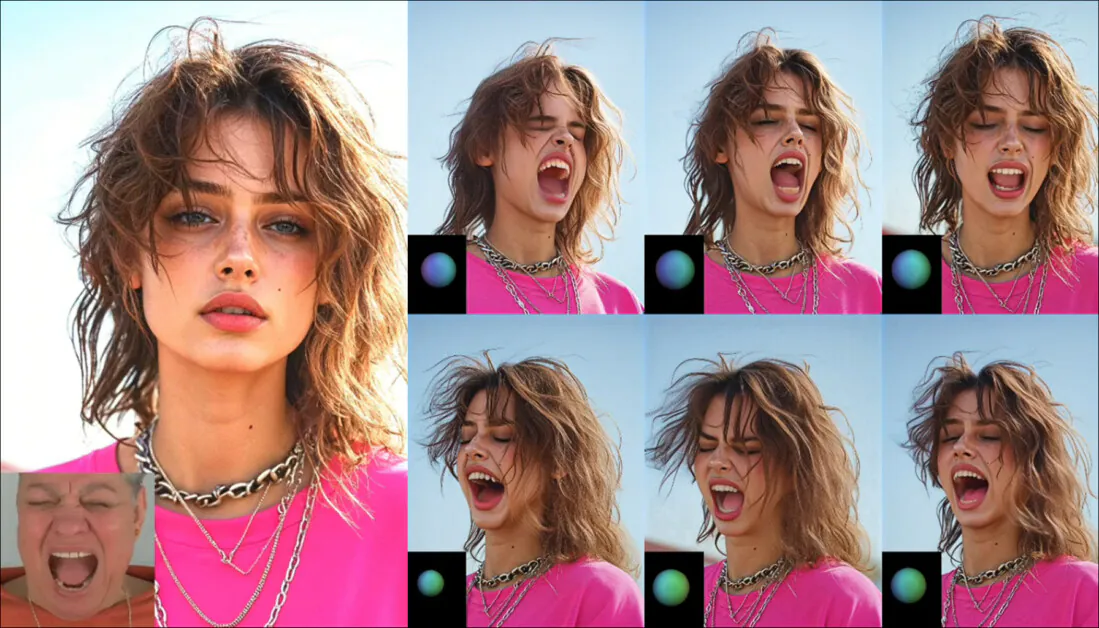
Abaixo, vemos uma dessas facetas, rotação da cabeça, em ação. A bola colorida no canto de cada miniatura à direita indica uma espécie de gimbal virtual que define a orientação da cabeça independentemente do movimento e expressão facial, que aqui é impulsionada por um ator (baixo à esquerda).
Clique para reproduzir. A bola multicolorida visualizada aqui representa o eixo de rotação da cabeça do avatar, enquanto a expressão é alimentada por um módulo separado e informada pelo desempenho de um ator (visto aqui embaixo à esquerda).
Uma das funcionalidades mais interessantes do projeto, que nem sequer está incluída adequadamente nos testes do artigo, é sua capacidade de derivar movimento de sincronização labial diretamente do áudio – uma capacidade que funciona de forma incomum, mesmo sem um ator de vídeo como guia.
Os pesquisadores enfrentaram os principais concorrentes nessa busca, incluindo o muito elogiado Runway Act-One e LivePortrait, e relatam que o DreamActor foi capaz de alcançar melhores resultados quantitativos.
Desde que os pesquisadores podem estabelecer seus próprios critérios, os resultados quantitativos não são necessariamente um padrão empírico; mas os testes qualitativos acompanhantes parecem apoiar as conclusões dos autores.
Infelizmente, este sistema não é destinado a ser liberado publicamente, e o único valor que a comunidade pode potencialmente derivar do trabalho está em possivelmente reproduzir as metodologias delineadas no artigo (como foi feito com efeito notável para o igualmente fechado Google Dreambooth em 2022 ).
O artigo afirma*:
‘A animação de imagem humana tem riscos sociais possíveis, como ser usada para criar vídeos falsos. A tecnologia proposta pode ser usada para criar vídeos falsos de pessoas, mas as ferramentas de detecção existentes [Demamba, Dormant] podem detectar esses falsos.
‘Para reduzir esses riscos, regras éticas claras e diretrizes de uso responsáveis são necessárias. Vamos restringir estritamente o acesso aos nossos modelos e códigos principais para evitar mau uso.’
Naturalmente, considerações éticas desse tipo são convenientes do ponto de vista comercial, pois fornecem uma justificativa para o acesso apenas à API ao modelo, que pode então ser monetizado. A ByteDance já fez isso uma vez em 2025, tornando o muito elogiado OmniHuman disponível para créditos pagos no site Dreamina. Portanto, desde que o DreamActor seja possivelmente um produto ainda mais forte, isso parece ser o resultado provável. O que resta a ser visto é a extensão com que seus princípios, na medida em que são explicados no artigo, podem ajudar a comunidade de código aberto.
O novo artigo é intitulado DreamActor-M1: Animação de Imagem Humana Holística, Expressiva e Robusta com Orientação Híbrida, e vem de seis pesquisadores da Bytedance.
Método
O sistema DreamActor proposto no artigo visa gerar animação humana a partir de uma imagem de referência e um vídeo de direção, usando um Diffusion Transformer (DiT) adaptado para espaço latente (aparentemente algum sabor de Stable Diffusion, embora o artigo cite apenas a publicação de lançamento de 2022).
Ao invés de confiar em módulos externos para lidar com a condicionação de referência, os autores mesclam recursos de aparência e movimento diretamente dentro do backbone do DiT, permitindo interação através do espaço e do tempo por meio de atenção:

Esquema para o novo sistema: DreamActor codifica pose, movimento facial e aparência em latentes separados, combinando-os com latentes de vídeo ruidosos produzidos por um 3D VAE. Esses sinais são fundidos dentro de um Diffusion Transformer usando autoatenção e atenção cruzada, com pesos compartilhados entre os ramos. O modelo é supervisionado comparando saídas desruídas com latentes de vídeo limpos. Fonte: https://arxiv.org/pdf/2504.01724
Para fazer isso, o modelo usa um 3D variational autoencoder pré-treinado para codificar tanto o vídeo de entrada quanto a imagem de referência. Esses latentes são patchificados, concatenados e alimentados no DiT, que os processa conjuntamente.
Essa arquitetura se afasta da prática comum de anexar uma rede secundária para injeção de referência, que foi a abordagem para os projetos influentes Animate Anyone e Animate Anyone 2.
Em vez disso, o DreamActor constrói a fusão no próprio modelo, simplificando o design enquanto melhora o fluxo de informações entre as dicas de aparência e movimento. O modelo é então treinado usando correspondência de fluxo em vez do objetivo de difusão padrão (A correspondência de fluxo treina modelos de difusão prevendo diretamente campos de velocidade entre dados e ruído, pulando estimativa de pontuação).
Orientação de Movimento Híbrida
O método de Orientação de Movimento Híbrida que informa as renderizações neurais combina tokens de pose derivados de esqueletos de corpo 3D e esferas de cabeça; representações faciais implícitas extraídas por um codificador de face pré-treinado; e tokens de aparência de referência amostrados da imagem de origem.
Esses elementos são integrados dentro do Diffusion Transformer usando mecanismos de atenção distintos, permitindo que o sistema coordene movimento global, expressão facial e identidade visual ao longo do processo de geração.
Para o primeiro desses, em vez de confiar em marcos faciais, o DreamActor usa representações faciais implícitas para guiar a geração de expressão, aparentemente permitindo um controle mais fino sobre a dinâmica facial enquanto desacopla identidade e pose da cabeça da expressão.
Para criar essas representações, a pipeline primeiro detecta e recorta a região da face em cada quadro do vídeo de direção, redimensionando-a para 224×224. As faces recortadas são processadas por um codificador de movimento facial pré-treinado no conjunto de dados PD-FGC, que é então condicionado por uma camada MLP.

PD-FGC, empregado no DreamActor, gera uma cabeça que fala a partir de uma imagem de referência com controle desacoplado de sincronização labial (do áudio), pose da cabeça, movimento dos olhos e expressão (de vídeos separados), permitindo manipulação precisa e independente de cada um. Fonte: https://arxiv.org/pdf/2211.14506
O resultado é uma sequência de tokens de movimento facial, que são injetados no Diffusion Transformer por meio de uma camada de atenção cruzada.
O mesmo framework também suporta uma variante impulsionada por áudio, na qual um codificador separado é treinado que mapeia entrada de fala diretamente para tokens de movimento facial. Isso torna possível gerar animação facial sincronizada – incluindo movimentos labiais – sem um vídeo de direção.
CONTÉUDO DE ÁUDIO. Clique para reproduzir. Sincronização labial derivada puramente do áudio, sem um vídeo de ator como guia. A única entrada de personagem é a foto estática vista no canto superior direito.
Em segundo lugar, para controlar a pose da cabeça independentemente da expressão facial, o sistema introduz uma representação de esfera de cabeça 3D (veja o vídeo incorporado anteriormente neste artigo), que desacopla a dinâmica facial do movimento global da cabeça, melhorando a precisão e flexibilidade durante a animação.
As esferas de cabeça são geradas extraíndo parâmetros faciais 3D – como rotação e pose da câmera – do vídeo de direção usando o método de rastreamento FaceVerse.

Esquema para o projeto FaceVerse. Fonte: https://www.liuyebin.com/faceverse/faceverse.html
Esses parâmetros são usados para renderizar uma esfera colorida projetada no plano de imagem 2D, alinhada espacialmente com a cabeça de direção. O tamanho da esfera corresponde à cabeça de referência, e sua cor reflete a orientação da cabeça. Essa abstração reduz a complexidade de aprender o movimento da cabeça 3D, ajudando a preservar formas de cabeça estilizadas ou exageradas em personagens desenhados a partir de animação.

Visualização da esfera de controle influenciando a orientação da cabeça.
Finalmente, para guiar o movimento corporal, o sistema usa esqueletos de corpo 3D com normalização de comprimento de osso adaptativa. Parâmetros de corpo e mão são estimados usando 4DHumans e o focado em mão HaMeR, ambos operando no modelo de corpo SMPL-X.

SMPL-X aplica uma malha paramétrica sobre o corpo humano inteiro em uma imagem, alinhando com pose e expressão estimadas para permitir manipulação de pose usando a malha como guia volumétrica. Fonte: https://arxiv.org/pdf/1904.05866
A partir dessas saídas, juntas de articulações são selecionadas, projetadas em 2D e conectadas em mapas de esqueleto baseados em linhas. Diferentemente de métodos como Champ, que renderizam malhas de corpo inteiro, essa abordagem evita impor priors de forma pré-definidos, e ao confiar apenas na estrutura esquelética, o modelo é assim encorajado a inferir forma e aparência do corpo diretamente a partir das imagens de referência, reduzindo o viés em direção a tipos de corpo fixos e melhorando a generalização em uma variedade de poses e constituições.
Durante o treinamento, os esqueletos de corpo 3D são concatenados com esferas de cabeça e passados por um codificador de pose, que produz recursos que são então combinados com latentes de vídeo ruidosos para produzir os tokens de ruído usados pelo Diffusion Transformer.
No momento da inferência, o sistema leva em conta as diferenças esqueléticas entre os sujeitos normalizando os comprimentos dos ossos. O modelo de edição de imagem pré-treinado SeedEdit transforma tanto as imagens de referência quanto as de direção em uma configuração canônica padrão. RTMPose é então usado para extrair proporções esqueléticas, que são usadas para ajustar o esqueleto de direção para corresponder à anatomia do sujeito de referência.

Visão geral do pipeline de inferência. Referências pseudo podem ser geradas para enriquecer dicas de aparência, enquanto sinais de controle híbridos – movimento facial implícito e pose explícita de esferas de cabeça e esqueletos de corpo – são extraídos do vídeo de direção. Esses são então alimentados em um modelo DiT para produzir saída animada, com movimento facial desacoplado da pose do corpo, permitindo o uso de áudio como driver.
Orientação de Aparência
Para melhorar a fidelidade da aparência, particularmente em áreas ocultas ou raramente visíveis, o sistema complementa a imagem de referência principal com referências pseudo amostradas do vídeo de entrada.
Clique para reproduzir. O sistema antecipa a necessidade de renderizar regiões ocultas com precisão e consistência. Isso está tão próximo quanto eu vi, em um projeto desse tipo, de uma abordagem de textura de bitmap CGI.
Esses quadros adicionais são escolhidos por diversidade de pose usando RTMPose e filtrados usando similaridade baseada em CLIP para garantir que permaneçam consistentes com a identidade do sujeito.
Todas as imagens de referência (primárias e pseudo) são codificadas pelo mesmo codificador visual e fundidas por meio de um mecanismo de autoatenção, permitindo que o modelo acesse dicas de aparência complementares. Essa configuração melhora a cobertura de detalhes como vistas de perfil ou texturas de membros. Referências pseudo são sempre usadas durante o treinamento e opcionalmente durante a inferência.
Treinamento
O DreamActor foi treinado em três estágios para introduzir gradualmente a complexidade e melhorar a estabilidade.
No primeiro estágio, apenas esqueletos de corpo 3D e esferas de cabeça 3D foram usados como sinais de controle, excluindo representações faciais. Isso permitiu que o modelo de geração de vídeo base, inicializado a partir de MMDiT, se adaptasse à animação humana sem ser sobrecarregado por controles de granulação fina.
No segundo estágio, representações faciais implícitas foram adicionadas, mas todos os outros parâmetros congelados. Apenas o codificador de movimento facial e as camadas de atenção facial foram treinadas nesse ponto, permitindo que o modelo aprendesse detalhes expressivos em isolamento.
No terceiro e último estágio, todos os parâmetros foram descongelados para otimização conjunta através da aparência, pose e dinâmica facial.
Dados e Testes
Para a fase de teste, o modelo é inicializado a partir de um checkpoint pré-treinado de DiT de imagem para vídeo e treinado em três estágios: 20.000 passos para cada um dos dois primeiros estágios e 30.000 passos para o terceiro.
Para melhorar a generalização em diferentes durações e resoluções, os cliques de vídeo foram amostrados aleatoriamente com comprimentos entre 25 e 121 quadros. Esses foram então redimensionados para 960x640px, mantendo a proporção.
O treinamento foi realizado em oito (NVIDIA H20 com foco na China) GPUs, cada uma com 96GB de VRAM, usando o otimizador AdamW com uma taxa de aprendizado (tolerantemente alta) de 5e−6.
Na inferência, cada segmento de vídeo continha 73 quadros. Para manter a consistência entre os segmentos, o latente final de um segmento foi reutilizado como o latente inicial para o próximo, o que contextualiza a tarefa como geração de imagem para vídeo sequencial.
A orientação de classificador livre foi aplicada com um peso de 2,5 para imagens de referência e sinais de controle de movimento.
Os autores construíram um conjunto de dados de treinamento (nenhuma fonte é citada no artigo) composto por 500 horas de vídeo provenientes de domínios diversos, apresentando instâncias de (entre outros) dança, esportes, cinema e discursos públicos. O conjunto de dados foi projetado para capturar um amplo espectro de movimento e expressão humanos, com uma distribuição uniforme entre tiros de corpo inteiro e meio corpo.
Para melhorar a qualidade da síntese facial, Nersemble foi incorporado no processo de preparação de dados.

Exemplos do conjunto de dados Nersemble, usado para aumentar os dados para o DreamActor. Fonte: https://www.youtube.com/watch?v=a-OAWqBzldU
Para a avaliação, os pesquisadores usaram seu conjunto de dados também como um benchmark para avaliar a generalização em vários cenários.
O desempenho do modelo foi medido usando métricas padrão de trabalhos anteriores: Fréchet Inception Distance (FID); Índice de Similaridade Estrutural (SSIM); Similaridade de Patch de Imagem Perceptual Aprendida (LPIPS); e Taxa de Sinal para Ruído de Pico (PSNR) para qualidade de quadro. Fréchet Video Distance (FVD) foi usado para avaliar a coerência temporal e a fidelidade geral do vídeo.
Os autores realizaram experimentos em tarefas de animação de corpo e animação de retrato, todas empregando uma única imagem de referência (alvo).
Para a animação de corpo, o DreamActor-M1 foi comparado com Animate Anyone; Champ; MimicMotion, e DisPose.

Comparações quantitativas contra frameworks rivais.
Embora o PDF forneça uma imagem estática como uma comparação visual, um dos vídeos do site do projeto pode destacar as diferenças de forma mais clara:
CONTÉUDO DE ÁUDIO. Clique para reproduzir. Uma comparação visual entre os frameworks desafiadores. O vídeo de direção é visto no canto superior esquerdo, e a conclusão dos autores de que o DreamActor produz os melhores resultados parece razoável.
Para os testes de animação de retrato, o modelo foi avaliado contra LivePortrait; X-Portrait; SkyReels-A1; e Act-One.

Comparações quantitativas para animação de retrato.
Os autores observam que seu método vence nos testes quantitativos e afirmam que também é superior qualitativamente.
CONTÉUDO DE ÁUDIO. Clique para reproduzir. Exemplos de comparações de animação de retrato.
Arguivelmente, o terceiro e último clipe mostrado no vídeo acima exibe uma sincronização labial menos convincente em comparação com alguns dos frameworks rivais, embora a qualidade geral seja notavelmente alta.
Conclusão
Antecipando a necessidade de texturas implícitas, mas não realmente presentes na imagem de referência única que alimenta essas recriações, a Bytedance abordou um dos maiores desafios enfrentados pela geração de vídeo baseada em difusão – texturas consistentes e persistentes. O próximo passo lógico após aperfeiçoar essa abordagem seria criar um atlas de referência a partir do clipe gerado inicialmente que pudesse ser aplicado a gerações subsequentes e diferentes, para manter a aparência sem LoRAs.
Embora essa abordagem seja efetivamente uma referência externa, isso não é diferente da textura-mapping em técnicas CGI tradicionais, e a qualidade de realismo e plausibilidade é muito maior do que as obtidas por métodos mais antigos.
Dito isso, o aspecto mais impressionante do DreamActor é o sistema de orientação híbrida de três partes, que une a divisão tradicional entre síntese humana focada na face e no corpo de forma ingênua.
Resta apenas ser visto se alguns desses princípios centrais podem ser aproveitados em ofertas mais acessíveis; como está, o DreamActor parece destinado a se tornar mais uma oferta de síntese como serviço, severamente limitada por restrições de uso e pela impraticabilidade de experimentar extensivamente com uma arquitetura comercial.
* Minha substituição de hiperlinks para os autores; citações em linha
† Como mencionado anteriormente, não está claro com qual sabor de Stable Diffusion foi usado neste projeto.
Publicado pela primeira vez na sexta-feira, 4 de abril de 2025


