
Ângulo de Anderson
Um Sistema de Aprendizado de Máquina para Reescrever um Artigo Enquanto Você Lê

 Adicione Unite.AI às suas fontes preferidas no Google
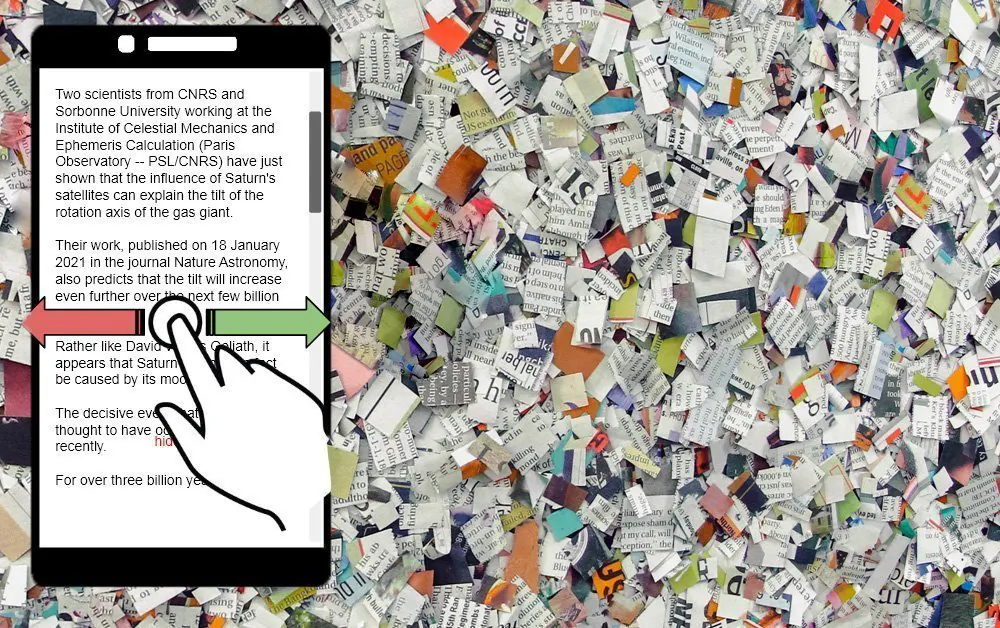
Pesquisas recentes do Canadá propõem um método para reescrever automaticamente um artigo à medida que você o lê, com base em um estilo de “deslizar” semelhante ao do Tinder, ou em uma observação passiva da interação do leitor com os vários tipos de conteúdo que o artigo contém.
O sistema, intitulado Hone As You Read (HARE), é apresentado em um artigo da Western University, em Ontario, Canadá, com código Python correspondente no GitHub.
A ideia central do projeto é que um artigo pode conter vários tipos de conteúdo, evoluindo (assim como este) do título até os detalhes adicionais. As partes posteriores de um artigo podem conter diferentes tipos de material de apoio, casos de uso ou hipóteses ou conjecturas sobre as ramificações da notícia.
No HARE, se você não gosta desse tipo de material, você pode votar para removê-lo em uma base de parágrafo por parágrafo, enquanto o sistema aprende suas preferências, de modo que, ao chegar ao final da página, o conteúdo semelhante ao material que você “descurtou” já foi removido ou reescrito. Se você não quiser participar ativamente do treinamento do sistema, o HARE pode deduzir suas escolhas observando suas interações passivas com o documento.
Votação em Estilo Tinder para Frases Desagradáveis
Na imagem abaixo, vemos três tipos possíveis de categorização inferida para o HARE, com base no comportamento explícito ou implícito do usuário. No primeiro caso (esquerda), o usuário ativamente “desliza para a esquerda” (ou para a direita), em um gesto de votação em estilo Tinder que expressa aprovação ou desaprovação no conteúdo do parágrafo ou frase, ou em seu estilo, complexidade ou tom.

Fonte: https://arxiv.org/pdf/2105.02923.pdf
No segundo caso (centro), o sistema usa o tempo de permanência como uma métrica de interesse do usuário, com base na posição e duração da pausa de rolagem.
No terceiro caso (direita), o HARE está usando a câmera do smartphone para estimar o caminho e o tempo de permanência da localização do olhar do visualizador ao longo dos parágrafos do documento visível.
Os pesquisadores defendem que um aumento no tempo de permanência em qualquer parágrafo pode indicar um aumento no interesse do usuário, embora logicamente isso possa não ser o caso onde o visualizador está tentando assimilar texto que pode ser complicado ou apenas mal escrito.

O feedback do usuário edita, reescreve ou apaga completamente porções ainda não vistas do artigo.
Pré-processamento de Conteúdo de Acordo com as Preferências do Usuário
O artigo lida com a experiência do usuário do HARE em uma base por artigo, mas claramente a interação histórica do usuário com documentos permite a personalização de futuras experiências de leitura, reconhecendo consistentemente tipos de conteúdo e aplicando preferências do usuário modeladas a novos artigos, de modo que a necessidade de interação diminui à medida que o usuário vê menos e menos “conteúdo indesejado”.
O HARE é caracterizado como um algoritmo de resumo, permitindo que o conteúdo não visto mais abaixo da página seja reescrito em termos de estilo ou concisão antes que o usuário chegue a ele; mas o artigo deixa claro que ele também pode remover previamente o conteúdo com base no feedback do usuário.
Para fins de teste, o sistema utilizou um corpus de 11.222 artigos do jornal Daily Mail do Reino Unido e foi avaliado por meio de uma implantação de teste no aplicativo de bate-papo Telegram. Artigos com menos de dez parágrafos foram descartados para fins de teste.

O aplicativo HARE do Telegram em uma fase de teste com usuários.
A metodologia dos pesquisadores usa K-Means clustering em SBERT incorporações de frases nos artigos, com pesos inicialmente aleatórios para conceitos tratados.
Entre uma ampla gama de algoritmos e abordagens, o HARE apresenta três modelos de comparação, o primeiro dos quais (ORACLEGREEDY) tem acesso a preferências anteriores do usuário, indicando a intenção de que o algoritmo possa pré-processar artigos na carga, em vez de interativamente.
Os outros modelos, ORACLESORTED e ORACLEUNIFORM, selecionam frases com base no nível de interesse ou aleatoriamente em todo o artigo, respectivamente.
Remoção e Reescrita de Conteúdo
Surpreendentemente, o ORACLEUNIFORM superou o conjunto de controle, embora não tenha acesso a interesses anteriores do usuário. Os pesquisadores defendem que isso ocorre porque ele lida com o artigo inteiro em uma única passada, “escolhendo apenas as frases mais interessantes”. Os pesquisadores admitem que isso pode restringir o conteúdo disponível às frases que lidam apenas com o conceito mais importante, logicamente removendo outros textos que podem lidar com ramificações ou avaliação do conceito.
Os resumidores extrativos usados no HARE são LexRank, SumBasic e TextRank.
O HARE foi testado em 13 voluntários ao longo de 70 ensaios e abordagens algorítmicas variadas e foi capaz de atualizar resumos (texto reescrito/excluído) em algum lugar entre 1,3 milissegundos e 100 ms em um laptop de consumo, dependendo do modelo sendo testado. Os resultados mostraram que os modelos que removeram a maioria do texto não se saíram bem, principalmente porque isso pode afetar a coerência do texto restante.
Implicações Éticas da Reescrita Dinâmica de Artigos
Os pesquisadores reconhecem preocupações éticas em torno de tecnologias desta natureza:
‘A tarefa HARE é destinada ao design de aplicações futuras voltadas para o usuário. Por design, essas aplicações têm a capacidade de controlar o que um usuário lê em um artigo determinado. É possível que, quando implantadas sem o devido cuidado, essas ferramentas possam exacerbam o efeito “câmara de eco” já produzido por feeds de notícias automatizados, resultados de busca e comunidades online.’
No entanto, eles também observam que um sistema como esse pode ser usado em aplicações futuras para mitigar o efeito de “câmara de eco” injetando texto que propõe pontos de vista alternativos que podem não ter sido inicialmente presentes no artigo. Eles observam: ‘O peso desse fator pode ser ajustado para fornecer tanto uma experiência de leitura envolvente quanto exposição a uma diversidade de ideias.’
Aqueles que provavelmente se beneficiarão de um sistema como esse, de acordo com os pesquisadores, são leitores que desejam economizar tempo ao absorver informações e editores de conteúdo.


