Podstawy AI
Czym są agenci obsługujący komputer? Jak sztuczna inteligencja widzi, klika, pisze i porusza się po oprogramowaniu
Agenci obsługujący komputer korzystają z oprogramowania za pomocą ekranów, kursorów i klawiatur, podobnie jak ludzie. Ta wszechstronność daje duże możliwości, ale niepewność związana z obrazem, długie sekwencje zadań i szerokie uprawnienia sprawiają, że niezbędne są staranne zabezpieczenia.

 Dodaj Unite.AI do preferowanych źródeł w Google

Agenci obsługujący komputer to systemy sztucznej inteligencji, które potrafią rozpoznawać interfejs oprogramowania i obsługiwać go za pomocą takich działań jak klikanie, pisanie, przewijanie, przeciąganie i używanie skrótów klawiszowych. Zamiast wymagać osobnego interfejsu API dla każdej aplikacji, działają za pośrednictwem wielu takich samych interfejsów wizualnych, z jakich korzystają ludzie.
Dzięki tej umiejętności agenci mogą działać w wielu różnych starszych programach, witrynach internetowych i aplikacjach komputerowych. Wiąże się to jednak z nietypowymi zagrożeniami. Niewielkie błędne rozpoznanie elementu wizualnego może skierować długie zadanie na niewłaściwy tor, a dostęp do interfejsu może ujawnić wszystko, co zalogowany użytkownik może zobaczyć lub zmienić.
Dlaczego obsługa komputera ma znaczenie
Wiele ważnych programów używanych na świecie zaprojektowano z myślą o ludziach, a nie agentach. Aplikacja może nie udostępniać publicznego interfejsu API, zapewniać programowy dostęp tylko do części swoich funkcji lub wymagać pracy w kilku interfejsach.
Tradycyjna automatyzacja procesów z użyciem robotów może obsługiwać interfejsy użytkownika, ale zazwyczaj opiera się na zdefiniowanych wcześniej selektorach i przepływach pracy. Agent obsługujący komputer wykorzystuje dodatkowo model, który potrafi interpretować nieznane ekrany, ustalać, jaki krok należy wykonać, i dostosowywać się do zmian interfejsu lub nieoczekiwanych okien dialogowych.
Dzięki temu obsługa komputera staje się narzędziem ogólnego zastosowania. Ta sama pętla percepcji i działania może potencjalnie służyć do poruszania się po arkuszu kalkulacyjnym, systemie zarządzania relacjami z klientami, aplikacji do projektowania, przeglądarce lub wewnętrznym portalu.
Jak działa agent obsługujący komputer
Najtrudniejszym etapem pośrodku jest powiązanie instrukcji z konkretnym elementem interfejsu. Agent musi przełożyć abstrakcyjne polecenie, takie jak „otwórz najnowszą fakturę”, na określony widoczny wiersz lub element sterujący. Pomocne mogą być etykiety tekstowe i metadane dostępności, ale dynamiczne układy, interfejsy oparte na obszarze roboczym typu canvas, nakładające się elementy i niejednoznaczne ikony mogą zmusić model do wnioskowania na podstawie pikseli.
Podstawowa pętla przypomina sposób, w jaki człowiek obsługuje oprogramowanie.
- Obserwacja: zrób zrzut ekranu, odczytaj drzewo dostępności, strukturę dokumentu, położenie kursora i inne informacje o stanie otoczenia.
- Interpretacja: rozpoznaj widoczne elementy sterujące, treści i ostrzeżenia, a także określ związek między bieżącym ekranem a zadaniem.
- Wybór działania: zdecyduj, czy kliknąć, wpisać tekst, przewinąć ekran, nacisnąć klawisz, poczekać czy poprosić o pomoc.
- Wykonanie: środowisko uruchomieniowe wykonuje działanie za pośrednictwem interfejsu systemu operacyjnego, przeglądarki lub maszyny wirtualnej.
- Weryfikacja: zrób zrzut zmienionego ekranu i ustal, czy działanie przyniosło zamierzony efekt.
- Powtórzenie lub zatrzymanie: kontynuuj realizację celu, napraw błąd lub zatrzymaj się na chronionej granicy.
W opisie agenta obsługującego komputer OpenAI przedstawia tę funkcjonalność jako połączenie percepcji wzrokowej, rozumowania oraz obsługi myszy i klawiatury. Istotą nie jest przewidzenie pojedynczego kliknięcia, lecz zamknięta pętla obejmująca percepcję, działanie i ponowną obserwację stanu.
Co agent może „zobaczyć”
Systemy do obsługi komputera mogą otrzymywać różne reprezentacje interfejsu.
Zrzuty ekranu zapewniają ogólny widok na poziomie pikseli i sprawdzają się nawet wtedy, gdy nie są dostępne żadne uporządkowane metadane interfejsu. Pozwalają uchwycić wykresy, obrazy, aplikacje oparte na obszarze roboczym typu canvas i układ wizualny. Trudne do zinterpretowania mogą być jednak małe elementy docelowe, ukryty stan i niejednoznaczne ikony.
Drzewa dostępności lub struktura dokumentu przedstawiają elementy sterujące i tekst w bardziej uporządkowanej formie. Mogą ułatwić precyzyjniejsze wybieranie elementów, ale mogą pomijać informacje wizualne lub działać niespójnie w różnych aplikacjach.
Systemy hybrydowe łączą piksele, uporządkowane elementy, stan aplikacji, a czasem także bezpośrednie interfejsy API. Takie podejście często sprawdza się lepiej niż traktowanie każdego problemu jako zadania polegającego wyłącznie na naśladowaniu obrazu.
Obsługa komputera a automatyzacja przeglądarki
Konwencjonalna automatyzacja przeglądarki wykorzystuje kod i stabilne selektory do wykonywania z góry określonej sekwencji działań. Jest szybka i przewidywalna, gdy struktura strony jest kontrolowana. Agent obsługujący komputer dynamicznie interpretuje interfejs i potrafi zdecydować, którą sekwencję wykonać.
Te podejścia wzajemnie się uzupełniają. W solidnym systemie agent może ustalić, co należy zrobić, a następnie zlecić wykonanie znanych operacji automatyzacji deterministycznej lub interfejsom API. Interakcja na poziomie pikseli jest najcenniejsza tam, gdzie nie ma uporządkowanego interfejsu lub nie da się z góry określić ścieżki działania.
Korzystanie z komputera a interfejsy API i wywoływanie narzędzi
| Percepcja | Przekształca piksele i dane ułatwień dostępu w potencjalne elementy interfejsu. |
|---|---|
| Ugruntowanie | Łączy zamierzone działanie z konkretnym widocznym elementem. |
| Wykonanie | Wydaje polecenie za pomocą myszy, klawiatury, ekranu dotykowego lub funkcji ułatwień dostępu. |
| Weryfikacja | Odczytuje kolejny stan zamiast zakładać, że działanie się powiodło. |
To hybrydowe podejście ogranicza zarówno liczbę błędów, jak i koszty. Agent może pobrać dane za pośrednictwem interfejsu API, otworzyć aplikację komputerową wyłącznie po to, by wypełnić formularz w starszym systemie, a następnie zweryfikować końcowy wpis za pomocą innego ustrukturyzowanego zapytania. Traktowanie sterowania wizualnego jako jednego z kilku narzędzi pozwala uniknąć wymuszania każdego kroku przez najmniej niezawodny interfejs.
Interfejs API zapewnia interfejs przeznaczony dla maszyn, z jasno określonymi operacjami i typami danych. Zazwyczaj jest szybszy, dokładniejszy i łatwiejszy do zweryfikowania niż klikanie na ekranie. Korzystanie z komputera zapewnia szerszą kompatybilność, ale wiąże się z większą niejednoznacznością.
Agent może na przykład sprawdzić stan zapasów za pośrednictwem interfejsu API, ale skorzystać z portalu internetowego dostawcy, by obsłużyć wyjątek, którego interfejs API nie wspiera. Wywoływanie narzędzi może udostępnić modelowi obie te możliwości, a środowisko wykonawcze może wybierać najbardziej niezawodną ścieżkę.
Typowe zastosowania
- Operacje zaplecza: przenoszenie danych między portalami, obsługa standardowych formularzy i przygotowywanie dokumentacji do zatwierdzenia.
- Badania: przeglądanie stron internetowych, filtrowanie wyników, gromadzenie dowodów i aktualizowanie dokumentu roboczego.
- Testowanie oprogramowania: odtwarzanie ścieżek użytkownika, rejestrowanie błędów i sprawdzanie zmian wizualnych.
- Wsparcie IT: sprawdzanie ustawień, zbieranie danych diagnostycznych oraz wskazywanie zatwierdzonych rozwiązań lub ich wdrażanie.
- Produktywność osobista: koordynowanie plików, aplikacji internetowych, kalendarzy i dokumentów.
- Dostępność: pomaganie użytkownikom w obsłudze interfejsów, po których trudno się poruszać, przy zachowaniu rygorystycznych zasad ochrony prywatności.
Dlaczego zadania wymagające obsługi komputera nadal sprawiają trudności
Interfejsy użytkownika zawierają dynamiczne menu, opóźnienia w ładowaniu, wyskakujące okienka, przewijane obszary, małe elementy docelowe oraz stany, które wyglądają podobnie, ale niosą różne konsekwencje. Zadanie może wymagać dziesiątek poprawnie wykonanych kroków, dlatego nawet niewielki odsetek błędów na każdym kroku kumuluje się.
Testy porównawcze, takie jak OSWorld, oceniają agentów w rzeczywistych środowiskach komputerowych, a nie na podstawie pojedynczych kliknięć. OSWorld 2.0 rozwija tę koncepcję, obejmując dłuższe procesy, w których zmieniają się stany i występuje większe zróżnicowanie. Rozdział Stanfordu dotyczący wydajności technicznej w raporcie AI Index 2026 odnotowuje szybki postęp, a zarazem wskazuje, że wyniki agentów w teście OSWorld nadal odbiegają od ludzkich, co podkreśla, że imponujące demonstracje nie oznaczają powszechnej niezawodności.
Główne przyczyny niepowodzeń
- Błędy w ugruntowaniu wizualnym: kliknięcie pobliskiego elementu sterującego lub elementu, który tylko przypomina właściwy.
- Pomylenie stanów: założenie, że strona się załadowała, zmiany zostały zapisane albo aktywne okno się zmieniło, choć tak się nie stało.
- Utrata orientacji w długim zadaniu: zgubienie celu zadania po wykonaniu wielu drobnych czynności.
- Ukryte skutki uboczne: wysłanie formularza lub dokonanie zakupu, choć agent miał jedynie wyświetlić podgląd.
- Wstrzykiwanie poleceń: wykonywanie złośliwych instrukcji osadzonych na stronie internetowej, w dokumencie lub wiadomości.
- Ujawnienie danych uwierzytelniających: ujawnienie lub niewłaściwe wykorzystanie informacji dostępnych w zalogowanej sesji.
- Nieodwracalne błędy: usuwanie, publikowanie, wysyłanie lub kupowanie bez odpowiedniego sprawdzenia.
Zasady bezpieczeństwa i kontroli
Treści wyświetlane w interfejsie nie są zaufane. Strona internetowa, e-mail lub dokument mogą zawierać instrukcje mające nakłonić agenta do zmiany kierunku działania, a złośliwe okno dialogowe może podszywać się pod znany komunikat z prośbą o potwierdzenie. System powinien oddzielać treści stron od zasad działania, ograniczać dostępne miejsca docelowe i poświadczenia oraz wstrzymywać działanie, gdy pojawi się nieoczekiwana prośba o uprawnienia lub prośba o potwierdzenie ważnej czynności.
Agent powinien obsługiwać komputer w możliwie najbardziej ograniczonym środowisku, które pozwala wykonać zadanie. Dedykowany profil przeglądarki, maszyna wirtualna lub piaskownica ograniczają dostęp do niezwiązanych z zadaniem kont i plików. Sesje powinny korzystać z poświadczeń przeznaczonych do konkretnego zadania i uprawnień ograniczonych do niezbędnego minimum, zamiast przejmować pełne uprawnienia użytkownika na komputerze.
Czynności o poważnych konsekwencjach wymagają wyraźnego momentu potwierdzenia. System powinien wstrzymać działanie bezpośrednio przed wysłaniem lub złożeniem czegoś, dokonaniem zakupu, usunięciem lub opublikowaniem treści albo zmianą poufnych ustawień, a następnie pokazać użytkownikowi dokładny cel i skutek tej czynności.
Agenci powinni również traktować zawartość ekranu jako niezaufane dane. Instrukcje napotkane na stronie internetowej nie mogą zastępować zasad systemowych ani zmieniać zadania wyznaczonego przez użytkownika. Pobrane pliki, skopiowane polecenia i komunikacja zewnętrzna wymagają osobnej weryfikacji.
Jak oceniać agenta obsługującego komputer
Wykonanie zadania jest konieczne, ale samo w sobie nie wystarcza. Zespoły powinny mierzyć dokładność poszczególnych kroków, umiejętność radzenia sobie z nieoczekiwanymi stanami, liczbę zbędnych działań, czas, koszt, narażenie danych poufnych, przestrzeganie wymogów zatwierdzania oraz powtarzalność wyników w kolejnych uruchomieniach.
Środowiska testowe powinny różnić się rozdzielczością ekranu, układem, danymi, czasem reakcji i stanem aplikacji. W przeciwnym razie agent może nadmiernie dopasować się do zaprogramowanego testu porównawczego, a mimo to nie radzić sobie ze zmiennością typową dla codziennego korzystania z oprogramowania.
Jak czytać diagramy obsługi komputera
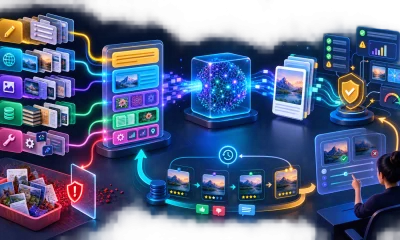
Diagramy obsługi komputera należy czytać od ponumerowanego wejścia w kierunku możliwego do zaobserwowania wyniku. Porównanie uwydatnia granicę, która odróżnia obsługę komputera od najbliższego rozwiązania na skróty, a ścieżka sterowania wskazuje, gdzie należy sprawdzić uprawnienia lub niepewność przed wystąpieniem rzeczywistych konsekwencji. Etykiety pozostają zwykłym, responsywnym tekstem strony, dzięki czemu można je tłumaczyć, zawijać i układać na nowo na ekranie telefonu.
W przypadku artykułu „Czym są agenci obsługujący komputer? Jak sztuczna inteligencja widzi, klika, pisze i porusza się po oprogramowaniu” grafika jest mapą, a nie gwarancją. Rzeczywista implementacja może łączyć etapy, powtarzać krok lub wprowadzać punkt zatwierdzenia przez człowieka. Ważne jest, czy zespół potrafi wskazać te same funkcje w wdrożonym systemie, przypisać osobę odpowiedzialną za każdą granicę oraz przetestować przejście między nimi. Jeśli danego etapu nie można obserwować ani mierzyć, trudno będzie zdiagnozować występujące na nim błędy.
Co warto zapamiętać o agentach obsługujących komputer
Agenci obsługujący komputer mogą korzystać z interfejsu oprogramowania przeznaczonego dla ludzi jak z uniwersalnego narzędzia. Mogą uzyskiwać dostęp do systemów bez odpowiednich interfejsów API i dostosowywać się do zadań, których stała automatyzacja nie jest w stanie łatwo przewidzieć.
Ta wszechstronność wiąże się z niejednoznacznością i potencjalnie szerokimi konsekwencjami. Najlepsze rozwiązania preferują ustrukturyzowane interfejsy API, jeśli są dostępne, izolują środowisko komputerowe, weryfikują każdą zmianę stanu i pozostawiają ludziom kontrolę nad działaniami o poważnych konsekwencjach.