
Kąt Andersona
Wykorzystanie sztucznej inteligencji do poprawy zdjęć przed ich wykonaniem

 Dodaj Unite.AI do preferowanych źródeł w Google
Zamiast poprawiać zdjęcia za pomocą generatywnej AI już po ich wykonaniu, badacze wyszkolili system, który przed naciśnięciem migawki podpowiada, jak się przesunąć, ustawić i skadrować ujęcie. Wykorzystuje on wiedzę naukową o tym, co sprawia, że obraz pozostaje w pamięci.
Edycja po wykonaniu zdjęcia od dawna staje się coraz łatwiejsza. Producenci i platformy technologiczne oferują funkcje edycji w aparacie, pozwalające natychmiast zmienić obraz. Przykładami są konwersacyjna edycja Google oraz generatywna edycja Samsunga.
Rosnące zainteresowanie „autentycznością” zamiast wynikami „ulepszonymi” przez AI może jednak sprawić, że część odbiorców zacznie uważać zmodyfikowane fotografie za bezwartościową treść AI.
Być może dlatego Google stworzył oparty na Gemini, wyszkolony przez AI moduł Camera Coach, który podczas fotografowania bezpośrednio instruuje użytkownika, jak poprawić ujęcie.
Google Camera Coach podpowiada między innymi, jak zmienić kadr.ŹródłoTo system zamknięty, o którym niemal nie ma publicznych informacji. Wygląda jednak na to, że Gemini pomaga poprawić kadrowanie albo proponuje drobne zmiany ustawienia, na przykład zbliżenie fotografowanych osób lub spojrzenie prosto w obiektyw.
Na podstawie dostępnych informacji produkt przesuwa kompozycję ku wartości średniej, prawdopodobnie wyuczonej z milionów przesłanych obrazów. Użytkownicy, odrzucając nieudane fotografie i publikując te, które im się podobają, wykonali więc bezpłatną selekcję danych kalibrujących AI.
Uśredniona kompozycja nie musi jednak mieć tej samej wartości estetycznej ani siły oddziaływania co fotografia naprawdę zapadająca w pamięć.
Poza „serem!” i regułą trójpodziału
Badacze z Włoch przedstawili system trenerski dostępny na wielu platformach, oparty na wcześniejszej wiedzy o tym, co sprawia, że fotografie zostają w pamięci.
Różnorodne przykłady porad generowanych przez nowy system.ŹródłoMemCoach proponuje działania, których trudno oczekiwać od systemu skupionego wyłącznie na kompozycji. W pierwszym przykładzie sugestia usunięcia nakrycia głowy jest szczególnie dyskusyjna. W drugim trudno wyobrazić sobie, jaki standardowy kontekst kompozycyjny miałby zastosować model do artystycznego zdjęcia młodej kobiety leżącej na podłodze z zamkniętymi oczami.
Trzyczęściowy włoski system opiera rozumienie zapamiętywalności na wcześniejszych pracach, między innymi What makes an object memorable? z 2015 roku i What makes a photograph memorable? z 2013 roku.
Przykłady zdjęć o wysokiej, średniej i niskiej zapamiętywalności z pracy z 2013 roku.ŹródłoWcześniejsze badania wskazały jako istotne czynniki wewnętrzne obecność ludzi, wnętrza i ekspresję emocjonalną, a nie same przedmioty czy panoramy. Znaczenie mają też czynniki zewnętrzne, w tym kontekst i obserwator. Projekt skupia się na informacji zwrotnej o zapamiętywalności, nazwanej MemFeed, aplikacji-trenerze MemCoach oraz benchmarku MemBench opartym na zbiorze PPR10K.
Różnorodne przykłady ze zbioru portretów PPR10K. Górny rząd zawiera obrazy oryginalne, dolny profesjonalnie poprawione wersje oraz maski obszaru postaci. Oryginały różnią się punktem widzenia, tłem, oświetleniem i ustawieniami aparatu, natomiast wersje poprawione mają lepszą jakość wizualną i większą spójność w grupach.ŹródłoAutorzy traktują zapamiętywalność jako cechę fotografii możliwą do zmierzenia, a nie jedynie zbiór subiektywnych ocen. Zjawisko to wykazano wcześniej zarówno dla zdjęć, jak i materiałów wideo.
Artykuł nosi tytuł How to Take a Memorable Picture? Empowering Users with Actionable Feedback. Powstał dzięki czworgu badaczom z University of Trento, University of Pisa oraz Fondazione Bruno Kessler. Strona projektu zapowiadała publikację kodu na GitHubie i danych w Hugging Face w marcu 2026 roku.
Metoda
Aby utworzyć MemBench ze zbioru portretów PPR10K, badacze zgrupowali zdjęcia tej samej sceny i ocenili zapamiętywalność każdego obrazu wyszkolonym predyktorem opartym na cechach CLIP. Następnie uporządkowali fotografie w każdej scenie od najmniej do najbardziej zapamiętywalnej i połączyli je w pary.
Budowa i ocena MemBench. Górny rząd przedstawia grupowanie obrazów według scen, przewidywanie zapamiętywalności, ustalanie rankingu i generowanie praktycznych porad. Dolny pokazuje ocenę jakości informacji zwrotnej przez wzrost zapamiętywalności po edycji oraz perplexity.Dla każdej pary InternVL3.5 tworzył opis różnic między wersją mniej i bardziej zapamiętywalną. Opisy te stały się sygnałem uczącym dla systemu informacji zwrotnej.
W przeciwieństwie do logiki Camera Coach nie chodziło o korekty po wykonaniu zdjęcia, takie jak „rozjaśnij obraz”, lecz o działania semantyczne możliwe do wykonania na żywo, na przykład „odwróćcie się do siebie”.
Końcowy MemBench obejmuje około 10 tysięcy obrazów pogrupowanych w 1570 scen, średnio po 6,5 obrazu na scenę. Chmura słów przygotowana przez autorów pokazuje szeroki zakres kategorii semantycznych.
Chmura najczęściej występujących słów w MemBench.Średni wynik zapamiętywalności zdjęć źródłowych wyniósł 0,63. Najbardziej zapamiętywalne ujęcia z tych samych scen miały wyniki od 0,51 do 1,0, a rozkłady obu grup wyraźnie się nakładały.
Rozkład wyników dla najmniej i najbardziej zapamiętywalnych obrazów w każdej scenie.Informacje zwrotne miały od krótkich, siedmiowyrazowych notatek do znacznie dłuższych instrukcji. GPT-5 Mini rozdzielał każdą poradę na małe jednostki działania.
Rozkład długości porad według słów znaczących i klasyfikacja elementarnych działań. Szerokość połączeń pokazuje, jak często kategorie występowały razem.Większość sugestii dotyczyła ustawienia fotografowanej osoby. Kolejne były zmiany znaczenia lub zawartości sceny. Kadrowanie często łączono z pozą, a zmiany światła ze zmianami semantycznymi.
Symulowanie wykonania porady za pomocą FLUX
Aby sprawdzić, czy porada zwiększa zapamiętywalność, model generatywny FLUX.1 Kontext pełnił rolę zastępczego fotografa. Z obrazu źródłowego i tekstowej instrukcji tworzył wersję symulującą zasugerowaną zmianę.
Po lewej znajdują się prawdziwe zdjęcia ze zbioru, a po prawej obrazy utworzone przez FLUX według żółtej instrukcji. Pozwalało to oceniać skuteczność porad bez angażowania wielu osób i tworzyło przepływ, który w przyszłości można iteracyjnie ulepszać prawdziwymi przykładami.Oryginał i wersję zmienioną oceniał predyktor zapamiętywalności. Częstość, z jaką wersja zmieniona osiągała wyższy wynik, nazwano Improvement Ratio, a wielkość wzrostu względem punktu wyjścia Relative Memorability.
Podobieństwo do referencyjnych porad mierzono także przez perplexity względem opisów wzorcowych. Zastosowano podział 80–20 na poziomie scen, aby testować wyłącznie sceny nieużywane podczas treningu.
Ograniczenia obecnych modeli multimodalnych
Aby sprawdzić świadomość zapamiętywalności w dzisiejszych modelach multimodalnych, pokazano im obrazy LaMem i zapytano, czy są pamiętliwe. Pewność modeli porównano z wynikami ludzi z pierwotnego badania.
Testy pokazujące, że bazowe modele multimodalne nie rozpoznają zapamiętywalności. Po lewej korelacja rang Spearmana między przewidywaniami modeli a wynikami LaMem, z porozumieniem oceniających jako odniesieniem. Po prawej Improvement Ratio porad zero-shot wobec bazowej edycji, pokazujące niewielkie korzyści.Nie znaleziono prawie żadnej znaczącej korelacji z ocenami ludzi. Mimo treningu na ogromną skalę modele nie śledziły elementów, które ludzie konsekwentnie pamiętają.
Przykłady ze zbioru LaMem. Przy obrazie w lewym górnym rogu widoczna jest także mapa cieplna.ŹródłoMemCoach
MemCoach skupia się na instrukcjach semantycznych wykonywanych przed naciśnięciem migawki: zmianie pozy, relacji między osobami lub elementów sceny. Porady zawierają od 7 do 102 słów znaczących. Według autorów zapamiętywalność silniej zależy od konfiguracji postaci i sygnałów narracyjnych niż od prostych poprawek kompozycji.
Przepływ MemCoach. Porady nauczycielskiego MLLM świadomego zapamiętywalności zestawia się z neutralnymi odpowiedziami ucznia, tworząc dane kontrastowe. Różnice aktywacji warstw są uśredniane w wektor sterujący zapamiętywalnością, który podczas wnioskowania przesuwa aktywacje ucznia ku lepszym poradom bez dodatkowego treningu.Testy
Użyto siedmiu MLLM: Qwen2.5-VL, InternVL3.5-8B, Idefics3-8B, LLaVA-OneVision-1.5, zamkniętego GPT-5 Mini oraz wyspecjalizowanych estetycznie Q-Instruct i AesExpert. Modele działały jako punkty odniesienia zero-shot lub nauczyciele-orakle.
InternVL3.5 służył zarówno jako nauczyciel, jak i uczeń, a kontrastowe przykłady utworzono z części treningowej MemBench.
Porównanie MemCoach z najnowszymi MLLM, nauczycielami, modelami estetycznymi i bazowymi zero-shot. MemCoach uzyskał wyższy Improvement Ratio, konkurencyjną Relative Memorability i najniższe perplexity, co oznacza bardziej spójne porady ukierunkowane na zapamiętywalność.MemCoach dawał skuteczniejsze wskazówki niż każdy model porównawczy. Sterowany InternVL3.5 zwiększał zapamiętywalność częściej i mocniej: Improvement Ratio był o 5% wyższy niż dla GPT-5 Mini, a Relative Memorability wzrosła o 31,81% względem wersji bez sterowania.
System przewyższył też modele wyspecjalizowane w estetyce bez dodatkowego treningu. Niższe perplexity wskazuje, że jego język lepiej odpowiada wzorcom nagradzanym przez ludzkie oceny zapamiętywalności.
Wyniki generalizacji. MemCoach poprawił informacje zwrotne na wielu bazach multimodalnych, konsekwentnie podnosząc Improvement Ratio i Relative Memorability oraz obniżając perplexity dla większości modeli.Dalszy test wykazał wzrost jakości porad na każdym badanym modelu bazowym. Improvement Ratio wzrósł we wszystkich przypadkach, a największe skoki wystąpiły dla Qwen2.5-VL i LLaVA-OV.
W ocenie jakościowej obok siebie analizowano obraz źródłowy, instrukcję językową i wyobrażony poprawiony wynik.
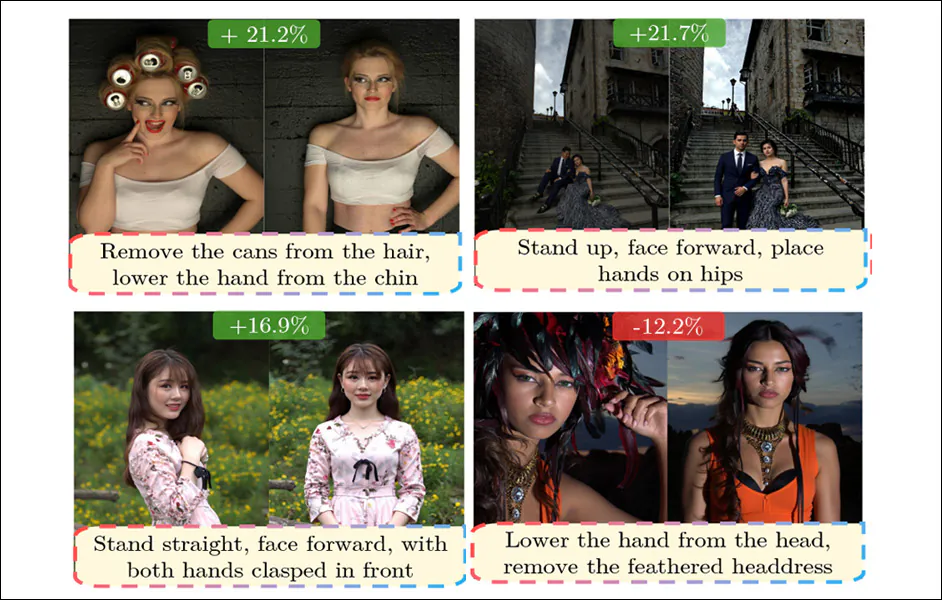
Przykłady porad MemCoach. Każda trójka pokazuje oryginał, instrukcję i edytowany wynik, a Relative Memorability opisuje zmianę. Sugestie obejmują pozę, kierunek spojrzenia i usuwanie obiektów. Pokazano zarówno poprawę, jak i przypadki, gdy usunięcie niezwykłego elementu zmniejszało zapamiętywalność.Autorzy podkreślają różnorodność zaleceń: od kierunku spojrzenia, pozy i ułożenia dłoni po usunięcie obiektu czy zmianę wyrazu twarzy. Są one zwięzłe, zrozumiałe i wykonalne, często używają czasowników „zbliż”, „stań” lub „usuń”, werbalizując sposób wykonania pamiętnego zdjęcia.
Wnioski
Interesujące byłoby porównanie zamkniętej metodologii Google z MemBench, zwłaszcza aby poznać normy, materiały odniesienia i bazy danych użyte do zdefiniowania standardów estetycznych Camera Coach.
Systemy tego rodzaju, otwarte lub zamknięte, przy masowym użyciu mogą narzucać jednolite standardy, które zamienią się w memy i klisze. Byłby to wizualny odpowiednik sporu o myślnik em w tekstach AI, gdzie „poprawna” procedura stała się podejrzana w codziennym użyciu.
* Autor artykułu zamienił cytowania w tekście na hiperłącza, jeśli odnośnika nie podano gdzie indziej.
† Praca w kilku miejscach wspomina materiały uzupełniające, których nie udało się znaleźć ani w artykule, ani w wykazie Arxiv, ani na stronie projektu.
Pierwsza publikacja: czwartek, 26 lutego 2026 roku.


