
Kąt Andersona
Przenoszenie analogii wizualnych do sztucznej inteligencji

 Dodaj Unite.AI do preferowanych źródeł w Google
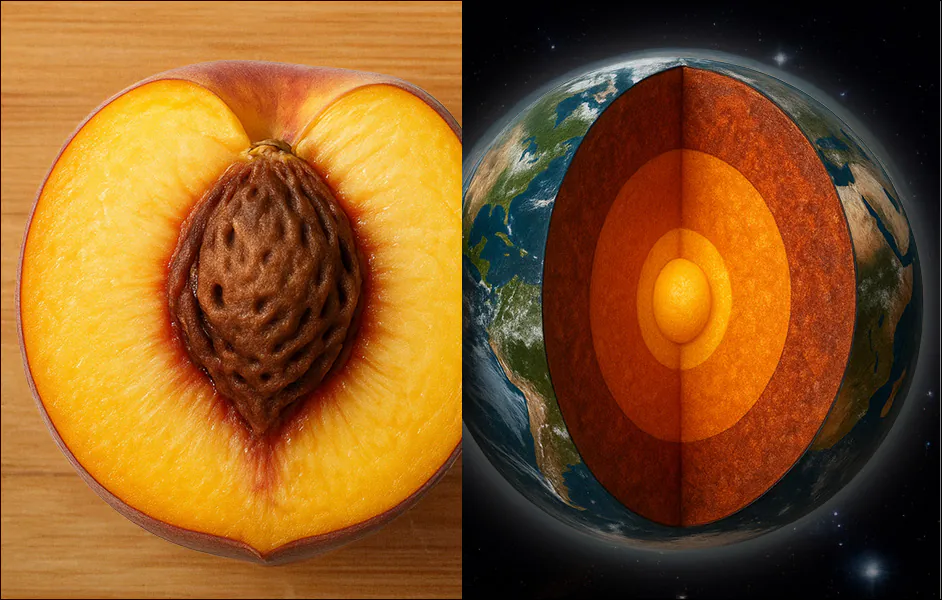
Obecne modele sztucznej inteligencji nie potrafią rozpoznać „relacyjnych” podobieństw obrazów, takich jak podobieństwo warstw Ziemi do brzoskwini, pomijając kluczowy aspekt percepcji ludzkiej.
Chociaż istnieje wiele modeli komputerowego widzenia, które potrafią porównywać obrazy i znajdować między nimi podobieństwa, obecna generacja systemów porównawczych ma niewielką lub żadną wyobraźnię. Rozważmy niektóre teksty piosenki z klasycznego utworu z lat 60. Windmills of Your Mind:
Jak karuzela, która się kręci, biegnąc wokół księżyca
Jak zegar, którego wskazówki przesuwają się wokół twarzy
I świat jest jak jabłko, wirujące cicho w przestrzeni
Porównania tego rodzaju reprezentują dziedzinę poetyckich aluzji, które są znaczące dla ludzi w sposób znacznie wykraczający poza artystyczne wyrażanie; raczej są one związane z tym, jak rozwijamy nasze percepcyjne systemy; gdy tworzymy naszą „przestrzeń obiektów”, rozwijamy zdolność do wizualnego podobieństwa, tak że – na przykład – przekroje przedstawiające brzoskwinię i planetę Ziemię lub fraktalne powtarzania, takie jak spirale kawy i gałęzie galaktyk, rejestrują się u nas jako analogiczne.
W ten sposób możemy wywnioskować połączenia między pozornie niezwiązanymi obiektami i typami obiektów oraz wnioskować systemy (takie jak grawitacja, pęd i powierzchniowa spójność), które mogą być stosowane w różnych dziedzinach na różnych poziomach.
Widzenie rzeczy
Nawet najnowsza generacja systemów porównawczych obrazów, takich jak Learned Perceptual Image Patch Similarity (LPIPS) i DINO, które są informowane przez opinie ludzi, wykonują tylko dosłowne powierzchniowe porównania.
Ihara możliwość znajdowania twarzy tam, gdzie ich nie ma – tj. pareidolia – nie reprezentuje rodzaju mechanizmów podobieństwa wizualnego, które rozwijają ludzie, ale raczej występuje dlatego, że algorytmy wyszukiwania twarzy wykorzystują niskopoziomowe cechy struktury twarzy cechy, które czasami są zgodne z losowymi obiektami:

Przykłady fałszywie dodatnich wyników rozpoznawania twarzy w zbiorze danych „Twarze i rzeczy”. Źródło
Aby określić, czy maszyny mogą naprawdę rozwinąć naszą wyobraźnię, aby rozpoznać wizualne podobieństwa między dziedzinami, badacze w USA przeprowadzili badanie dotyczące relacyjnego podobieństwa wizualnego, tworząc i szkoląc nowy zbiór danych, zaprojektowany tak, aby wymusić abstrakcyjne relacje między różnymi obiektami, które są jednak związane abstrakcyjną relacją:

Najnowsze modele AI rozpoznają podobieństwo tylko wtedy, gdy obrazy dzielą powierzchniowe cechy, takie jak kształt lub kolor, co sprawia, że łączą tylko grupę B (powyżej) z odniesieniem. Ludzie, z drugiej strony, widzą również grupę A jako podobną – nie dlatego, że obrazy wyglądają podobnie, ale dlatego, że podążają za tym samym ukrytym logicznym podejściem, takim jak przedstawianie transformacji w czasie. Praca ta próbuje odtworzyć ten rodzaj strukturalnego lub relacyjnego podobieństwa, mając na celu przybliżenie percepcji maszyn do ludzkiego rozumowania. Źródło: https://arxiv.org/pdf/2512.07833
System kapionowania opracowany dla tego zbioru danych umożliwia niezwykle abstrakcyjne adnotacje, zaprojektowane tak, aby wymusić na systemach AI skupienie się na podstawowych cechach, a nie na konkretnych lokalnych szczegółach:

Przewidywane „anonimowe” podpisy, które przyczyniają się do metryki „relsim” autorów.
Zbiór danych i jego niezwykły styl kapionowania zasilają nową proponowaną przez autorów metrykę relsim, którą autorzy dostosowali do modelu widzenia-języka (VLM).

Porównanie stylu kapionowania typowych zbiorów danych, które koncentrują się na podobieństwie atrybutów, podczas gdy podejście relsim (dolny wiersz) podkreśla relacyjne podobieństwo.
Nowe podejście opiera się na metodach z dziedziny nauki o poznaniu, w szczególności na teorii mapowania strukturalnego Dedre Gentner (badanie analogii) oraz na definicji relacyjnego podobieństwa i podobieństwa atrybutów Amosa Tversky’ego.

Z witryny projektu, przykład relacyjnego podobieństwa. Źródło
Autorzy stwierdzają:
„Ludzie przetwarzają podobieństwo atrybutów percepcyjnie, ale relacyjne podobieństwo wymaga abstrakcyjnej abstrakcji, często wspieranej przez język lub wcześniejszą wiedzę. To sugeruje, że rozpoznanie relacyjnego podobieństwa wymaga najpierw zrozumienia obrazu, korzystania z wiedzy i abstrakcji jego podstawowej struktury”.
Nowy artykuł nosi tytuł Relacyjne podobieństwo wizualne i jest dostępny na stronie projektu (zobacz film umieszczony na końcu tego artykułu).
Metoda
Badacze wykorzystali jeden z najlepiej znanych zbiorów danych jako punkt wyjścia dla swojego zbioru – LAION-2B:

Metadane dla wpisu w zbiorze LAION-2B. Źródło
114 000 obrazów, które mogą zawierać elastyczne struktury relacyjne, zostało wyodrębnionych z LAION-2B, co wymagało filtrowania wielu niskiej jakości obrazów, które są obecne w minimalnie kuratorowanym zbiorze danych.
Aby utworzyć potok do tego procesu selekcji, autorzy wykorzystali Qwen2.5-VL-7B, wykorzystując 1300 pozytywnych i 11 000 negatywnych przykładów oznaczonych przez ludzi:

System relsim jest szkolony w trzech etapach: filtrowanie obrazów z LAION-2B pod kątem zawartości relacyjnej; przypisywanie każdej grupie wspólnej anonimowej podpisu, która ujmuje ich podstawową logikę; oraz uczenie się dopasowywania obrazów do tych podpisów przy użyciu kontrastowej straty.
W artykule napisano:
„Annotatorzy zostali poinstruowani: „Czy widzisz jakikolwiek relacyjny wzór, logikę lub strukturę w tym obrazie, który mógłby być przydatny do tworzenia lub łączenia z innym obrazem?”. Dostosowany model osiąga 93% zgodności z ludzkimi osądami, a gdy jest stosowany do LAION-2B, daje N = 114k obrazów uznanych za relacyjnie interesujące”.
Aby wygenerować relacyjne etykiety, badacze poprosili model Qwen o opisanie wspólnej logiki za zestawami obrazów bez nazywania konkretnych obiektów. Ta abstrakcja była trudna do uzyskania, gdy model widział tylko jeden obraz, ale stała się możliwa, gdy wiele przykładów demonstrowało podstawowy wzór.
Wynikające z tego grupowe podpisy zastąpiły konkretnymi terminami takimi jak „{Podmiot}” lub „{Typ ruchu}”, co sprawiło, że stały się one szeroko stosowalne.
Po weryfikacji przez ludzi każda podpis została połączona z wszystkimi obrazami w swojej grupie. Więcej niż 500 takich grup zostało wykorzystanych do szkolenia modelu, który został następnie zastosowany do 114 000 wyfiltrowanych obrazów, aby wyprodukować duży zbiór abstrakcyjnych, relacyjnie adnotowanych próbek.
Dane i testy
Po wyodrębnieniu relacyjnych cech za pomocą Qwen2.5-VL-7B model został dostosowany do danych przy użyciu LoRA przez 15 000 kroków, za pomocą ośmiu procesorów A100*. Dla strony tekstowej relacyjne podpisy zostały osadzone przy użyciu all-MiniLM-L6-v2 z biblioteki Sentence-Transformers.
Zbiór danych 114 000 obrazów z podpisami został podzielony na 100 000 do szkolenia i 14 000 do oceny. Aby przetestować system, użyto ustawienia pobierania: dla danego obrazu zapytania model musiał znaleźć inny obraz z puli 28 000 elementów, który wyraża to samo relacyjne pojęcie. Pula pobierania obejmowała 14 000 obrazów oceny i 14 000 dodatkowych próbek z LAION-2B, z 1000 zapytań losowo wybranych z zestawu oceny do benchmarkingu.
Aby ocenić jakość pobierania, użyto GPT-4o do oceny relacyjnego podobieństwa między każdym zapytaniem a pobranym obrazem w skali od 0 do 10. Przeprowadzono również oddzielne badanie z udziałem ludzi, aby ocenić preferencje użytkowników (patrz poniżej).
Każdy uczestnik został pokazany anonimowany obraz zapytania z dwoma kandydatami, jednym pobranym za pomocą proponowanego podejścia, a drugim za pomocą podejścia bazowego. Uczestnicy zostali poproszeni, który obraz jest bardziej relacyjnie podobny do zapytania, czy oba są równie bliskie. Dla każdego podejścia bazowego utworzono 300 tripletów i oceniono je co najmniej przez trzy osoby, co dało około 900 odpowiedzi.
Podejście relsim zostało porównane z kilkoma ustanowionymi metodami podobieństwa obrazu, w tym z dreamsim i CLIP-I. Oprócz podejść bazowych, które bezpośrednio obliczają wyniki podobieństwa między parami obrazów, takimi jak LPIPS, DINO, dreamsim i CLIP-I, autorzy przetestowali również metody oparte na podpisach, w których Qwen został użyty do wygenerowania anonimowego lub abstrakcyjnego podpisu dla każdego obrazu; ten podpis służył jako zapytanie pobierania.
Dwa warianty pobierania zostały ocenione, z użyciem CLIP-T do pobierania tekst-obraz i Qwen-T do pobierania tekst-tekst. Obie metody bazowe oparte na podpisach wykorzystywały oryginalny wstępnie wytrenowany model Qwen, a nie wersję dostosowaną do logiki relacyjnej. To pozwoliło autorom na izolację efektu szkolenia opartego na grupach, ponieważ dostosowany model został wystawiony na zestawy obrazów, a nie na izolowane przykłady.
Istniejące metryki i relacyjne podobieństwo
Autorzy początkowo przetestowali, czy istniejące metryki mogą uchwycić relacyjne podobieństwo:

Porównanie wyników pobierania według GPT-4o, pokazujące średni wynik relacyjnego podobieństwa dla każdej metody. Konwencjonalne metryki podobieństwa, takie jak LPIPS, DINO i CLIP-I, uzyskały niższe wyniki. Metody bazowe oparte na podpisach Qwen-T i CLIP-T również uzyskały gorsze wyniki. Najwyższy wynik został osiągnięty przez relsim (6,77, najbardziej na prawo niebieska kolumna), co wskazuje, że dostosowanie do wzorców relacyjnych grupowych poprawiło zgodność z ocenami GPT-4o.
W odniesieniu do tych wyników autorzy stwierdzają**:
„[LPIPS], który koncentruje się wyłącznie na percepcyjnym podobieństwie, osiąga najniższy wynik (4,56). [DINO] wykonuje nieco lepiej (5,14), prawdopodobnie dlatego, że jest szkolony wyłącznie w sposób samouczący na danych obrazowych. [CLIP-I] daje najmocniejsze wyniki wśród podejść bazowych (5,91), prawdopodobnie dlatego, że niektóre abstrakcje są czasem obecne w podpisach obrazów.
„Jednak CLIP-I nadal uzyskuje gorsze wyniki niż nasze podejście, ponieważ osiągnięcie lepszego wyniku może wymagać możliwości osiągnięcia jeszcze wyższych abstrakcji, takich jak te w anonimowych podpisach”.
W badaniu z udziałem ludzi ludzie konsekwentnie preferowali podejście relsim we wszystkich podejściach bazowych:

Wyniki relacyjnego podobieństwa przypisane przez GPT-4o dla każdej metody. Standardowe metryki podobieństwa, takie jak LPIPS, DINO i CLIP-I, uzyskały niższe wyniki, a metody bazowe oparte na podpisach Qwen-T i CLIP-T wykonują nieco lepiej. Nawet dostosowane wersje DINO i CLIP nie zmniejszyły różnicy. Najwyższy wynik, 6,77, został osiągnięty przez model relsim, szkolony z nadzorem grupowym.
Autorzy zauważają:
„To jest bardzo zachęcające, ponieważ pokazuje nie tylko, że nasz model, relsim, może pomyślnie pobrać relacyjnie podobne obrazy, ale także potwierdza, że ludzie postrzegają relacyjne podobieństwo – a nie tylko podobieństwo atrybutów!”
Aby zbadać, jak relacyjne i atrybutowe podobieństwo mogą się uzupełniać, badacze użyli połączonej metody wizualizacji. Jeden obraz zapytania („Pies trzymający aparat”) został porównany z 3000 losowymi obrazami, a podobieństwo zostało obliczone przy użyciu modeli relacyjnych i atrybutowych:

Wspólna wizualizacja przestrzeni podobieństwa wizualnego przy użyciu osi relacyjnych i atrybutowych. Jeden obraz zapytania, przedstawiający psa używającego aparatu, został porównany z 3000 innymi. Wyniki zostały zorganizowane według relacyjnego podobieństwa (pionowe) i atrybutowego podobieństwa (poziome). Górny prawy obszar zawiera obrazy, które przypominają zapytanie zarówno logiką, jak i wyglądem, takie jak inne psy używające narzędzi. Górny lewy obszar zawiera semantycznie powiązane, ale wizualnie odrębne przypadki, takie jak różne zwierzęta wykonujące czynności związane z aparatem. Większość pozostałych przykładów grupuje się niżej w przestrzeni, odzwierciedlając słabsze podobieństwo. Układ ilustruje, jak modele relacyjne i atrybutowe podkreślają uzupełniające aspekty danych wizualnych. Proszę odnieść się do oryginalnego artykułu w celu uzyskania lepszej rozdzielczości.
Wyniki ujawniły klastry odpowiadające różnym typom podobieństwa: niektóre obrazy były zarówno relacyjnie, jak i wizualnie podobne; inne dzieliły relacyjną logikę, ale nie wygląd; reszta nie wykazywała żadnego z nich.
Ta analiza sugeruje, że dwa typy podobieństwa pełnią odrębne role i dają bogatszą strukturę, gdy są łączone.
Przypadki użycia
Artykuł bada również niektóre możliwe przypadki użycia relacyjnego podobieństwa, w tym relacyjne pobieranie obrazów, które pozwala na wyszukiwanie obrazów bardziej zgodne z ludzkim kreatywnym sposobem patrzenia na świat:

Relacyjne pobieranie zwraca obrazy, które dzielą głębszą strukturę pojęciową z zapytaniem, a nie pasują do cech powierzchniowych. Na przykład, potrawa stylizowana, aby przypominać twarz, zwraca inne antropomorficzne posiłki; przekrojony obiekt daje inne przekrojone formy; a sceny interakcji rodzic-dziecko zwracają obrazy z podobnymi relacyjnymi rolami, nawet jeśli gatunki i skład różnią się.
Inny możliwy przypadek użycia to analogiczna generacja obrazów, która pozwoliłaby na syntezę zapytań, które wykorzystują relacyjne struktury, a nie bezpośrednie opisy. W porównaniu wyników uzyskanych z bieżącej generacji modeli tekst-obraz, możemy zobaczyć, że wyniki takiego podejścia są bardziej różnorodne:

Dla wejściowego obrazu i relacyjnego podpisu, modele zostały poproszone o wygenerowanie nowego obrazu wyrażającego to samo podstawowe pojęcie. Własne modele wyprodukowały bardziej wierną analogię, zachowując logiczną strukturę przez duże zmiany w formie, a modele open-source tendencję do regresji do literalnych lub stylistycznych dopasowań, nie przenosząc głębszego pomysłu. Wyniki zostały porównane z ludzkimi analogiami, które uosabiały zamierzoną transformację.
Wnioski
Systemy generatywne sztucznej inteligencji byłyby, wydaje się, znacznie wzmocnione przez zdolność do inkorporowania abstrakcyjnej reprezentacji do ich pojęć. Jak jest teraz, pytanie o obrazy oparte na pojęciach, takich jak „złość” lub „szczęście”, tendencję do zwracania obrazów stylizowanych z najpopularniejszych lub najbardziej licznych obrazów, które miały te skojarzenia w zbiorze danych; co jest pamięcią zamiast abstrakcją.
Prawdopodobnie ten sam zasada mógłby być jeszcze bardziej korzystny, gdyby mógł być zastosowany do generatywnej pisarskiej – szczególnie analitycznej, spekulatywnej lub fikcyjnej.
Naciśnij, aby odtworzyć. Źródło
* Karta A100 może mieć 40 GB lub 80 GB pamięci VRAM; nie jest to określone w artykule.
** Cytaty autorów są zbędne i wykluczone.
Pierwotnie opublikowane we wtorek, 16 grudnia 2025


