
AGI i przyszłość AI
Potęga Rerankers i Dwuetapowego Pobierania dla Wzmocnionej Generacji Pobierania

 Dodaj Unite.AI do preferowanych źródeł w Google

Kluczowe punktyDwuetapowe pobieranie z modelami przeorządkowującymi znacząco poprawia dokładność RAG…
Zobacz więcej
- Dwuetapowe pobieranie z modelami przeorządkowującymi znacząco poprawia dokładność RAG, najpierw pobierając wiele dokumentów, a następnie porządkując je za pomocą inteligentniejszego modelu.
- Mechanizm późnej interakcji ColBERT umożliwia wydajne wyszukiwanie semantyczne poprzez oddzielne przetwarzanie zapytań i dokumentów aż do ostatecznego porównania.
- Modele przeorządkowujące można trenować na danych specyficznych dla domeny, aby rozwiązać problemy niezgodności dziedzinowej powszechne w ogólnych modelach embeddingowych.

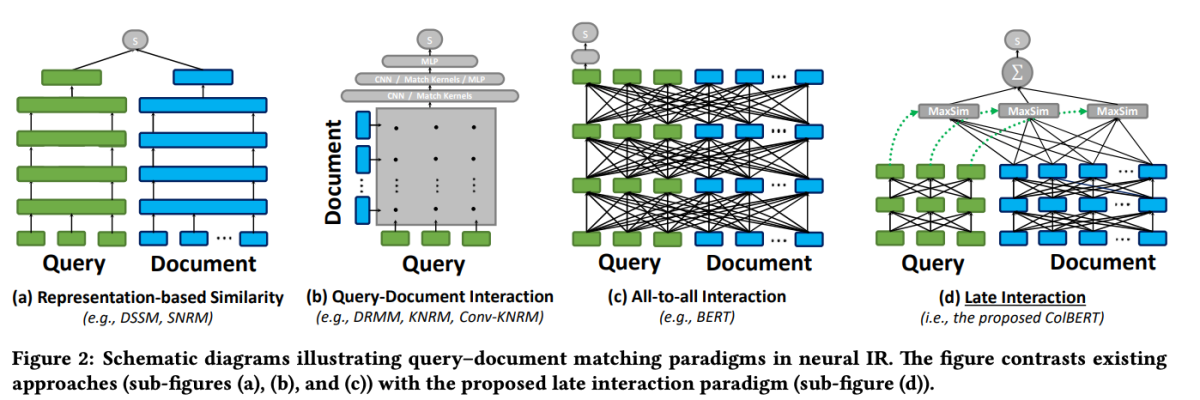
Poniższy fragment kodu pokazuje, jak skonfigurować i użyć modelu jina-colbert-v1-en do indeksowania kolekcji dokumentów, wykorzystując jego zdolność do efektywnego radzenia sobie z długimi kontekstami.
Wdrożenie Dwuetapowego Pobierania z Rerankersami
Teraz, gdy mamy zrozumienie zasad dwuetapowego pobierania i rerankersów, przejdźmy do ich praktycznego wdrożenia w kontekście systemu RAG. Wykorzystamy popularne biblioteki i ramy, aby zademonstrować integrację tych technik.
Konfigurowanie Środowiska
Przed rozpoczęciem kodu, skonfigurujmy nasze środowisko programistyczne. Będziemy używać Pythona oraz kilku popularnych bibliotek NLP, w tym Hugging Face Transformers, Sentence Transformers i LanceDB.
# Zainstaluj wymagane biblioteki
!pip install datasets huggingface_hub sentence_transformers lancedb
Przygotowanie Danych
Do celów demonstracyjnych, wykorzystamy zestaw danych “ai-arxiv-chunked” z Hugging Face Datasets, który zawiera ponad 400 artykułów z serwisu ArXiv na temat uczenia maszynowego, przetwarzania języka naturalnego i dużych modeli językowych.
from datasets import load_dataset <p>dataset = load_dataset("jamescalam/ai-arxiv-chunked", split="train")</p> &lt;pre&gt;
Następnie, przetworzymy dane i podzielimy je na mniejsze fragmenty, aby ułatwić efektywne pobieranie i przetwarzanie.
from transformers import AutoTokenizer <p>tokenizer = AutoTokenizer.from_pretrained("bert-base-uncased")</p> <p>def chunk_text(text, chunk_size=512, overlap=64): tokens = tokenizer.encode(text, return_tensors="pt", truncation=True) chunks = tokens.split(chunk_size - overlap) texts = [tokenizer.decode(chunk) for chunk in chunks] return texts</p> <p>chunked_data = [] for doc in dataset: text = doc["chunk"] chunked_texts = chunk_text(text) chunked_data.extend(chunked_texts)</p>
Do etapu początkowego pobierania, wykorzystamy model Sentence Transformer do zakodowania naszych dokumentów i zapytań w gęste reprezentacje wektorowe, a następnie wykonamy przybliżoną wyszukiwanie najbliższych sąsiadów przy użyciu bazy danych wektorowej, takiej jak LanceDB.
from sentence_transformers import SentenceTransformer from lancedb import lancedb <p># Załaduj model Sentence Transformer model = SentenceTransformer('all-MiniLM-L6-v2')</p> <p># Utwórz magazyn wektorowy LanceDB db = lancedb.lancedb('/path/to/store') db.create_collection('docs', vector_dimension=model.get_sentence_embedding_dimension())</p> <p># Zindeksuj dokumenty for text in chunked_data: vector = model.encode(text).tolist() db.insert_document('docs', vector, text)</p> <p>from sentence_transformers import SentenceTransformer from lancedb import lancedb</p> <p># Załaduj model Sentence Transformer model = SentenceTransformer('all-MiniLM-L6-v2')</p> <p># Utwórz magazyn wektorowy LanceDB db = lancedb.lancedb('/path/to/store') db.create_collection('docs', vector_dimension=model.get_sentence_embedding_dimension())</p> <p># Zindeksuj dokumenty for text in chunked_data: vector = model.encode(text).tolist() db.insert_document('docs', vector, text)
Ze zindeksowanymi dokumentami, możemy wykonać etap początkowego pobierania, wyszukując najbliższych sąsiadów dla danego wektora zapytania.
from transformers import AutoTokenizer <p>tokenizer = AutoTokenizer.from_pretrained("bert-base-uncased")</p> <p>def chunk_text(text, chunk_size=512, overlap=64): tokens = tokenizer.encode(text, return_tensors="pt", truncation=True) chunks = tokens.split(chunk_size - overlap) texts = [tokenizer.decode(chunk) for chunk in chunks] return texts</p> <p>chunked_data = [] for doc in dataset: text = doc["chunk"] chunked_texts = chunk_text(text) chunked_data.extend(chunked_texts)
Reranking
Po etapie początkowego pobierania, zastosujemy model rerankingu, aby ponownie ustalić kolejność pobranych dokumentów na podstawie ich istotności względem zapytania. W tym przykładzie, wykorzystamy model rerankingu ColBERT, szybki i dokładny model transformatorowy, specjalnie zaprojektowany do rankingu dokumentów.
from lancedb.rerankers import ColbertReranker

reranker = ColbertReranker()

<p># Rerankuj dokumenty początkowe
reranked_docs = reranker.rerank(query, initial_docs)
Lista reranked_docs zawiera teraz dokumenty ponownie ustalone na podstawie ich istotności względem zapytania, określonej przez model rerankingu ColBERT.
Uzupełnienie i Generowanie
Z rerankowanymi i istotnymi dokumentami, możemy przejść do etapów uzupełnienia i generowania potoku RAG. Wykorzystamy model językowy z biblioteki Hugging Face Transformers do wygenerowania ostatecznej odpowiedzi.
from transformers import AutoTokenizer, AutoModelForSeq2SeqLM <p>tokenizer = AutoTokenizer.from_pretrained("t5-base") model = AutoModelForSeq2SeqLM.from_pretrained("t5-base")</p> <p># Uzupełnij zapytanie z rerankowanymi dokumentami augmented_query = query + " " + " ".join(reranked_docs[:3])</p> <p># Wygeneruj odpowiedź z modelu językowego input_ids = tokenizer.encode(augmented_query, return_tensors="pt") output_ids = model.generate(input_ids, max_length=500) response = tokenizer.decode(output_ids[0], skip_special_tokens=True)</p> print(response)


