
Kąt Andersona
System Machine Learning do Przerabiania Artykułu Podczas Jego Czytania

 Dodaj Unite.AI do preferowanych źródeł w Google
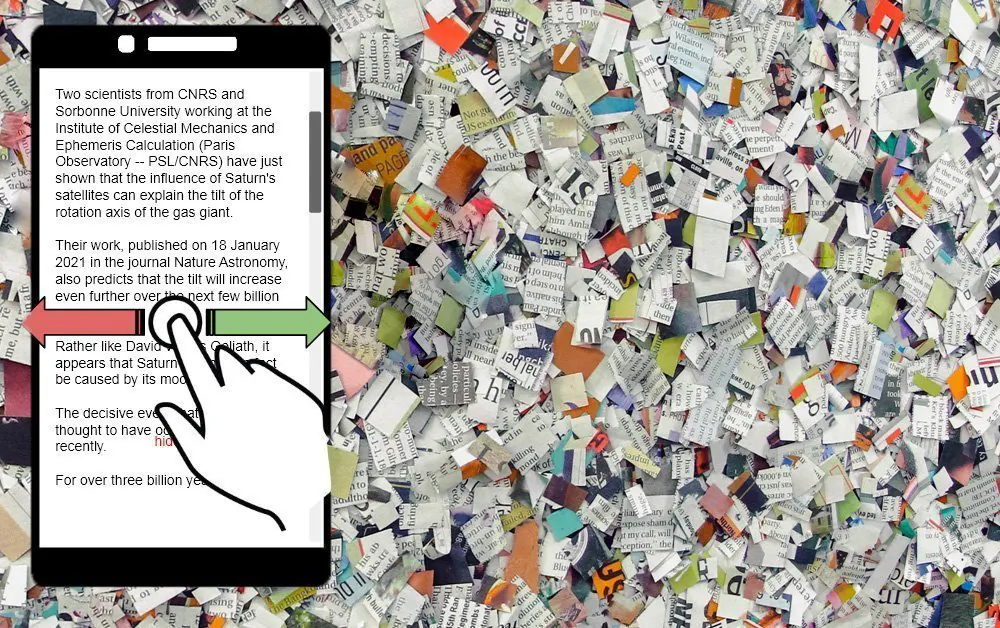
Nowe badania z Kanady proponują metodę automatycznego przerabiania artykułu podczas jego czytania, w oparciu o “przewijanie” w stylu Tinder lub bierną obserwację interakcji czytelnika z różnymi rodzajami zawartości, które artykuł zawiera.
System, zatytułowany Hone As You Read (HARE), został przedstawiony w artykule z Western University w Ontario, Kanada, z odpowiadającym kodem Python na GitHub.
Głównym pomysłem projektu jest to, że artykuł może zawierać różne rodzaje zawartości, rozwijające się (podobnie jak ten) od nagłówka do dalszych szczegółów. Późniejsze części artykułu mogą zawierać różne rodzaje materiałów wspierających, przypadki użycia lub hipotezy lub przypuszczenia dotyczące konsekwencji wiadomości.
Pod HARE, jeśli nie lubisz tego rodzaju materiału, możesz go zagłosować w dół na podstawie akapitu, podczas gdy system uczy się Twoich preferencji, tak aby do czasu, gdy przewijasz w dół, zawartość podobna do materiału, który “zagłosowałeś w dół”, została już usunięta lub przerobiona. Jeśli nie chcesz aktywnie uczestniczyć w szkoleniu systemu, HARE może wywnioskować Twoje wybory, obserwując Twoje bierną interakcję z dokumentem.
Głosowanie w stylu Tinder dla nieprzyjemnych zdań
Na poniższym obrazie widzimy trzy możliwe rodzajeinferowanej kategoryzacji dla HARE, w oparciu o wyraźne lub niejawne zachowanie użytkownika. W pierwszym przypadku (po lewej), użytkownik aktywnie “przewija w lewo” (lub w prawo), w geście głosowania w stylu Tinder, wyrażając aprobatę lub niezadowolenie w zawartości akapitu lub zdania, lub w jego stylu, złożoności lub tonie.

Źródło: https://arxiv.org/pdf/2105.02923.pdf
W drugim przypadku (środek), system używa czasu przestoju jako miary zainteresowania użytkownika, w oparciu o pozycjonowanie i czas trwania przerwy w przewijaniu.
W trzecim przypadku (po prawej), HARE używa kamery smartfona do oszacowania ścieżki i czasu przestoju położenia wzroku widza na akapity widocznego dokumentu.
Badacze twierdzą, że zwiększony czas przestoju na dowolnym akapicie może wskazywać na zwiększone zainteresowanie użytkownika, choć logicznie nie musi to być przypadku, gdy widz stara się przyswoić tekst, który może być skomplikowany lub po prostu źle napisany.

Opinia użytkownika edytuje, przerabia lub całkowicie kasuje jeszcze niewidoczne części artykułu.
Przetwarzanie zawartości zgodnie z preferencjami użytkownika
Artykuł dotyczy doświadczenia użytkownika HARE na podstawie artykułu, ale jasne jest, że historyczna interakcja użytkownika z dokumentami pozwala na dostosowanie przyszłych doświadczeń czytania, poprzez ciągłe rozpoznawanie rodzajów zawartości i stosowanie szablonów preferencji użytkownika do nowych artykułów, tak aby potrzeba interakcji zmniejszała się, gdy użytkownik widzi coraz mniej “niepożądanej” zawartości.
HARE jest charakteryzowany jako algorytm podsumowujący, pozwalający na przerobienie niewidocznej zawartości dalej na stronie w kwestii stylu lub zwięzłości przed tym, jak użytkownik do niej dotrze; ale artykuł wyjaśnia, że może również zapobiec usunięciu zawartości na podstawie opinii użytkownika.
Do celów testowych system wykorzystał korpus 11 222 artykułów z brytyjskiej gazety Daily Mail i został oceniony za pomocą testowego wdrożenia na aplikacji Telegram. Artykuły z mniej niż dziesięcioma akapitami zostały odrzucone dla celów próbnych.

Aplikacja Telegram HARE w fazie testowej z użytkownikami.
Metodologia badaczy wykorzystuje K-Means clustering na SBERT osadzaniu zdań w artykułach, z początkowo losowymi wagami dla pojęć.
Wśród szerokiej grupy algorytmów i podejść HARE posiada trzy modele porównawcze, z których pierwszy (ORACLEGREEDY) ma dostęp do wcześniejszych preferencji użytkownika, wskazując na zamiar, że algorytm mógłby przetwarzać artykuły podczas ładowania, a nie interaktywnie.
Pozostałe modele, ORACLESORTED i ORACLEUNIFORM, wybierają zdania na podstawie poziomu zainteresowania lub losowo w całym artykule.
Usuwanie i przerabianie zawartości
Zaskakująco, ORACLEUNIFORM przewyższył zestaw kontrolny, nawet pomimo braku dostępu do wcześniejszych zainteresowań użytkownika. Badacze twierdzą, że jest to dlatego, że zajmuje się całym artykułem w jednym przejęciu, “wybierając tylko najbardziej interesujące zdania”. Badacze przyznają, że może to ograniczyć dostępną zawartość do zdań, które zajmują się tylko najważniejszym pojęciem, logicznie usuwając inne teksty, które mogą dotyczyć konsekwencji lub oceny pojęcia.
Wykorzystane w HARE są extractory podsumowujące LexRank, SumBasic i TextRank.
HARE został przetestowany na 13 ochotnikach w ciągu 70 prób i różnych podejść algorytmicznych i był w stanie zaktualizować podsumowania (przerobiony/usunięty tekst) w czasie od 1,3 milisekund do 100 ms na laptopie konsumenckim, w zależności od testowanego modelu. Wyniki wykazały, że modele, które usunęły najwięcej tekstu, nie działały dobrze, głównie dlatego, że może to wpłynąć na spójność pozostałego tekstu.
Etyczne implikacje dynamicznego przerabiania artykułów
Badacze przyznają, że istnieją obawy etyczne dotyczące technologii tego rodzaju:
‘Zadanie HARE jest przeznaczone do projektowania przyszłych aplikacji użytkowych. Z założenia te aplikacje mają możliwość kontrolowania tego, co użytkownik czyta z danego artykułu. Możliwe, że gdy zostaną wdrożone bez wystarczającej staranności, mogą one nasilić efekt “echo-chamber”, już wytwarzany przez automatyczne kanały informacyjne, wyniki wyszukiwania i społeczności internetowe.’
Jednakże, zauważają również, że taki system mógłby być wykorzystany w przyszłych aplikacjach do złagodzenia efektu “echo-chamber”, wstrzykując tekst, który proponuje alternatywne punkty widzenia, które mogły nie być obecne w artykule. Obserwują: ‘Waga tego czynnika mogłaby być dostosowana do zapewnienia zarówno angażującego doświadczenia czytania, jak i narażenia na różnorodność idei.’
Osoby, które mogą skorzystać z takiego systemu, według badaczy, to czytelnicy, którzy chcą zaoszczędzić czas na przyjmowanie informacji, oraz wydawcy treści.


