
Grunnleggende AI
Hva er forsterkningslæring fra menneskelig tilbakemelding (RLHF)?

 Legg til Unite.AI blant dine foretrukne kilder på Google
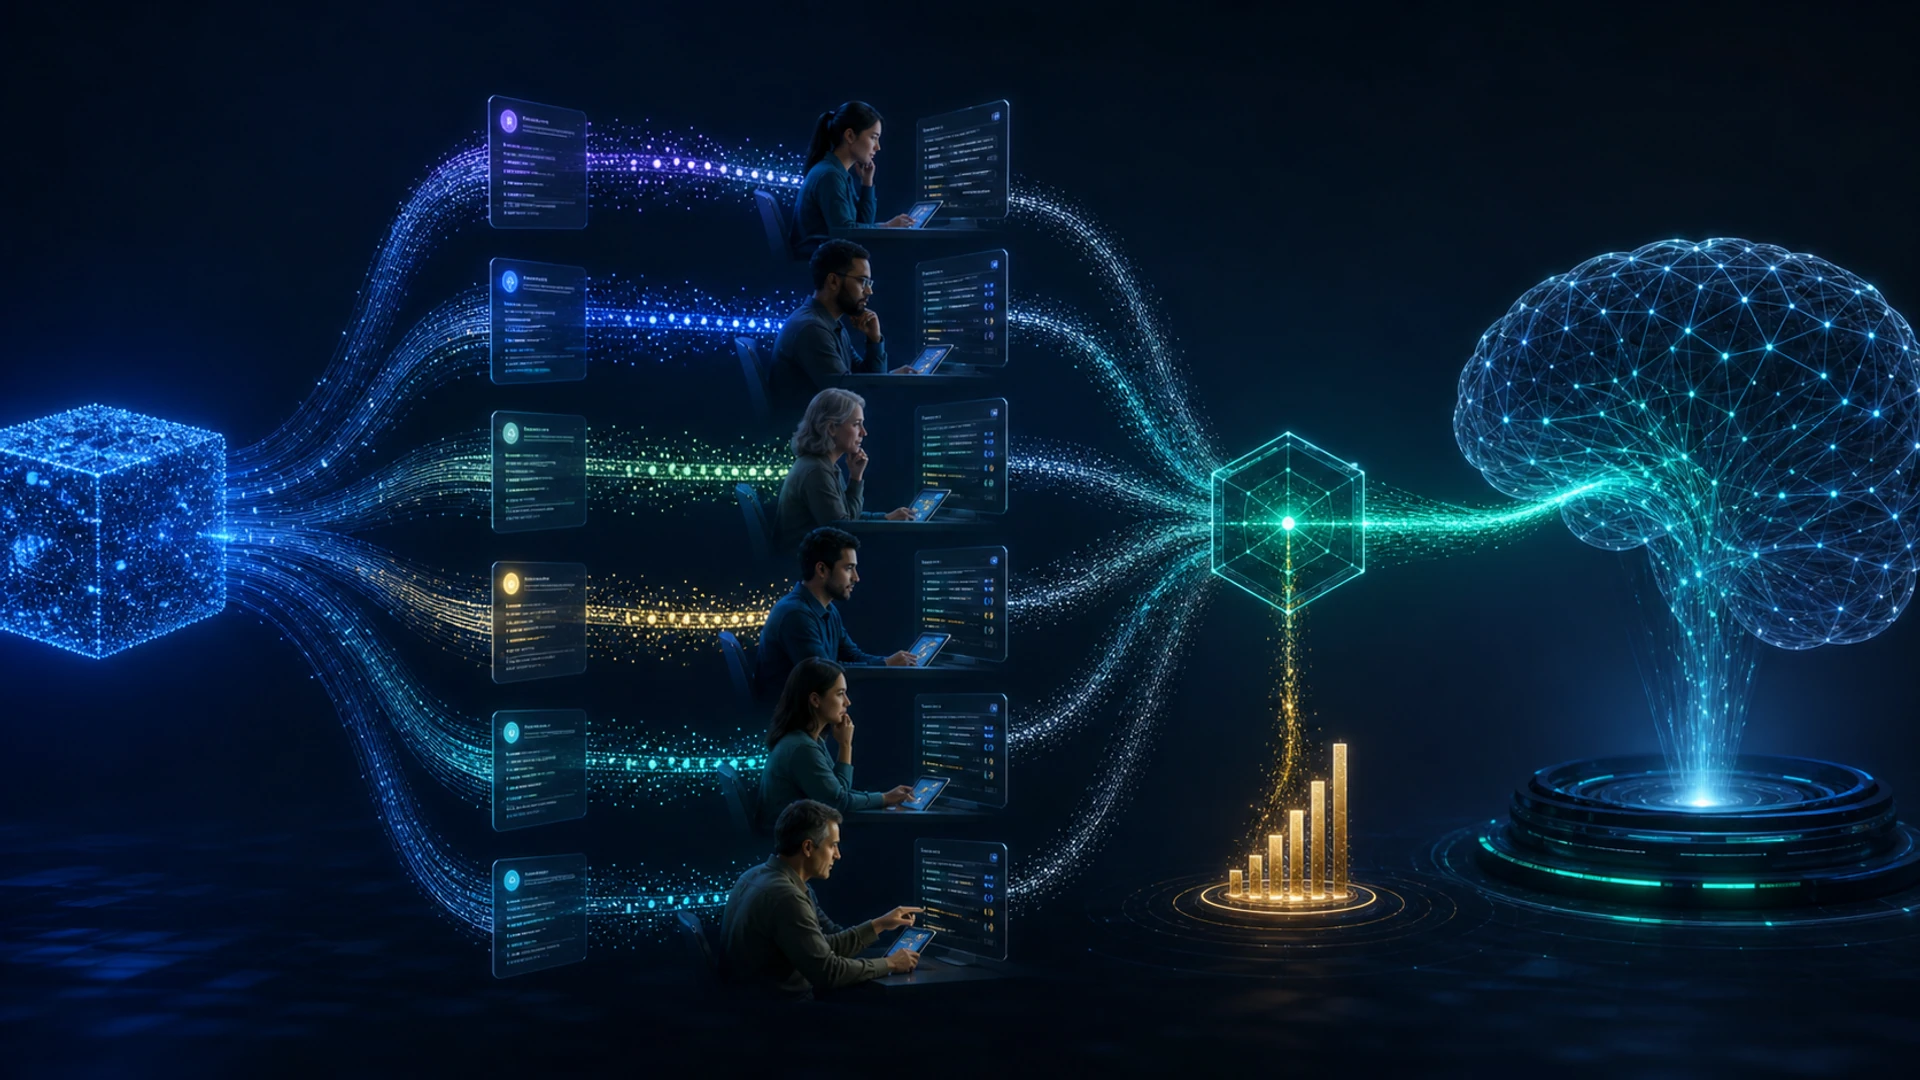
Forsterkningslæring fra menneskelig tilbakemelding (RLHF) er en familie av metoder som bruker menneskelige vurderinger for å hjelpe med å optimalisere en modell når ønsket atferd er vanskelig å spesifisere med en enkel automatisk belønning. For språkmodeller sammenligner folk ofte kandidatresponsene, og en lært preferansemodell omgjør disse sammenligningene til et treningssignal.
RLHF kan gjøre en forhåndstrent modell mer hjelpsom eller bedre tilpasset en skriftlig policy, men det garanterer ikke sannferdighet eller samsvar med hver bruker. Resultatet avhenger av hvem som gir tilbakemeldingen, hvordan promptene velges, hva belønningsmodellen kan representere, og hvordan optimaliseringen er begrenset.
Viktige punkter
- RLHF følger vanligvis forhåndstrening og veiledet instruksjonsjustering.
- Parvise preferanser trener en belønnings‑ eller preferansemodell; policy‑optimalisering foretrekker deretter resultater med høyere poeng.
- Belønningshacking, annotatormotstand, distribusjonsforskyvning og overoptimalisering er fortsatt viktige risikoer.
- Evaluer den endelige policyen direkte for oppgavekvalitet, sikkerhet, kalibrering og effekter på undergrupper.
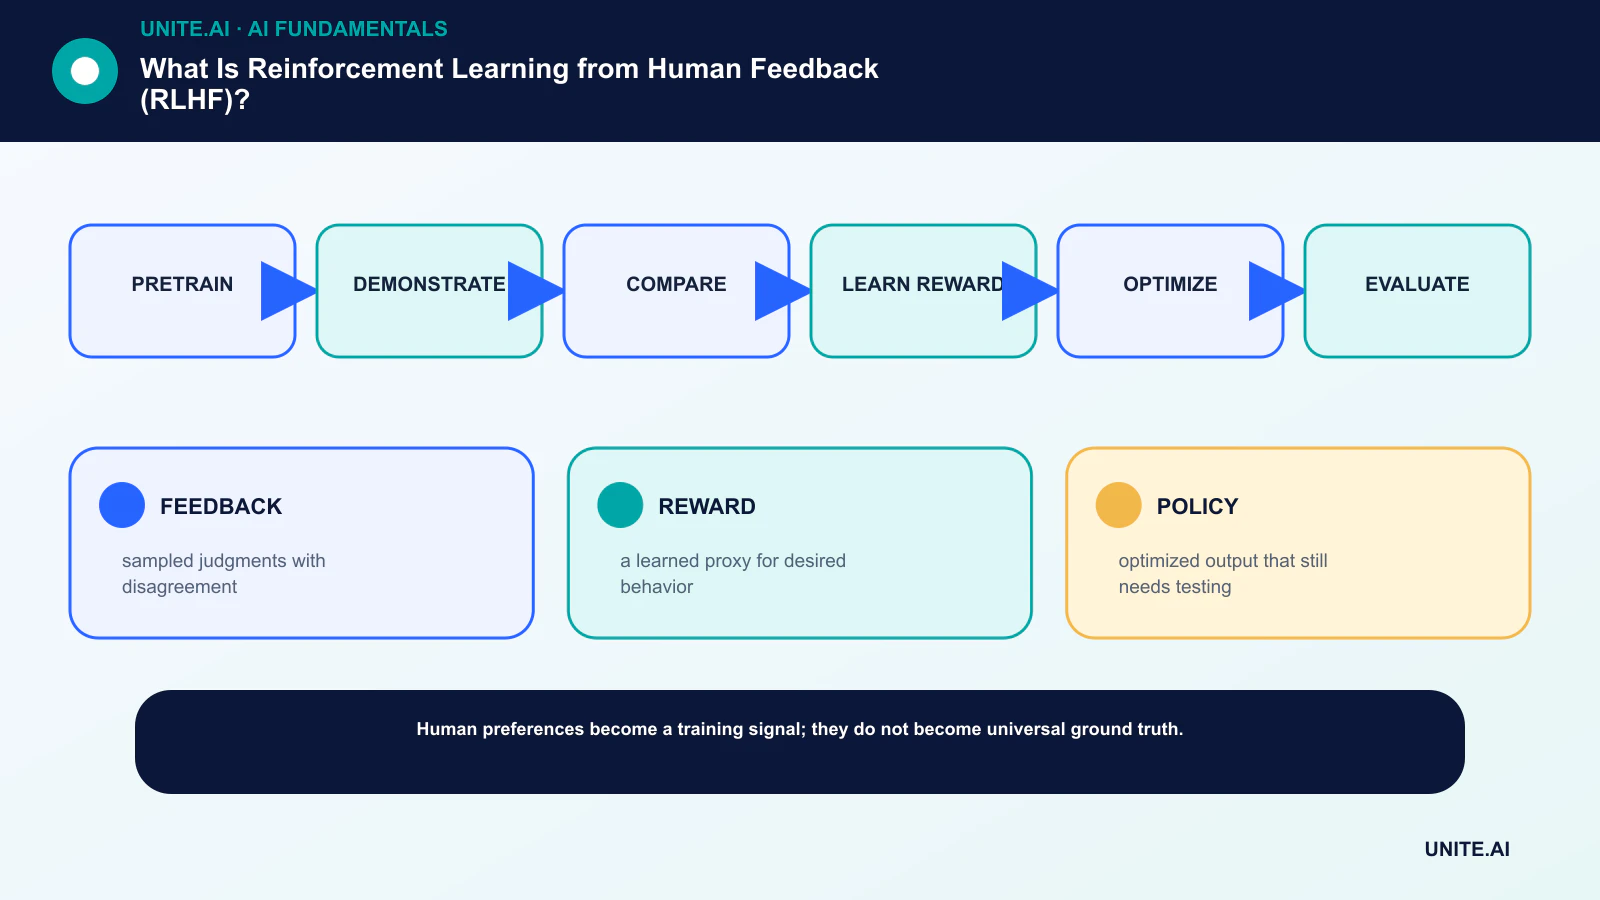
Den vanlige RLHF‑pipeline
En språkmodell lærer først bred statistisk struktur gjennom forhåndstrening. Veiledet finjustering bruker deretter demonstrasjoner av ønskede svar. For innsamling av preferanser rangerer eller velger annotatorer mellom svar på samme prompt.
En belønningsmodell lærer å forutsi disse sammenligningene. En reinforcement-learning algoritme som PPO kan optimalisere språkmodellen mot den lærte belønningen, mens en straff hindrer den i å avvike for langt fra referanse‑policyen.
Tilbakemelding er måling, ikke sannhetsgrunnlag
Annotatorer kan være uenige fordi instruksjonene er tvetydige, ekspertise varierer, eller verdier faktisk er i konflikt. Posisjon, ordlystetthet, selvtillit og stil kan påvirke preferanser. Et høykvalitetsprogram trener vurderere, måler enighet, reviderer eksempler og bevarer usikkerhet.
Utvalg er også viktig. Hvis preferansesettet ekskluderer vanskelige språk, domener eller skadelig innhold, kan ikke belønningsmodellen pålitelig veilede dem. Data-science-disciplin er like viktig som optimalisatoren.
Feilmoduser
Policyen kan utnytte svakheter i den lærte belønningen, og produsere resultater som får høy poengsum uten å oppfylle den underliggende intensjonen. Overdreven optimalisering kan redusere mangfold, forsterke en foretrukket stil, eller få modellen til å svare selvsikkert og ettergivende.
Selve belønningsmodellen kan svikte utenfor sin treningsfordeling. Team bør teste motstridende prompt, faktuelle oppgaver, avslagsterskler, kalibrering og atferd ved ulike optimaliseringsstyrker i stedet for å stole på én samlet preferanse‑vinnerate.
Alternativer og komplementer
Direkte preferanseoptimalisering lærer fra preferansepar uten å tilpasse en separat policy gjennom en online forsterknings‑læringssløyfe. Avvisningsutvalg, veiledet preferanse‑finjustering, regelbasert tilbakemelding og prosess‑overvåkning gir andre avveininger.
Ingen metode fjerner behovet for prompt‑, gjenopphentings‑, verktøy‑ og applikasjonsnivåkontroller. Etter‑trening former atferd; distribuerte systemer krever fortsatt forankret bevis, tillatelser, overvåkning og menneskelig eskalering.
Hvordan preferansemodeller trenes
For en prompt x og to svar y₁ og y₂ tilordner en preferansemodell skalarpoeng og trenes slik at det foretrukne svaret får høyere poeng. Et vanlig tap er basert på sannsynligheten for at ett poeng overstiger det andre. Dette omgjør mange parvise vurderinger til en funksjon som kan poengsette nygenererte resultater.
Modellen lærer hvilke signaler som forutsier de innsamlede valgene. Hvis vurderere foretrekker selvsikker prosa, lengre svar, spesifikke kulturelle normer eller kjente synspunkter, kan disse korrelasjonene bli belønningsfunksjoner. Balanserte instruksjoner, moteksempler, ekspertvurdering og revisjoner av overfladiske preferanser reduserer, men eliminerer ikke problemet.
Preferansedata kan inkludere likhet, rangeringer, kritikker, skalar‑etiketter eller demonstrasjoner. Parvalg er viktig: sammenligninger mellom åpenbart ulike svar lærer mindre om subtile kvalitetsgrenser, mens kun vanskelige par kan gjøre treningen ustabil. Aktiv prøvetaking kan målrette informerende uenigheter, men kan endre datadistribusjonen.
Policy‑optimalisering og regularisering
PPO‑basert RLHF trekker svar fra den nåværende policyen, poengsetter dem med belønningsmodellen, og oppdaterer policyen for å øke forventet belønning. En Kullback–Leibler‑straff eller tilsvarende begrensning holder policyen nær den veiledede referansen, begrenser destruktiv avdrift og motvirker utnyttelse av smale svakheter i belønningsmodellen.
Optimaliseringsstyrken er et produktvalg. For lite etterlater ønsket atferd uendret; for mye kan føre til belønningshacking, repeterende formuleringer, smiger eller redusert mangfold. Visualiser kvalitet‑ og sikkerhetsmålinger mot belønning og avvik gjennom hele treningen i stedet for kun å velge et sjekkpunkt basert på belønning.
Direkte preferansemetoder utleder et mål fra preferansepar og en referansemodell uten en eksplisitt online RL‑sløyfe. De kan forenkle trening, men arver fortsatt preferansekvalitet, dekning og antakelser om referanse‑policy. Konstitusjonell eller AI‑generert tilbakemelding endrer hvem som leverer etiketter; den fjerner ikke behovet for å validere verdier og feil med mennesker.
Evaluering og datastyring
Bruk blinde sammenligninger, oppgavespesifikke tester, motstridende prompt, faktasjekker, avslag‑presisjon og -rekall, og gjennomgang av undergrupper. Skil evaluatorer fra treningsdata så langt det er mulig. En vinnerate mot en eldre modell kan skjule absolutte feil når begge kandidatene er dårlige.
Dokumenter annotatorrekruttering, kompensasjon, ekspertise, geografi, språk, instruksjoner, eksponering for skadelig innhold, uenighet, avgjørelse og kvalitetskontroller. Tilbakemeldingsarbeid kan medføre psykologisk risiko, og ansvarlige dataoperasjoner inkluderer støtte til arbeidere og retten til å avslå forstyrrende oppgaver.
Etter utrulling, overvåk preferansedrift og overgeneralisering. En policy finjustert for uformell assistanse kan oppføre seg dårlig i medisinske eller juridiske sammenhenger. Hold domenegrenser, gjenopphenting, tillatelser og eskalering utenfor RLHF‑antakelsen, og tren på nytt kun når ny evidens rettferdiggjør endringen.
En konkret RLHF‑trenings‑ og evalueringspipeline
Et typisk prosjekt starter med en forhåndstrent språkmodell og et instruksjonsdatasett brukt til veiledet finjustering. Annotatorer sammenligner deretter kandidatresponsene under et skriftlig rubrikk som dekker korrekthet, relevans, stil, sikkerhet og usikkerhet. Parvise preferanser trener en belønningsmodell eller optimaliserer policyen direkte. Utvalg må inkludere vanlige oppgaver, vanskelige kanttilfeller, motstridende prompt, flere språk, og områder hvor annotatorer legitimt er uenige.
Belønningsmodellens nøyaktighet på hold‑out‑sammenligninger er nødvendig, men ikke tilstrekkelig. Den optimaliserte policyen kan utnytte feil i den lærte belønningen, bli overdrevent omfattende, avslå harmløse forespørsler, eller miste evner. Spor oppgave‑benchmarker, menneskelig preferanse, kalibrering, sikkerhet, mangfold og avvik fra referansemodellen gjennom treningen. Samle periodisk inn nye sammenligninger fra den endrende policyen slik at preferansedataene dekker resultatene modellen faktisk produserer.
Dokumenter hvem som leverte preferanser, deres instruksjoner, kompensasjon, uenighet, kvalitetskontroller og kulturelle eller domenespesifikke grenser. Bruk ekspertvurderere der feil kan medføre spesialisert skade. Red‑team både belønningsmodellen og den endelige policyen, oppretthold regresjonstester for atferd, og trinnvis utrulling. RLHF former atferd i henhold til målte preferanser; den beviser ikke sannferdighet, eliminerer ikke skjevhet, eller løser det bredere problemet med å spesifisere hva en modell skal gjøre i enhver kontekst.
Praktisk implementeringssjekkliste
Gjør konseptet til en avgrenset, testbar arbeidsflyt: forhåndstrening → demonstrasjon → sammenligning → lær belønning → optimalisering → evaluering. Navngi en ansvarlig eier, dokumenter data og avhengigheter, etabler en enkel basislinje, sett aksept‑ og stoppkriterier, test representative feil, og definer overvåking, tilbakeføring og gjennomgang før omfanget utvides. Registrer versjoner og antakelser slik at et annet team kan gjenskape resultatet og forstå hva som har endret seg.
Før lansering, gjennomfør en dokumentert beredskapsgjennomgang med personene som bygger, drifter, sikrer og påvirkes av systemet. Test normale tilfeller, grensetilstander, avhengighetsfeil og misbruk; bevar bevisene og uavklarte risikoer. Definer hvem som kan godkjenne utgivelse, endre en terskel, overstyre et resultat, eller stoppe driften. Revurder beslutningen etter at virkelige data kommer inn, fordi en teknisk vellykket pilot ikke garanterer pålitelig ytelse i større skala.
- FEEDBACK: utvalgte vurderinger med uenighet.
- REWARD: en lært erstatning for ønsket atferd.
- POLICY: optimalisert resultat som fortsatt må testes.
Ofte stilte spørsmål
Er RLHF det samme som finjustering?
RLHF er en form for etter‑trening som bruker preferanse‑avledede belønninger. Veiledet finjustering trener direkte på mål‑output; mange pipelines bruker begge.
Gjør RLHF en modell sannferdig?
Den kan forbedre atferd målt gjennom tilbakemeldingsprosessen, men en modell kan fortsatt være feil, overbevisende, eller strategisk utnytte belønningen. Sannferdighet krever direkte evaluering og forankring.
Primære referanser












