
AIの基礎
インフルエンスエンジニアリング: パーソナライゼーション、説得、AI倫理

 Unite.AI を Google の優先ソースに追加
インフルエンスエンジニアリングは、注意、選択、行動を意図的に形作るデジタルシステムを設計するための有用な総称です。レコメンデーション、パーソナライゼーション、実験、説得的インターフェース設計、感情に関連するシグナルはすべて要素となり得ますが、この用語は単一の標準的定義を持つ確立された技術分野ではありません。
中心的な問いは、システムが個人の目標を支援するのか、あるいは隠れた、欺瞞的、または搾取的な仕組みで導くのかです。予測精度が高まるほど、同意、透明性、機微な推論への制限、独立したレビュー、そして測定可能なユーザー福祉が求められます。
主なポイント
- 意図、手法、開示、ユーザーコントロールを検証し、利益になる指導と操作を区別する。
- 推測された感情は確率的モデルの出力であり、個人の内部状態への直接的なアクセスではありません。
- エンゲージメントだけでなく、ユーザーの成果と長期的福祉を最適化する。
- 意味のある選択肢、データ最小化、争点化、そして不均衡な影響の監視を提供する。
デジタルインフルエンスの仕組み
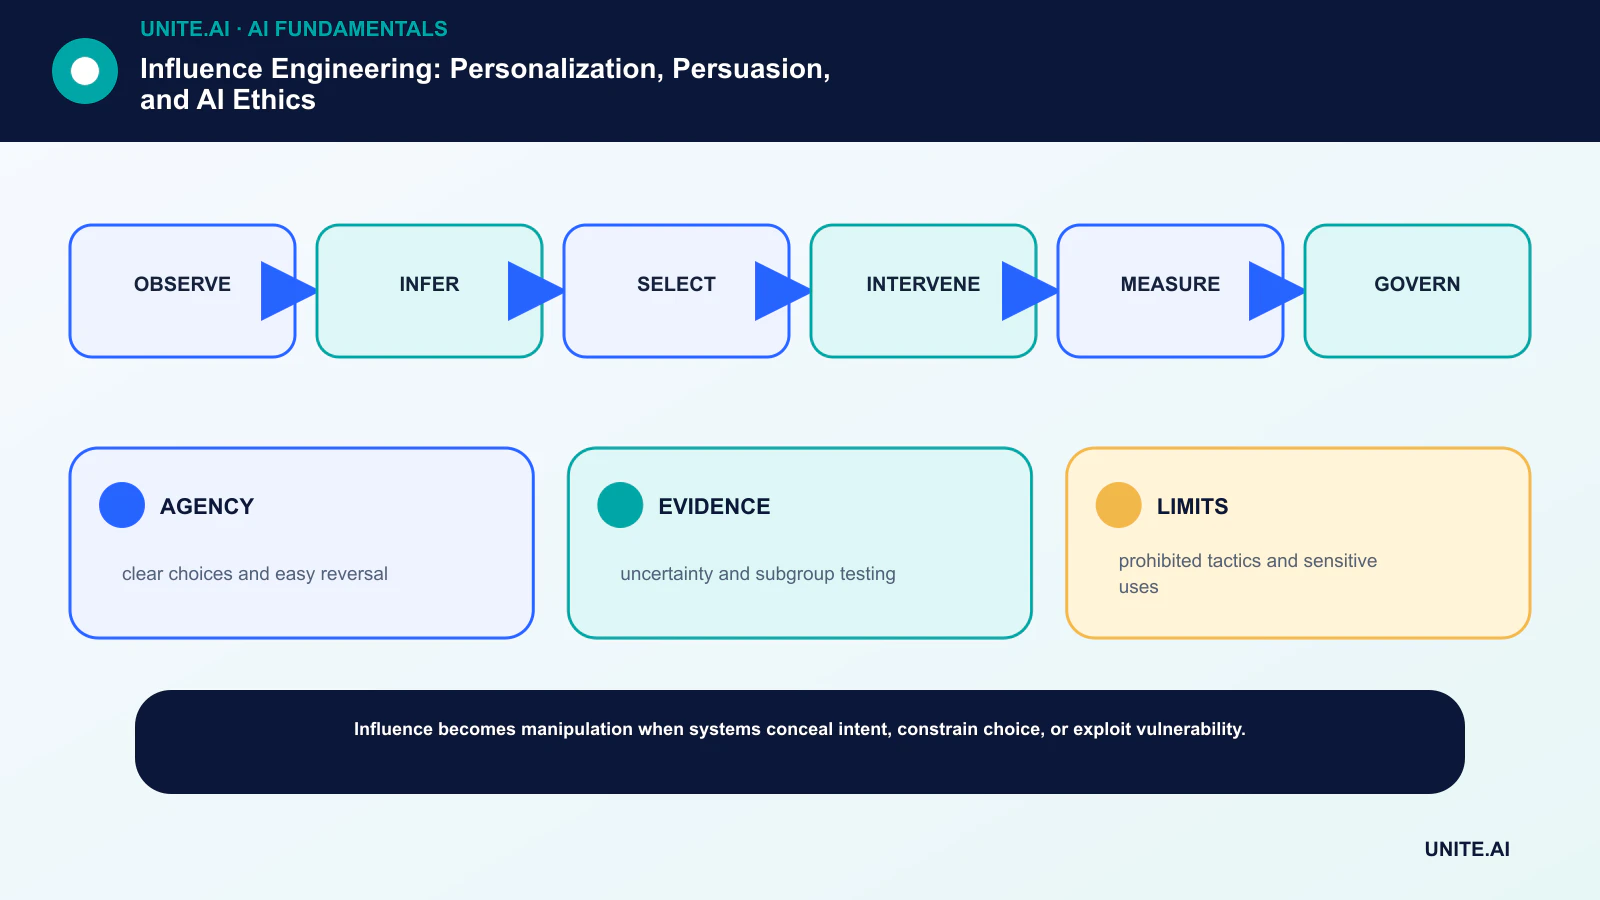
システムは行動を観測し、ユーザーまたはコンテキストモデルを構築し、介入を選択し、反応を測定し、ポリシーを更新します。介入にはランキング、タイミング、デフォルト設定、ソーシャルキュー、表現、通知、価格、あるいは対話的な応答が含まれます。
このフィードバックループは強化学習に似ていますが、報酬は価値判断をエンコードしています。クリック数やセッション時間は測定しやすい一方、情報に基づく選択、信頼、長期的な利益は測定が難しく、しかししばしばより重要です。
感情AIが入る場所
感情AIは顔の動き、声、言語、生理、またはインタラクションからパターンを推定できます。これらのシグナルは文脈依存であり、文化的に変動します。モデルはラベル付けされたカテゴリを予測できても、実際に誰かが何を感じているかを確立するわけではありません。
このような予測を用いてメッセージ、価格、機会を変更すると、機微なフィードバックループが生じる可能性があります。パフォーマンスはサブグループや文脈別に評価すべきであり、システムはサービスが実際に必要とする以上の推論を行うべきではありません。
説得、支援、そして操作
ユーザーが選択したプランに従うのを支援するナビゲーションプロンプトは、偽装広告やキャンセルを困難にする妨害とは異なります。目的が開示されているか、代替手段が利用可能か、合理的な人物が選択を理解し逆転できるかを評価してください。
ダークパターンは情報や労力の非対称性を利用します。生成的インターフェースは言語を継続的に調整することでこれらの手法を拡大できるため、保護策は目的と実験システム全体をカバーすべきであり、単に見える画面だけでは不十分です。
ガバナンスと評価
意図された利益、影響を受けるグループ、禁止された手法、データソース、保持期間、最適化目的、レビュー担当者を文書化します。展開前テストには脆弱なユーザー、敵対的シナリオ、即時のコンバージョン以外の成果を含めるべきです。
苦情、逆転、後悔、露出頻度、サブグループの成果、予期しない行動を監視します。バイオメトリクス、消費者保護、雇用、教育、健康に関する規則が適用される場合は、責任あるAIのコントロールと法的レビューを適用してください。
インフルエンス背後の最適化システム
インフルエンスシステムは単一モデルではなく、パイプラインであることが多いです。候補ジェネレータが可能なメッセージやアイテムを選択し、ランキングモデルがスコア付けし、実験フレームワークが処置を割り当て、フィードバックサービスが行動を記録します。アイデンティティ解決とユーザープロファイルがセッション間の観測を結びつけるため、プライバシーと目的制限が中心的なアーキテクチャ上の選択となります。
最適化目標はクリックのような即時的なものや、コース修了や継続的な健康行動のような遅延的なものがあります。代理指標はゲーム化を招きやすく、たとえば通知ポリシーは不安を生むことで開封数を増やし、レコメンダーは視聴時間を伸ばす一方で満足度を低下させることがあります。チームは最適化に入る前にガードレール指標と長期的成果を定義すべきです。
バンディットや強化学習手法は探索を加えますが、探索は実際の人々を不確実な介入にさらします。アクションセットに上限を設け、機微な文脈を除外し、頻度に上限を設け、保守的なポリシーを使用してください。オフラインシミュレーションだけでは社会的反応を完全に予測できないため、段階的実験と停止基準は依然として必要です。
測定、因果関係、そして脆弱なユーザー
A/Bテストは割り当てと測定の前提のもとで平均的な因果効果を推定しますが、小規模グループに集中した害や同時実験間の相互作用、遅延効果、製品を離れたユーザーなどを見落とす可能性があります。ヘッドライン的なコンバージョン向上だけでなく、分布的な成果も報告してください。
パーソナライゼーションは、ユーザーごとに異なる介入が表示されるため、説明を複雑にします。ポリシーのバージョン、適格性、文脈、選択理由を保持してください。保護された特性や機微な属性が直接使用されているか、間接的に推論されているか、位置情報、デバイス、言語、閲覧パターンなどの特徴と相関しているかを監査します。
子ども、困窮状態にある人、財政的に制約のあるユーザー、健康や雇用の決定に直面している人は、特にカスタマイズされた圧力に対して脆弱です。緊急性、社会的証明、変動報酬、感情的ターゲティングなど、これらの状況を利用する手法は避けてください。独立したレビューは、収益が向上していても最適化を禁止する権限を持つべきです。
正当なインフルエンスの設計要件
正当なシステムは目的を明示し、スポンサーシップを可視化し、レコメンデーションと事実を分離し、個人がパーソナライゼーションを変更または無効化できるようにします。デフォルトは合理的な期待を反映すべきです。同意は、データとインフルエンスメカニズムを広範な用語に隠すことなく、具体的に記述できる程度に詳細でなければなりません。
露出コントロール、静粛期間、リセット、プロファイル検査、レコメンデーションの主要要因の説明を提供してください。摩擦を非対称に使用しないでください—購読はワンクリックで済むのに、退会は複数の混乱した画面が必要といったことです。ユーザーはサービスと無関係な罰則なしに決定を逆転できるべきです。
ガバナンスは目的、機能ソース、実験設計、苦情のテーマ、下流の成果をレビューすべきです。インフルエンスシステムとハイリスク実験のレジストリを維持してください。有害なパターンが現れた場合、ポリシーを無効化し、証拠を保存し、適切に影響を受けたユーザーに通知し、そこから生じたインセンティブを変更します。
実践的なインフルエンスリスク評価
インフルエンスシステムは、アクター、目的、対象、データ、モデル、メッセージ、チャネル、フィードバックループ、結果をマッピングすることで評価します。支援と説得、説得と操作を区別してください。ユーザーが選んだリマインダーは、強迫的なエンゲージメントを狙った隠れた最適化とは異なります。システムが脆弱性を狙い、スポンサーシップを隠し、感情状態を利用し、偽の緊急性を作り出す、または重要なサービスへのアクセスを行動応答に依存させる場合、リスクは高まります。
展開前に、パーソナライゼーションが理解、自治、グループ間の成果を変えるかどうかをテストしてください。インフォームドレビュー付きの統制実験を使用しますが、クリックやコンバージョンだけを最適化しないでください。後悔、苦情、オプトアウト、下流の害、ユーザーがメッセージ受信理由を特定できるかを測定します。必要でない機微な推論を禁止し、許容できる目的を制限し、適格性や価格決定を感情応答の最適化から分離してください。
インターフェースは合成エージェントとスポンサー付きコミュニケーションにラベルを付け、実質的なパーソナライゼーションを説明し、意味のあるコントロールを提供すべきです。キャンペーン、ターゲットルール、モデルバージョン、クリエイティブバリエーション、承認の監査可能な記録を保持し、不要な感情データは保持しません。独立したレビューは、政治、金融、健康、雇用、教育、子ども向け利用に適しています。中心的な問いはインフルエンスが起きるかどうかではなく、その目的、証拠、手法、権力関係が情報に基づく人間の主体性を尊重しているかどうかです。
実装チェックリスト
概念を限定的で検証可能なワークフロー: 観測 → 推論 → 選択 → 介入 → 測定 → ガバナンス に変換します。責任者を指名し、データと依存関係を文書化し、シンプルなベースラインを設定し、受容基準と停止基準を定め、代表的な失敗をテストし、スコープ拡大前にモニタリング、ロールバック、レビューを定義してください。バージョンと前提条件を記録し、他のチームが結果を再現し、変更点を理解できるようにします。
リリース前に、構築・運用・セキュリティ・影響を受ける担当者と共に文書化された準備レビューを実施します。通常ケース、境界条件、依存失敗、誤用をテストし、証拠と未解決リスクを保存してください。リリース承認、閾値変更、出力上書き、運用停止が誰にできるかを定義します。実データが入った後に判断を再検討してください。技術的に成功したパイロットでも、広範なスケールでの信頼できるパフォーマンスが保証されるわけではありません。
- エージェンシー: 明確な選択肢と容易な逆転。
- エビデンス: 不確実性とサブグループテスト。
- 制限: 禁止された手法と機微な利用。
よくある質問
すべてのパーソナライゼーションは操作ですか?
いいえ。パーソナライゼーションは労力を削減し、関連性を向上させることができます。目的が隠蔽され、選択肢が制限され、機微な特性が推測され、またはシステムが脆弱性を利用する場合にリスクが高まります。
AIシステムは人の感情を知ることができますか?
モデルとデータセットに基づき、観測可能なシグナルからラベルを推定することは可能です。その推定は不確実で文脈依存であり、内部状態への直接的な知識として提示すべきではありません。
主要参考文献












