
Andersonの視点
ユニチューン:Googleの代替ニューラルイメージ編集技術

 Unite.AI を Google の優先ソースに追加
要点UniTuneは、単一の画像で拡散モデルを微調整し、テキスト駆動による精密な編集を可能にする。
もっと見る
- UniTuneは、単一の画像で拡散モデルを微調整し、テキスト駆動による精密な編集を可能にする。
- DreamBoothやTextual Inversionとは異なり、UniTuneは詳細な保存を向上させるために両方のアプローチを拒否する。
- この手法は高い意味的切り離しを実現し、背景の大幅な変換中でも顔をそのまま維持する。
Google Researchは、テキストベースのイメージ編集に対して、多角的なアプローチを取っているようです。今週発表されたImagic論文に続き、Googleは、別の方法では不可能なAI画像編集をテキスト命令で行う潜在拡散ベースの方法、UniTuneを提案しました。
プロジェクトの新しい論文に示されている例から、UniTuneは、セマンティックポーズとアイデアを実際の画像コンテンツから分離することに、驚くほどの程度の成功を収めています。

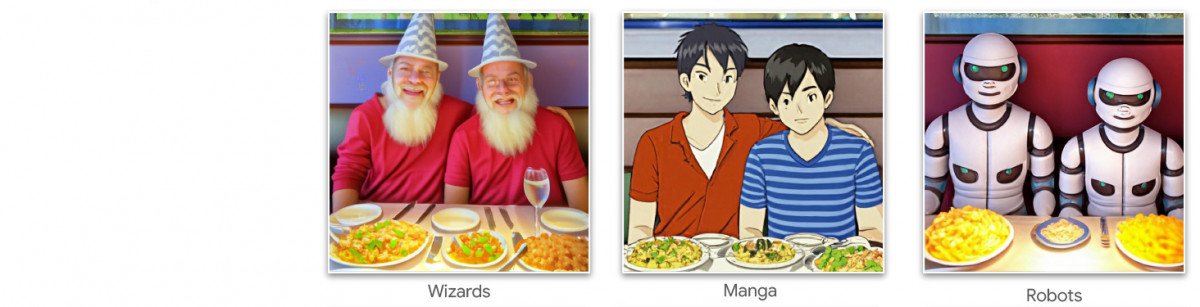

ユニチューンのセマンティック構成のコマンドは、優れています。上段の画像の右側の画像を見てください。2人の人の顔は、他の部分の変換によって歪んでいません。
Stable Diffusionのファンは、画像の他の部分を損なわずに一部の領域を編集することは、時々不可能な操作であることを学んできました。人気のある配布版であるAUTOMATIC1111は、ローカル編集と制限された編集のマスクを作成できますが、このプロセスは難しく、予測不可能です。
明らかな答えは、コンピュータビジョンの専門家にとって、セマンティックセグメンテーションの層を挿入することです。これは、画像内のオブジェクトをユーザーの介入なしに認識して分離することができます。実際、最近、この考え方に基づく新しい取り組みがいくつかありました。
別の可能性は、OpenAIの影響力のあるContrastive Language-Image Pre-training(CLIP)モジュールを利用することです。これは、DALL-E 2やStable Diffusionなどの潜在的な拡散モデルの中核です。このコンテキストでは、CLIPは、テキストから画像へのモデルがユーザーにレンダリングを送信するポイントでフィルタおよび品質管理モジュールとして機能する必要があります。このアプローチは、Stability.aiのDreamStudio API駆動のポータルでまもなく採用される予定です(Discordリンク)。
しかし、CLIPは、ある意味で、問題と解決策の両方です。なぜなら、CLIPは、画像が進化する方法も教えたからです。さらに、ハードウェアの要件は、エンドユーザーがローカルで利用できるものを超える可能性があります。このアプローチは、理想的ではないかもしれません。
圧縮言語
提案されたユニチューンは、他の潜在拡散アーキテクチャにも対応すると研究者が述べる方法であり、、既存の拡散モデル(この場合は、GoogleのImagen)を「ファインチューン」します。ユニークなトークンがモデルに挿入され、テキストプロンプトに含めることで呼び出されます。
一見すると、Stable Diffusionの利用者や開発者が熱中するGoogleのDreamBoothに似ています。数枚の元画像だけで、しばしば1時間未満で既存のチェックポイントに新しい人物や物体を追加できます。あるいは、チェックポイント用の補助ファイルを作るTextual Inversionにも似ています。補助ファイルは最初からモデルに学習されたかのように扱われ、テキスト分類器を修正してモデルの膨大な資源を利用するため、剪定後も最低2GBあるDreamBoothのチェックポイントより小さくなります。しかし研究者は両方を退けました。Textual Inversionは重要な細部を省略しすぎ、DreamBoothは最終的に選んだ方法より「性能が悪く、時間もかかった」と述べています。
ユニチューンは、DreamBoothと同様のカプセル化されたセマンティック「メタプロンプト」アプローチを使用します。トレーナーによって選択されたユニークな単語で、トレーニングされた変更が呼び出されます。これらの単語は、すでにパブリックリリースモデルのトレーニングに使用されている用語と衝突しないように選択されます。
QUOTEOPEN‘編集操作を実行するには、ファインチューンされたモデルをプロンプト「[rare_tokens] edit_prompt」でサンプリングします(例:「beikkpic 2匹の犬がレストランにいる」または「beikkpic ミニオン」)。’QUOTECLOSE
プロセス
最終機能がほぼ同じ2本の論文がGoogleから同じ週に出たのは不思議ですが、多くの類似点にもかかわらず、ユニチューンとImagicには明確な違いが少なくとも一つあります。Imagicは「非圧縮」自然言語プロンプトを使用して画像編集操作を誘導しますが、ユニチューンは、DreamBoothスタイルのユニークなトークンをトレーニングします。
したがって、Imagicで編集を行う場合、次のように入力します…

ユニチューン論文から – ユニチューンは、Googleのライバルニューラル編集フレームワークであるSDEditと比較しています。ユニチューンの結果は、右側に表示されています。推定マスクは、2番目から左の画像に表示されています。
Imagicには「背景に座る3人目の人物を、かわいい毛むくじゃらの怪物に」と入力します。一方、ユニチューンのコマンドは、‘後ろの男性を[x]に’ となります。ここで、x は、毛むくじゃらの怪物に関連する、ファインチューンされた概念に結び付けられた、奇妙でユニークな単語です。
DreamBoothとTextual Inversionは複数の画像から、多様な姿勢にできるディープフェイク風の抽象表現を作りますが、ユニチューンとImagicは画像を1枚だけシステムに入力します。つまり、オリジナルの、純粋なイメージです。
これは、過去数年のGANベースの編集ツールが動作した方法と似ています。つまり、入力画像をGANの潜在的な空間に変換し、変更のために他の部分の潜在的な空間に送信します。
しかし、結果は、拡散モデルとこの方法によって、比較すると驚くほど正確です。
ファインチューニングプロセス
ユニチューン方法は、元の画像を、変更方法に関する一連の指示とともに、拡散モデルを介して送信します。実質的に、現在、Stable Diffusionのimg2img機能でも可能ですが、残したい部分の歪みや変化は避けられません。
ユニチューンプロセス中、システムはファインチューンされます。つまり、ユニチューンは、モデルを再トレーニングさせ、ほとんどのレイヤーを解凍します。通常、ファインチューニングは、苦労して得られた高性能モデルの全体的な一般的な損失値を下げ、その代わりに作成または改善したい別の側面を追加・改良します。
しかしユニチューンでは、数GB以上ある場合もあるモデルのコピーが、一つの目的を果たした後に破棄される使い捨ての「殻」として扱われるようです。このような大量の一時データは、剪定後も対象ごとに最低2GBある独自モデルを持つDreamBooth利用者にとって、日々の保存容量の危機になっています。
Imagicと同様に、主なチューニングは、Imagenの下位2つのレイヤー(64px、64px>256px、256px>1024px)で行われます。Imagicとは異なり、研究者は最後の最大の超解像レイヤーも最適化する潜在的価値を見出していますが、まだ試していません。
64pxレイヤーでは、モデルはトレーニング中にベース画像にバイアスされ、128回のイテレーションでバッチサイズ4の複数の画像/テキストペアがシステムにフィードされます。Adafactorは、0.0001の学習率で損失関数として使用されます。この微調整ではT5エンコーダーだけが固定されており、Imagenの初期学習時にも固定されています。
上記の操作は、同じノイズ増幅手順を使用して、64>256pxレイヤーに繰り返されます。
サンプリング
変更を、ファインチューンされたモデルから引き出すことができる、多くのサンプリング方法があります。Classifier Free Guidance(CFG)が含まれています。CFGは、基本的に、モデルが「想像力」を追求する自由度と、入力ソースデータに従う必要性のバランスを定義します。

Textual Inversionのように、ユニチューンは、元の画像に独自のグラフィックスタイルを適用することに適しています。
研究者は、SDEditの「遅い開始」テクニックも実験しました。ここでは、システムは、元の詳細を保存するために、最初から部分的に「ノイズ」でなければなりませんが、基本的な特性を維持します。研究者はこれを最下位の64pxレイヤーだけに使用しましたが、将来の有用な補助サンプリング手法になり得ると考えています。
研究者は、プロンプトツープロンプトも、モデルに条件を与える追加のテキストベース手法として使用しました。
QUOTEOPEN‘「プロンプトツープロンプト」設定では、プロンプトガイダンスと呼ぶ手法が、忠実度と表現力の調整に特に役立つことが分かりました。’QUOTECLOSEQUOTEOPEN‘プロンプトガイダンスは、クラスフリーガイダンスと似ていますが、ベースラインは、無条件のモデルではなく、別のプロンプトです。これによりモデルは二つのプロンプトの差に向かいます。 ‘QUOTECLOSE

ユニチューンのプロンプトツープロンプト。実質的に、変更する領域を分離します。
しかし、プロンプトガイダンスは、CFGが望ましい結果を得られなかった場合にのみ、時々必要でした。
開発中に遭遇したもう1つの新しいサンプリングアプローチは、補間 でした。ここでは、画像の領域は、元の画像と変更された画像が構成上非常に似ているため、より単純な補間を使用できます。

補間は、変換される領域が離れており、十分にマージンがある場合、ユニチューンのより大きな努力を不要にします。
著者は、補間が、多くのターゲット画像の場合、デフォルト設定として使用できる可能性があると示唆しています。また、複雑なオクルージョンを交渉する必要がない場合、補間は、驚くほどの変換をもたらす可能性があると述べています。
ユニチューンは、編集マスクの有無に関係なく、ローカル編集を実行できます。また、独自に編集を配置することもできます。解釈力と、ソース入力データの本質的な要素の強固な固有化の、不思議な組み合わせを持ちます。

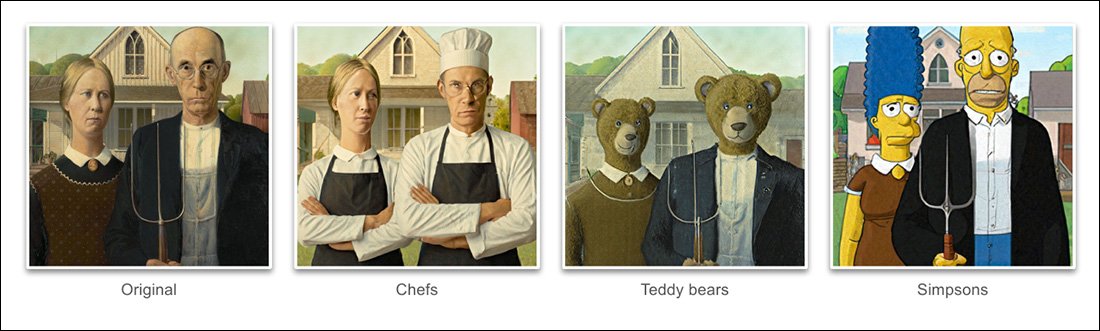
2列目最上部の画像では、UniTuneは指示された「背景の赤い列車」を適切で自然な位置に置いています。他の例でも、画素内容や画像の基本スタイルが大きく変わる中で、元画像との意味的整合性が維持されている点に注目してください。
待機時間
最初のイテレーションは、常に遅いものになります。また、コミュニティの関与や企業のコミットメントによって、最終的にはリソースハングリーなルーチンを最適化してスピードアップする可能性があります。ただし、ユニチューンとImagicは、驚くほど素晴らしい編集を作成するために、かなり大きな機械学習マニューバを実行しています。したがって、API経由のアクセスではなく家庭用にどこまで縮小できるかは疑問です。GoogleにはAPI方式の方が好ましいかもしれません。
現在、入力から結果までのラウンドトリップには約3分かかります。T4 GPUで、推論には約30秒追加されます(あらゆる推論ルーチンのように)。著者は、これが高待機時間であり、「インタラクティブ」とはほとんど称えられないと認めています。しかし、モデルは、初期にチューンされた後、ユーザーがプロセスを終了するまで、さらに編集を行うために利用可能なままであるため、編集ごとの時間が短縮されます。
2022年10月21日初出。


