SEO 101
-
SEO 101Googleのパーソナルインテリジェンスが検索とSEOを永遠に変えた
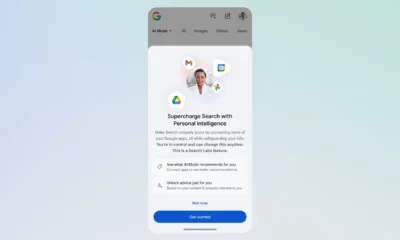
2026年1月22日、GoogleはAIモード内のパーソナルインテリジェンスのロールアウトとともに、コア製品に大きな更新を導入しました。この機能は、ユーザーの個人的なコンテキストに合わせてレスポンスをユニークにカスタマイズすることで、検索の仕組みを変えました。SEOで働く人にとって、これはマイナーの機能リリースではありません。これは、コンテンツがどのように発見され、ランク付けされ、提示されるかという基本的な再定義を表します。大きな変化は何でしょうか。検索結果は、単にユーザーが入力した単語によってのみ決定されるのではなく、検索者の誰であるか、彼らが何をしたか、残したデジタル足跡によって影響を受けるようになりました。Googleの新しいAIモードは、ユーザーのGmailとGoogle Photosにアクセスして、個人の好み、計画、習慣、過去の行動についてより包括的な理解を構築できます。検索は、単にクエリをマッチングすることではなく、クエリの背後にある人物を理解することについてになります。パーソナルインテリジェンスが何を実行するかパーソナルインテリジェンスは、GoogleのAIモードの一部であり、生成的なインターフェイスが現在検索で会話型、合成された結果を提供するように設計されています。有効にすると、この機能により、AIはユーザーのGmailとGoogle Photosのデータを参照して、パーソナライズされた回答を形成できます。Googleが共有した例には、フライトの確認と過去の服の選択に基づいて、予定されている旅行に適したコートを提案することが含まれます。あるいは、過去のバケーション写真やメールの予約に基づいて、新しい都市で家族向けのアトラクションを推奨することもあります。さらに、「私の人生はどのような映画ジャンルになるでしょうか?」のようなクエリは、ユーザーの個人的な記憶やルーチンを認識して回答されます。Googleは、このパーソナライゼーションは完全にオプションであると述べています。システムはユーザーのメールや写真をトレーニングに使用せず、接続はいつでもオンまたはオフにできます。ただし、ユーザーがオプトインした場合、AIは検索エンジンよりもパーソナルアシスタントに近くなります。ツールとしての検索からコンパニオンとしての検索へ歴史的に、検索は関連性についてでした。Googleはキーワードとドキュメントをマッチングし、意味的な理解を改善し、徐々に意図に基づくモデルを重ねました。各進歩は、検索が何を実行できるかを拡大しましたが、すべてクエリを中心に据えました。この更新は、そのモデルを覆しました。パーソナルインテリジェンスを使用すると、クエリは多数のシグナルの一つになります。検索は、単に何を入力したかを解釈するのではなく、ユーザーの人生に基づいてこの瞬間に何が必要かを解釈します。これにより、検索は深くコンテキスト化されたサービスになります。SEOも、単にキーワードをランク付けすることよりも複雑なものになります。パーソナルインテリジェンス後のSEO数年間、SEO戦略は、共有された検索体験の概念に依存してきました。2人が「最高のランニングシューズ」を検索した場合、同じ結果セットが表示されます。ランク付けはユニバーサルで、最適化は共通の意図を満たすコンテンツを作成することについてでした。そのモデルはもはや適用されません。同じ検索用語は、異なるユーザーに対して異なる回答をもたらす可能性があります。あるユーザーは、過去に購入したブランドに基づいて提案を受けるかもしれません。別のユーザーは、予定されている旅行に結びついた推奨を受けるかもしれません。別のユーザーは、最近の健康目標に合った靴を提示されるかもしれません。この検索体験の断片化は、巨大な影響を及ぼします。可視性はコンテキストに依存します。ランク付けは、孤立した状態で追跡できなくなります。成功は、クエリのマッチングだけでなく、ユーザーのプロファイル、行動、信頼性の履歴との整合にも依存します。簡単に言えば、SEOはもはや関連性だけではありません。記憶され、特定のユーザーと特定の時点でGoogleのAIによって適切な一致として認識されることについてです。伝統的なランク付けが重要性を失う理由AIモードが要約とパーソナライズされた回答を生成する場合、リンクは二次的なものになります。GoogleのAIは、引用、要約、または回答に組み込むコンテンツを選択します。これにより、AIの合成に含まれることが、生のランク付け位置よりも価値があります。Googleは、信頼できるソースにさらに依存するようになります。つまり、構造化されたコンテンツ、明確に書かれたコンテンツ、AIが解釈しやすいコンテンツが必要です。漠然としすぎる、またはあまりにも広範なコンテンツは、明確な声明をし、重要性を説明するページに優先されます。これにより、明確性、信頼性、深さが高く評価されます。トピックのカバレッジ、専門家による執筆、編集基準に一貫して投資してきたブランドや出版社は、AIの要約に含まれる可能性が高くなります。パーソナライズされた検索と主要セクターへの影響電子商取引電子商取引ブランドにとって、パーソナライゼーションは機会とリスクの両方をもたらします。一方で、GoogleのAIがユーザーを過去の顧客として認識した場合、製品は頻繁に推奨される可能性があります。SEOのハックではなく、ブランドがユーザーの好みに合っているという理由で、将来の検索ではデフォルトの選択肢になる可能性があります。一方で、これにより、新しい顧客の旅に打ち込むことが難しくなります。ユーザーが通常別のブランドでショッピングしている場合、コンテンツは表示されない可能性があります。最適化が優れているとしても、汎用的な「ベスト製品」リストは、個人に合わせた推奨に優先される可能性があります。競争するには、電子商取引SEOは、可視性だけでなく、関係を構築し、信頼のシグナルを構築することに焦点を当てる必要があります。製品ページは、完全で、構造化され、実際のユーザーのニーズと一致している必要があります。Google Merchant Centerを介した豊富な製品データの維持は、AIモードがショッピンググラフのデータを引き続き使用する場合に特に重要です。リテンションとロイヤルティはSEO要因になります。顧客がGoogleに接続された製品を介してあなたとやり取りするほど、再び表示される可能性は高くなります。ニュースとメディアニュース出版社は、最も大きな変動性を経験する可能性があります。AIモードの要約は、ユーザーの読書履歴または既知の好みに基づいて、異なるソースを強調する可能性があります。テクノロジーに精通したユーザーは、専門化されたアウトレットからのカバレッジを見るかもしれませんが、別のユーザーは、社会的影響や政治に関連した要約を見るかもしれません。このようなパーソナライゼーションは、特定の読者層内でニッチアウトレットを強化する可能性がありますが、ユーザーのプロファイルと一致しない個々の記事のリーチが減少する可能性もあります。ゼロクリック要約のリスクも高まります。AIモードがクエリに包括的に回答した場合、ユーザーはソースサイトを訪問しない可能性があります。これは、生成的な検索で既に知られている懸念です。パーソナライゼーションは、さらに別のレイヤーを追加します。記事が関連性のある場合でも、読者との強いブランド関係がない限り、選択されない可能性があります。メディアアウトレットは、発見可能性と繰り返しの関与に重点を置く必要があります。サブスクリプション、ニュースレター、直接訪問は、Googleが読者との関連性をどのように見なすかに影響を与える可能性があります。ブログとニッチコンテンツブロガーと独立したクリエイターは、特にロングテールトラフィックにおいて最も劇的な変化を感じる可能性があります。パーソナライズされた結果は、ニッチコンテンツをAIの回答に押し込む可能性があります。可視性は向上するかもしれませんが、トラフィックが続かない場合は損害となる可能性があります。しかし、パーソナライゼーションはニッチコンテンツを打ち破るのにも役立ちます。ユーザーの行動が特定の趣味に興味があることを示している場合、AIモードは、広く人気があるかどうかに関係なく、プロファイルに合ったコンテンツを高める可能性があります。鍵は、直接の関与を構築することです。ブログがブックマークされている、定期的に訪問されている、またはユーザーデータに記載されている場合(メールや検索など)、ユーザーのコンテキスト化されたウェブの一部になります。そこから、コンテンツは引用される、または推奨される可能性が大幅に高まります。独自性は、以前よりも重要です。AIはコンセンサスを要約することに優れています。ユニークな洞察、第一人称の経験、個人的な物語は、読者だけでなく、コンテンツを選択するAIシステムにも、コンテンツを際立たせるのに役立ちます。ユニバーサルからパーソナルへのSEO戦略の転換新しい環境で機能するのは、技術的なトリックのセットではありません。それは、コンテンツとユーザーエクスペリエンスに対する包括的なアプローチです: オーディエンスのセグメントを詳細に理解する 特定のコンテキストとニーズに直接対応するコンテンツを作成する ログイン、サブスクリプション、再関与を促進する 一貫した存在感と信頼できる出力によってブランドの認知度を構築する AIの読みやすさのために、人間のスキャニングだけでなくコンテンツを構造化する 分析も進化する必要があります。従来のランク追跡とインプレッションデータは、限定された見方を提供します。出版社は、クリックの動作、ブランドの言及、ダウンストリームの関与を分析して、パフォーマンスを理解する必要があります。Googleは、将来、AIの回答でコンテンツがどのように使用されているかを追跡するためのより優れたツールを提供する可能性がありますが、それまでは、より不透明なシステムで動作しています。より大きな絵パーソナルインテリジェンスは、検索のもう一つの機能ではありません。それは方向性の変化であり、AI駆動システムが情報にアクセスする方法をどのように形作るかについての明確なプレビューです。検索は、すべてのユーザーに対して同じように応答する静的なインターフェイスではありません。それは、各個人のニーズ、行動、好みを中心に形成される適応性のある体験になります。ユーザーにとっては、これは以前よりも関連性が高く、タイムリーで、パーソナライズされた回答を意味します。SEOとコンテンツクリエイターにとっては、優先順位のシフトを意味します。目標は、単にキーワードをマッチングしたり、ユニバーサルランクを追求したりするのではなく、コンテンツを設計することです。コンテンツは、リアルタイムでパーソナライズされた結果を提供するAIシステムによって選択され、解釈され、信頼される可能性があります。これは、Answer Engine Optimization (AEO)という分野が重要になる場所です。AEOは、コンテンツを構造化して、生成モデルによって簡単に解析され、再利用されるようにします。明確性、意味的豊かさ、機械が読み取りやすい形式を重視します。Search Generative Optimization (SGO)やAI Experience Optimizationなどの関連アプローチは、コンテンツクリエイターが、言語モデルが処理、合成、提供する回答に適合するコンテンツを形成するのを支援するために登場しています。新しい現実は、コンテンツがランク付けされるだけでなく、AIの意思決定に役立つように構築される必要があるということです。つまり、個々の人々ではなく、個々の人々にとって有用で、解釈可能で、コンテキストに応じた関連性があることを意味します。従来のSEOツールや原則はまだ重要ですが、それらは、コンテンツを、高度にパーソナライズされた検索環境で利用可能で、アクセス可能で、好ましいものにすることに焦点を当てた、より大きな戦略の一部にすぎません。これは、最も人々にとって最も優れた答えを得ることではなく、正しい答えを正しい人に正しい時に得ることについてです。
著者 Antoine Tardif, Unite.AIのCEO兼創設者
-

SEO 101AI検索に表示されるコンテンツを作る方法
ほとんどの会社は、コンテンツ運用にChatGPTを何らかの形で取り入れています。しかし、多くの会社はまだ、ChatGPTがコンテンツをどのように見つけるかについて考えてはいません。現在起こっていることは次の通りです。先見の明ある企業は、AIツールの登場により、以前よりも多くのコンテンツをリリースしています。一方、他の企業はまだGoogleを最適化している2019年のように動いています。彼らは、トラフィックが減少していることを疑問に思っているのです。なぜなら、彼らは「ベストプラクティス」をすべて従っているからです。ゲームは変化しましたが、ほとんどの企業は自分たちがゲームをしていることさえ気づいていないのです。Google以外の検索エンジンマーケティングチームは、研究のためにAI搭載の検索ツールを使用することが増えています。Googleだけではありません。 Perplexity、ChatGPT、Claude、その他のAI検索エンジン。彼らはこれらのツールに直接質問をします。たとえば、「クリエイティブエージェンシーのためのベストなプロジェクト管理ソフトウェアは何ですか?」と聞きます。すると、瞬時に複数の情報源から合成された回答が得られます。青いリンクをクリックする必要はありません。フラフの多いブログ記事をスキャンする必要もありません。これが競争上の優位性となること、または大きな盲点となることです。ジェネレーティブエンジン最適化とはジェネレーティブエンジン最適化(GEO)は、基本的にAIのためのSEOです。従来のSEOは、Googleのアルゴリズムを最適化して検索結果にランクインすることを目的としています。GEOは、AIシステムが実際の回答となるように最適化します。次のように考えてみてください。 SEOは次のように言います。「ここに10個のリンクがあります」 GEOは次のように言います。「ここに正確な回答があります。このコンテンツから引用されています」 現在、 従来の検索エンジンの検索ボリュームは、2026年までに25%減少することが予測されています。これは、ChatGPT、Perplexity、GoogleのAIサマリー、Claude、その他のAIエンジンの隆盛によるものです。コンテンツは、両方のシステムで機能する必要があります。そうでない場合、企業は潜在的なオーディエンスの増加する部分から実際に不可視になります。AI検索の不快な真実ここで、ほとんどの企業がAI最適化について間違っていることです。彼らは、それが別のアルゴリズムを操作することであると思っています。より多くのキーワードを追加することです。別のチェックリストに従うことです。そうではありません。AIシステムは、有用な情報を認識して抽出するようにトレーニングされています。彼らは、明確さ、コンテキスト、直接的な回答を探しています。すべての 従来のSEOキーワードスタッフィングは、実際にはコンテンツをより難しくして、AIが解析して使用するのを妨げます。次のことを考えてみてください。SEO最適化された記事は、メインキーワードで2位になるかもしれませんが、AI生成の回答には決して表示されません。一方、8位の記事は常に引用されます。なぜでしょうか。8位の記事は最初の段落で質問に答えているからです。2位の記事は、読者に500文字の「コンテキスト」をスクロールさせるように求めます。実際に機能するフレームワーク徹底的なテストの後、AIの回答にコンテンツを表示するためのシステムが見つかりました。1. 最初に回答し、次に説明する各記事の最初に、40〜50文字の直接的な回答を入れてください。フラフはありません。「時代の始まり」のような導入もありません。悪い例:「今日の急速に変化するビジネス環境では、プロジェクト管理を理解することは非常に重要です…」良い例:「プロジェクト管理ソフトウェアは、タスクを整理し、締め切りに追跡し、チームが効率的にコラボレーションできるようにします。クリエイティブエージェンシーのための最良のオプションは、Monday.com、Asana、ClickUpです。なぜなら、彼らは視覚的なワークフローとロバストな機能のバランスをとっているからです。」違いはわかりますか?2. 抽出のための構造AIシステムは、明確な構造を愛しています。次のものを使用してください。 質問ベースの見出し(「Xの仕組みは?」ではなく、「Xについての理解」) 複数のポイントのための箇条書き プロセスのための番号付きステップ 短い段落(3文以下) これはコンテンツを単純化することではありません。人間と機械の両方にアクセス可能にすることです。3. 自然言語のシフト実際に人々が質問するように書いてください。従来のキーワードリサーチでは、「プロジェクト管理ソフトウェアの機能」と言います。しかし、人々はPerplexityに「プロジェクト管理ソフトウェアで何を探すべきですか?」と聞きます。どちらのバージョンがAIにわかりやすいと思いますか?4. FAQの金鉱各コンテンツに正当なFAQセクションを追加してください。キーワードを詰め込む怠け者タイプではありません。ターゲットオーディエンスが実際に尋ねる質問と、実際の回答です。プロのヒント:Perplexityの「関連する質問」またはChatGPTのフォローアップを使用して、人々が何を尋ねているかを調べます。次に、その質問にコンテンツで答えてください。技術的な話(実際にはそうではない)企業は開発チームを必要としません。しかし、いくつかのことを実装する必要があります。スキーママークアップこれは基本的に、コンテンツにラベルを付けて、AIが何であるかを理解できるようにすることです。 質問セクションのためのFAQスキーマ チュートリアルのためのHowToスキーマ ブログ投稿のための記事スキーマ ほとんどのWordPress SEOプラグインはこれを自動的に追加できます。設定には5分かかります。エンティティ認識ブランド名、製品名、重要な概念を一貫して言及してください。AIシステムはエンティティ間の関係をマッピングします。コンテンツ内で製品が3つの異なる名前で呼ばれると、機械は混乱します。新鮮さのシグナルコンテンツを定期的に更新してください。偽の更新ではありません。新しい統計、新しい例、新しい洞察です。Perplexityのインデックスは毎日更新されます。2023年の統計はもう使えません。コンテンツ戦略への影響コンテンツを作成することを止めてください。各ピースには、2つの目的を果たす必要があります。 伝統的な検索でランクインすること(まだ重要です) AIシステムが引用するソースになること これは実際にはシンプルにします。なぜなら、AIに効果的なもの – 明確な回答、良い構造、自然な言語...
著者 Alex McFarland
-

SEO 101ネガティブSEO:脅威、戦術、Gaming.net攻撃のケーススタディ
単純に言えば、ネガティブSEOとは、サイトのランキングや検索エンジンでの可視性を低下させることを目的とした悪意のある行動を指します。これらの行動は検索エンジンのガイドラインに違反し、ターゲットサイトを信頼できないまたはスパムのようなサイトに見せることを目的としています。検索エンジンのアルゴリズムが進化するにつれて、かつてサイトのランキングを上げるのに役立ったスパムテクニックは今ではサイトに害を及ぼすようになりました。攻撃者はこれを利用して、悪意のある信号を競合他社に向けます。ここでは、攻撃者が使用する一般的な戦術と、2024年から2025年にかけて私のウェブサイト、Gaming.netに対して行われた継続的な攻撃の実際の影響について、詳細なケーススタディを通じて説明します。さらに、他の注目すべき事件とウェブマスターが自分自身を保護する方法についても説明します。ネガティブSEOの影響は深刻なものになり得ます。如果攻撃が成功した場合、被害サイトはランキングの低下、有機的なトラフィックの減少、評判の損傷を被る可能性があります。回復には時間とコストがかかり、スパム信号のクリーンアップと検索エンジンの信頼の回復が必要になります。私たちの場合、トラフィックは約90%減少しました。ケーススタディ:Gaming.net攻撃私たちが直面した最も困難で有害な戦術の1つは、悪意のあるテキストの注入でした。攻撃者はスパムや挑発的な用語(例:医薬品、明確なコンテンツ、または連絡先リスト)を使用して検索URLを生成し、これらのクエリは自動生成された検索結果ページに埋め込まれました。さらに悪いことに、攻撃者はこれらの検索結果URLにバックリンクを積極的に構築し、人工的なリンクのエクイティを与え、Googleがこれらのページをクロールしてインデックスする可能性を高めました。結果として、私たちが意図的に存在させたことのないページがインデックスに表示され、多くの場合、私たちが公開したことのないフレーズで満たされていました。この戦術は私たちのインデックスを汚染し、信頼性を損なったことは極めて困難でした。なぜなら、技術的に私たちのサイト上に存在する機能を利用していたからです。内部と外部の操作の線を曖昧にし、バックエンドのフィルタリングと積極的なインデックス制御の両方を必要としました。詳細は、?id=123、?action=QUERY、?error=404などの悪意のあるクエリ文字列の大量注入を含む複数の攻撃ベクトルです。これらはGoogleによってインデックスされるジャンクページの雪崩を生み出しました。攻撃者はまた、サイトのRSSフィードをターゲットにし、検索結果ページを悪用してクロークされたXML出力にスパムキーワードを注入しました。ネガティブSEO攻撃戦術有毒バックリンクターゲットサイトにスパムまたは低品質のバックリンクを大量に流し込むことは、古典的な方法です。攻撃者は、サイトがリンクスキームに参加しているように見せるために、無関係または悪意のあるドメインからの数千のリンクを構築する可能性があります。これらの有毒バックリンクは、アルゴリズムによるペナルティを引き起こし、ランキングを低下させる可能性があります。私たちの場合、Gaming.netは突然、外国人のディレクトリ、成人向けウェブサイト、ハッキングされたフォーラムからのバックリンクの増加を経験しました。これらのリンクは、ゲームや私たちのブランドとは無関係な内部ページを指していました。アンカーテキストは、ゲームや私たちのブランドとは無関係な製薬キーワード、偽の連絡先リスト、またはランダムな無意味なテキストでした。このようなバックリンクプロファイルは、サイトが操作的であるように見せるため、検索エンジンによって信頼されません。さらに悪いことに、これらの有毒バックリンクのいくつかは、故意に不正なURLを指しており、スパムの印象をさらに強めました。私たちがリンクを生成したことや支持したことはありませんでしたが、検索エンジンはこれらのリンクを信頼しませんでした。回復の一環として、Google Search Consoleとバックリンク監査ツールを使用して、これらの有毒ドメインのクラスター全体を特定し、却下する必要がありました。スパムキーワード攻撃者は、ランダムまたは悪意のあるクエリパラメータを使用して、サイトのURL構造をターゲットにします。例えば、?ref=spamまたは?error=404などのパラメータを追加して、複製または薄いコンテンツページを生成します。これにより、クロール予算が過負荷になり、ソフト404エラーまたはジャンクインデックスが発生する可能性があります。Gaming.netの場合、これらのクエリ文字列はランダムではありませんでした。多くの場合、検索とページネーション機能を利用するために慎重に作成されました。私たちは、空またはほぼ空のページを生成するための長い、エンコードされたパラメータを見つけました。いくつかはキリル文字または中国語文字を含んでおり、他のものは共通の分析トラッキングコードを模倣して混ぜました。さらに心配なのは、規模です。数十万のURLがヒットされてインデックスされ、ボットやクローラーがこれらのジャンクバリエーションをサイト全体でフォローしていました。これにより、インデックスが汚染され、Googlebotが無価値なページに貴重なクロール予算を浪費し、新しい正当なコンテンツのインデックスが遅れることになりました。これらのジャンクURLは、ソフト404をトリガーしたり、誤解を招く構造を持つコンテンツのないページをレンダリングしたりして、検索結果の操作を試みているように見えました。これを緩和するには、複数のアプローチが必要でした。サーバーレベルで悪意のあるパラメータをフィルタリングし、クエリのサニタイズに正規表現を実装し、動的に生成された検索結果ページがインデックスできないようにロボットとメタディレクティブを修正しました。ただし、これらのクリーンアップは私たちの対応の最もリソースを大量に消費する部分でした。クロークされたRSSフィードサイトは自動的にRSSまたはXMLフィードを生成することがあります。攻撃者はこれを利用して、検索クエリまたはタグページに結び付くフィードにスパムキーワードを注入します。これらのフィードは検索エンジンによってインデックスされる可能性があり、サイトの存在をスパムコンテンツで汚染します。Gaming.netの場合、これは攻撃のより潜在的な側面でした。スパム用語でサイト検索をトリガーし、結果のURLに/feed/を追加することで、攻撃者はRSSフィードを生成しました。これらのフィードには、スパム用語がフィードメタデータに含まれていました。これらのフィードは通常のユーザーには見えませんが、検索エンジンによって発見され、クロールできます。結果として、私たちのサイトは無関係または有害なトピックに関連付けられる、インデックスされたコンテンツの流入を招きました。 フィードURLは通常信頼され、構造化されているため、Googleはこれらの多くのクロークされたRSS出力を正当なものとして扱いました。これにより、私たちのドメイン内にスパムコンテンツの隠されたレイヤーが作成されました。メニューまたはサイト構造には表示されませんが、クローラーには表示され、可視化されていました。場合によっては、これらのスパムフィードはバックリンクを取得し、検索結果での表示をより持続させました。最終的に、すべての公開RSSとXMLフィードの生成をグローバルに、またクエリごとに無効にする必要がありました。また、/feed/エンドポイントへのすべてのリクエストがリダイレクトされるかブロックされることを確認する必要がありました。この戦術は微妙でしたが、私たちのドメインの信頼性の低下に大きく貢献し、技術的な監査を徹底的に行う必要がありました。言語とタグディレクトリの悪用マルチ言語プラグインやタグアーカイブは、攻撃者によって悪用されることがあります。攻撃者は外国語のページを生成し、無関係または低品質のコンテンツで満たします。これらのページはインデックスされ、サイトの品質が低下します。Gaming.netの場合、このベクトルは特に永続的でした。私たちのコンテンツの多言語バージョンを生成する自動翻訳プラグインの使用により、/zh-CN/、/ru/、/uk/などのフォルダーが作成されました。攻撃者はこれらのパスをスパムまたは無関係なキーワードで埋め込んだタグやカテゴリのURLを生成することでこれらのパスを悪用しました。これらのURLは技術的には有効でしたが、外国語で空または低品質のタグアーカイブページにリンクし、検索エンジンによってインデックスされました。結果として、Googleのインデックスには、正当なコンテンツがほとんどなく、ユーザーとの関与がまったくない、数千の外国語ページが含まれていました。これらのページは私たちのドメインの足跡を汚染し、私たちが無意味または無関係な資料を公開しているように見せ、さらに私たちのサイトの信頼性を低下させました。いくつかのケースでは、これらのスパムタグアーカイブページは外部からリンクされ、問題を悪化させました。これに対抗するために、サーバーレベルでこれらの未使用の言語フォルダーとタグパスをリダイレクトしました。また、手動でキュレーションされていない多言語のタクソノミーアーカイブにnoindexルールを適用しました。表面的に見ると小さな詳細ですが、このループホールは攻撃者が私たちのドメインで大量のジャンクコンテンツを生成することを可能にしました。メタデータの悪用一部の攻撃者はメタデータを操作します。偽のカノニカルタグやnoindexディレクティブを注入して、検索エンジンがどのコンテンツバージョンが権威あるものであるかを混乱させます。これにより、サイトの正当なコンテンツが可視性を失う可能性があります。私たちの監査では、Gaming.netがメタデータの操作によって影響を受けたかどうかを判断するために、このベクトルも調査しました。特に、rogueカノニカルタグまたはnoindexディレクティブがプラグインの脆弱性、テーマファイル、または悪意のあるスクリプトを介して注入された可能性について調べました。メタデータの操作は、基本的にコンテンツの権威あるバージョンを検索エンジンに無視または誤って帰属させることです。しかし、私たちは幸いなことに、これらの戦術が私たちに対して成功裏に使用された証拠を見つけることができませんでした。しかし、脅威は現実的です。単一のカノニカルタグがスパムドメインを指しているか、または重要なサイトセクションにnoindexディレクティブが存在するだけで、SEO努力を大幅に妨げる可能性があります。私たちの強化プロセスの一環として、テーマとプラグインファイルへのアクセスをロックダウンし、メタデータ生成のバージョン管理をより厳格に実施し、重要なSEOタグが予期せず変更されていないことを確認するために、継続的に監視しています。影響この攻撃は深刻な問題を引き起こしました: Google Search Consoleはクロールエラーで溢れかえりました。 スパムページがインデックスされ、私たちのドメインの信頼性が低下しました。 私たちの高性能コンテンツのランキングが低下しました。 新しい投稿が適時にインデックスされませんでした。 時折、Googleがサイトをハッキングされたかスパムとみなしているように感じました。私たちの対応対応として、チームは多層防御戦略を実施しました: サーバーレベルで、.htaccessルールを使用して有害なクエリ文字列を傍受し、/search/、/feed/、および外国語タグフォルダーのような悪性パスをブロックしました。 検索機能を書き直して、検索用語がURLに表示されないようにし、検索結果ページの作成を停止しました。 WordPress内で、すべての公開RSSフィード(RSS、Atom、JSON)を無効にし、XML-RPCおよびREST APIエンドポイントを非アクティブにし、疑わしいクエリ文字列パターンを検出して中和するフィルタを展開しました。 robots.txtおよびX-Robots-Tag: noindexを使用して、低品質または動的に生成されたページ、特にスパム活動に関連するページのインデックスを防ぎました。 また、サーバーを悪意のあるスクリプトに対してフルスキャンし、Google Search Consoleを介して数千のジャンクURLを削除し、再発生または新しい攻撃ベクトルの兆候を継続的に監視しました。 回復2025年半ばまでに、状況は安定しました。クロールエラーは減少し、ジャンクURLはクロールされなくなりました。新しいコンテンツは再び適時にインデックスされました。長く詳細なプロセスでしたが、SEOの足元を取り戻しました。ただし、私たちのトラフィックは歴史的な最高値と比較してまだ恥ずかしいほど低いままです。ネガティブSEOの他の注目すべきケース私たちの経験は激烈でしたが、私たちだけではありません。大手ブランドやエージェンシーも被害を受けています: J.C. Penneyは、無関係なスパムサイトからの数千のリンクによってランキングが低下しました。 Forbesは、有機的なトラフィックに影響を与えるスパムバックリンクの波に直面しました。 これらの例は、ネガティブSEOが誰にでも影響を及ぼす可能性があることを示しています。ウェブサイトを保護する方法ここでは、私たちが経験から学んだ重要なステップを紹介します: 定期的に監視する:Google...
著者 Antoine Tardif, Unite.AIのCEO兼創設者
-
SEO 101GoogleがMedium.comの盗作コンテンツをオリジナルコンテンツよりも優先する方法
数年間、Googleはウェブマスターのコミュニティに、オリジナルで高品質のコンテンツが検索結果で上位に表示されるための鍵であることを強調してきました。Googleのシステムは、E-E-A-T(専門知識、経験、信頼性、そして信頼性)を示すコンテンツを報奨することを目的としています。コンテンツがどのように制作されたかに関係なく、この品質重視のアプローチは、信頼性の高い検索結果を提供する上で中心的な役割を果たしてきました。 このアプローチは、Helpful Content Updateなどの新しいアルゴリズムの変更によって今日も継続されており、ユーザーが検索ランキングのためだけに作成されたコンテンツではなく、人々のために作成されたコンテンツを見つけることを保証することを目的としています。 これが、私がSEO戦略の一環として、価値を提供するコンテンツを最適化することに重点を置いてきた理由です。これは、私がすべてのウェブサイトで行ってきたことです。 Medium.comの盗作コンテンツが私たちのコンテンツを上回る 私は、多くの私たちの詳細な、個別化されたAI製品レビューがランクインしていないことを発見し、驚かされました。たとえば、私たちのYou.comレビューには、スクリーンショットや個別化されたテストを含むオリジナルで高品質のコンテンツが含まれていますが、それでも視認性を得るのに苦労していました。 Googleのトップ10の検索結果をスキャンすると、私たちのAIツールレビュー(正確なタイトル)がMedium.comのウェブサイトで高くランクインしていることがわかりました。 私たちのレビューページはランクインしておらず、Googleの検索結果から完全に欠落していました。Googleの明らかに最先端の検索エンジンは、オリジナルのクレジットを、ほとんどのトラフィックがないMedium.comアカウントに与えました。 実際、アカウントは非常に新しく、以下のスクリーンショットによると、7人のフォロワーしかいませんでした。さらに興味深いのは、アカウントに投稿されたすべての記事が私たちの記事の直接の著作権侵害であったことです。以下の投稿の時間から、盗作者がコピーして貼り付けにどれほど忙しかったかがわかります。 たとえば、上記に投稿されたトップ3の記事は、私たちのYouTube Shortsを作成するためのベストAIツール、ベストAIビデオジェネレーター、および私たちのベストAI Chrome拡張機能の記事です。 彼らはどうやってそれをやってのけたのか? 7人のフォロワーしかいないMediumアカウントが、月間数百万人の訪問者を持つサイトを上回ることができるという疑問は、ドメイン権威の理解を必要とします。ドメイン権威は、ウェブサイトが検索エンジンの結果でどれほど上位に表示される可能性があるかを予測するために使用されるメトリックです。これは公式のGoogleランキング要因ではありませんが、SEO専門家によってサイトの信頼性とランクインする可能性を判断するためによく使用されます。 さまざまなツールによってどのように測定されるか Mozは、ドメイン権威というメトリックを最初に作成しました。これは、ウェブサイトのランキングの可能性を1から100のスケールで測定します。バックリンクプロファイル、受信リンクの品質、その他のSEO関連データを考慮して、ウェブサイトが検索結果でどれほど上位に表示される可能性があるかを推定します。これは、機械学習モデルによって計算され、さまざまなSERPでランキングを予測します。 Ahrefsは、ドメインレーティング(DR)というメトリックを使用して、ウェブサイトのバックリンクプロファイルの強さを測定します。主にバックリンクの品質と数量に焦点を当て、0から100の対数スケールを使用します。高いDRは、バックリンクの権威が強いことを示します。Ahrefsは、バックリンクがサイトのランキング力にどのように貢献するかも考慮します。 SEMRushは、権威スコア(AS)を測定します。これは、バックリンクだけではなく、バックリンク(数量と品質)、有機トラフィック(サイトがどれほどのトラフィックを取得しているか)、キーワードランキング(サイトがターゲットキーワードでどれほど上位に表示されるか)など、より広範な要素を考慮します。 これらのツールはすべて、ウェブサイトの権威を測定し、より一般的なガイドラインを提供するものであり、真のランキングの公式ではありません。 この場合、Ahrefsを使用して私たちのドメイン権威を確認します。Unite.AIのスコアは75で、多くのウェブサイトと比較して非常に高いスコアです。 もちろん、このスコアは印象的ですが、Medium.comと比較すると相対的に低いです。 実際、Similar Webによると、Mediumは世界でトップ500のウェブサイトの一つです。ここに問題があります。Googleは、ドメイン権威が高いドメイン上にある記事に優先的な扱いを与えるべきでしょうか。ドメイン権威がランキングシグナルではないという主張はありますが、多くのSEOコミュニティは、経験的証拠のため、それがランキングシグナルであると信じています。 Googleはよりよくする必要がある...
著者 Antoine Tardif, Unite.AIのCEO兼創設者
-
AIモデルとプラットフォーム検索の未来:AIが検索から深い推論へ
ジェネレーティブAIが技術とのやり取りを再定義するにつれ、情報を検索する方法も深い変化を遂げています。キーワードマッチングと検索に頼る従来の検索エンジンは、ジェネレーティブAIを利用してコンテキストドリブン、より深い、そしてより正確な洞察を提供するより高度なシステムに徐々に置き換えられていきます。この基本的な検索から深い推論への移行は、情報とのやり取りを変革し、検索エンジンを単なるデータファインダーから、価値のあるアシスタントへと進化させるでしょう。そうしたアシスタントは、必要なものを見つけるだけでなく、情報を理解し、情報に基づいた決定を下すのを支援します。検索の進化検索技術の旅は、シンプルなキーワードベースのシステムから始まりました。初期の検索エンジンであるAltaVistaやYahoo!は、ユーザーのクエリをインデックス化されたWebページと一致させることに大きく依存していました。ある程度効果的でしたが、これらのシステムは、ユーザーが必要なものを見つけるためにページの情報を手動で絞り込む必要があった、無関係な結果を大量に返すことが多かったです。1990年代後半にGoogleが登場したことで、検索技術は大きな飛躍を遂げました。GoogleのPageRankアルゴリズムは、Webページの関連性と権威を考慮することで検索を変革し、より正確で有用な結果をもたらしました。ただし、従来の検索エンジンは、キーワードマッチングへの依存によって基本的に限界がありました。検索におけるAIの台頭検索技術へのAIの統合は、新たな可能性をもたらしました。マシンラーニングアルゴリズム、自然言語処理(NLP)、およびニューラルネットワークは、検索エンジンがコンテキスト、意図、意味を理解できるようにしました。これにより、より直感的でユーザーフレンドリーな検索体験が実現しました。検索におけるAIの最も注目すべき進歩の1つは、自然言語クエリを処理する能力です。キーワードのシリーズを入力するのではなく、ユーザーは会話形式で質問を投げかけることができます。例えば、「ニューヨークのベストなイタリアンレストラン」を検索するのではなく、「ニューヨーク市で最も良いイタリアンレストランはどこですか?」と尋ねることができます。AI駆動の検索エンジンは、クエリの意図を理解し、関連する結果を提供できます。検索エンジンが深い推論を必要とする理由AIは検索結果の精度と関連性を大幅に向上させましたが、検索技術は依然として、深い推論と微妙な理解を必要とする複雑なクエリに苦労しています。例えば、希少な医療状態の最善の治療オプションを探したり、契約紛争に関する法的アドバイスを求めたりすることが考えられます。現在の検索技術、AIを搭載したものでも、記事や文書の一覧を返すかもしれませんが、もっと深いものが必要な場合はどうでしょうか? 情報を単に取得するだけでなく、クエリの複雑さを理解し、さまざまな視点を比較検討し、推論された分析を提供するシステムが必要です。これが現在の検索技術が苦労する点です。データの取得は得意ですが、複雑な質問に直面したときに情報をつなぎ合わせることが苦手です。例えば、「ヘルスケアにおけるAIの倫理的影響は?」と尋ねると、倫理、AI、ヘルスケアに関する記事が別々に返されるかもしれませんが、質問の複雑さを真正に捉えた、統合された回答は得られません。複雑なクエリに対処するには、検索エンジンは複数の情報源から情報を統合し、影響を分析し、詳細な回答を提供する推論能力が必要です。検索エンジンを変革するリトリーバル・オーギュメンテッド・ジェネレーションリトリーバル・オーギュメンテッド・ジェネレーション(RAG)は最近、検索技術に大きな進歩をもたらしました。従来のキーワードマッチングに頼る方法とは異なり、RAGは情報の取得とジェネレーティブAIを組み合わせます。この組み合わせにより、システムは大量のデータセットから関連するデータを取得し、ユーザーの特定のクエリに合わせて、大規模言語モデルを使用してコンテキストに富んだ回答を生成できます。RAGベースの検索技術の例としては、GoogleのVertex AI検索やMicrosoftのBingなどがあります。 RAGは、キーワードマッチに基づいて全文書を取得するのではなく、文書の特定のセクションに焦点を当てることで検索を強化します。例えば、気候変動が北極生態系に与える影響について調査している場合、RAG駆動の検索はこのトピックについて論じているセクションを取得し、より正確で効率的な検索体験を提供します。しかし、RAGは依然として、情報を統合してまとまりのある回答を提供する能力が不足しています。例えば、「北極生態系への気候変動の影響を軽減する最も効果的な戦略は?」と問われれば、RAGシステムはさまざまな戦略を取得するかもしれませんが、最善のアプローチを評価して提示することは苦手です。RAGシステムに推論と計画能力を向上させるための研究は続けていますが、これらの技術は依然として発展中です。これは、検索システムが情報を取得して生成するだけでなく、よく考えられた情報を提供する能力も必要であることを示しています。ナレッジグラフの役割ナレッジグラフは、検索技術における推論を可能にする上で重要な役割を果たします。これらの構造化された情報表現は、エンティティ間の関係を捉え、AIシステムがコンテキストを理解し、つながりを築くことを可能にします。例えば、ナレッジグラフは「気候変動」を「二酸化炭素排出」、「地球温暖化」、「再生可能エネルギー」と関連付けることができます。ナレッジグラフを利用することで、AI駆動の検索エンジンはより正確でコンテキストに応じた回答を提供できます。ユーザーが複雑な質問を投げかけたとき、AIはナレッジグラフを辿ってさまざまなドメインからの情報を収集し、包括的でバランスのとれた回答を提供できます。一部の研究者は、RAGの強みである関連テキストセグメントの特定とナレッジグラフの関係マッピング能力を組み合わせる方法を探究しています。この統合により、気候変動が北極生態系に与える影響についての関連する段落だけではなく、関連する要因である二酸化炭素排出や生物多様性についても情報を結び付け、より包括的でコンテキストに応じた回答を提供することを目指しています。こうした技術が発展するにつれ、検索をより思慮深く洞察に富んだツールへと変革する可能性を持っています。認知コンピューティングとコンテキスト理解認知コンピューティングは、AI駆動の検索を次のレベルに引き上げ、システムがコンテキストを理解し推論できるようにします。これには、クエリの内容だけではなく、ユーザーの意図、好み、過去のやり取りも考慮します。例えば、ユーザーが持続可能な生活について頻繁に検索する場合、認知検索エンジンはユーザーの関心に沿った回答を調整できます。コンテキスト理解は、言語の解釈にも拡張されます。ジェネレーティブAIシステムは、慣用句、比喩、文化的参照を解釈し、より正確で意味のある結果を提供できます。このレベルの洗練度は、検索エンジンを、有意義な会話を交わすことができるインテリジェントなアシスタントへと変貌させます。さまざまな業界への影響検索から深い推論への移行は、さまざまな業界に広範な影響を及ぼします。ヘルスケアでは、AI駆動の検索エンジンは、医療文献、患者の記録、臨床ガイドラインを分析することで、複雑な状態の診断を医師が支援できます。金融では、推論能力を持つ検索技術は、経済指標、地政学的イベント、歴史的傾向を考慮して、投資家に包括的な市場分析を提供できます。教育も、検索エンジンの推論能力が大きな違いをもたらす分野です。こうした検索エンジンは、個別の説明とリソースを提供することで、学生が複雑な概念を理解するのを支援する、個別のチューターとして機能できます。この知識の民主化は、教育のギャップを埋め、世界中の学習者をエンパワーメントする可能性があります。結論検索技術が進化するにつれ、単にデータを取得することから、情報を理解し推論するツールへと変化しています。AIの進歩、たとえばリトリーバル・オーギュメンテッド・ジェネレーションやナレッジグラフは、検索エンジンをより直感的で複雑な質問に回答できるアシスタントへと変革し始めています。この変化は、ヘルスケアや教育のような業界に大きな影響を与え、検索を決定や学習のためのより貴重なリソースにします。
著者 Dr. Tehseen Zia
-

SEO 10110 ベスト AI SEO ツール (10月 2026)
検索エンジン最適化(SEO)は、Google の青リンク順位付けだけに留まらなくなっています。ブランドは依然としてキーワード調査、競合分析、権威あるリンク獲得、技術的パフォーマンス改善、既存コンテンツの最適化が必要ですが、同時に AI 概要、ChatGPT、Perplexity、Gemini などの回答エンジンで情報がどのように表示されるかも理解しなければなりません。人工知能はこのワークフローの多くの部分を加速できます。最新の SEO プラットフォームは、出現しつつあるテーマの特定、意図別のキーワードグループ化、コンテンツブリーフの生成、内部リンク機会の発見、技術的問題の検出、ページ更新の推奨、AI 生成回答でのブランド可視性の追跡、そしてオーガニックパフォーマンス向上につながる作業の優先順位付けを行います。これらのツールは編集判断を支援すべきであり、置き換えるべきではありません。検索エンジンと回答エンジンは、ユーザーの意図を満たす有用で正確、かつオリジナルな情報を評価します。最適化スコアが高くても、軽くレビューされた大量の AI コンテンツを公開すると、事実性・評判・インデックスのリスクが生じます。以下のプラットフォームは SEO プロセスのさまざまな部分をカバーしています。あるものは包括的なリサーチスイートであり、別のものはトレンド発見、WordPress 最適化、コンテンツ改善、技術的導入、または生成エンジン全体での可視性に特化しています。本ガイドでは、各ソリューションを独自に評価し、SEO 機能、実務上の強み・制限、そしてランキングに反映されたユースケースへの適合性を検証しました。おすすめAI SEOツールの比較おすすめAI SEOツール10選https://youtu.be/u5lsAQhLMKwExploding Topics は、注目が高まっているテーマ、製品、企業、マーケットを、主流になる前に見つけ出します。SEO やコンテンツチームにとっては、競合が飽和する前に有用なカバレッジを構築できる領域を示すことができます。このプラットフォームは機械学習と人間のレビューを組み合わせ、1.1 百万以上のトレンドデータベースを維持しています。各トレンドには検索ボリューム、成長率、予測、季節性、変動性、感情、関連トレンド、チャネル別内訳、製品、スタートアップ、メタトレンドが含まれ、API でダッシュボードや自動化ワークフローに構造化データを供給できます。Exploding Topics の最大の強みは、早期発見と市場インテリジェンスの層を提供する点です。上昇シグナルがオーディエンスの意図やビジネス的関連性と合致しているかを編集側が検証してからリソースを投入すべきです。プランニングサイクルの前半でトレンドシグナルを研究優先度やブリーフ、マーケットモニタリングに活用するのが最適で、ページレベルのキーワードデータやバックリンク分析、技術的クロールの代替にはなりません。 メリットとデメリット 競合が激化する前に新興テーマを明らかにする 大規模でキュレーションされたトレンドデータベースを保持...
著者 Antoine Tardif, Unite.AIのCEO兼創設者
-

SEO 101SEO Optimization: How Google’s AI Works (10月 2026)
検索エンジン最適化(SEO)は、特定の検索用語に対してウェブページがどのくらいのランクになるかを影響する、ページ内およびページ外の要素を最適化するプロセスです。これは、ページの読み込み速度を最適化すること、リンクビルディング戦略を生成すること、SEOツールを使用すること、さらに計算思考を使用してGoogleのAIを逆にエンジニアリングすることを含む、マルチ面的なプロセスです。計算思考は、コンピュータープログラマーがコードやアルゴリズムを書くときに使用する高度な分析および問題解決技術です。計算思考者は、問題を分解して、第一原理思考を使用して分析することで、真実を探します。Googleは秘密のソースコードを誰にも公開しないので、計算思考に頼ります。Googleの歴史上の重要な瞬間を辿り、使用されているアルゴリズムを形作ったものを学び、そしてこれが重要な理由を学びます。マインドを作成する方法2012年に出版された、著名な未来学者であり発明家であるレイ・カーツワイルによる「マインドを作成する方法:人間の思考の秘密を明らかに」という本から始めましょう。この本は人間の脳を解析し、脳がどのように機能するかを分解しました。私たちは、パターン認識を使用して予測マシンになるために脳が自分自身をトレーニングする方法を、基礎から学びます。常に未来を予測し、次の単語を予測しています。人間は日常生活でパターンをどのように認識しますか?脳ではこれらの接続はどのように形成されますか?本は、階層的な思考を理解することから始めます。これは、多様な要素で構成される構造を理解することであり、これらの要素はパターンに配置されており、この配置はシンボルを表します。たとえば、文字や文字列、さらには文章です。最終的に、これらのパターンはアイデアを形成し、これらのアイデアは人間が構築する製品に変換されます。人間の脳を模倣することで、現在のニューラルネットワークの能力を超えた高度なAIを作成するための道筋が明らかになります。この本は、世界のデータを吸い上げ、多層のパターン認識処理を使用してテキスト、画像、オーディオ、ビデオを解析することで、スケーラブルなAIを作成するためのブループリントでした。クラウドと並列処理能力の利点により、データ入力または出力に最大値はありません。この本は、出版後にすぐに影響力を与え、著者であるレイ・カーツワイルがGoogleに雇用され、機械学習と言語処理に焦点を当てたエンジニアリングディレクターになりました。この役割は、彼が書いた本と完璧に一致していました。この本がGoogleの未来と、ウェブサイトのランキング方法に与えた影響を否定することは不可能です。このAI本は、誰もがSEOの専門家になるために必読であるべきです。ディープマインド2010年に立ち上げられたディープマインドは、新しいタイプのAIアルゴリズムを使用したホットな新しいスタートアップでした。これは強化学習と呼ばれていました。ディープマインドは次のように説明しています。「私たちは、強化学習を使用して、高次元の感覚入力から直接制御ポリシーを学習する最初のディープラーニングモデルを提示します。モデルは、入力が生のピクセルであり、出力が将来の報酬を推定する価値関数である、Q学習のバリアントでトレーニングされた畳み込みニューラルネットワークです。」ディープラーニングと強化学習を融合することで、ディープ強化学習システムになりました。2013年までに、ディープマインドはAtari 2600ゲームで人間のプレイヤーに対して勝利を収めるためにこれらのアルゴリズムを使用していました。人間の脳と同様に、トレーニングと繰り返しによって学習します。人間がボールを蹴ったり、テトリスをプレイしたりするのと同様に、AIも学習します。AIのニューラルネットワークはパフォーマンスを追跡し、自己改善を繰り返し、次のイテレーションでより強力な動作を選択します。ディープマインドは技術的優位性が圧倒的でした。Googleはこの技術へのアクセスを購入しなければなりませんでした。2014年にディープマインドは5億ドル以上で買収されました。買収後、AI業界は連続したブレイクスルーを目撃しました。1997年5月11日、チェスグランドマスターのガルリ・カスパロフが、IBMの科学者によって開発されたチェスプレイヤーコンピューター、ディープブルーに最初の6試合のうち1試合を失ったとき以来、見られませんでした。2015年、ディープマインドはアルゴリズムを改良し、Atariの49のゲームのスイートをテストし、23のゲームで人間のパフォーマンスを上回りました。それが最初でした。2015年の後半、ディープマインドはAlphaGoに焦点を当てました。プロの囲碁世界チャンピオンを倒すことを目的としたプログラムでした。中国で約4000年前に最初に現れた古代のゲームである囲碁は、約10^360の可能な動きがあるため、人間の歴史上で最も困難なゲームと見なされています。ディープマインドは、人間のプレイヤーから学ぶことでAlphaGoシステムをトレーニングするために教師あり学習を使用しました。すぐに、AlphaGoは2016年3月の5試合のマッチで、世界チャンピオンの李世乭を破ったと報道されました。2017年10月、ディープマインドはAlphaGo Zeroをリリースしました。これは、無教師学習を使用するため、人間のトレーニングを必要としない新しいモデルでした。AlphaGo Zeroは、前身をすぐに上回りました。ディープマインドは次のように説明しています。「AlphaGoの以前のバージョンは、人間のアマチュアおよびプロのゲームを数千件学習して、囲碁をプレイする方法を学びました。AlphaGo Zeroはこのステップを省略し、完全にランダムなプレイから開始して、自分自身と対戦することによってのみ学習します。そうすることで、人間のレベルのプレイにすぐに到達し、以前のバージョンのAlphaGoを100戦全勝で破りました。」その間、SEOの世界はPageRankに非常に焦点を当てていました。PageRankはGoogleのバックボーンです。これは1995年に始まり、当時スタンフォード大学の博士課程の学生だったラリー・ペイジとセルゲイ・ブリンが、ウェブページを重要性の尺度にランク付けするという研究プロジェクト「BackRub」に取り組み始めたときです。目標は、バックリンクデータを変換することによってウェブページを重要性の尺度にランク付けすることでした。バックリンクとは、1つのページから別のページへのリンクです。アルゴリズムは後に「PageRank」と改名され、「ウェブページ」と「共同創設者ラリー・ペイジ」の両方にちなんで名付けられました。ラリー・ペイジとセルゲイ・ブリンは、バックリンクのみによってウェブを駆動する検索エンジンを構築するという野心的な目標を持っていました。それが機能しました。PageRankがヘッドラインを支配するSEOの専門家はすぐに、PageRankがどのようにGoogleがウェブページの質のランキングを計算するかを理解しました。賢いブラックハットSEOの起業家は、コンテンツをスケールアップするには、有機的に獲得するのを待つ代わりにリンクを購入する方がよいと理解しました。バックリンクの新しい経済が生まれました。検索エンジンのランキングに影響を与えたいウェブサイトの所有者はリンクを購入し、ウェブサイトをモノ化したいウェブサイトはリンクを売りました。リンクを購入したウェブサイトは、夜の間にGoogleのランキングを上回り、既存のブランドを上回りました。このランキング方法は、長い間非常にうまく機能しました。機械学習が導入され、根本的な問題が解決されたときまで機能しました。強化学習の導入により、PageRankはランキングの変数となり、主な要因ではなくなりました。現在、SEOコミュニティはリンク購入について割り切れています。私は、リンク購入は最適な結果をもたらさないと考え、バックリンクを獲得するための最も良い方法は、業界固有の要因に基づいていると考えています。私はHARO(Help a Reporter Out)と呼ばれるサービスを勧めます。HAROでは、メディアのリクエストに応えることでバックリンクを獲得する機会があります。既存のブランドは、リンクを取得する必要はありません。時間が彼らに味方しているからです。ウェブサイトが古いほど、より多くの高品質のバックリンクを収集する時間が増えます。言い換えると、検索エンジンのランキングは、時間 = バックリンクというメトリックを使用して、ウェブサイトの年齢に大きく依存していました。たとえば、CNNは、ブランド、信頼性、最初から高いランキングであったため、自然にニュース記事のバックリンクを獲得しました。つまり、ユーザーが記事を調べ、最初の検索結果にリンクしている場合、さらにバックリンクを獲得しました。つまり、より高いランクのウェブページは、自然にバックリンクを獲得しました。不幸にも、これにより、新しいウェブサイトはバックリンクアルゴリズムを乱用するためにバックリンクマーケットプレイスに頼らざるを得ないことが多くなりました。2000年代初頭、バックリンクを購入することは非常にうまくいきました。プロセスも簡単でした。リンク購入者は、サイト全体のフッターリンクや記事ごとのリンク(ゲスト投稿として偽装される場合もあります)を、高い権威を持つウェブサイトから購入しました。ウェブサイトの所有者は、質の低いものであっても、ウェブサイトをモノ化したいと考えていたので、喜んで従いました。最終的に、Googleの機械学習エンジニアの才能プールは、検索エンジンの結果を手動でコーディングすることは無駄であることを理解しました。PageRankの多くは手動でコーディングされていました。代わりに、AIが最終的にランキングを完全に、またはほとんど人間の介入なしで計算する責任を負うことになりました。Googleは、強化学習を含むあらゆるツールを使用して競争力を維持しています。世界で最も高度なタイプの機械学習アルゴリズムです。このシステムは、2010年にMetaWebをGoogleが買収したことに加えて、ゲームチェンジャーでした。2010年のMetaWeb買収が重要だった理由は、Googleがキーワードに置いた重みを軽減したからです。コンテキストは突然重要になりました。これは、エンティティと呼ばれる分類化メソッドを使用して実現されました。Fast Companyは次のように説明しています。「一度MetaWebがエンティティを特定すると、結果のセットを提供できます。エンティティを組み合わせて、より複雑な検索を実行することもできます。たとえば、「40歳以上の女優」は1つのエンティティであり、「ニューヨーク市に住む女優」は別のエンティティであり、「現在上映中の映画を持つ女優」は別のエンティティです。」このテクノロジーは、2015年の春にリリースされた主要なアルゴリズムの更新であるRankBrainに組み込まれました。RankBrainは、キーワードベースではなくコンテキストを理解することに重点を置き、さらに環境コンテキスト(検索者の場所など)を考慮し、以前はなかった意味を推測しました。これは特にモバイルユーザーにとって重要な更新でした。ここで、計算理論を使用して、Googleがこれを行う方法について推測してみましょう。ディープラーニングとはディープラーニングは、最も一般的に使用されるタイプの機械学習です。Googleがこのアルゴリズムを使用しないことは不可能です。ディープラーニングは、人間の脳がどのように機能するかに大きく影響を受けています。人間の脳がパターン認識を使用してオブジェクトを識別および分類する方法を模倣しようとします。たとえば、あなたが「a」という文字を見たとき、脳は自動的に線や形を識別して、それを「a」という文字として識別します。「ap」という文字の場合、脳は自動的に未来を予測しようとし、たとえば「app」または「apple」という単語が得られます。他のパターンには、数字、道路標識、または混雑した空港で愛する人を識別することが含まれる場合があります。ディープラーニングシステム内の接続は、人間の脳がニューロンやシナプスと接続する方法に似ています。ディープラーニングは、多層パーセプトロンの多数を結合することによって生じる、機械学習アーキテクチャに与えられた名前です。1つの隠れ層だけではなく、多数の隠れ層があるため、ネットワークはより複雑なパターンを学習できます。完全に接続されたネットワークは、さまざまなディープラーニングアーキテクチャを作成するために、他の機械学習関数と組み合わせることができます。Googleがディープラーニングを使用する方法Googleは、ハイパーリンク(ニューロンと考えることができます)を介してウェブサイトをクロールします。これは、Googleが最初から使用している元の方法であり、現在も使用されています。ウェブサイトがインデックス化されると、さまざまなタイプのAIがこのデータの宝庫を分析します。Googleのシステムは、わずかな人間の入力または介入で、ウェブページをさまざまな内部メトリックに基づいてラベル付けします。介入の例としては、DMCA削除リクエストにより特定のURLが手動で削除される場合があります。Googleのエンジニアは、SEOカンファレンスの出席者を苛立たせることで有名です。Googleがどのように機能するかについて質問がされるのは、常に同じように不完全に回答されるからです。特定のウェブサイトがランク付けに失敗する理由については、ほとんどの場合、同じように不完全に回答されます。回答は、ウェブサイトの所有者が数か月、または数年間、良いコンテンツを作成していることを認めていることが多いのです。予測可能に、ウェブサイト所有者は、価値のあるコンテンツを構築することに焦点を当てるよう指示されます。これは重要な要素ですが、包括的ではありません。この答えの欠如は、エグゼクティブが質問に適切に答えることができないためです。Googleのアルゴリズムはブラックボックスです。入力と出力があり、それがディープラーニングの働き方です。ここで、多くのウェブサイトに悪影響を及ぼすランキングペナルティについて説明します。PageSpeed InsightsGoogleはほとんど透明性がありませんが、PageSpeed Insightsは例外です。PageSpeed Insightsのテストに失敗したウェブサイトは、特にモバイルユーザーが影響を受ける場合は、ペナルティボックスに入れられます。推測されるのは、プロセスの中で、高速なウェブサイトと遅い読み込み(PageSpeed Insightsに失敗した)ウェブサイトを区別する決定ツリーがあるということです。決定ツリーは、データセットをさまざまな基準に基づいて個々のデータポイントに分割するアルゴリズムアプローチです。基準は、モバイルユーザーとデスクトップユーザーに対するランキングに影響を与える可能性があります。仮に、ランキングスコアにペナルティが適用される可能性があります。たとえば、ペナルティなしで5位にランク付けされるウェブサイトは、-20、-50、またはAIによって選択された他の未知の変数によってランキングを25位、55位、または別の番号に低下させる可能性があります。将来的には、GoogleがAIに自信を持つにつれて、PageSpeed Insightsの終焉を見ることができるかもしれません。このスピードテストに対するGoogleの現在の介入は、最適な結果が排除される可能性があるため、危険です。また、技術的に不器用な人に対して差別的です。小規模ビジネスを運営するすべての人が、スピードテストの問題を診断および解決するための専門知識を持つことを要求することは、大きな要求です。1つの簡単な解決策は、GoogleがWordPressユーザー向けのスピード最適化プラグインをリリースすることです。WordPressはインターネットの43%を支配しているからです。不幸にも、すべてのSEO努力は、ウェブサイトがGoogleのPageSpeed Insightsに合格しない限り、無駄です。ウェブサイトがこのテストに合格する方法については、別の記事で説明しますが、少なくともウェブサイトが合格するかどうかを確認する必要があります。心配するべきもう1つの重要な技術的メトリックは、SSL(Secure Sockets Layer)というセキュリティプロトコルです。これにより、ドメインのURLがhttpからhttpsに変更され、データの安全な転送が保証されます。SSLが有効になっていないウェブサイトはペナルティを受けることになります。規則には例外がありますが、ECサイトや金融サイトは最も大きな影響を受けるでしょう。低コストのウェブホストは、SSLの実装に対して年間料金を請求します。一方、Sitegroundのような優れたウェブホストは、SSL証明書を無料で発行し、自動的に統合します。メタデータウェブサイト上のもう1つの重要な要素は、メタタイトルとメタ説明です。これらのコンテンツフィールドは、ページの成功または失敗に大きく貢献する可能性のある、非常に重要な役割を果たします。これは、Googleがメタタイトルとメタ説明を検索結果に表示する可能性が高いからです。したがって、これらのフィールドを可能な限り注意深く埋めることが重要です。代替案は、Googleがメタタイトルとメタ説明を無視して、代わりに予測されるクリック数が多いデータを自動生成することです。如果Googleが予測を誤り、適切なタイトルを自動生成しない場合、これによりクリック数が減り、結果として検索エンジンのランキングが低下します。Googleが含まれているメタ説明がクリックを得るのに最適化されていると判断した場合、検索結果に表示されます。そうでない場合は、Googleはウェブサイトからランダムなテキストのチャンクを選択します。Googleは通常、ページ上で最も適切なテキストを選択しますが、Googleはどの説明を選択するかを判断するのが非常に悪いです。もちろん、コンテンツが本当に優れていると感じる場合は、Googleが最も適切なメタ説明を自動生成することを許可することは時々意味があります。コンテンツが豊富であるため、この記事ではメタ説明を省略します。Googleは、ユーザーのクエリに最も適した説明を選択する可能性が高いです。人間は、最良の検索結果をクリックしています。これは、人間のループ、つまりGoogleの最後のフィードバックメカニズムです。ここで、強化学習が機能します。強化学習とは強化学習は、AIエージェントを繰り返し行うアクションと関連する報酬を通じてトレーニングする、機械学習のテクニックです。強化学習エージェントは、環境で実験し、アクションを実行し、正しいアクションを実行したときに報酬を受け取ります。時間の経過とともに、エージェントは報酬を最大化するアクションを学習します。報酬は、推奨ページで費やした時間の量を計算する単純な計算に基づく場合があります。この方法論を人間のループサブルーチンと組み合わせると、YouTube、Netflix 、Amazon Primeなどのデジタル生活のすべての側面を制御する既存のレコメンダーエンジンと非常に似ているように聞こえます。検索エンジンがどのように機能するべきかについてあなたは正しいです。Googleが強化学習を使用する方法Googleのフライホイールは、各検索で改善されます。人間は、最も適切な結果を選択することでAIをトレーニングし、他の数百万のユーザーの同様のクエリも同様にします。強化学習エージェントは、人間と検索結果の間で最もポジティブな相互作用のみを強化することによって、継続的に自己改善に取り組んでいます。Googleは、結果ページをスキャンするのにかかる時間、クリックするURL、訪問したウェブサイトで費やした時間、および戻るクリックを測定します。これらのデータは、類似のデータマッチまたはユーザーエクスペリエンスを提供するすべてのウェブサイトと比較してコンパイルされます。滞在時間(滞在時間)が低いウェブサイトは、強化学習システムによって負の値が与えられ、他の競合するウェブサイトがテストされてランキングが改善されます。Googleは、人間の介入がない限り、偏見がないと仮定して、最終的に望ましい検索結果ページを提供します。ユーザーは、無料のデータをGoogleに提供し、ディープ強化学習システムの最終的なコンポーネントになります。代わりに、Googleはユーザーに広告をクリックする機会を提供します。広告は、収益を生成する以外に、ユーザーがクリックしたいものについての追加のデータを提供する二次的なランキング要素として機能します。Googleは、基本的に、ユーザーが何を望んでいるかを学習します。これは、ユーザーの興味に合わせてコンテンツをターゲットにするビデオストリーミングサービスによるレコメンダーエンジンに類似しています。たとえば、ユーザーがロマンチックコメディの連続的なストリームを楽しむ場合、同じコメディアンを共有するパロディーも楽しむ可能性があります。これがSEOにどのように役立つか計算思考を続けると、Googleは最良の結果を提供するように自己トレーニングされていると仮定できます。これは、人間の偏見を満たすことによって達成されることが多いです。実際、GoogleのAIがこれらの偏見に最適化された結果を提供しないことは不可能です。そうでない場合、結果は最適化されません。言い換えると、魔術的な公式はありませんが、ベストプラクティスはあります。SEOプラクティショナーの責任は、Googleが探している特定の業界の偏見を認識することです。たとえば、日付を指定せずに選挙の投票結果を検索する人は、最新の結果を検索する可能性が高いです。これは、新しさの偏見です。レシピを検索する人は、最新のページではなく、時間の試練に耐えたレシピを望むかもしれません。SEOプラクティショナーの責任は、訪問者が探しているものを提供することです。これが、Googleでランク付けする最も持続可能な方法です。ウェブサイト所有者は、特定のキーワードをターゲットにし、ユーザーに何でも提供できるという期待を放棄する必要があります。検索結果は、ユーザーのニーズと正確に一致する必要があります。偏見とは何でしょうか?ドメイン名が高い権威を持っているかどうか、つまり市場にサービスを提供しているかどうかを判断することができます。たとえば、ドメイン名に「インド」という言葉が含まれていると、米国のユーザーがURLをクリックすることをためらう可能性があります。これは、居住国の結果を信頼する国粋主義的な偏見のためです。一言で言えば、権威の幻想を与える可能性があります。最も重要な偏見は、ユーザーの検索クエリに何が一致するかです。FAQ、トップ10のリスト、ブログ投稿、またはその他のものですか。これを理解する必要があります。答えは簡単に見つけることができます。ターゲット市場でGoogle検索を実行するだけで、競合他社を分析する必要があります。ブラックハットSEOは死んだこれを、ウェブサイトをランク付けするための攻撃的な方法であるブラックハットSEOと比較してみましょう。ブラックハットSEOでは、スパム技術を悪用する方法が使用されます。リンクを購入または偽造する、ウェブサイトをハッキングする、大量の自動生成されたソーシャルブックマークを作成するなどの方法が含まれます。これらの方法は、さまざまな検索エンジンマーケティングフォーラムで再販されるブラックハットツールを介して適用されます。価値はほとんどありませんが、販売者は豊かになります。これが、私がブラックハットを放棄することをお勧めする理由です。代わりに、SEOを機械学習の観点から見ることに焦点を当てましょう。重要なのは、誰かが検索結果をスキップして下に埋もれた結果をクリックするたびに、人間のループがディープ強化学習システムと協力して自己改善を助けていることを理解することです。これは、人間の歴史上で最も多くのユーザーによってトレーニングされた機械学習アルゴリズムです。Googleは、平均して1分間に380万件の検索を処理します。1時間に2280万件、1日に56億件の検索を処理します。これは、多くのデータです。ブラックハットSEOを試みることは愚かです。GoogleのAIが停滞することは不可能です。システムは、自己改善を指数関数的に行うために、加速収束の法則を使用しています。GoogleのAIは、最終的に人工一般知能(AGI)に到達する最初のAIになる可能性があります。AGIは、1つの分野で学習した知能を、さまざまな分野に適用することができる知能です。Googleの将来のAGIの努力については別の記事で説明しますが、プロセスが始まると、停止するのが難しいということだけを理解しておく必要があります。現在、Googleは狭いAIです。ブラックハットにさらに1秒も費やすことは、愚かです。ホワイトハットSEOGoogleのAIが自己改善を続けることを受け入れると、Googleを出し抜こうとすることを放棄する必要があります。代わりに、Googleが探しているものを最適化して、ウェブサイトを最適化することに焦点を当てましょう。これには、SSLを有効にすること、ページの読み込み速度を最適化すること、メタタイトルとメタ説明を最適化することが含まれます。これらのフィールドを最適化するには、メタタイトルとメタ説明を競合するウェブサイトと比較して、クリック率が高い要素を特定する必要があります。クリックを最適化した場合、次の目標は、最も優れたランディングページを作成することです。目標は、平均滞在時間が類似の競合他社を上回るランディングページを提供することです。ユーザーエクスペリエンスを最も優れたものにすることで、ウェブページはランク付けを向上させることができます。これまでに、最も重要なメトリックとしてこれらを特定しました。 読み込み速度 SSL有効 メタタイトルとメタ説明 ランディングページ ランディングページは最も難しい要素です。世界と競合しています。ランディングページは、期待されるすべてを提供し、ユーザーをさらに驚かせることができなければなりません。最終的な考察Googleが使用する他のAIテクノロジーについて、またはSEOの兎穴をさらに掘り下げることについて、2000語以上を書くことは簡単です。しかし、ここでの意図は、最も重要なメトリックに焦点を当てることです。SEOの実践者は、システムを操作しようとしているので、最終的には、SEOの最も重要な要素である、ユーザーに可能な限り多くの価値を提供することを忘れてしまいます。1つの方法は、重要なコンテンツが古くなることを決して許さないことです。1ヶ月後に重要な貢献を思いついた場合、それはこの記事に追加されます。Googleは、コンテンツがどのくらい新しいかを判断し、ページが価値を提供する履歴と一致させます。バックリンクを取得することについて心配している場合は、解決策は簡単です。訪問者の時間を尊重し、価値を提供します。バックリンクは自然に得られます。ユーザーはコンテンツの価値を見つけるので、共有したいと思うからです。質問は、ウェブサイト所有者が最良のユーザー価値とユーザーエクスペリエンスを提供する方法に移ります。
著者 Antoine Tardif, Unite.AIのCEO兼創設者