
ヘルスケア
医療を革命する:大規模言語モデルが医療に与える影響と将来

 Unite.AI を Google の優先ソースに追加

要点GoogleのMed-PaLM 2は、米国医師免許試験の問題で専門家レベルの成績を達成しました。
もっと見る
- GoogleのMed-PaLM 2は、米国医師免許試験の問題で専門家レベルの成績を達成しました。
- スタンフォード大学のNigam Shahは、監督下のインターンのように特定の医療データでLLMを訓練することを提唱しています。
- オープンソースのMeditronモデルは、臨床信頼性を高めるために厳選された医療情報源で訓練されています。
医療とヘルスケアにおける大規模言語モデル(LLM)の統合と応用は、大きな関心を集め、開発が進んでいる分野である。
医療情報管理システム協会の世界会議などの主要なイベントでも示されたように、Google (GOOGL ) などの企業は、医療における生成AIの可能性の探究を主導している。Med-PaLM 2などの取り組みは、診断、患者ケア、事務作業の効率化をはじめとする、AIを活用した医療ソリューションの進展を示している。
GoogleのMed-PaLM 2は医療分野の先駆的なLLMであり、米国医師免許試験形式の質問で「専門家」レベルに達するなど、優れた能力を示している。同種のモデルも含め、医療従事者による情報へのアクセスや活用の方法を変革し、診断の精度や患者ケアの効率を高める可能性がある。
一方、臨床現場での実用性と安全性には懸念もある。モデルの訓練に膨大なインターネット上のデータを用いることは、状況によっては有益でも、医療目的には必ずしも適切で信頼できるとは限らない。ニガム・シャー博士(PhD、MBBS)、Stanford Health Careのチーフデータサイエンティストが指摘するように、重要なのは、実際の医療現場での性能と、患者ケアや医療の効率に与える実際の影響である。
シャー博士は、医療へのLLMの活用には、より用途に合わせた方法が必要だと強調する。幅広いインターネットデータで訓練した汎用モデルではなく、特定の関連する医療データで訓練する、焦点を絞った戦略を提案している。研修医に具体的な課題を与え、仕事ぶりを監督し、能力を示すにつれて徐々に自律性を認めていくことに似ている。
この考え方に沿うEPFLの研究者によるMeditronの開発は、興味深い進歩である。医療用途に特化したオープンソースLLMのMeditronは、PubMedや診療ガイドラインなどの信頼できる情報源から厳選した医療データで訓練され、より用途に即した、信頼性の高い可能性のあるツールを医療従事者に提供する。オープンソースであることは、透明性や協働を促すだけでなく、幅広い研究コミュニティによる継続的な改善や厳しい条件での検証も可能にする。

MEDITRON-70BはMedQAの4択形式の米国医師免許試験型質問で正解率70.2%を達成
MeditronやMed-PaLM 2などの開発は、AIを医療に応用する際の固有の要件に対する認識が高まっていることを示す。関連性のある高品質な医療データで訓練し、臨床現場での安全性と信頼性を確かめることが極めて重要である。
また、赤十字国際委員会の人道支援の現場など、多様な状況のデータを取り入れることは、世界の医療のさまざまなニーズや課題への配慮を示している。技術的に先進的であるだけでなく、社会的責任を果たし、役立つAIツールを生み出そうとする、多くのAI研究拠点の使命にも合致する。
Nature誌で発表された論文「大規模言語モデルは臨床知識を符号化する」は、LLMを臨床現場で効果的に活用する方法を探究している。医療分野におけるLLMの能力と限界に光を当て、新しい知見と手法を示す研究である。
医療は複雑な分野であり、多種多様な症状、疾患、治療法が常に変化している。LLMには、この複雑さを理解するだけでなく、最新の医療知識やガイドラインに対応することも求められる。
研究の中心となるのは、新たに構成されたベンチマークMultiMedQAである。既存の6つの医療質問応答データセットに、オンラインで頻繁に検索される医療上の質問を集めた新しいHealthSearchQAを組み合わせている。事実への忠実さ、理解、推論、起こり得る害、バイアスなど、多面的にLLMを評価し、限られたベンチマークに依存していた従来の自動評価の限界に対処することを目指す。
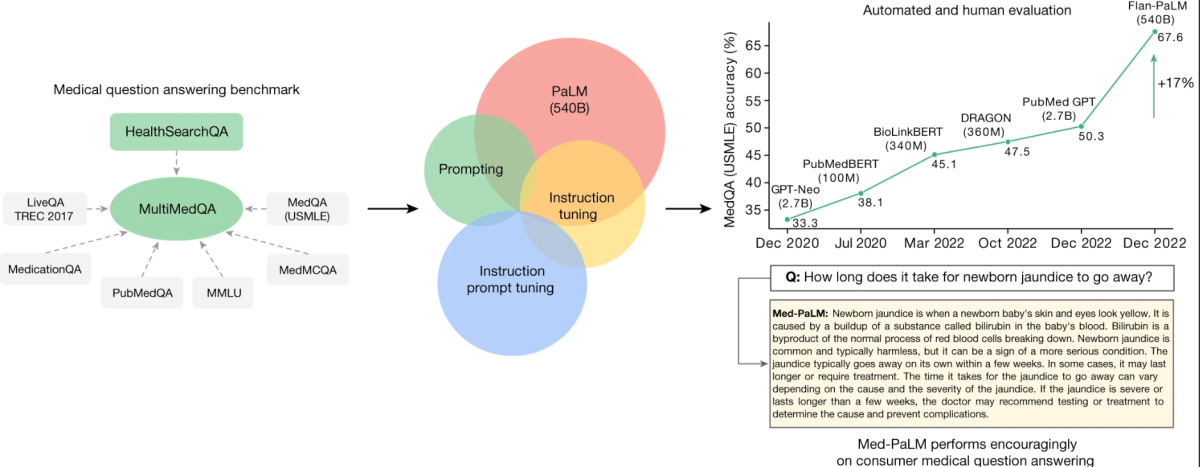
医師試験を含む医療質問応答のベンチマークMultiMedQA
この研究では、5400億パラメーターのPathways Language Model(PaLM)と、指示に合わせて調整した派生モデルFlan-PaLMを、MultiMedQAで評価している。Flan-PaLMはMultiMedQAのすべての多肢選択式データセットで当時の最高水準の正解率を達成し、米国医師免許試験形式のMedQAでは67.6%を記録した。これは従来の最高水準を17%超上回る大きな改善である。
MedQA
MedQAデータセットには、米国医師免許試験(USMLE)形式の質問が収録され、各問に4つまたは5つの選択肢がある。開発用セットは11,450問、テスト用セットは1,273問で構成される。
形式:質問と回答(Q+A)、多肢選択式、オープンドメイン。
質問例:高血圧のある65歳男性が、定期健康診断のために受診した。現在の服用薬はアテノロール、リシノプリル、アトルバスタチンである。脈拍は毎分86回、呼吸数は毎分18回、血圧は145/95 mmHg。心臓の診察で拡張末期雑音を認める。この身体所見の原因として最も考えられるものはどれか。
選択肢(正解は太字):(A)左心室のコンプライアンスの低下、(B)僧帽弁の粘液腫様変性、(C)心膜の炎症、(D)大動脈基部の拡張、(E)僧帽弁尖の肥厚。
一方で、特に一般の人からの医療上の質問に答える場面では、モデルの性能に重大な不足も見つかった。研究者は、少数の例を使ってLLMを新しい分野に効率よく適応させる「指示プロンプトチューニング」を導入し、Med-PaLMを作成した。Med-PaLMは理解、知識の想起、推論に改善を示し、有望な性能を見せたものの、依然として臨床医には及ばなかった。
この研究の特徴の一つは、詳細な人間による評価の枠組みである。モデルの回答が科学的合意と一致しているか、有害な結果を招く可能性があるかを調べる。Flan-PaLMの長文回答で科学的合意に沿っていたのは61.9%だったのに対し、Med-PaLMでは92.6%へ上昇し、臨床医の回答に匹敵した。また、有害な結果を招く可能性も、Flan-PaLMに比べてMed-PaLMでは大きく低下した。
人間によるMed-PaLMの回答評価は、複数の領域で臨床医の回答に近い能力を示し、臨床現場での支援ツールとしての可能性を裏付けた。
これらの研究は、LLMを医療用途に向けて改善するための複雑な課題を扱っている。そこでの手法や知見は、他のさまざまな分野のLLMの能力向上にも応用できる。主な点を見ていこう。
指示チューニングによる性能向上
- 汎用的な応用:具体的な指示やガイドラインに基づいてLLMを微調整する指示チューニングは、さまざまな分野で性能を大きく改善することが示されている。法務、金融、教育などにも応用し、出力の正確さと関連性を高められる可能性がある。
モデル規模の拡大
- より広い意味:モデルの大型化が性能を改善するという知見は、医療質問応答に限らない。パラメーターの多い大規模モデルは、より細やかで複雑な応答を処理・生成できる。微妙な違いの理解と適切な応答が重要な、顧客サービス、創作、技術支援などでも役立つ可能性がある。
思考の連鎖(CoT)プロンプティング
- 多様な分野での利用:CoTプロンプティングは医療データセットで必ず性能を改善するわけではないが、複雑な問題解決を要する他の分野では有用になり得る。技術的な問題の切り分けや複雑な意思決定などで、情報を段階的に処理するようLLMを導き、より正確で筋道の通った出力につなげられる。
自己整合性による正確さの向上
- 幅広い応用:複数の出力を生成し、最も整合性のある回答を選ぶ自己整合性の手法は、さまざまな分野で性能を大きく改善する可能性がある。金融や法務など正確さが極めて重要な領域では、生成した出力を相互に検証し、信頼性を高めるために使える。
不確実性と選択的予測
- 分野を超えた重要性:誤情報が深刻な結果につながる医療や法律などでは、不確実性の見積もりを伝えることが重要である。LLMが不確実性を表明し、確信が低いときには予測を控える能力は、不正確な情報の拡散を防ぐ重要な手段となり得る。
実際の応用は質問応答にとどまらず、患者への説明、診断過程の支援、医学生の訓練にも及ぶ。ただし、適切な人間の監督なしにAIに依存しないよう、導入は慎重に管理しなければならない。
医療知識の進展に合わせ、LLMも適応し、学習する必要がある。時間がたっても関連性と正確さを保てるよう、継続的な学習と更新の仕組みが求められる。


