
AIモデルとプラットフォーム
Appenの新しいオフザシェルフ(OTS)データセット – AIの導入を加速する

 Unite.AI を Google の優先ソースに追加
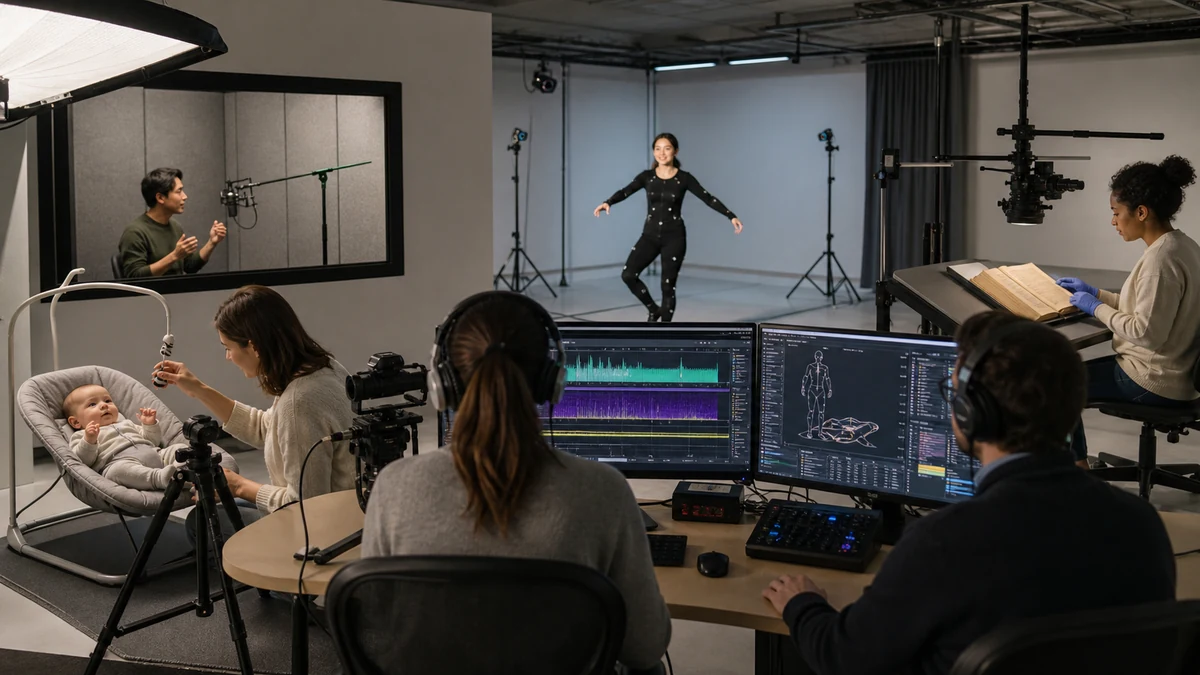
Appen Limited (ASX:APX)は、AIシステムを大規模に構築する組織向けの高品質なトレーニングデータを提供するリーディングプロバイダーであり、本日、新しいオフザシェルフ(OTS)データセットを発表しました。これらのデータセットは、ビジネスがAIおよび機械学習(ML)プロジェクトを加速するために必要な高品質なトレーニングデータを容易に取得できるように設計されています。新しいOTSデータセットには、人間の身体の動きや革新的で赤ちゃんの泣き声、スクリプト化されたスピーチやテキストが含まれる画像が含まれており、オプティカルキャラクターレコグニション(OCR)に適しています。アラビア語、クロアチア語、ギリシャ語、ハンガリー語、タイ語など、高需要だが入手が難しい言語に対応しています。拡張データセットにより、AppenのOTSオファリングの総数は250を超え、11,000時間以上のオーディオ、25,000以上の画像、80以上の言語と方言を含む8,700万語句を超えています。
AppenのOTSデータセットは、AIまたはMLプロジェクトを一貫した高品質なトレーニングデータで迅速に開始するための迅速でコスト効率の高いツールです。AI機能を拡大するチームも、OTSデータセットを使用して効果的に精度を向上させ、新しいモデルスキルを開発し、他の改善をAIモデルに組み込むことができます。OTSデータセットは、たとえば、新しいデータセット収集および注釈付けプロジェクトの8〜12週間よりも1週間で提供されることがよくあります。複雑さに応じてさらに長くなる場合もあります。Appenのすべてのデータセットは、完全に透明で、オプトイン方式で開発されており、AIスペシャリストはデータがクリーンでコンプライアンスされていることを保証できます。潜在的なリスクや評判の被害を排除できます。
「世界中のAIチームは、厳しい締め切りと柔軟なデータ要件を持つプロジェクトで、オフザシェルフデータセットを使用することで利益を得ることができます」と、AppenのCTOであるウィルソン・パンさんは述べています。 「OTSデータセットは、時間とコストを短縮し、高品質なデータにアクセスできるようにします。Appenでは、すべてのデータセットが倫理的に収集され、人口統計的にバランスの取れたものであることを保証するために必要な措置を講じています。企業は、モデル内の偏見を最小限に抑え、データ注釈付け者への公平な扱いを保証することで、責任あるAIの実践を維持できます。OTSデータセットの正確な品質がわかっているため、現実世界で機能するより良いAIを構築するのに役立ちます。」
MediaInterfaceは、20年以上にわたって、ドイツやヨーロッパの他の地域にある医療関連の機関に言語技術のソリューションを提供しています。フランスに拡大する際、同社はフランス語のレキシコンデータ、特にフランス語の名前や場所が不足していました。これらの名前や場所は、患者さんのヘルスケア情報でよく参照されます。AppenのOTSデータセットを使用して、MediaInterfaceは約21,000のフランス語の名前と14,000の地名を取得しました。 「Appenから得た重要なデータは、私たちのバックグラウンドレキシコンに組み込まれており、新しい市場に成功裏に立ち上がることができました。また、これにより、私たちのクライアントのための新しい語彙を構築し、将来の市場立ち上がりのアプローチを強化することができます」と、MediaInterfaceのプロダクトマネージャーであるイネス・ウェンドラーさんは述べています。
最も経験豊富なAI専門家は、OTSデータセットをオンデマンドのデータ収集および注釈付けプロジェクトと組み合わせて、複雑なAIモデルトレーニングデータのニーズを満たします。Appenは、AIパワードのツールや自動化されたワークフローを通じて、継続的なサポートを提供するリーダーであり、データ収集サービス、スマートラベリング、効率性の最大化を提供しています。
「私たちは、AIと相互作用しています。目覚める瞬間から寝る瞬間まで、仮想アシスタント、チャットボット、検索エンジン、ソーシャルネットワーク、医療機器、スマートカー、他のアプリケーションを通じて」と、AppenのAIスペシャリストのシニアディレクターであるジュディス・ビショップさんは述べています。 「言語は、これらの多くの魅力的なAIユースケースの主なインターフェイスであるため、モデルが誰に対しても機能することを保証するために、トレーニングする必要があります。Appenの高品質なデータと責任ある、倫理的なAI開発への取り組みにより、企業は自社のOTSデータセットを購入して、データに完全な信頼をもってAIプロジェクトを加速することができます。」
appen.comに既に公開されている数百のデータセットに加えて、利用可能な新しいAppen OTSデータセットのリストには、以下が含まれます:
- アラビア語(エジプト)、アラビア語(サウジアラビア)、アラビア語(アラブ首長国連邦)、中央クメール語(カンボジア)、クロアチア語、ギリシャ語、ハンガリー語、ポーランド語、スペイン語(スペイン)、トルコ語のスクリプト化されたスピーチ
- 簡体中国語印刷テキスト、タイ印刷テキスト、フィンランド印刷テキストの画像OCR – 広告、外包装、標識、雑誌、メニューを含む、コンピュータビジョンOCRモデルをトレーニングおよび更新するための事前録音されたビルボード
- 人間の身体の動き(中国)- ピクセルレベルでトラッキングされた、ゲーム開発、フィットネスアプリなどに適した人の動きの注釈付ビデオ
- 赤ちゃんの泣き声オーディオ(中国)- 親に異なる泣き声を認識して警告するためにAIモデルをトレーニングするために使用できる、事前録音および注釈付の赤ちゃんの音
さらに詳しい情報やAppen OTSデータセットのサンプルをリクエストするには、こちらをクリックしてください。


