
Andersonの視点
Stable Diffusionはどのように一般消費者向けの主流製品へ発展できるか

 Unite.AI を Google の優先ソースに追加
要点主流のStable Diffusionアプリは、複雑なコマンドラインインストールと依存関係の問題を解決しなければならない。
もっと見る
- 主流のStable Diffusionアプリは、複雑なコマンドラインインストールと依存関係の問題を解決しなければならない。
- 商用開発者は、ディープフェイク生成とNSFWコンテンツフィルターに伴う法的リスクに直面している。
- 時間的一貫性やテキスト反転のような高度な機能は、一般消費者が利用するにはクラウドベースの処理を必要とする。
皮肉なことに、Stable Diffusionは世界を席巻した新しいAI画像合成フレームワークだが、まだ安定しているわけでも、広く普及しているわけでもない。
システムの機能全体は、少数の開発者が絶えず変更するさまざまな実装に分散している。開発者たちはDiscordの各種討論で最新の情報や理論を盛んに交換しているが、作成・改変するパッケージのインストール手順の大半は、簡単にすぐ使えるものとは程遠い。
むしろ、通常はコマンドラインやBATファイルによるインストールが必要で、GIT、Conda、Python、Minicondaなどの高度な開発フレームワークを使用する。一般消費者には珍しいソフトウェア群なので、インストールするとウイルス対策・マルウェア対策製品がシステム侵害の証拠として頻繁に警告する。

現在の標準的なStable Diffusionのインストールに必要な手順のごく一部。多くの配布版は特定のPythonバージョンも要求し、利用者のマシンにある既存バージョンと競合しうる。ただしDockerベースのインストールや、ある程度はConda環境の利用で回避できる。
Stable DiffusionのSFW、NSFW双方のコミュニティのスレッドには、Pythonスクリプトや標準インストールを改変して機能を高め、頻発する依存関係エラーなどを解決するヒントがあふれている。
このため、テキストプロンプトからすばらしい画像を作りたい一般消費者は、増え続ける有料のウェブAPIにほぼ全面的に頼らざるを得ない。大半はごく少数の画像を無料生成できるだけで、その後はトークン購入が必要になる。
さらに、こうしたウェブサービスのほぼすべては、Stable DiffusionをOpenAIの検閲されたDALL-E 2と区別するNSFWコンテンツの出力を拒む。その中には、戦争など、ポルノとは関係のない一般的関心事も多く含まれうる。
Stable DiffusionのためのPhotoshop
Twitterの#stablediffusionハッシュタグを毎日埋める幻想的、きわどい、あるいは異世界のような画像に魅了された大衆が待っているのは、Stable DiffusionのためのPhotoshopだ。Stability.aiのアーキテクチャの最も優れた強力な機能と、SD開発コミュニティの独創的な革新をまとめた、各種プラットフォームにインストールできるアプリである。ポップアップするコマンドライン画面や、不明瞭で絶えず変わるインストール・更新手順、欠けた機能はない。
現在、機能の充実した実装の大半にあるのは、別個のコマンドライン画面に隣接する、仕上がりのさまざまなウェブページであり、URLはlocalhostのポートを指している。

コマンドライン駆動のFaceSwapやBAT中心のDeepFaceLabなどの合成アプリと同様、Stable Diffusionのprepackインストールもコマンドライン由来であることを示している。localhostのポート経由で開くインターフェースは、上の画像の上部に示されており、CLIベースのStable Diffusion機能と通信する。
より使いやすいアプリが登場するのは間違いない。Patreon経由でダウンロードできる一体型アプリもすでにいくつかあり、GRiskやNMKDが例だ。下の画像を参照してほしい。しかし、より高度で利用しにくい一部のStable Diffusion実装が持つ全機能を統合したものは、まだない。

Patreonで提供される初期のStable Diffusionパッケージは、まだ部分的にアプリ化された段階だ。NMKDはCLI出力をGUIに直接統合した最初のパッケージである。
このすばらしいオープンソース製品を、より洗練され統合された形で実装すればどうなるか、どんな課題があるかを見てみよう。
十分な資金を投じた商用Stable Diffusionアプリの法的検討事項
NSFWという要因
Stable Diffusionのソースコードは、極めて寛容なライセンスで公開されている。ソースコードを幅広く活用する商用の再実装や派生作品は禁止されていない。
前述のPatreonベースの実装が増え、Figma、Krita、Photoshop、GIMP、Blenderなどのアプリ用プラグインも多数開発されている。資金豊富なソフトウェア企業が、はるかに高度で強力なStable Diffusionアプリを作れない実際的な理由はない。市場の観点では、そのような取り組みがいくつか、すでに相当進んでいると考える十分な根拠がある。
こうした取り組みは直ちにジレンマに直面する。多くのStable DiffusionウェブAPIと同様、システム内蔵のコード片であるNSFWフィルターをオフにすることをアプリで認めるかどうかだ。
NSFWスイッチを隠す
Stability.aiのStable Diffusionオープンライセンスには、システムを使用してはならない用途が幅広く解釈できる形で挙げられている。これにはポルノコンテンツやディープフェイクが含まれうる。しかし提供元が実効的に禁止するには、NSFWフィルターをPythonファイル内の設定ではなく内部を見通せない実行ファイルへコンパイルするか、NSFW指示を含むPythonまたはDLLファイルのチェックサム照合を強制する必要がある。設定を利用者が変更すると描画できなくなる仕組みだ。
すると想定されるアプリは、現在のDALL-E 2のように機能を制限され、商業的魅力を失う。さらに、元のPython実行時要素でも、現在TopazのAI画像改善ツールが使うコンパイル済みDLLでも、これらを逆コンパイルして改変した版が、いずれトレントやハッキングのコミュニティに出現するだろう。障害となる要素を置換し、チェックサム要件を無効化すれば制限を解除できるからだ。
最終的に提供元は、現在の多くのStable Diffusion配布版が初回起動時に示すStability.aiの悪用禁止警告を繰り返すだけにするかもしれない。
しかし、このような非公式な免責文を使う小規模なオープンソース開発者は、Stable Diffusionを完全で利用しやすくするために多大な時間と資金を投じた企業に比べ、失うものが少ない。企業にはより深い検討が必要だ。
ディープフェイクへの責任
最近指摘したように、開発中のStable Diffusionモデルが学習した42億枚の画像の一部を占めるLAION-aestheticsデータベースには、有名人の画像が多数含まれる。そのため、有名人のディープフェイクポルノを含むディープフェイクを利用者は作成できる。

以前の記事より。Jennifer Connellyの40年にわたるキャリアの四つの時期をStable Diffusionで生成した。
これは、実在の人物を描かない、通常は合法な抽象的ポルノの生成とは別の、より議論を呼ぶ問題だ。もちろん、そうした画像も学習素材の多数の実写写真から推論される。
米国のより多くの州や国々がディープフェイクポルノ禁止法を準備・施行しているため、Stable Diffusionの有名人ポルノ生成能力は、完全には検閲されていない、つまりポルノを作れる商用アプリでさえ、認識された有名人の顔をフィルタリングする必要があるかもしれないことを意味する。
一つの方法は、有名人の名前や関連する架空の人物など、ユーザープロンプトで受け付けない語の内蔵禁止リストを用意することだ。元データには他言語も含まれるため、英語以外の複数言語にも対応する必要があるだろう。Clarifaiなどが開発する有名人認識システムを組み込む方法もある。
ソフトウェア企業は、こうした機能を違法にする可能性がある新法を待つ間、完全な独立型Stable Diffusionアプリが有名人の顔を生成することを防ぐ助けになる方法を、初期状態ではオフかもしれないが、提供せざるを得ないかもしれない。
もちろん、関心を持つ人はこれらも逆コンパイルして無効化できる。それでも逆解析が過度に容易でなければ、提供元はこれを許可のない破壊行為だと主張できる。
搭載できる機能
十分な資金を投じた商用アプリには、どのStable Diffusion配布版にもある基本機能が期待される。テキストプロンプトから適切な画像を作るテキストから画像、スケッチや他の画像を新しい画像の指針にする画像から画像、システムの創造性を調整する手段、描画時間と品質の兼ね合いを選ぶ方法などだ。画像やプロンプトの任意の自動保存、RealESRGANによる通常の任意の拡大、少なくともGFPGANまたはCodeFormerによる基本的な顔補正も含まれる。
これらはかなり基本的な構成だ。現在開発・拡張されており、完全な従来型Stable Diffusionアプリに組み込めそうな高度な機能を見てみよう。
確率的エンコードの固定
以前の成功した描画のシードを再利用しても、次の描画でプロンプトや元画像、あるいは両方のどこか一部分でも変わると、Stable Diffusionに変換を正確に繰り返させるのは非常に難しい。
EbSynthを使ってStable Diffusionの変換を実写映像に時間的に一貫した形で適用したい場合、これは問題になる。ただし頭と肩を写した単純な構図には大変効果的なことがある。
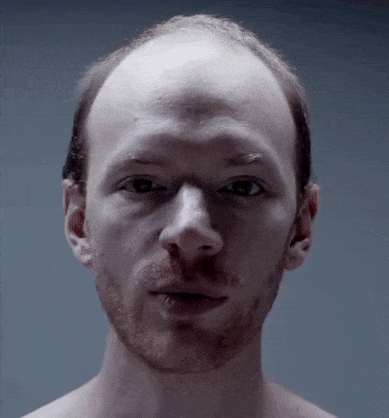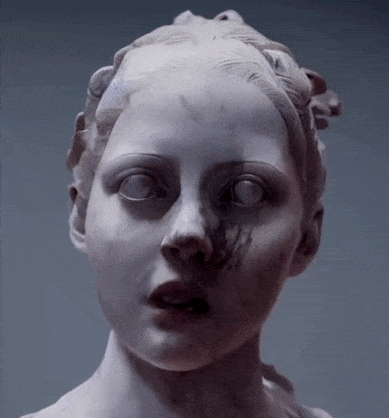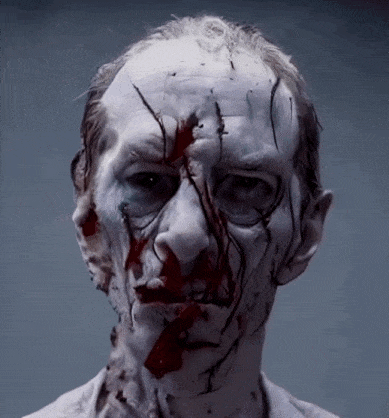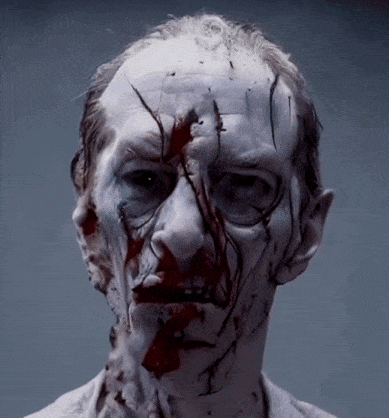
動きが限られていれば、EbSynthはStable Diffusionの変換をリアルな映像に取り込む有効な手段になりうる。 出典:https://streamable.com/u0pgzd
EbSynthは、変更した少数のキーフレームを、画像ファイルの連続に展開した映像全体へ外挿する。画像は後で再び動画に組み立てられる。

EbSynthサイトのこの例では、動画の少数のフレームを芸術的に着色している。EbSynthはこれらをスタイルの指針にして動画全体を同様に変更し、描かれたスタイルに合わせる。 出典:https://www.youtube.com/embed/eghGQtQhY38
下の例では、左の実在する金髪のヨガ講師はほとんど動いていない。それでもStable Diffusionは一貫した顔を保てない。キーフレームとして変換する三枚の画像は、同じ数値シードを使っていても完全に同じではないからだ。

三つの変換でプロンプトとシードが同じで、元フレームの変化が小さくても、筋肉の大きさや形が変わる。さらに重要なのは顔が不統一で、EbSynth動画にした際の時間的一貫性を妨げることだ。
下のEbSynth/SD動画は、利用者の指をそれぞれ歩くズボンとアヒルに変える創意に富んだものだ。しかしズボンの不一致は、元フレームが似ていてシードが同じでも、Stable Diffusionが異なるキーフレーム間で一貫性を保てない問題を示す。
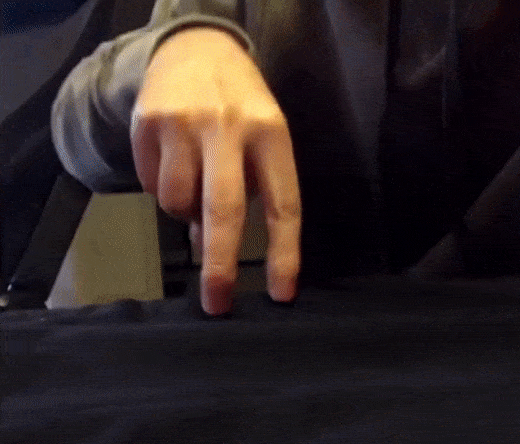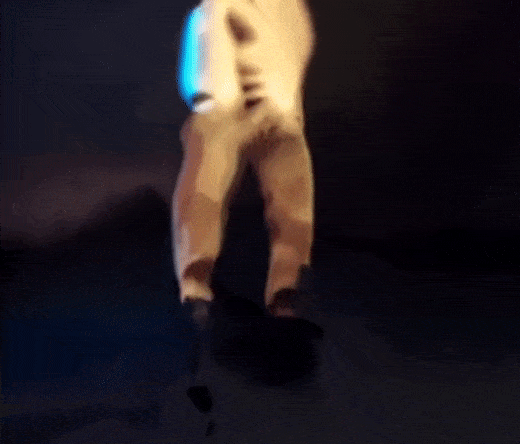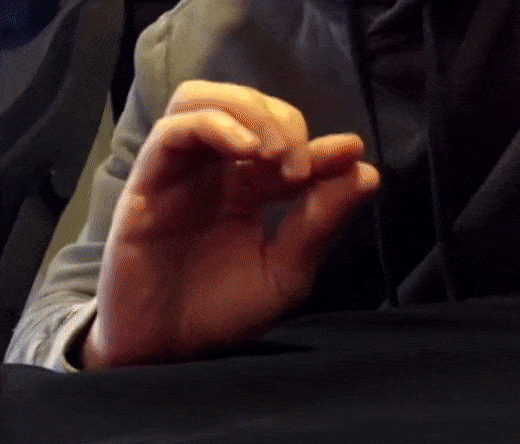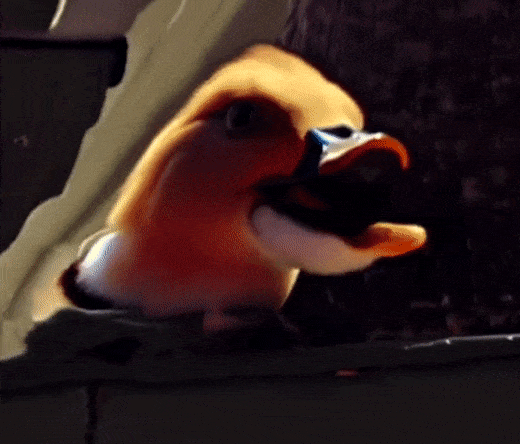
Stable DiffusionとEbSynthによって、男性の指が歩く人とアヒルに変わる。 出典:https://old.reddit.com/r/StableDiffusion/comments/x92itm/proof_of_concept_using_img2img_ebsynth_to_animate/
動画を作った利用者は説明している。二つのうちアヒルへの変換は、より効果的ともいえるが、印象や独創性では劣り、必要な変換済みキーフレームは一枚だけだった。一方、歩くズボンにはStable Diffusion画像50枚が必要で、時間的不一致が目立つ。50枚それぞれで一貫性を得るために五回の試行が必要だったとも述べている。
したがって、本当に包括的なStable Diffusionアプリが、キーフレーム間の特性を最大限保存する機能を備えれば大きな利点になる。
一つの方法は、各フレームの変換に使う確率的エンコードを利用者が固定できるようにすることだ。現在はソースコードを手動で変更するしかない。下の例のように時間的一貫性に役立つが、完全には解決しない。
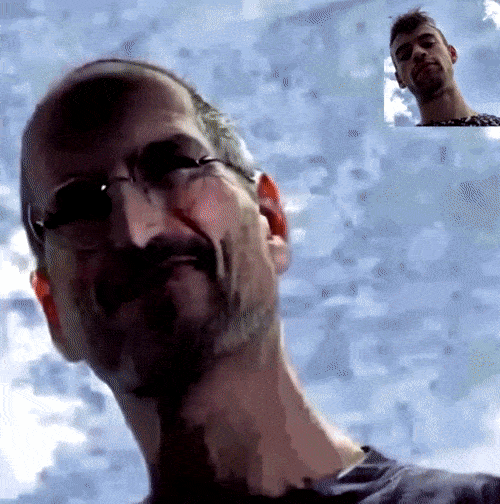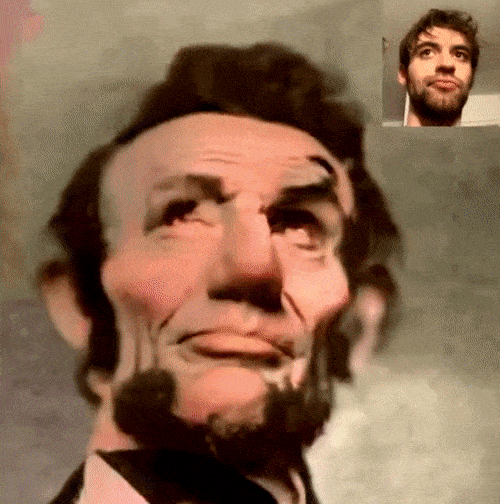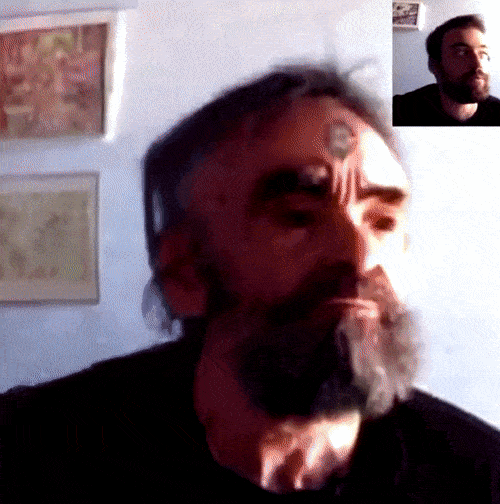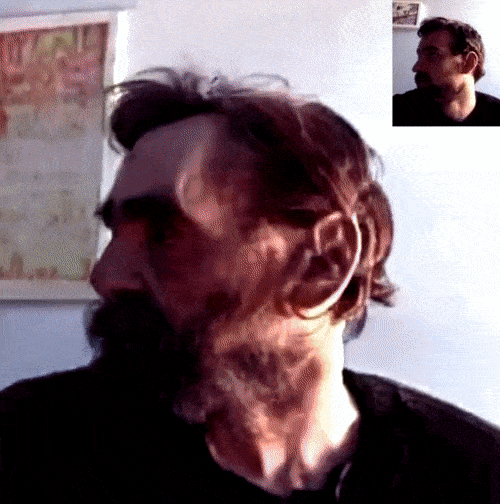
あるReddit利用者は、自分のウェブカメラ映像をさまざまな有名人へ変換した。どのStable Diffusion実装でも維持できるシードを固定するだけでなく、各変換のstochastic_encode()パラメーターも同じにしている。コード変更で実現したが、利用者向けの切り替えスイッチにするのは簡単だろう。ただし時間的な問題がすべて解消されるわけではない。 出典:https://old.reddit.com/r/StableDiffusion/comments/wyeoqq/turning_img2img_into_vid2vid/
クラウドでのテキスト反転
時間的に一貫した人物や物体を生成するより良い方法は、それらをテキスト反転ファイルに組み込むことだ。注釈付き画像五枚だけで数時間で訓練できる5KBのファイルで、特殊な*プロンプトで呼び出せる。例えば、物語に登場させる新しい人物の外見を一貫させられる。

適切なタグを付けた画像をテキスト反転で個別の実体にし、特別なトークン語で曖昧さなく、正しい文脈とスタイルで呼び出せる。 出典:https://huggingface.co/docs/diffusers/training/text_inversion
テキスト反転は、Stable Diffusionが使う巨大で学習済みのモデルに付加するファイルだ。生成・プロンプト処理に組み込まれ、モデルが作る場面に参加し、物体、スタイル、環境、相互作用に関するモデルの膨大な知識を利用できる。
訓練時間は長くないが、大量のVRAMが必要だ。現在のさまざまな解説では12GB、20GB、さらには40GBとされている。
一般利用者の多くはこれほどのGPU容量を持たないため、処理を担うクラウドサービスがすでに登場している。Hugging Face版もその一つだ。Stable Diffusion用テキスト反転を作成できるGoogle Colabの実装もあるが、VRAMと時間の要件はColab無料枠の利用者には難しい場合がある。
将来の十分に出資された完全なインストール型Stable Diffusionアプリでは、重い処理を企業のクラウドサーバーへ移すのが明白な収益化戦略になる。低価格または無料のアプリにこうした有料機能を組み込むという前提だ。今後6~9か月でこの技術から生まれる多くのアプリに、その可能性がありそうだ。
提供された画像とテキストに注釈を付けて整形するかなり複雑な処理も、統合環境で自動化できる。Stable Diffusionの広大な世界を探索し相互作用する独自の要素を作ることには、一般の愛好家にも若い利用者にも、強い中毒性がありうる。
柔軟なプロンプトの重み付け
長いテキストプロンプトの一部分を強調できる実装は現在多いが、操作方法には大きな違いがあり、しばしば不便で直感的ではない。
例えば非常に人気の高いAUTOMATIC1111によるStable Diffusion版では、単語を一重または多重の丸括弧で囲んで強調を弱め、角括弧で強調を強められる。

このStable Diffusionの重み付け実装では、角括弧や丸括弧で朝食を変えられるが、どちらもコレステロールの悪夢だ。
他のStable Diffusion版は感嘆符で強調し、最も柔軟なものはGUIでプロンプト内の各単語に重みを付けられる。
システムは負のプロンプト重みも扱うべきだ。ホラーファンのためだけではない。Stable Diffusionの潜在空間には、限られた言語の使い方で呼び出せるものより、不気味さが少なく、より啓発的な謎があるかもしれないからだ。
アウトペインティング
Stable Diffusionが大きな反響とともにオープンソース化された直後、OpenAIは発表したアウトペインティングでDALL-E 2への注目を取り戻そうとしたが、ほとんど成功しなかった。この機能は意味的論理と視覚的一貫性を保ち、画像を境界の外へ拡張する。
当然ながら、その後Stable Diffusionでもさまざまな形で実装され、Kritaにも搭載された。包括的なPhotoshop風のStable Diffusion版にも当然入れるべきだ。
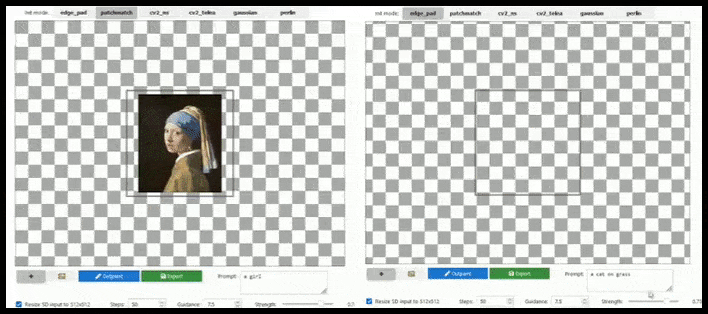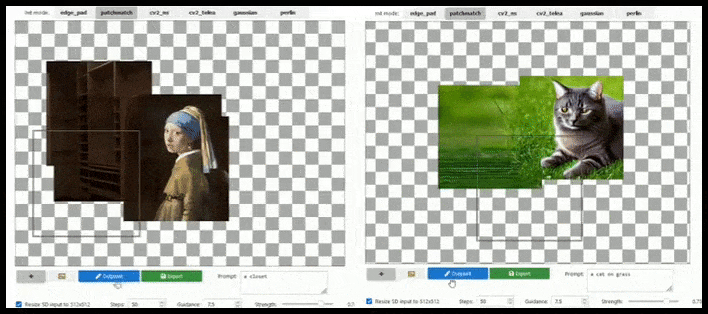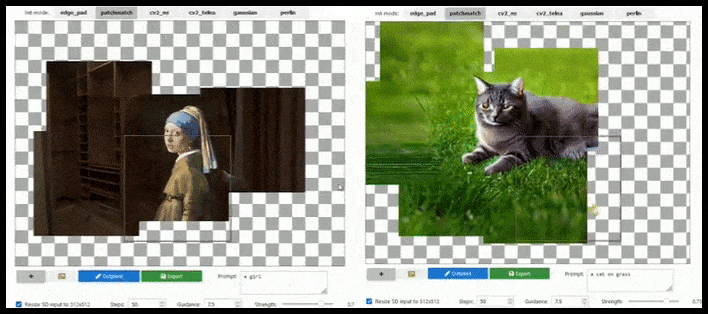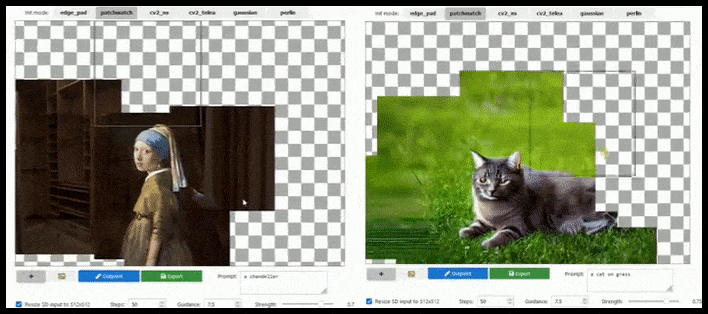
タイルベースの拡張により、プロンプト、既存画像、意味的論理が許す限り、標準の512×512出力をほぼ無限に拡張できる。 出典:https://github.com/lkwq007/stablediffusion-infinity
Stable Diffusionは512×512ピクセル画像で学習しており、他のさまざまな理由もあって、プロンプトが頭部の強調を明示していても、人物の頭や重要な身体部位を切り落としがちだ。

Stable Diffusionで頭が切れる典型例。ただしアウトペインティングでGeorgeを画像に戻せるかもしれない。
上の動画のようなアウトペインティング実装は、Unixライブラリだけを使っているがWindowsでも再現可能なはずだ。また、この問題をワンクリックまたは一つのプロンプトで修復するツールを備えるべきだ。
現在は、頭の切れた画像のキャンバスを上方へ広げ、頭の領域を大まかに塗ってimg2imgで失敗した出力を完成させる利用者がいる。
文脈を理解する効果的なマスキング
マスキングはStable Diffusionの派生版やバージョンによって、非常に当たり外れが大きい。まとまりのあるマスクを描けても、指定領域が画像全体の文脈を考慮しない内容で補完されることが多い。
一度、顔画像の角膜をマスクし、「青い目」というプロンプトで補完したところ、まるで切り抜いた二つの人間の目を通して、遠くにある異様なオオカミの画像を見ているようになった。Frank Sinatraでなかったのは幸いだ。
画像を最初に作ったノイズを特定する意味的編集も可能だ。残りの部分を変えずに、出力の特定の構造要素を扱える。

画像を最初に作ったノイズを見つけ、目標領域に寄与した部分を操作すれば、従来のマスクを使わず、周囲を変えずに一つの要素を変更できる。 出典:https://old.reddit.com/r/StableDiffusion/comments/xboy90/a_better_way_of_doing_img2img_by_finding_the/
この方法はK-Diffusionサンプラーに基づく。
身体構造の誤りを除く意味的フィルター
前述のように、Stable Diffusionは手足を増減させがちだ。主な原因はデータの問題と、学習画像に付いた注釈の不足にある。

学校の集合写真で舌を出したいたずらっ子のように、Stable Diffusionの身体の異常はすぐ分かるとは限らない。余分な手や溶けた手足に気づく前に、最新のAI傑作をInstagramへ投稿してしまうかもしれない。
この種の誤りは修正が非常に難しい。完全なStable Diffusionアプリに、意味的分割で入力画像に重大な身体構造の欠陥がないか計算する認識システムがあれば便利だろう。上の例のような画像を、利用者へ見せる前に破棄し、新しく生成できる。

もちろん女神Kaliやドクター・オクトパスを描きたい場合も、手足が異常な画像の無傷な部分を救いたい場合もある。そのため、この機能は任意で切り替えられるべきだ。
テレメトリーを利用者が受け入れれば、こうした失敗を匿名で送信し、連合学習の共同作業に生かせるかもしれない。将来のモデルが身体構造の論理をよりよく理解する助けになる。
LAIONベースの自動顔改善
Stable Diffusionが今後対処できる三つの事柄を以前に検討した際も述べたように、最初の出力で描かれた顔を改善する試みを、どれかのGFPGAN版だけに任せるべきではない。
GFPGANの改善は極めて画一的で、人物の特徴をしばしば損なう。しかも画像の他部分より多くの処理時間や注意を与えられず、すでに不十分に描かれた顔だけを対象にする。
したがって専門的なStable Diffusionプログラムは、YOLOのような標準的で比較的軽量なライブラリで顔を認識し、利用できるGPU能力のすべてで再生成するべきだ。改善した顔を全体の文脈がある元画像へ合成するか、手作業で再合成するために別途保存できるようにする。現在はかなり手作業を要する。
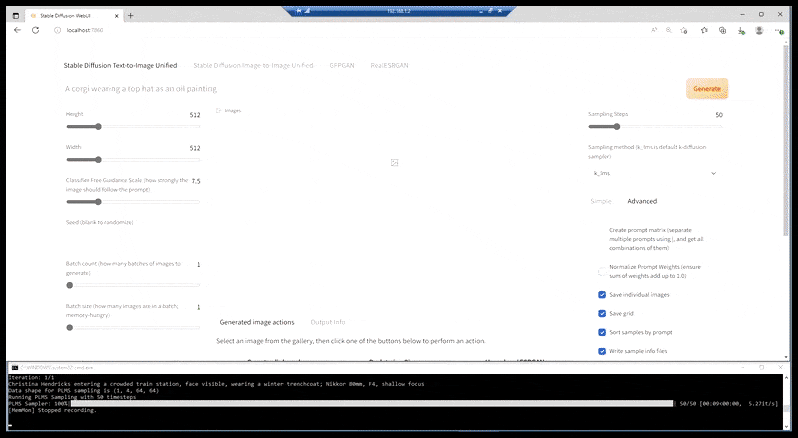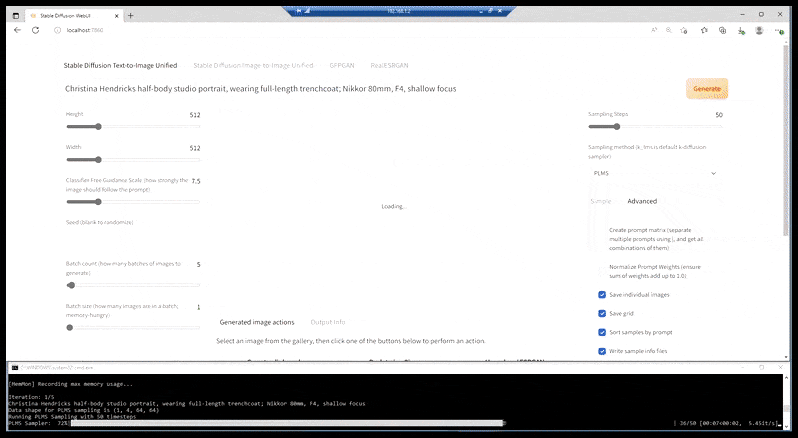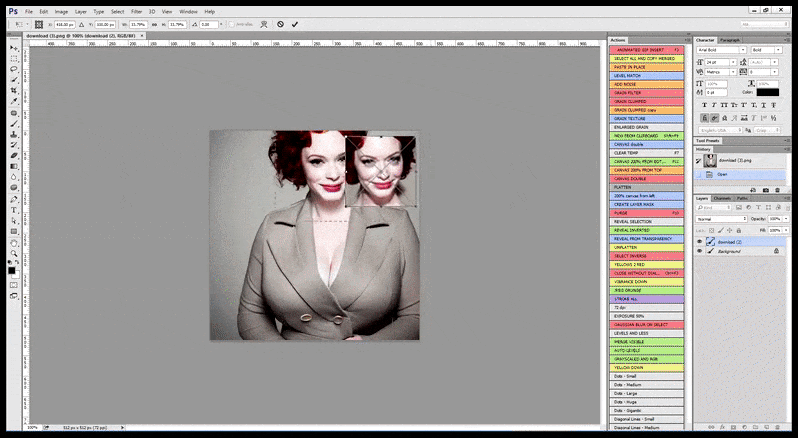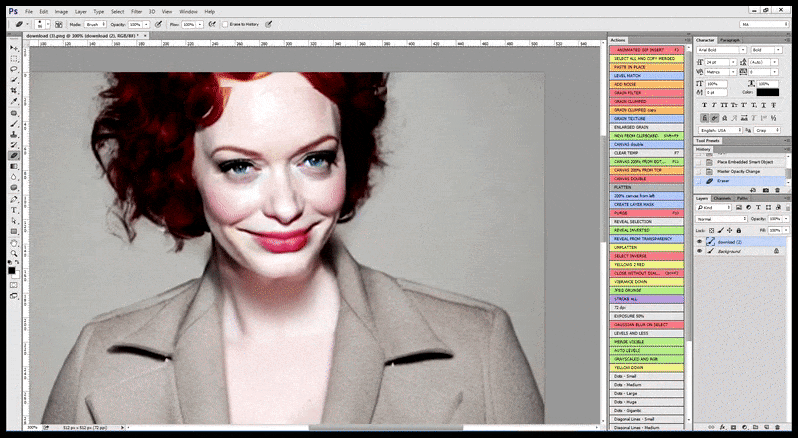
Stable Diffusionがある有名人の画像を十分に学習していれば、次の描画でGPU全体の能力を画像の顔だけの再生成に集中できる。通常は顕著な改善になり、GFPGANと異なり、生成済みピクセルの単なる調整ではなくLAION学習データの情報を利用する。
アプリ内のLAION検索
LAIONデータベースで概念、人物、テーマを検索するとStable Diffusionをよりよく使えると利用者が気づいてから、haveibeentrained.comなど複数のオンラインLAION探索ツールが登場した。

haveibeentrained.comの検索機能では、Stable Diffusionを支える画像を調べ、生成したい物、人物、アイデアが学習に含まれた可能性を探れる。有名人のまとまり方や現在のアイデアから続く次のアイデアなど、隣接する実体の発見にも役立つ。 出典:https://haveibeentrained.com/?search_text=bowl%20of%20fruit
こうしたウェブデータベースは画像に付いたタグを一部示すものの、学習中の汎化により、特定の画像のタグをプロンプトにするだけでその画像を呼び出せる可能性は低い。
また自然言語処理ではストップワードの削除や語幹・見出し語の抽出を行うため、表示される多くの句はStable Diffusionの学習前に分割または省略されている。
それでも、美的なグループがこれらの画面で結び付く様子は、Stable Diffusionの論理、あるいは個性について多くを教え、より良い画像制作の助けになる。
結論
完全なネイティブデスクトップ版Stable Diffusionで見たい機能は他にも多い。例えばCLIPベースの画像分析は、標準的な処理を逆にして、元画像や生成物にシステムが自然に結び付ける語句を利用者が得られるようにする。
また、本当のタイルベース拡大も歓迎したい。ESRGANはGFPGANとほぼ同じくらい大ざっぱな道具だからだ。幸いGOBIGのtxt2imghd実装を統合する計画で、多くの配布版において急速に実現しつつある。デスクトップ版にも明らかに適した選択だ。
Discordコミュニティの他の人気要望である、統合プロンプト辞書や適用できる画家・スタイル一覧には関心が薄い。ただしアプリ内のメモ帳やカスタム語句集は理にかなった追加機能だろう。
同様に、CogVideoなどが端緒を開いたStable Diffusionの人間中心のアニメーションは、まだ極めて初歩的だ。実際の人間の動きに関する時間的事前知識の基礎研究に左右される。
現在のStable Diffusion動画は徹底してサイケデリックだが、EbSynthや初期段階の他のテキストから動画への取り組みによる、ディープフェイクの人形操作には近い将来、より明るい可能性がある。Runwayの最新宣伝動画に合成・改変された人物がいない点にも留意したい。
もう一つ有用なのは、Photoshopとの透過的な画像受け渡しだ。Cinema4Dのテクスチャ編集機能などでは長年使われている。画像をアプリ間で容易に移し、それぞれが得意な変換に使える。
最後に、おそらく最も重要なのは、完全なデスクトップStable Diffusionプログラムは、システムを動かす基盤モデルの版であるチェックポイント間を容易に切り替えるだけでなく、以前の公式モデルで動いた独自のテキスト反転を更新できることだ。公式Discordの開発者が可能性を指摘したように、後のモデルでは機能しなくなるかもしれない。
皮肉なことに、これほど強力で統合されたStable Diffusion用ツール群を作るのに最適なAdobeは、コンテンツ真正性イニシアチブと極めて強く結び付いているため、こうした製品は広報上の後退と見えるかもしれない。例外は、OpenAIがDALL-E 2に行ったほど徹底して生成能力を抑え、自社の豊富なストック写真資産の自然な進化として位置付ける場合だ。
初出:2022年9月15日。


