Andersonの視点
感情をタイポグラフィーで表現する – AIを用いた新しいアプローチ

 Unite.AI を Google の優先ソースに追加
要点音声変調タイポグラフィは、ピッチ・持続時間・音量をベースラインシフト・カーニング・フォントウェイトにマッピングする。
もっと見る
- 音声変調タイポグラフィは、ピッチ・持続時間・音量をベースラインシフト・カーニング・フォントウェイトにマッピングする。
- 動的キャプションは静的キャプションよりも評価が低かった。なぜなら、動く文字を読むことは視聴者に認知負荷を加えるからである。
- 韻律を考慮したテキストは、感情コンピューティングのデータセットや、顧客満足度や抑うつ推定といったタスクを豊かにする可能性がある。
テキストコミュニケーション(メール、メッセージング、キャプションシステムなど)の最新のトレンドと革新は、書き言葉と話し言葉の間の感情的な隔たりを、粗くて近似的な方法で乗り越えなければなりません。
例えば、最近の数年間で、大文字と小文字を交互に使用するスタイルが、ソーシャルメディアの炎上での挑発的なメームとして流行しています。一方で、嫌われ者のCaps Lock(および一部のコメントプラットフォームで許可される太字などの目立つタイポグラフィ効果)の使用は、モデレーターからの介入を引き起こしています。これらは、書き言葉の意図を明確にするための単調で広範な方法です。
同時に、顔文字と絵文字は文字と視覚を組み合わせた感情の伝達手段として普及し、近年は自然言語処理(NLP)の研究で活発に取り上げられてきました。ユーザーがコメント欄に投稿するアニメーションGIFの意味にも関心が集まっています。
書き言葉は、感情を代理するか、話し言葉のトーン情報が欠如する状況で感情を呼び起こすために、革新的な方法を発展させてきました。
通常、書き言葉から感情を推測する必要があります。例えば、感嘆「Oh, Oh, Oh!」を考えてみましょう。これは、レディ・マクベスの狂気の夜の独白の最後の部分であり、イントネーションが意味に与える影響の範囲を示すことができます。
ほとんどの演出では、この痛みに満ちた嘆きは2〜6秒間続きますが、トレバー・ナンの1976年のロイヤル・シェイクスピア・カンパニーの『マクベス』公演では、ジュディ・デンチがこの行を24.45秒間にわたって演じました。これはいまだ破られていない可能性のある記録であり、この役の象徴的な解釈となっています。
(YouTubeの自動キャプションシステムでは、このクリップのデンチの叫びを [MUSIC]と表記しています)
韻律をタイポグラフィーに翻訳する
ブラジルからの最近の論文は、韻律などのパラ言語的要素を字幕に直接組み込める、音声に応じて文字を変形させるタイポグラフィの仕組みを提案しています。[叫んでいる]といった説明や、従来の字幕で使われる平面的な手法では十分に表現できない感情の次元を追加するものです。
「私たちは、音響特性からテキストの視覚的な外見を変化させる、スピーチモジュレートタイポグラフィーの新しいモデルを提案します。これにより、特定の発話の書き起こしが、単に言及された単語を表すだけでなく、どのように言及されたかも表すことができます。」
「これにより、韻律の特徴である大きさ、ピッチ、継続時間を視覚的に代理することができるタイポグラフィーパラメータを発見することを目指しています。」

韻律をタイポグラフィーに翻訳するワークフロー。最も汎用性が高く幅広く導入できるシステムを生み出すことを目指して、著者らはベースラインシフト、カーニング、ボールドネスに限定しています。後者は、オープンタイプフォントの汎用性によって提供されます。ソース: https://arxiv.org/pdf/2202.10631.pdf
論文は、「隠された叫び、ささやき、ヤップ:テキストを単なる単語以上のものにすることができるか」というタイトルで、ブラジルのUniversidade Estadual de Campinasの研究者、Calua de Lacerda PatacaとPaula Dornhofer Paro Costaによって書かれています。
太字の言葉
このプロジェクトのより広範な目的は、キャプションに韻律や他のパラ言語的特性を伝えるシステムを開発することですが、著者らはこのようなシステムが、聴覚障害者のみならず、健聴者にも広く受け入れられる可能性があると考えています。
この分野には、1983年のプロジェクトのような以前の取り組みがあり、字幕システムに「特殊効果、色、大文字を用いて、耳の聞こえない子どもたちが得られない豊かな声の調子の情報を表現する」ことが提案されていました。
一方、ブラジルのプロジェクトは、自動トランスクリプションと新しい感情認識の進歩を活用でき、音声サウンドトラックのコンポーネントをインポートして特性付けることができるワークフローを実現しています。
韻律特性を抽出して処理した後、それらはスピーチの単語のタイムスタンプにマッピングされ、ルールベースのキャプションタイポグラフィー変調を適用するためのトークンが生成されます。
これにより、ある音節がどの程度引き伸ばされ、ささやかれ、強調されているかなど、通常の書き起こしでは失われる文脈情報を視覚的に表現できます。

プロジェクトの試験段階の例。カーニング(単語内の文字間隔)を広げることで、引き伸ばされた発音を表現している点に注目してください。
著者らは、感情や情動の認識に関する研究に直接貢献することを目的とせず、むしろスピーチの特性を分類して、シンプルで限定された新しい視覚的規約のセットで表現することを目指しています。
少なくとも、このシステムが提供する追加の強調は、視聴者が音を聞くことができない状況(障害や再生環境のため)で、行動の対象が明確でない文を明確にします。
私自身の2017年の例を借りてみましょう。機械学習システムも文中の動作とその対象の把握に苦労することがあるという例です。強調によって単純な文の意味さえ大きく変わることが分かります。
私はそれを盗みませんでした。(誰か別の人がそれを盗みました)
私はそれを盗んではいません。(盗んだという非難を否定します)
私はそれを盗んだのではありません。(それは私の所有物なので、窃盗には当たりません)
私はそれを盗んだのではありません。(しかし、別のものは盗みました)
ブラジル人の著者が提案する韻律からタイポグラフィーへのメカニストワークフローは、感情計算研究のデータセット開発における補助ツールとしても役立つ可能性があります。なぜなら、事前に推論されたパラリンガル次元を含む、純粋なテキストベースのデータを処理できるからです。
さらに、研究者らは、韻律を認識したテキストの追加の言語情報が、顧客満足度評価やテキストコンテンツからのうつ病の推論など、NLPベースのタスクで役立つ可能性があると指摘しています。
エラスティックタイポグラフィー
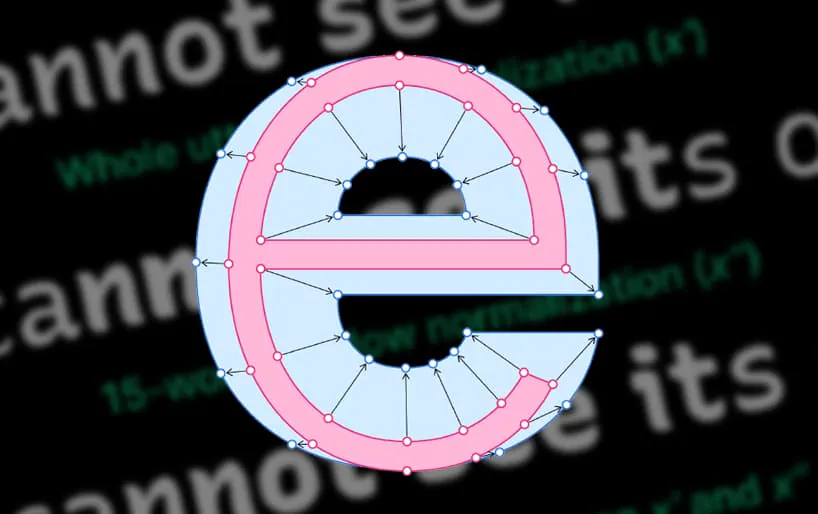
研究者の開発した枠組みでは、文が載る基準線に対して文字を上下させるベースラインシフト、単語内の文字間隔を狭めたり広げたりするカーニング、フォントの太さ(字重)を変化させられます。
これらの3つのスタイリングは、プロジェクトが制限したスピーチの抽出特性にマップされます。具体的には、ピッチ、継続時間、大きさです。

文のスタイリングの進行。#1では、抽出プロセスで定義されたシラブルの境界が見られます。#2では、振幅と字の太さ、文字間隔と持続時間、音高とベースラインシフトの3つの変調がそれぞれ適用されています。#3では、117人の参加者に提示された最終出力の組み合わせたタイポグラフィー変調が見られます。
単一のフォントファミリーで、太字やイタリックなどのバリエーションを別々のフォントファイルで提供する必要がある場合、研究者らは、Googleの実装であるオープンタイプフォント「Inter」を使用しました。このフォントは、単一のフォントファイルに細かい重さの範囲を統合しています。

論文からの図。Interフォントのオープンタイプグリフが、最小ベーススプラインのスケルトンに沿って、幅広いボールドな強調を表現する範囲を示しています。
テスト
カーニングとベースラインシフトの表現は、ブラウザプラグインに組み込まれて、117人の健聴者を対象としたテストが実施されました。
試験用のデータセットは、このプロジェクトのために特別に作成されました。俳優を雇い、研究対象の3つの特徴に対応させて、毎回異なる強調を付けながら選んだ詩を何度も朗読してもらいました。詩なら、詩人の意図を超えるような強調であっても、不自然に聞こえずに幅広く表現できるためです。
参加者は2つのグループに分けられました。最初のグループは、15ラウンドにわたる俳優の詩節の朗読に同期して、アニメーション化されたモデュレートテキストが提示されました。
2番目のグループは、同じタスクセットを受け取りましたが、テキストは静的なイメージで提示され、オーディオクリップの再生中は変化しません。
正解率の平均は、静止画像のグループでは偶然の水準とは異なる67%、アニメーションテキストグループで63%でした。試験後に集めた参加者のコメントは、動的な表現を解釈する認知的負荷が、動く文字の試験での低い得点につながった可能性があるという研究者の仮説を裏付けました。しかし、キャプションやメッセージシステムでは、通常、デフォルトで完了したテキストが提供されます。
参加者のコメントはまた、継続時間を示すためにカーニングを使用することの限界があることを示唆しています。1人のコメント者は、文字があまりにも離れていると、単語を識別するのが難しくなることを指摘しています。
研究者らはさらに次のように述べています:
「一部の参加者は、モデルがより繊細で複雑なスピーチの表現を体現できるべきだと感じていました。より多様で表現力のある視覚的な語彙でそれを行うことは、簡単なタスクではありません。しかし、スピーチモジュレートタイポグラフィーのさまざまな応用が、発展するにつれてどのように分岐するかを想像することは、励みになります。」
最初に公開されたのは2022年2月24日です。