
監視
合成顔の「劣化」が顔認識技術の向上に貢献する

 Unite.AI を Google の優先ソースに追加
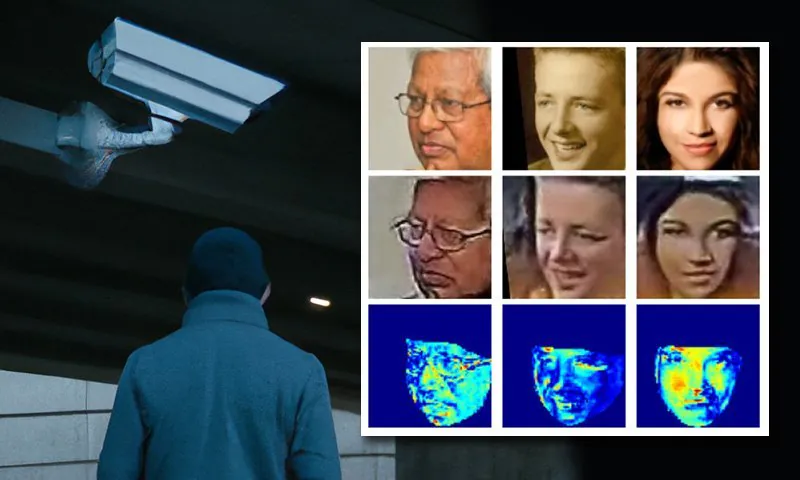
要点実際の監視映像のようなスタイルで作られた合成顔は、認識精度を損なうドメインギャップを埋めることができる。
もっと見る
- 実際の監視映像のようなスタイルで作られた合成顔は、認識精度を損なうドメインギャップを埋めることができる。
- レガシーなCCTVシステムは技術的負債を抱えており、現代の顔認識の学習にとって貧弱なデータ源となっている。
- 敵対的マニピュレーションは、対象システムのスタイルを取り込むことで、認識を攻撃するのではなく認識に役立てることができる。
ミシガン州立大学の研究者は、合成顔がディープフェイクの世界を少し離れ、画像認識システムの精度向上という形で社会に役立つ方法を考案した。
新しい制御可能顔合成モジュール(CFSM)は、実際の監視映像のスタイルで顔を再生成できる。著名人を集めた人気のオープンソースデータセットにある、全体的に高品質な画像に依存する方法とは異なる。そうしたデータセットは、本物のCCTVシステムの顔のぼけ、低解像度、センサーノイズなど、認識精度に影響する欠点を十分に反映していない。

制御可能顔合成モジュール(CFSM)の概念構成。 出典: http://cvlab.cse.msu.edu/pdfs/Liu_Kim_Jain_Liu_ECCV2022.pdf
CFSMは、ディープフェイクシステムが目指す頭の姿勢、表情などの一般的な特性を忠実に再現するためのものではない。スタイル転送を使い、対象の認識システムのスタイルに合ったさまざまな代替ビューを生成するためのものだ。
システムは対象システムのスタイル領域を模倣し、その解像度やさまざまな癖に合わせて出力を調整する。費用のため更新されそうにない旧式システムも用途に含まれる。かつては先進的だったかもしれない出力も、現在では品質が低く、新世代の顔認識技術にはほとんど貢献できないからだ。
研究者が検証したところ、こうしたノイズの多い低品質データを扱う画像認識システムで、従来の最高水準に対する顕著な改善が得られた。

顔認識モデルを対象システムの制約に適応させる学習。 出典: http://cvlab.cse.msu.edu/pdfs/Liu_Kim_Jain_Liu_ECCV2022_supp.pdf
また、有用な副産物として、対象データセットの特性を把握して相互比較できるようになった。これにより今後、異なるCCTVシステム向けの比較、ベンチマーク、専用データセット生成が容易になる。
さらに、この方法は既存のデータセットにも適用でき、事実上のドメイン適応を行って顔認識システムに適したものにできる。
新論文の題名は制約のない顔認識に向けた制御可能かつ誘導された顔合成である。米国国家情報長官室(ODNI、IARPA)の一部支援を受け、MSUのコンピュータ科学・工学科の研究者4人が執筆した。
注目すべき内容
低品質顔認識(LQFR)は近年重要な研究分野となった。公共・自治体当局は同じ問題に定期的に資源を再投入したくないため、頑丈で長持ちする監視システムを構築した。その結果、多くの旧式監視網が機械学習データ源としての適応性に関して技術的負債を抱えている。

旧式と近年の各種監視システムにおける顔の解像度の違い。 出典: https://arxiv.org/pdf/1805.11519.pdf
幸い、拡散モデルやその他のノイズベースモデルは、この問題の解決に特に適している。近年の人気で有効な画像合成システムの多くは、処理工程で低解像度画像をアップスケーリングする。画像や動画をビットマップデータではなくニューラルデータとして保存するニューラル圧縮技術にも、これは不可欠だ。
顔認識の課題の一つは、最も小さく情報の乏しい低解像度画像から抽出できる最小限の特徴で、可能な限り高い精度を得ることだ。この制約は低解像度で顔を識別・生成できる利点だけから生じるわけではない。ローカルGPUの利用可能なVRAM内で学習するモデルの、形成中の潜在空間を通せる画像サイズにも技術的限界がある。
この意味で「特徴」という言葉は紛らわしい。公園のベンチのデータセットからも特徴は得られるからだ。コンピュータビジョンでは、画像から得られる識別に役立つ特性を指す。教会の輪郭、山、顔データセットの顔の各部分の配置など、どんな画像にも当てはまる。
コンピュータビジョンのアルゴリズムは画像や動画の解像度向上に長けており、低解像度あるいは劣化した旧式監視映像を「改善」する方法が提案されている。犯罪捜査で特定人物が現場にいたことを示すなど、改善結果を法的目的に利用できる可能性もある。
誤認の可能性はときに大きく報道される問題だ。それを別にしても、低レベル特徴に着目する顔認識システムはそのような高解像度や鮮明さを必要としないはずであり、理論上、個人を確実に識別するために低解像度映像を超解像化・変換する必要はないはずだ。こうした変換は実際には費用も高く、その妥当性や合法性への追加の繰り返される疑問を生む。
より多くの低品質な著名人画像が必要
高解像度での人物の同一性と、変更が難しく、しばしば代替不能な既存監視設備の劣化画像との関係をよりよく理解し、旧式システムの出力をそのまま使って特徴を取り出せる方が有益だ。つまり、人間の顔の特徴から機械学習の特徴を得ることである。
問題は標準にある。ウェブから収集したMS-Celeb-1MやWebFace260Mなどは、現在の最高水準に対する小さな進歩や大きな進歩を測る一貫した基準になるため、研究界に広く採用されている。

マイクロソフトの人気データセットMS-Celeb1mの例。 出典: https://www.microsoft.com/en-us/research/project/ms-celeb-1m-challenge-recognizing-one-million-celebrities-real-world/
しかし著者らは、これらのデータセットで学習した顔認識(FR)アルゴリズムは、多くの旧式監視システムの出力が持つ視覚的な「領域」に適さないと主張する。
論文は述べる。*
「最先端(SoTA)のFRモデルは、ドメインシフトのため、制約のない実際の監視画像ではうまく機能しない。ウェブで集めた著名人の顔を使う大規模な半制約学習データセットには、センサー固有のノイズ、低解像度、動きによるぼけ、乱流の影響など、実環境で生じる変動が欠けている。
「例えば、最高水準モデルの一つが報告した、非制約のIJB-Sデータセットでの1対1の本人確認精度は、半制約のLFWより約30%低い。
「対策として大規模な非制約顔データセットを集めることが考えられる。しかし、数万人を含む学習データセットの構築は手作業のラベル付け費用が高く、極めて困難だ。」
論文は、旧式または低コスト監視システムの多様な出力に合わせようとした従来手法が「ブラインド」なデータ拡張に取り組んだと振り返る。対してCFSMは学習中に対象システムの実出力から直接フィードバックを受け、スタイル転送でその領域を模倣する。

コンピュータビジョン界を支配する少数のデータセットでよく見かける女優ナタリー・ポートマンも、このCFSMの例の人物に含まれる。実際の対象モデルの領域からのフィードバックを基に、スタイルを合わせたドメイン適応を行う。
著者らのアーキテクチャは高速勾配符号法(FGSM)を使い、対象システムの実出力からスタイルと特性を識別して「取り込む」。画像生成部分は学習につれて改善し、対象システムにより忠実になる。対象システムの低次元スタイル空間からのフィードバックは低レベルの特性に関するもので、最も一般的な派生視覚記述子に対応する。
著者らは説明する。
「FRモデルからのフィードバックにより、合成画像はFR性能にとってさらに有益となり、それを使って学習したFRモデルの汎化能力が大幅に向上する。」
実験
研究者はMSU自身の先行研究を実験のひな型とし、同じ実験手順で、ウェブから集めた著名人写真のみを含むMS-Celeb-1mをラベル付き学習データセットに用いた。公平を期すため、85,700クラスの390万画像からなるMS1M-V2も加えた。
対象データは香港中文大学のWiderFaceデータセットだった。難しい状況での顔検出を目的とする非常に多様な画像集で、そのうち70,000枚を使った。
評価では4つの顔認識ベンチマーク、IJB-B、IJB-C、IJB-S、TinyFaceを使用した。
CFSMはMS-Celeb-1mの学習データの約10%、約40万枚の画像で学習した。バッチサイズ32、125,000反復、Adam最適化器、非常に低い学習率1e-4を使用した。
対象の顔認識モデルはResNet-50の改変をバックボーンとして使い、学習時にArcFace損失関数を有効にした。また、要素除去と比較の実験としてCFSMでモデルを学習した(下の結果表では「ArcFace」と表記)。

CFSMの主な実験結果。数値は高い方がよい。
著者らは主な結果について述べる。
「ArcFaceモデルは顔の識別と本人確認の両タスクですべてのベースラインを上回り、新たな最高水準の性能を達成した。」
旧式または低仕様の監視システムの多様な特性から領域を抽出する能力により、各システムの分布の類似性も比較・評価できる。また、後続研究に使える視覚的スタイルとして各システムを表現できる。

異なるデータセットの例は明確なスタイルの差を示す。
著者らは、これまで研究・コンピュータビジョン界が解決すべき問題とのみ見なしていた技術も、このシステムなら有効利用できると指摘する。
「CFSMは、敵対的操作が攻撃にとどまらず、視覚タスクの認識精度を高めるためにも使えることを示す。また、学習したスタイル基底に基づくデータセット類似性指標を定義した。これらの基底は、ラベルや予測器に依存せずスタイルの差を捉える。
「本研究は、非制約環境のFRに向けた制御可能かつ誘導された顔合成モデルの力を示し、データセット間の違いへの理解を提供したと考える。」
* 執筆者が論文中の参考文献への参照をハイパーリンクに変換した。
初出:2022年8月1日。


