
Andersonの視点
一貫したAIビデオコンテンツ編集とテキストガイド入力

 Unite.AI を Google の優先ソースに追加
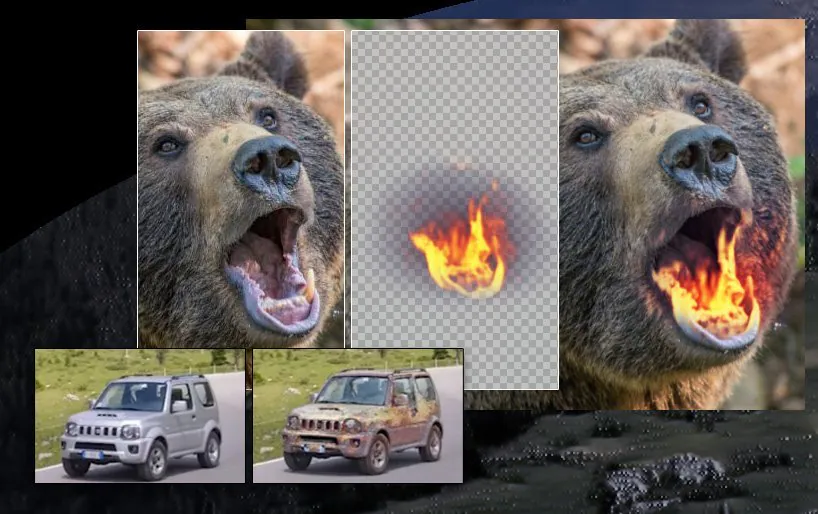
要点Text2Liveは、フレームごとの処理を必要とせずに、テキストプロンプトから一貫したビデオ編集を可能にします。
もっと見る
- Text2Liveは、フレームごとの処理を必要とせずに、テキストプロンプトから一貫したビデオ編集を可能にします。
- このシステムはニューラルレイヤードアトラスを使用して、ビデオ全体のタイムラインにわたって編集を一度に適用します。
- Text2Liveはマスキングとコンポジットを自動化し、ロトスコーピングやグリーンスクリーンを不要にします。
プロフェッショナルVFXコミュニティは、新しいイメージとビデオ合成のイノベーションに魅了され、ときには少し脅威も感じていますが、ほとんどのAIベースのビデオ編集プロジェクトでは時間的連続性が欠けているため、これらの努力は「サイケデリック」な領域に留まり、輝きと急速に変化するテクスチャや構造、不一致なエフェクトや、フォトケミカル時代の視覚効果を思い起こすような、原始的な技術の扱い方が特徴です。
ビデオ内の特定のものを変更したい場合、ディープフェイク(すでにある人物の映像に新しいアイデンティティを課すこと)以外の場合、ほとんどの現在の解決策は、プロダクション品質の視覚効果に必要な精度という点で、かなり厳しい制限を受けています。
一つの例外は、ワイツマン科学研究所の学者たちによる継続的な研究です。2021年、3人の研究者は、アドビと共同で、新しい方法を発表しました。ビデオを分解し、内部マッピングを合成出力に重ね合わせるという方法で、レイヤードニューラルアトラスを作成し、アルファチャンネルと時間的一貫性のある出力を生成しました。
(ADBE )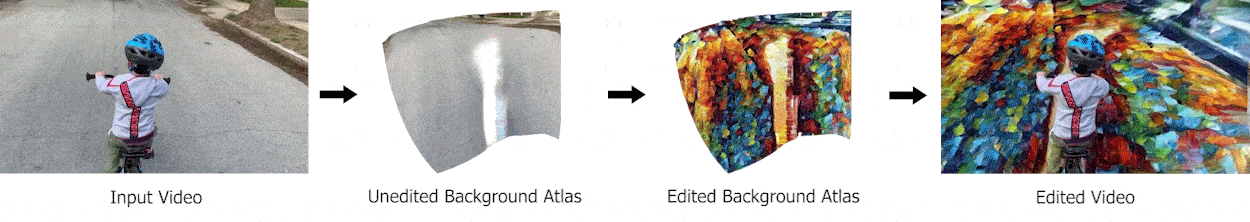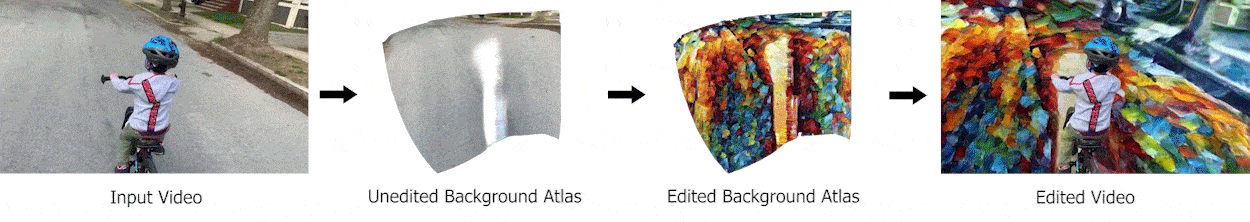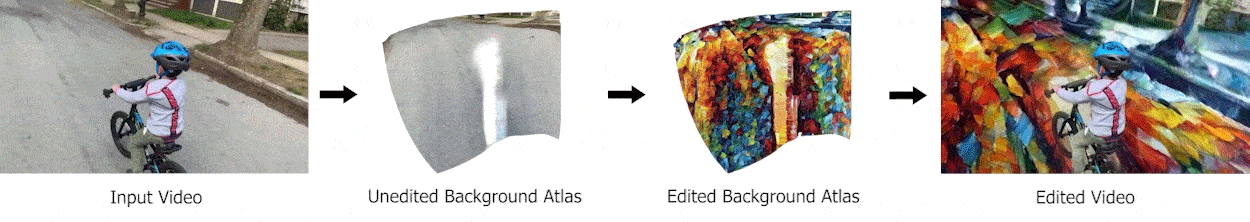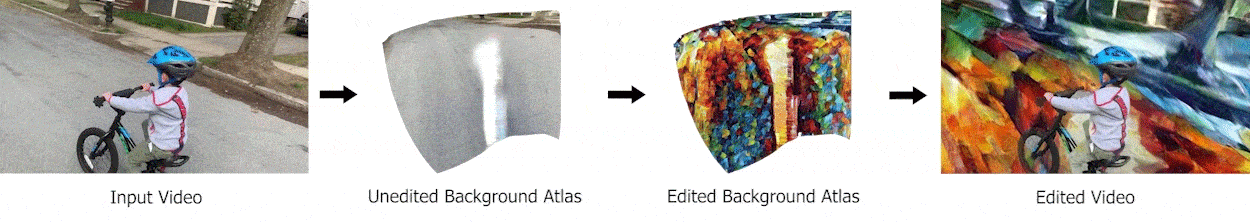
2021年の論文から:ソースクリップの道路の完全なトラバーサルの推定は、従来、広範囲にわたるロトスコープとマッチムーブが必要だった手法で、ニューラルネットワークによって編集されます。背景と前景の要素は別々のネットワークで処理されるため、マスクは本当に「自動」です。ソース:https://layered-neural-atlases.github.io/
このアプローチは、オプティカルフローに似ていますが、伝統的なCGワークフローには直接的な対応するものはありません。なぜなら、時間的テクスチャマップを構成するからです。これは、伝統的なソフトウェア方法で生成され、編集できます。
上のイラストの2番目の画像では、道路の表面の背景が、ビデオの全期間にわたって表現されています。基礎画像(上のイラストの左から3番目の画像)を変更すると、背景に一貫した変更が生じます。
上のアトラスの「展開された」画像は、個々の解釈フレームのみを表しています。ターゲットビデオの任意のフレームに対する一貫した変更は、必要なオクルージョンや影、反射などのシーンエフェクトを保持したまま、元のフレームにマップバックされます。
コアアーキテクチャでは、マルチレイヤーパーセプトロン(MLP)を使用して、アトラス、アルファチャンネル、マッピングを表現し、すべてを2D空間で最適化します。NeRFスタイルの3D幾何学の事前知識、深度マップ、CGIスタイルの装飾が不要になります。
個々のオブジェクトの参照アトラスも信頼性高く変更できます。
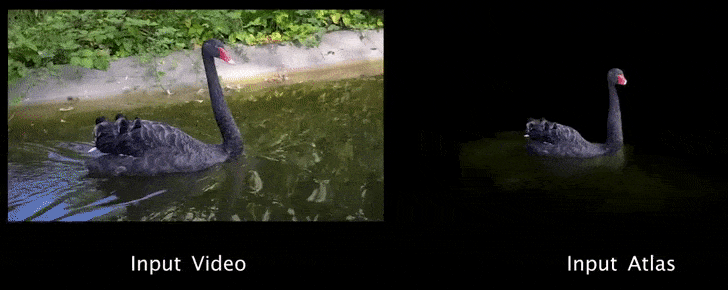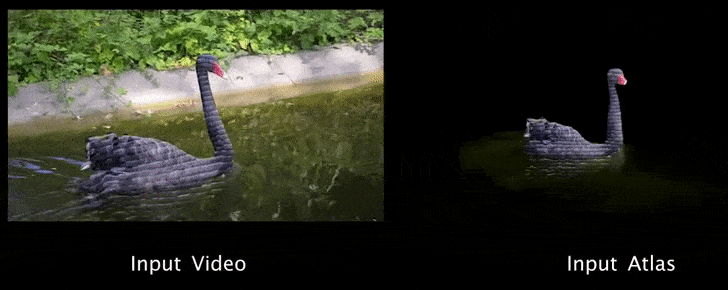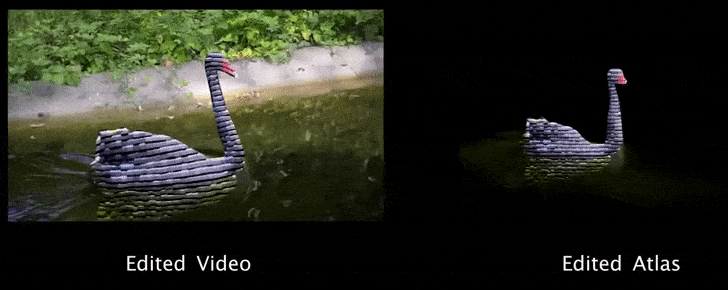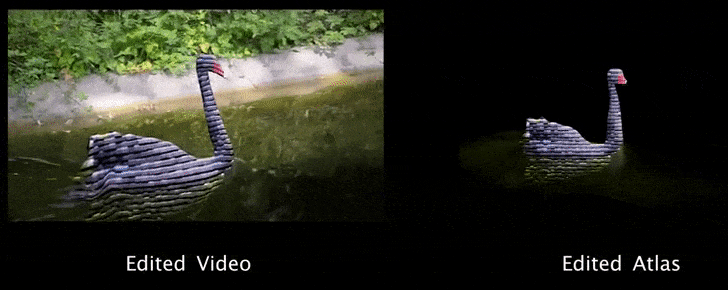
2021フレームワークでの動くオブジェクトへの一貫した変更。 ソース:https://www.youtube.com/watch?v=aQhakPFC4oQ
基本的に、2021年のシステムは、幾何学的整列、 マッチムーブ、 マッピング、 再テクスチャ化、 ロトスコープを1つの離散的なニューラルプロセスにまとめました。
Text2Live
2021年の論文の3人のオリジナル研究者と、NVIDIA (NVDA ) Researchは、DALL-E 2フレームワークのリリースとともに、テキストガイドCLIP技術の力とレイヤードアトラスを組み合わせた新しいイノベーションの貢献者です。
新しいアーキテクチャ、Text2Liveは、エンドユーザーがテキストプロンプトに基づいて実際のビデオコンテンツに対してローカライズされた編集を作成できるようにします。
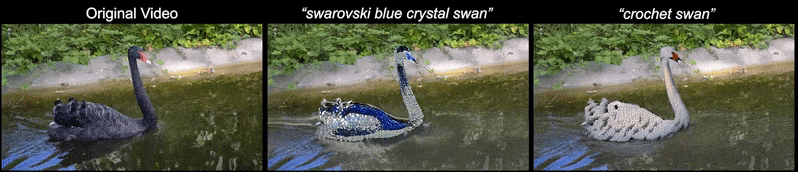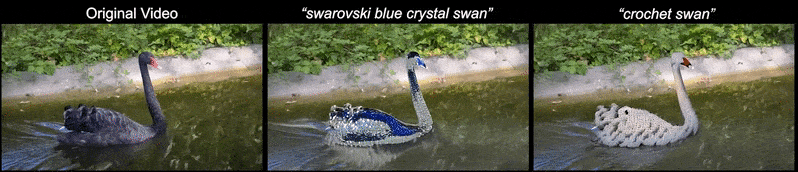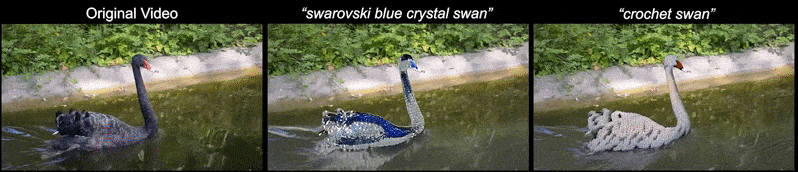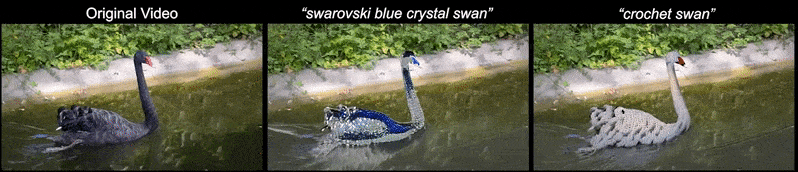
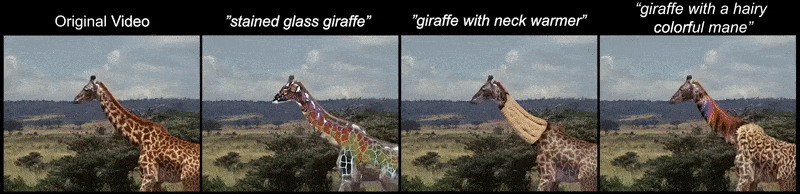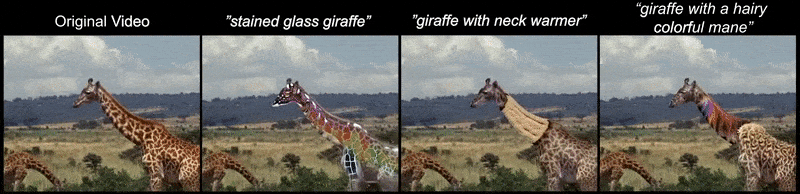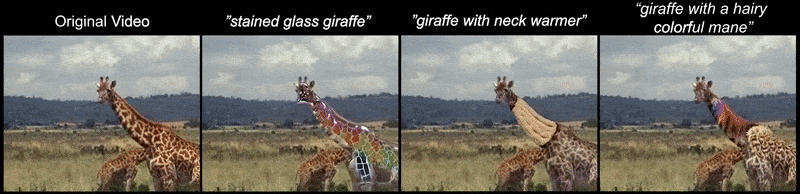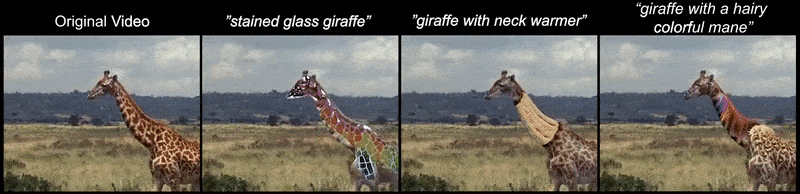
前景編集の2つの例。より高い解像度と鮮明さを求める場合は、 https://text2live.github.io/sm/pages/video_results_atlases.html
Text2Liveは、事前トレーニングされたジェネレータを使用せずに、内部データベースを使用して、ビデオクリップに特有のものを使用して、意味的かつ高くローカライズされた編集を提供します。

Text2Liveでの背景と前景(オブジェクト)の変換。 ソース:https://text2live.github.io/sm/pages/video_results_atlases.html
このテクニックでは、ユーザーが提供するマスク(通常のロトスコープまたはグリーンスクリーン ワークフロー)が不要ですが、代わりに、テルアビブ大学コンピューター科学部とFacebook AI Research(FAIR)の2021年の研究に基づくブートストラップ手法によって関連性マップを推定します。

トランスフォーマーベースのジェネリックアテンションモデルによって生成された出力マップ。
新しい論文は、Text2LIVE:テキスト駆動型レイヤードイメージとビデオ編集と題されています。オリジナルの2021年のチームに、ワイツマンのオメル・バール・タルと、NVIDIA Researchのヨニ・カステンが参加しています。
アーキテクチャ
Text2Liveは、単一の入力画像とターゲットテキストプロンプトでトレーニングされたジェネレータで構成されています。4億組のテキストと画像のペアで事前学習した対照的言語・画像事前学習(CLIP)モデルは、ユーザー入力の変換を解釈するための関連する視覚資料を提供します。

ジェネレータは、入力画像(フレーム)を受け取り、ターゲットRGBAレイヤーを出力します。このレイヤーには、色と不透明度の情報が含まれます。このレイヤーは、追加のオーグメンテーションとともに、元の映像に合成されます。

生成されたRGBAレイヤーのアルファチャンネルには、従来のAfter Effectsのようなピクセルベースのソフトウェアを使用する必要のない内部コンポジット関数が含まれます。
Text2Liveは、対象のビデオや画像に関連する内部画像で学習することで、入力画像を敵対的生成ネットワーク(GAN)の潜在空間へ逆変換する必要をなくします。この逆変換は現在、制作現場のビデオ編集に必要な十分な精度には遠く及びません。また、より正確で調整可能であっても対象ビデオへの忠実度を保てない拡散モデルを使う必要もありません。

Text2Liveからのプロンプトベースの変換編集のサンプル。
以前のアプローチは、伝播ベースの方法またはオプティカルフローベースのアプローチを使用していました。これらのテクニックは、フレームベースであるため、出力ビデオの変更の時間的一貫性を生成することができません。一方、ニューラルレイヤードアトラスは、変更を扱うための単一の空間を提供し、コミットされた変更に忠実に残ることができます。
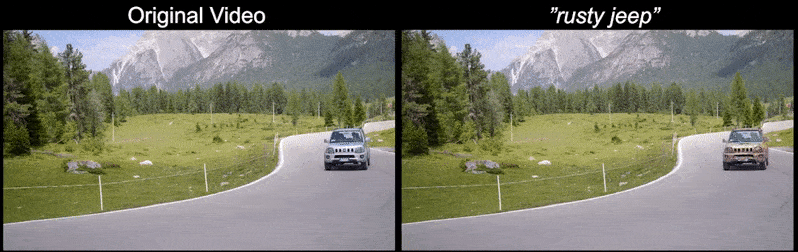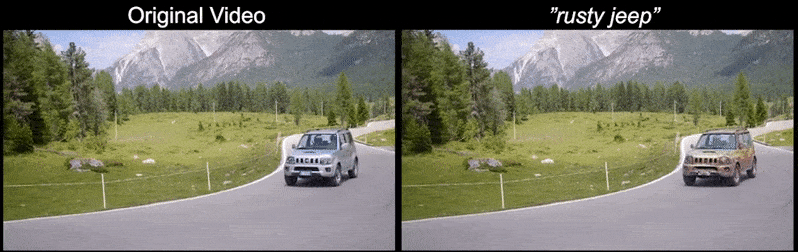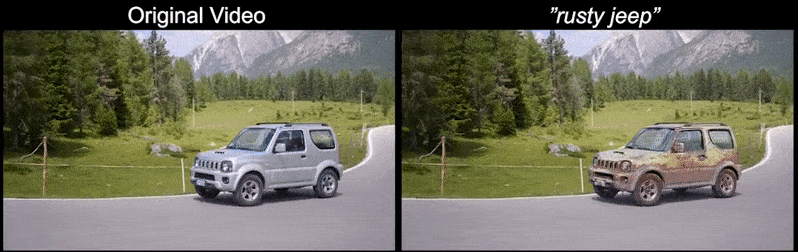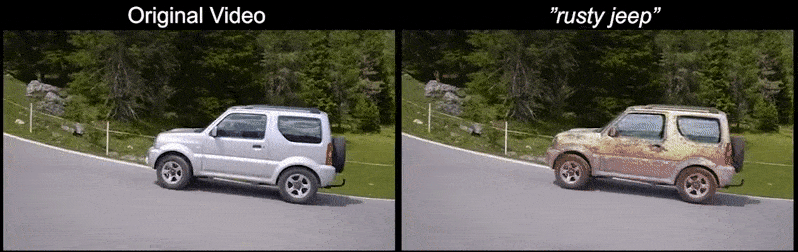
ちらつきや無作為な幻覚はありません。Text2Liveはテキストプロンプト「錆びたジープ」を解釈し、それをビデオのニューラルレイヤードアトラスの車に1回適用します。各解釈フレームごとに変換を再開することはありません。

ジープを錆びた遺物に変換するText2Liveのワークフロー。
Text2Liveは、テキストから画像を生成する分野よりも、AIを使った映像合成の画期的進歩に近い技術です。テキストから画像を生成する分野は、今週OpenAIがDALL-Eフレームワークの第2世代を公開したことで大きな注目を集めました。DALL-Eは変換過程に対象画像を取り込めますが、写真を直接変更する能力には依然として制約があります。さらに、利用者の悪用を防ぐために元の学習データの検閲やフィルターの適用も行われています。
Text2Liveは、エンドユーザーがアトラスを抽出して、高制御のピクセルベースの環境(Photoshopや、より抽象的な画像合成フレームワークでも可能と考えられるNeRF)で1回のパスで編集できるようにします。次に、3D推定や過去の手法に立ち返るCGIベースのアプローチに頼ることなく、正しく向けられた環境に戻します。
さらに、Text2Liveは、著者によると、完全に自動的な方法でマスキングとコンポジットを実現した最初の比較可能なフレームワークです。
初めて公開:2022年4月7日。





