
インタビュー
SF Tensorの創設者兼CEO、Ben Koska – インタビュー・シリーズ

 Unite.AI を Google の優先ソースに追加
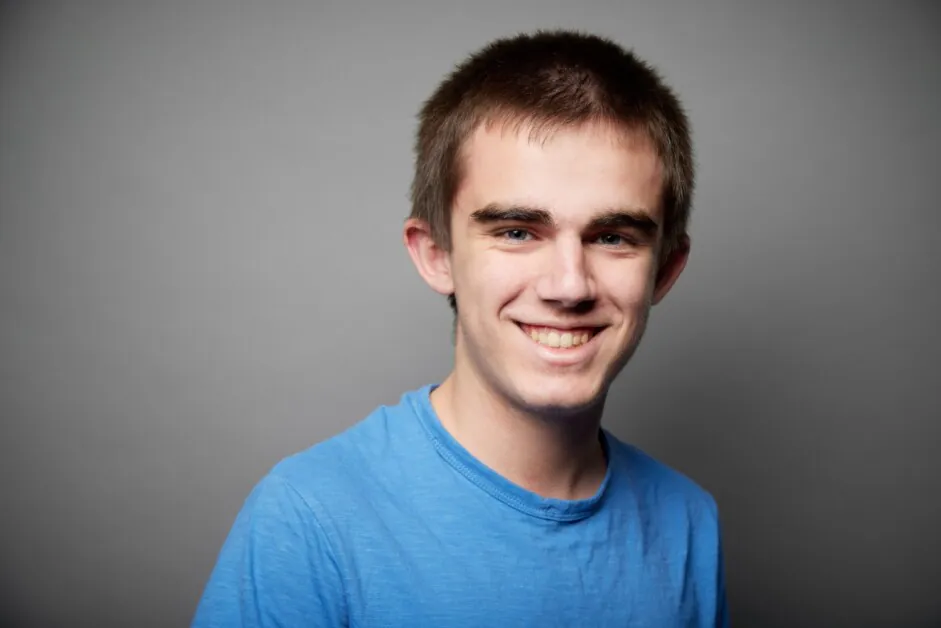
Ben Koskaは、SF Tensorの創設者兼CEOであり、AI研究者兼システムエンジニアです。彼は、高性能コンピューティング、カーネル最適化、効率的なモデルトレーニングに関する研究で知られています。彼の背景は、低レベルAIインフラストラクチャの開発、トレーニングスループットの改善、重量的なエンジニアリングオーバーヘッドなしに高度なモデル開発を可能にするツールの設計にあります。彼は、速度、移植性、信頼性の限界を超えるシステムを構築することに焦点を当てています。
SF Tensorは、彼が率いる会社で、この哲学を実践的なプラットフォームに変えました。統一プログラミングモデル、カーネル最適化器、クロスクラウドオーケストレーションレイヤーを導入し、分散AIワークロードの複雑さを排除します。プラットフォームは、エンジニアにハードウェア非依存の環境を提供し、そこでコードを1回書いてどこにでもデプロイし、高性能を自動的に実現できるように設計されています。SF Tensorの使命は、AIコンピューティングを劇的に高速化し、管理を容易にし、ベンダーロックインから解放することです。
あなたは19歳で複数のスタートアップでエンジニアリングを率いた後にSF Tensorを設立しました。どのような経験があなたをAIインフラストラクチャの再発明に駆り立てたのでしょうか?
私たちが解決しようとしている問題は、私自身が直面した問題です。当初、SF Tensorのコアスタックを開発していたとき、商業プロジェクトではなく、学術研究プロジェクトでした。研究を行うために助成金を得たのですが、インフラストラクチャと最適化にほとんどの時間を費やしました。私たちのインフラストラクチャ技術に興味を持つ人が多かったのです。
SF Tensorは、NVIDIAのCUDAの優位性を打破するという、AIで最も難しい問題に取り組んでいます。ハードウェアの移植性を損なうことなく、高性能を実現するシステムを設計するために、どのようにアプローチしましたか?
最終的には、すべてのAIは単純な数学に帰着します。各モデルは、結果を計算するために必要な数学演算のセットです。数学的な問題としてではなく、コンピュータサイエンスの問題として扱うことで、計算の最小の制約を特定し、数百万から数十億の異なる方法で計算を機械語に変換し、最速のものを見つけることができます。ただし、数十億の異なるプログラムを実行して最速のものを見つけることは不可能なので、検索空間を絞り込むために、ハードウェアとプログラムの速度を推定するための数学モデルの開発が必要でした。
会社のブログには、コンパイル最適化とクロスクラウドオーケストレーションに関する革新が紹介されています。SF Tensorのアプローチは、PyTorchやJAXなどの既存のフレームワークとどのように異なりますか?
まだ技術的なブログ記事は書いていませんが、実際にはPyTorchやJAXなどのフレームワークをサポートし、コードを最適化できるようにしています。JAXやPyTorchと私たちのスタックの違いは、モデル全体を単一の計算として扱うことです。伝統的なコンパイル最適化技術を適用するのではなく、数百万から数十億のカーネルを生成し、最速のものを見つけることを目指しています。
多くのスタートアップはトレーニング効率に焦点を当てていますが、あなたは「インフラストラクチャ税」という概念を強調しています。SF Tensorは、この不均衡をどのように解決していますか?
両方の問題を解決する必要があります。私たちの多くの仕事はトレーニング効率の向上に費やされていますが、現在私たちが解決できる最も重大な問題は、インフラストラクチャ税です。私たち自身がすでに解決している問題だからです。
あなたはトレーニングコストの最大80%削減を実現したと述べています。どのような最適化またはアーキテクチャの革新がこれを可能にしましたか?
私たちのソフトウェアスタックは、検索ベースのコンパイラが人間のルールに勝つという考えに基づいています。現在、コンパイラの最大の制約は、数百万から数十億のカーネルをベンチマークしてランク付けすることが不可能であるということです。そこで、ハードウェアとプログラムの速度を推定するための数学モデルの開発が必要でした。
あなたのEmmaプログラミング言語の開発経験は、SF Tensorのアーキテクチャとパフォーマンス、抽象化へのアプローチにどのように影響しましたか?
私はまだコンパイラエンジニアです。私は常に、物事を少しでも速くする方法を見つけることに興味があります。Emmaを開発する際に、コンパイラを4回または5回捨てて、最初からやり直しました。最適化のために、システムを再設計する必要がありました。現在、私たちのシステムは、最適化を繰り返し適用できるように設計されています。
4,000以上のGPUを使用した大規模トレーニング実行の経験から、コンピューティングを管理する上で最も重要な教訓は何でしたか?
ハードウェアの故障は予想よりも頻繁に発生し、問題となることがあります。従来のプログラムやコンパイラと比較して、GPUはハードウェアの故障がより頻繁に発生し、特に大規模なクラスタでの分散トレーニングでは、ハードウェアの故障が重大な問題となることがあります。
Y Combinatorは、テクノロジー業界で最も変革的なインフラストラクチャ企業を支援してきました。Y Combinatorでの経験は、SF Tensorの製品とビジョンの拡大にどのように影響しましたか?
Y Combinatorに入る前は、私たちの目標が野心的であると思っていました。しかし、数週間後には、私たちの目標はさらに大きなものになりました。Y Combinatorでの経験は、私たちに大きな影響を与え、問題に対処するためのより協調的なアプローチをとるようになりました。
将来的には、非LLMモデル、ロボティクス、合成データに興味があると述べています。これらの分野は、会社の長期的なビジョンにどのように関連していますか?
LLMは確かに興味深い技術であり、将来的には重要な役割を果たすことになるでしょう。しかし、LLMが他のAI分野よりも優れているのは、多くの投資と協力によって最適化されてきたからです。私たちは、研究者が可能な限り安価に、効率的に研究を行えるようにすることで、LLM以外のモデルが発展することを期待しています。
5年後のAIインフラストラクチャスタックはどのようなものになりそうですか? SF Tensorはその中でどのような役割を果たすと思いますか?
5年後には、多くの企業が専用チップを開発し、研究者がそれらのチップを利用できるようになっていると考えています。理想的には、コードを特別に書く必要も、チップの存在を知る必要もなく、利用できるようになっていると思います。私たちは、その未来を目指して働いています。
素晴らしいインタビュー、詳しく知りたい読者はSF Tensorを訪れてください。


