Andersonの視点
シーンを理解するAI画像マッティング

 Unite.AI を Google の優先ソースに追加
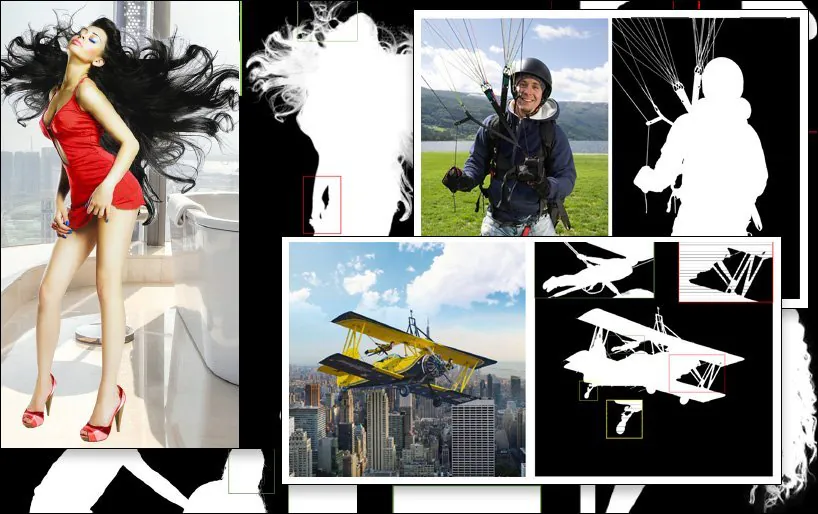
要点AIマット処理は現在、シーン記述を使用してグリーンスクリーンなしで抽出をガイドします。
もっと見る
- AIマット処理は現在、シーン記述を使用してグリーンスクリーンなしで抽出をガイドします。
- このシステムは、髪の毛や透明なテクスチャなどの細部を保持することで、トリマップ不要の手法を上回ります。
- OPPO研究所のSPG-IMは、画像キャプションを活用して高コストな手動アノテーションを削減します。
映画『Alien3』(1992)の2003年DVD版に収録された特典ドキュメンタリーで、視覚効果の巨匠Richard Edlundは、光化学的なマット抽出という「相撲の格闘」を恐ろしい記憶として振り返った。この処理は1930年代後半から1980年代後半まで視覚効果制作の主流だった。Edlundはその不確実さを相撲にたとえ、1990年代初頭に主流となったデジタルのブルー/グリーンスクリーン技術と比較した。その後も彼はこの比喩に立ち返っている。
前景要素(人物や宇宙船モデルなど)を背景から抽出し、切り抜いた画像を別の背景プレートに合成できるようにする手法は、もともと前景オブジェクトを均一な青または緑の背景の前で撮影することで実現されていた。
『Return of the Jedi』(1983)のVFXショットのためにILMが行った、手間のかかる光化学的な抽出処理。
得られた映像では、背景色が化学的に分離され、テンプレートとして使用され、前景オブジェクト(または人物)を光学プリンターで再印刷し、透明なフィルムセル内に「浮き」オブジェクトとして配置した。
このプロセスはカラー分離オーバーレイ(CSO)と呼ばれていたが、最終的には1970年代から1980年代の低予算テレビ制作で使用された粗い‘Chromakey’映像効果と結びつくようになった。これらは化学的・デジタル的手法ではなく、アナログ手法で実現されていた。

1970年、英国の子ども向け番組『Blue Peter』で行われたカラー分離オーバーレイの実演。 出典: https://www.bbc.co.uk/archive/blue_peter_noakes_CSO/zwb9vwx
いずれにせよ、映画でもビデオでも、抽出された映像は他の映像に挿入できるようになった。
ディズニーの特に高価で独自のナトリウム蒸気方式(黄色にキーイングし、使用されたアルフレッド・ヒッチコックの1963年ホラー『The Birds』でも採用された)は、より鮮明でクリスプなマットを提供したが、フォトケミカル抽出は依然として手間がかかり信頼性に欠けていた。

ディズニー独自のナトリウム蒸気による抽出処理には、スペクトルの黄色側に近い背景が必要だった。写真では『Bedknobs and Broomsticks』(1971)のVFXを多用した場面の撮影中、Angela Lansburyがワイヤーでつられている。 出典
デジタルマッティングを超えて
1990年代、デジタル革命により化学薬品は不要となったが、緑スクリーンの必要性は残った。Photoshop のようなピクセル編集ソフトや新世代のビデオ合成スイートで、対象色の許容範囲内のピクセルを検索するだけで緑(または任意の色)背景を除去できるようになった。ほぼ瞬時に、60年にわたる光学印刷産業は歴史の闇に葬られた。
GPU 加速によるコンピュータビジョン研究の過去10年は、マット抽出を第3の時代へと導き、研究者は緑スクリーン不要で高品質なマットを抽出できるシステムの開発に取り組んでいる。Arxiv だけでも、機械学習ベースの前景抽出に関する論文が毎週掲載されている。
私たちを映像に入れる
学術界と産業界での AI 抽出への関心はすでに消費者向けにも波及しており、Zoom や Skype のフィルタで、リビングルームの背景を熱帯の島などに置き換えることができる。
しかし、最高品質のマットは依然として緑スクリーンが必要であると、Zoom が先週水曜日に指摘した。

左はグリーンスクリーンの前に立つ男性で、Zoomのバーチャル背景機能が髪をきれいに抽出している。右は一般的な室内にいる女性で、アルゴリズムによる髪の抽出は精度が低く、必要な計算資源も多い。 出典: https://support.zoom.us/hc/en-us/articles/210707503-Changing-your-Virtual-Background-image
さらに別の投稿 では、緑スクリーンを使用しない抽出はキャプチャデバイス側でより多くの計算リソースが必要になると警告している。
切り抜く必要性
実環境でのマット抽出システム(緑スクリーン不要で人物を分離する)の品質、携帯性、リソース効率の向上は、ビデオ会議フィルタ以外の多くの分野や用途にとって重要である。
データセット開発においては、顔や全頭、全身認識の向上により、余計な背景要素が人間対象のコンピュータビジョンモデルに学習されるのを防げる。より正確な分離は、セマンティックセグメンテーション 技術を改善し、「猫」、「人」、「船」 といったドメインを区別・統合することを可能にし、VAE や トランスフォーマー ベースの画像合成システム(例:OpenAI の新しい DALL‑E 2)を向上させ、また高価な VFX パイプラインにおける手作業のロトスコーピング の必要性を削減できる。
実際、マルチモーダル(通常はテキスト/画像)手法の台頭により、「猫」 のようなドメインが画像と関連テキストの両方でエンコードされ、画像処理への応用が進んでいる。最近の例として、Text2Live アーキテクチャは、マルチモーダル(テキスト/画像)学習を用いて、クリスタルの白鳥やガラスのキリン など多様な映像を生成できる。
シーン認識AIマッティング
AI による自動マッティングの研究は、画像やビデオフレーム内の境界認識とピクセル群の評価に多く焦点を当ててきた。しかし、中国の新たな研究は、シーンのテキストベースの記述(過去 3〜4 年でコンピュータビジョン研究分野で注目を集めたマルチモーダルアプローチ)を活用し、輪郭とマット品質を向上させる抽出パイプラインを提案し、従来手法を複数の面で上回ると主張している。

SPG-IMによる抽出例(最後の画像、右下)を、従来の競合手法と比較したもの。 出典: https://arxiv.org/pdf/2204.09276.pdf
抽出研究サブセクターが直面している課題は、手動アノテーションや人間の介入を極力減らす、理想的には全く不要なワークフローを実現することだ。コスト面だけでなく、さまざまな文化圏の外部クラウドワーカーが行うアノテーションや手動セグメンテーションは、画像が異なる方法でラベル付け・セグメント化される原因となり、アルゴリズムの一貫性と満足度を損なうことが指摘されている。
このことの一例が「前景オブジェクト」の主観的解釈である:

新論文より。従来手法のLFMとMODNetは前景の内容を異なる形で定義し、その効果にも差がある。一方、新しいSPG-IMはシーンの文脈から近くの内容をより適切に区別する。GTはGround Truthを意味し、しばしば手作業や非アルゴリズム的手法で得られる理想的な参照結果を示す。
この課題に対処するため、研究者は Situational Perception Guided Image Matting(SPG‑IM)という二段階パイプラインを開発した。二段階エンコーダ/デコーダ構造は、Situational Perception Distillation(SPD)と Situational Perception Guided Matting(SPGM)から構成される。

SPG-IMのアーキテクチャ。
まず、SPD は視覚特徴からテキスト特徴への変換を事前学習し、画像に対応するキャプションを生成する。その後、前景マスク予測は新しい顕著性予測手法と接続することで可能になる。
続いて SPGM は、最初のモジュールで得られたマスクと生の RGB 画像入力に基づき、推定アルファマットを出力する。
目的は状況認識に基づくガイダンスであり、システムが画像の内容を文脈的に理解することで、例えば複雑な髪を背景から抽出するという課題を、その特定の作業について既知の特徴を踏まえて捉えられるようにすることだ。

下の例ではSPG-IMがひもをパラシュートの不可欠な一部と理解するのに対し、MODNetはその詳細を保持・識別できない。同様に上の例では、MODNetが遊具の全体的な構造を恣意的に失っている。
新しい論文は Situational Perception Guided Image Matting と題され、OPPO Research Institute、PicUp.ai、Xmotors の研究者らによるものである。
インテリジェント自動マット
SPG‑IM はさらに、ローカルディテールとグローバルコンテキストを別々に処理できる Adaptive Focal Transformation(AFT)リファインメントネットワークを提供し、「インテリジェントマット」を実現する。

この例の「馬と一緒にいる少女」のようにシーンの文脈を理解することで、従来手法より前景の抽出が容易になる可能性がある。
論文では次のように述べられている。
「私たちは、画像キャプション生成などの視覚情報をテキストに変換するタスクから得られる視覚表現が、より意味的に包括的な信号、すなわち a) 物体同士の関係、b) 物体と周囲の環境の関係に注目すると考えている。これにより全体の情報と局所的な詳細の両方を含む説明を生成できる。また、画像マッティングの高コストな画素単位のアノテーションに比べ、テキストラベルは非常に低コストで大量に収集できる。」
SPD ブランチは、ミシガン大学のVirTex トランスフォーマーベースのテキストデコーダと共同で事前学習され、セマンティックに濃密なキャプションから視覚表現を学習する。

VirTexは画像とキャプションの組を使ってConvNetとTransformerを共同学習し、得られた知識を物体検出などの後続の視覚タスクに転用する。 出典: https://arxiv.org/pdf/2006.06666.pdf
他のテストやアブレーション研究とともに、研究者らはSPG-IMを最先端のtrimapベースの手法と比較した。対象はDeep Image Matting(DIM)、IndexNet、Context-Aware Image Matting(CAM)、Guided Contextual Attention(GCA)、FBA、Semantic Image Matting(SIM)である。
比較対象には、trimapを必要としないLFM、HAttMatting、MODNetなどの従来のフレームワークも含まれた。公平な比較のため、各手法の違いに合わせてテスト方法を調整し、コードを入手できない場合は論文に記載されたアーキテクチャから手法を再実装した。
新しい論文は次のように述べている。
「私たちのSPG-IMは、競合するすべてのtrimap不要の手法([LFM]、[HAttMatting]、[MODNet])を大きな差で上回る。また、公開データセット(Composition-1K、Distinction-646、Human-2K)および独自のMulti-Object-1Kベンチマークにおいて、4つの指標すべてで最先端(SOTA)のtrimapベースの手法やマスク誘導型の手法よりも顕著に優れた結果を示している。」
さらに、次のように続く。
「私たちの手法は、trimapによるガイダンスなしで、髪の先端、透明なテクスチャ、境界などの細部を保持する。また、他の競合するtrimap不要のモデルと比較して、SPG-IMは全体的な意味の完全性をよりよく保持できる。」


2022年4月24日公開。