Andersonの視点
Google の Imagic と Runway の「Erase and Replace」による AI 支援オブジェクト編集

 Unite.AI を Google の優先ソースに追加

今週、2つの新しいが対照的な AI 主導のグラフィックアルゴリズムが、エンドユーザーに写真内のオブジェクトを非常に細かく、効果的に変更する新たな方法を提供しています。
最初は Google Research が、イスラエル工科大学とワイツマン科学研究所と共同で開発した Imagic です。Imagic は拡散モデルのファインチューニングを通じて、テキスト条件付きでオブジェクトを細かく編集できる機能を提供します。

好きな部分だけを変更し、残りはそのままに – Imagic は変更したい部分だけを細かく編集できることを約束します。 ソース: https://arxiv.org/pdf/2210.09276.pdf
Stable Diffusion で再描画した際にたった1つの要素だけを変更しようとしたことがある人は、成功した編集のたびにシステムが自分が好きだった5つの要素まで変更してしまうという問題をよく知っているでしょう。この欠点のため、多くの熟練した SD ユーザーは「コラテラルダメージ」を修正するために Stable Diffusion と Photoshop を行き来しています。この観点だけでも、Imagic の成果は注目に値します。
執筆時点では、Imagic にはまだプロモーション動画すらなく、Google が 慎重な姿勢 を示していることから、制限のない画像合成ツールを公開するかどうかは不透明です。
2つ目の提供は、Runway ML が比較的手軽に利用できる Erase and Replace 機能です。これは同社のオンライン専用機械学習ベースのビジュアルエフェクトツールスイート「AI Magic Tools」セクションに追加された 新機能 です。
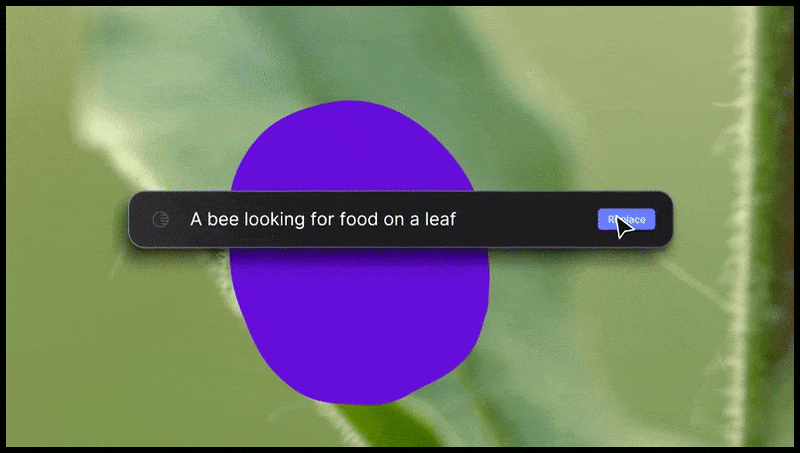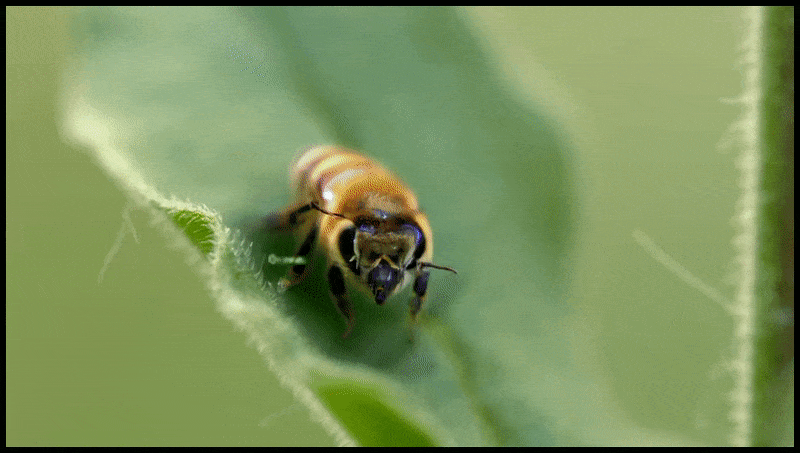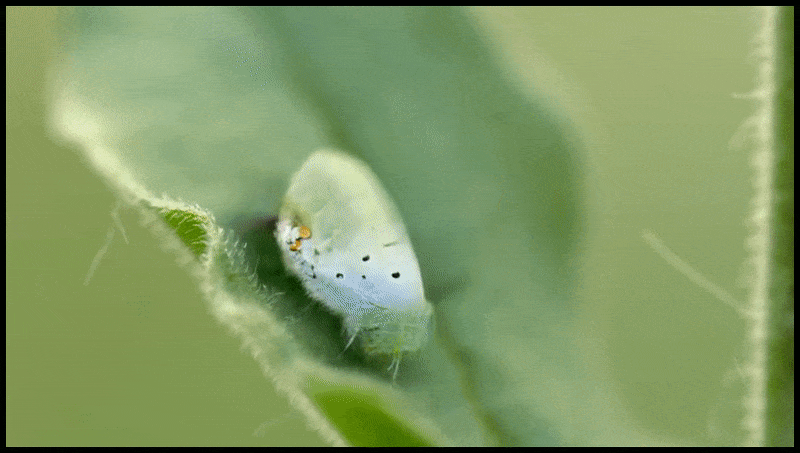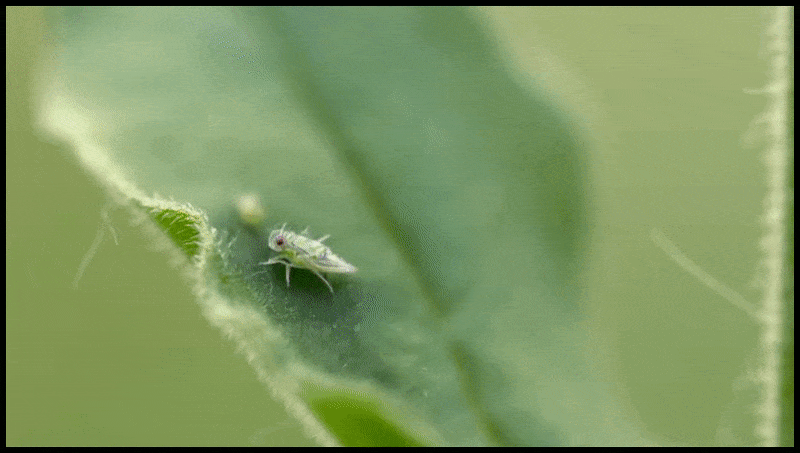
Runway ML の Erase and Replace 機能は、テキストから動画への編集システムのプレビューでもすでに見られました。
まずは Runway のこの機能を見てみましょう。
Erase and Replace
Imagic と同様に Erase and Replace は静止画に限定して動作しますが、Runway は テキストから動画への編集ソリューション でも同様の機能をプレビューしています(まだリリースされていません)。
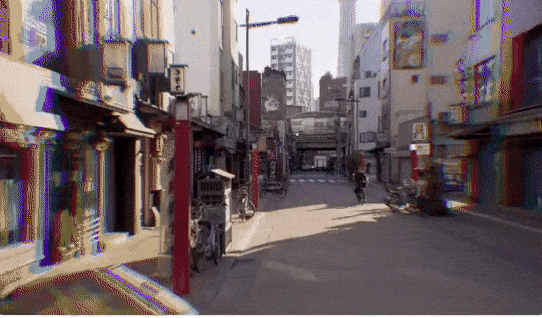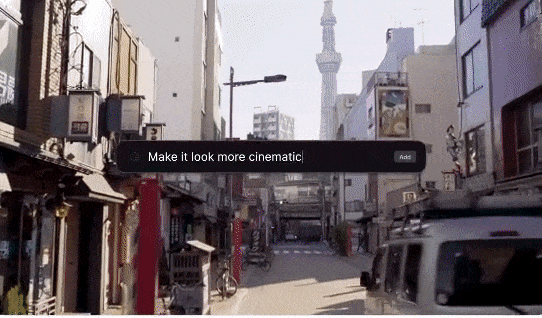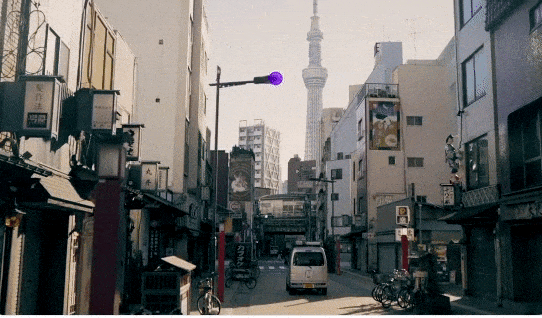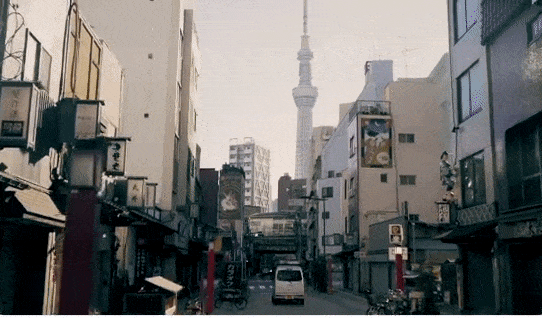
誰でも画像上で新しい Erase and Replace をテストできますが、動画版はまだ一般公開されていません。 Source: https://twitter.com/runwayml/status/1568220303808991232
Runway ML は Erase and Replace の背後にある技術詳細を公開していませんが、家の観葉植物をロナルド・レーガンの胸像に差し替える速度から、Stable Diffusion(あるいは、はるかに可能性が低いですがライセンスされた DALL‑E 2)といった拡散モデルが、選択したオブジェクトを再生成していると推測できます。

観葉植物をロナルド・レーガン像に置き換える速度はこの例ほど速くはありませんが、かなり高速です。 Source: https://app.runwayml.com/
このシステムには DALL‑E 2 と同様の制限があります。— Erase and Replace フィルタが検出した画像やテキストは、さらなる違反があった場合にアカウント停止の警告が出されます — 事実上、OpenAI が DALL‑E 2 に対して実施しているポリシーの雛形と言えるでしょう。
多くの結果は Stable Diffusion が持つ典型的な粗さを欠いています。Runway ML は投資家であり 研究パートナー でもあるため、オープンソースの 1.4 チェックポイントウェイトよりも優れた独自モデルを訓練している可能性があります(他の開発グループ、ホビイスト・プロフェッショナル問わず、現在 Stable Diffusion の訓練やファインチューニングに取り組んでいます)。
Runway ML の Erase and Replace で、家庭用テーブルを「氷のテーブル」に置き換える。
Imagic(下記参照)と同様に、Erase and Replace は「オブジェクト指向」的です。つまり、画像の空白部分を単に消去してテキストプロンプトの結果で塗りつぶすことはできません。その場合、システムはマスクの視線方向に最も近い明らかなオブジェクト(壁やテレビなど)をトレースし、そこに変換を適用します。
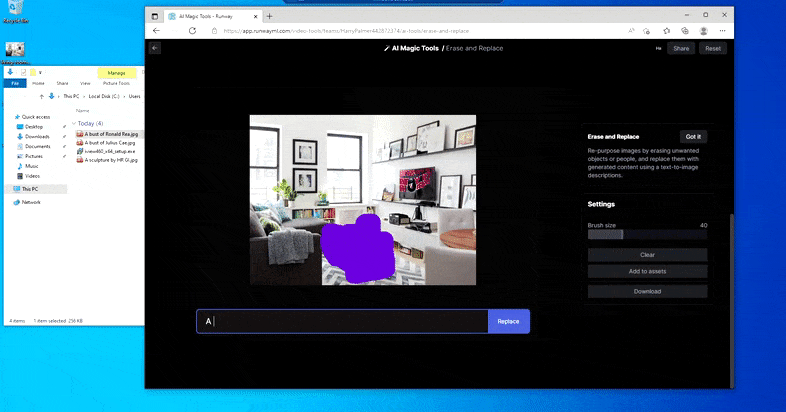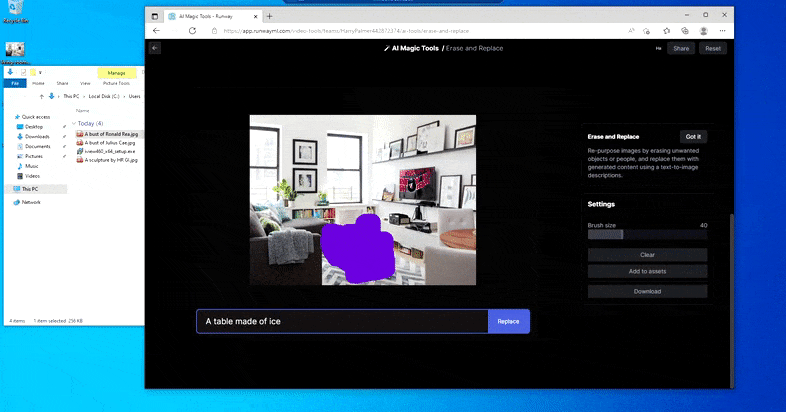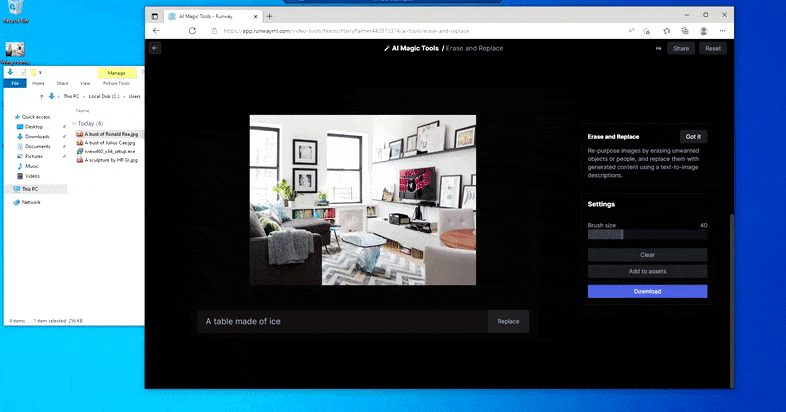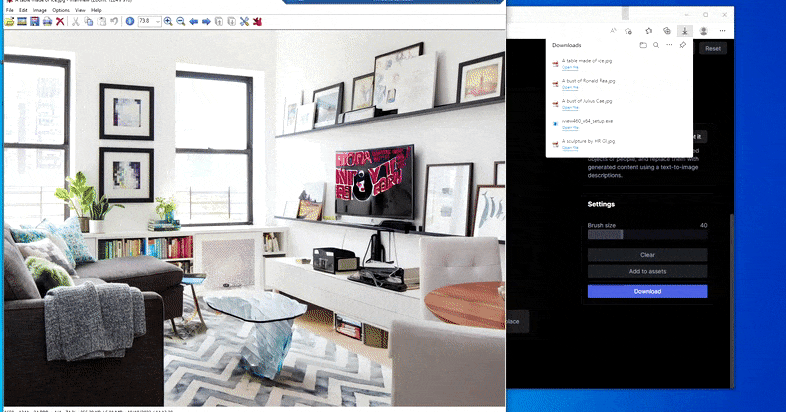
名前が示す通り、Erase and Replace では空間にオブジェクトを注入できません。ここでは、最も有名なシス・ロードを呼び出そうとした結果、テレビに奇妙なヴェイダー関連の壁画が描かれました(「置換」領域が描かれた位置付近)。
Erase and Replace が著作権で保護された画像の使用を回避しようとしているのか(DALL‑E 2 でも依然として多くが阻止されている)、あるいはバックエンドで使用されているモデルがその種のタスクに最適化されていないのかは不明です。
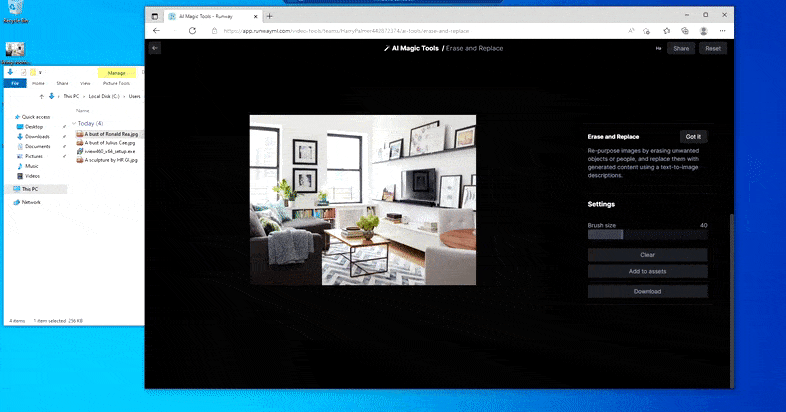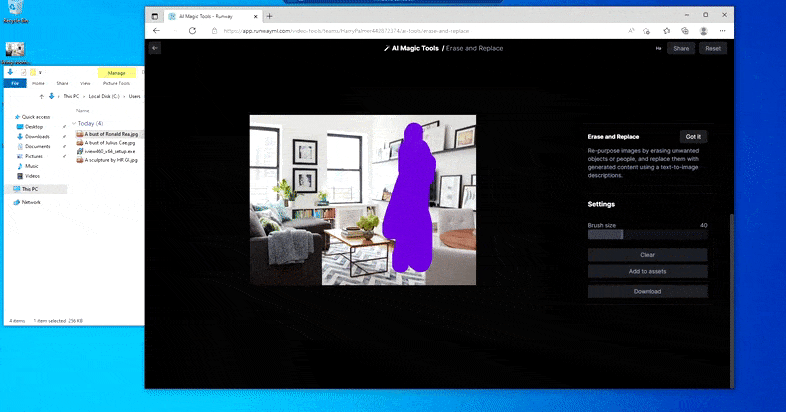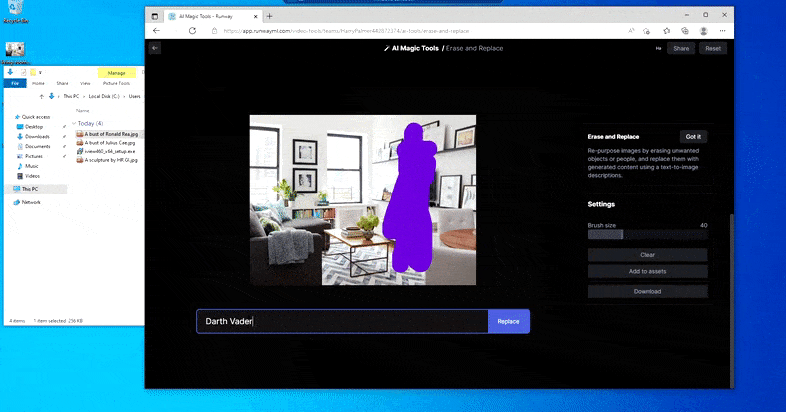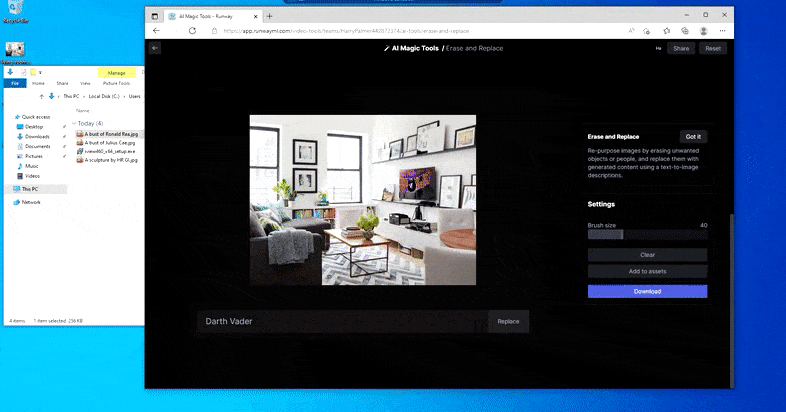
やや NSFW な「ニコール・キッドマンの壁画」は、拡散ベースのモデルが DALL‑E 2 のように実写顔や過激なコンテンツを体系的に排除しないことを示唆しています。一方、著作権で保護された作品を再現しようとした結果は、曖昧な「エイリアン」から不条理な「鉄の王座」まで様々です。右下に元画像があります。
Erase and Replace がオブジェクトを分離して置換できる手法は興味深いです。おそらく画像は CLIP の派生で処理され、オブジェクト認識とセマンティックセグメンテーションにより個別項目が抽出されているのでしょう。これらの処理は一般的な Stable Diffusion のインストールではほとんど機能しません。
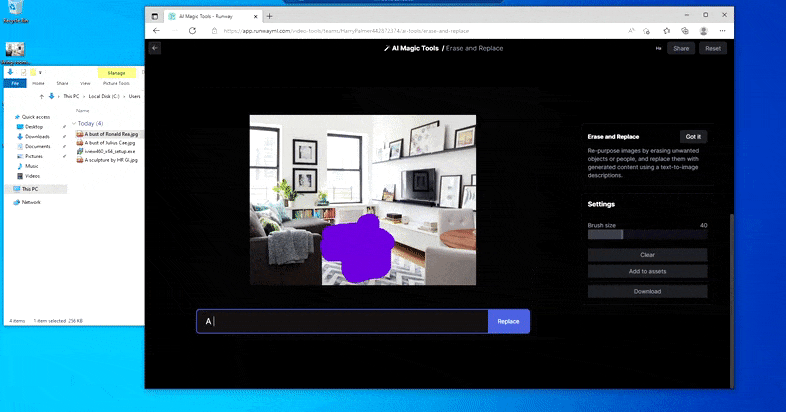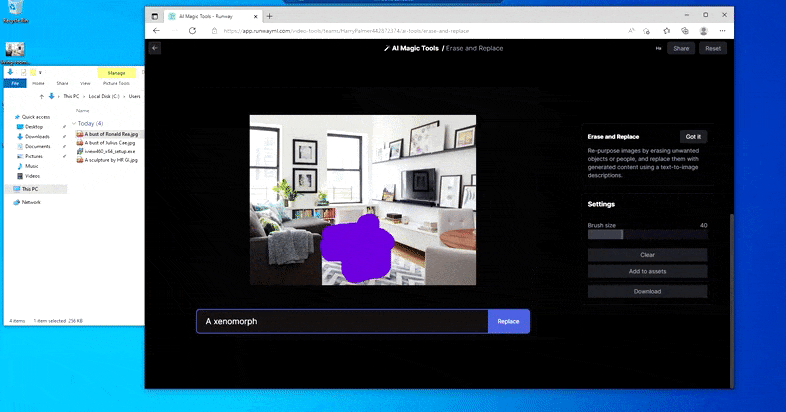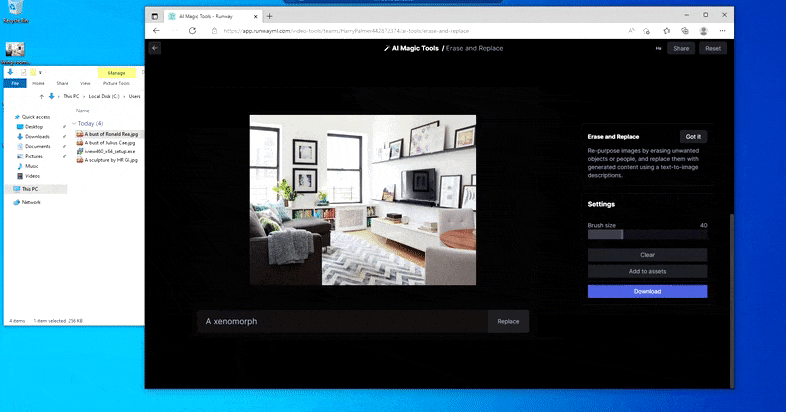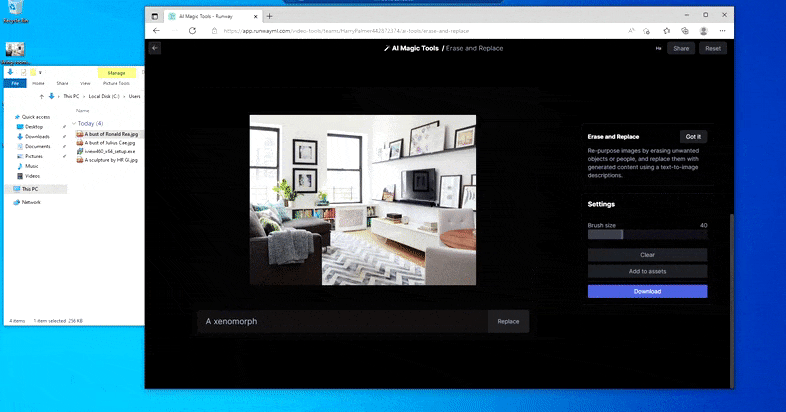
しかし完璧ではありません。時折システムは消去は行うものの置換が行われず、上記画像のようにテキストプロンプトが何を意味するかをレンダリングエンジンが確実に理解していても、コーヒーテーブルをエイリアン(「エイリアン」)に変えることは不可能で、テーブルが単に消えてしまいます。
「ウォーリーをさがせ」の恐ろしいバージョンです。Erase and Replace がエイリアンを生成できません。
Erase and Replace は優れたインペインティング機能を備えた効果的なオブジェクト置換システムですが、既存の認識されたオブジェクトを編集することはできず、あくまで置換に限られます。環境を損なわずに既存画像の内容を変更することは、コンピュータビジョン研究分野が長年取り組んできた 分離(disentanglement) の課題と深く関わっていると言えるでしょう。
Imagic
Imagic はこの課題に取り組んでいます。新しい論文 では、画像全体をそのままにして個別の要素だけを変更できる多数の例が示されています。
Imagic では、編集された画像は単一画像から導出された限られた事前情報に依存するディープフェイク・パペットの特徴的な伸びや歪み、‘遮蔽推測’ の問題に悩まされません。
このシステムは 3 段階のプロセスで構成されています — テキスト埋め込みの最適化、モデルのファインチューニング、そして最終的に修正画像の生成です。

Imagic は対象テキストプロンプトをエンコードして初期テキスト埋め込みを取得し、結果を最適化して入力画像を得ます。その後、生成モデルをソース画像に対してファインチューニングし、さまざまなパラメータを追加して要求された補間を行います。
予想通り、フレームワークは Google の Imagen テキスト‑to‑ビデオ アーキテクチャに基づいていますが、研究者はこのシステムの原理は潜在拡散モデル全般に広く適用できると述べています。
Imagen は 3 層のアーキテクチャを採用しており、同社の最近の テキスト‑to‑ビデオ バージョン が使用する 7 層構成とは異なります。3 つのモジュールは、64×64px の解像度で動作する生成拡散モデル、出力を 256×256px に拡大する超解像モデル、さらに 1024×1024px まで拡大する追加の超解像モデルで構成されています。
Imagic はこのプロセスの最初の段階で介入し、64px 段階で要求されたテキスト埋め込みを Adam オプティマイザ(学習率 0.0001)で最適化します。
分離(disentanglement)のマスタークラス:拡散、GAN、NeRF モデルでオブジェクトの色を変えるだけでも、Imagic が画像全体の一貫性を壊さずに変換できることの重要性が分かります。
その後、Imagen のベースモデルに対して 1500 ステップのファインチューニングが行われ、修正された埋め込みに条件付けられます。同時に、二次的な 64px→256px レイヤーも条件付け画像上で並行して最適化されます。研究者は最終的な 256px→1024px レイヤーの最適化は「ほとんど効果がない」ため実装していないと述べています。
論文によれば、最適化プロセスは TPU V4 チップ 2 台で画像ごとに約 8 分かかります。最終的なレンダリングは DDIM サンプリング方式 に基づいて Imagen のコアで行われます。
Google の DreamBooth と同様のファインチューニングプロセスと共通点があり、得られた埋め込みはスタイライズや、Imagen の背後にある大規模データベースから情報を引き出したフォトリアリスティックな編集にも利用できます(下の最左列が示すように、元画像自体には必要なコンテンツが含まれていません)。
Imagic では柔軟なフォトリアルな動きや編集が可能で、プロセスで得られた分離コードはスタイライズ出力にも容易に利用できます。
研究者は Imagic を以前の研究 SDEdit(2021 年の GAN ベース手法、スタンフォード大学とカーネギーメロン大学の共同研究)および Text2Live(2022 年 4 月、ワイツマン科学研究所と NVIDIA の共同研究)と比較しました。
Imagic、SDEdit、Text2Live のビジュアル比較。
従来手法は苦戦しているのが明らかですが、下段の行で大幅なポーズ変更を試みた際、既存手法はソース素材をまったく再構築できず、Imagic は顕著な成功を収めています。
Imagic のリソース要件と画像ごとの訓練時間は、同種の取り組みと比較しては短いものの、個人用 PC のローカル画像編集アプリに組み込むには現実的ではなく、ファインチューニングプロセスを消費者レベルにまで縮小できるかは不透明です。
現時点では、Imagic は API 向けに最適化された印象的な提供物であり、Deepfake の助長に対して批判的な姿勢を取る Google Research にとっては、最も快適な環境と言えるでしょう。
First published 18th 2022年10月.