
Angolo di Anderson
UniTune: la tecnica alternativa di Google per l’editing neurale delle immagini

 Aggiungi Unite.AI alle tue fonti preferite su Google
Punti chiaveUniTune 在单张图像上微调扩散模型,以实现精确的文本驱动编辑。
Vedi di più
- UniTune 在单张图像上微调扩散模型,以实现精确的文本驱动编辑。
- 与 DreamBooth 或 Textual Inversion 不同,UniTune 摒弃了这两种方法,以更好地保留细节。
- 该方法实现了高度的语义解耦,在彻底改变背景时保持面部完整。
La ricerca di Google sembra attaccare l’editing di immagini basato su testo da diverse angolazioni e, presumibilmente, aspetta di vedere cosa “funziona”. Subito dopo la pubblicazione della sua relazione Imagic di questa settimana, il gigante della ricerca ha proposto un altro metodo basato sulla diffusione latente per eseguire modifiche altrimenti impossibili alle immagini tramite comandi testuali, chiamato UniTune.
Basato sugli esempi forniti nel nuovo documento del progetto, UniTune ha raggiunto un grado straordinario di disentanglement della posa semantica e dell’idea dal contenuto effettivo dell’immagine:

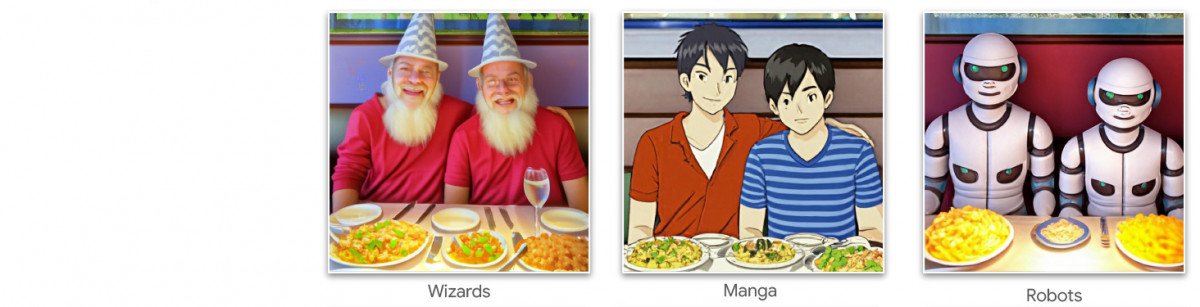

Il controllo di UniTune sulla composizione semantica è eccezionale. Nota come nella riga superiore delle immagini, i volti delle due persone non sono stati distorti dalla trasformazione straordinaria del resto dell’immagine sorgente (a destra). Fonte: https://arxiv.org/pdf/2210.09477.pdf
Per i fan di Stable Diffusion, applicare modifiche a sezioni parziali di un’immagine senza alterare negativamente il resto dell’immagine può essere un’operazione difficile, a volte impossibile. Sebbene le distribuzioni popolari come AUTOMATIC1111 possano creare maschere per modifiche locali e limitate, il processo è tortuoso e spesso imprevedibile.
La risposta ovvia, almeno per un praticante di visione computerizzata, è interporre un livello di segmentazione semantica in grado di riconoscere e isolare oggetti in un’immagine senza intervento dell’utente, e, in effetti, ci sono stati diverse nuove iniziative recentemente lungo questa linea di pensiero.
Un’altra possibilità per bloccare le operazioni di editing di immagini neurali disordinate e intrecciate è sfruttare il modulo di pre-formazione del linguaggio-immagine contrastivo di OpenAI (CLIP), che è al cuore dei modelli di diffusione latente come DALL-E 2 e Stable Diffusion, per agire come un filtro nel punto in cui un modello di testo-immagine è pronto per inviare un rendering interpretato all’utente. In questo contesto, CLIP dovrebbe agire come una sentinella e modulo di controllo della qualità, rifiutando rendering malformati o altrimenti inadeguati. Ciò è in procinto di essere introdotto (collegamento Discord) nel portale API-driven di Stability.ai DreamStudio.
Tuttavia, poiché CLIP è essenzialmente sia il colpevole che la soluzione in tale scenario (poiché ha anche informato il modo in cui l’immagine è stata evoluta), e poiché i requisiti hardware possono superare ciò che è probabile essere disponibile localmente per un utente finale, questo approccio potrebbe non essere ideale.
Lingua compressa
Il proposto UniTune “affina” un modello di diffusione esistente – in questo caso, il modello Imagen di Google, sebbene i ricercatori affermino che il metodo è compatibile con altre architetture di diffusione latente – in modo che un token univoco venga iniettato in esso, che può essere richiamato includendolo in un prompt testuale.
A prima vista, questo sembra come DreamBooth di Google, attualmente un’ossessione tra i fan e gli sviluppatori di Stable Diffusion, che può iniettare personaggi o oggetti nuovi in un checkpoint esistente, spesso in meno di un’ora, sulla base di una manciata di immagini sorgenti; o come Textual Inversion, che crea file “sidecar” per un checkpoint, che vengono trattati come se fossero stati originariamente addestrati nel modello, e possono sfruttare le risorse del modello stesso modificando il suo classificatore testuale, risultando in un file piccolo (rispetto ai checkpoint pruned di almeno 2GB di DreamBooth).
In realtà, i ricercatori affermano che UniTune ha rifiutato entrambi questi approcci. Hanno scoperto che Textual Inversion ometteva troppi dettagli importanti, mentre DreamBooth ‘eseguiva peggio e richiedeva più tempo’ della soluzione che alla fine hanno adottato.
UniTune usa comunque lo stesso approccio di «metaprompt» semantico incapsulato di DreamBooth: le modifiche apprese vengono richiamate da parole uniche scelte dall’addestratore, che non confliggono con i termini già presenti nel modello pubblico faticosamente addestrato. QUOTEOPEN«Per eseguire l’operazione di modifica, campioniamo i modelli affinati con il prompt “[rare_tokens] edit_prompt” (per esempio “beikkpic due cani in un ristorante” oppure “beikkpic un minion”).»QUOTECLOSE
Il processo
Sebbene sia intrigante il motivo per cui due documenti quasi identici, in termini di funzionalità finale, siano arrivati da Google nella stessa settimana, c’è, nonostante un enorme numero di somiglianze tra le due iniziative, almeno una chiara differenza tra UniTune e Imagic – quest’ultimo utilizza prompt di linguaggio naturale “non compressi” per guidare le operazioni di editing di immagini, mentre UniTune addestra token univoci nello stile di DreamBooth.
Pertanto, se si stesse modificando con Imagic e si desiderasse effettuare una trasformazione di questo tipo…

Dal documento UniTune – UniTune si contrappone al framework di editing neurale rivale di Google, SDEdit. I risultati di UniTune sono a destra, mentre la maschera stimata è visibile nella seconda immagine da sinistra.
.. in Imagic, si inserirebbe ‘la terza persona, seduta in secondo piano, come un mostro peloso carino’.
Il comando equivalente di UniTune sarebbe ‘Uomo dietro come [x]’, dove x è la parola strana e univoca legata al concetto fine-addestrato associato al personaggio del mostro peloso.
Mentre DreamBooth e Textual Inversion ricevono più immagini per creare un’astrazione in stile deepfake richiamabile in molte pose, UniTune e Imagic ricevono una sola immagine: l’originale intatto. È simile agli strumenti di modifica basati su GAN degli ultimi anni, che convertono l’immagine in codici nello spazio latente del GAN e poi li inviano ad altre zone dello spazio per modificarla (per esempio proiettando una giovane persona dai capelli scuri attraverso codici associati a «vecchio» o «biondo»). Tuttavia i risultati ottenuti così in un modello di diffusione sono sorprendentemente precisi e molto meno ambigui per confronto. 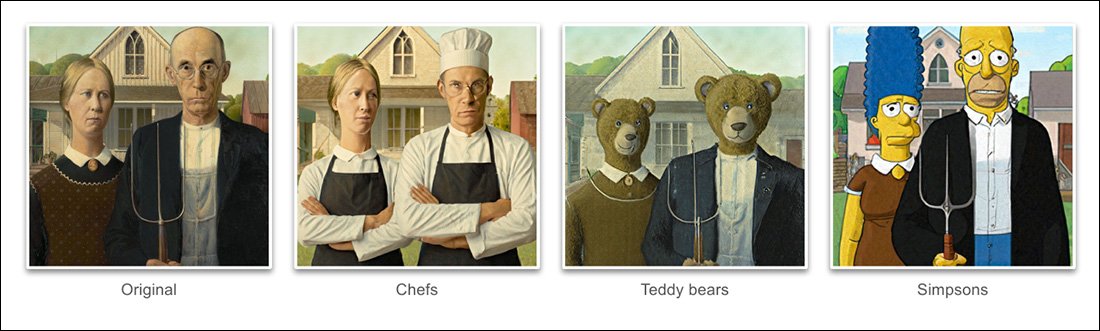
Il processo di fine-tuning
Il metodo UniTune invia essenzialmente l’immagine originale attraverso un modello di diffusione con un set di istruzioni su come dovrebbe essere modificata, utilizzando i vasti repository di dati disponibili addestrati nel modello. In effetti, è possibile farlo ora con la funzionalità img2img di Stable Diffusion – ma non senza deformare o in qualche modo cambiare le parti dell’immagine che si desidera mantenere.
Durante il processo UniTune, il sistema viene fine-tuned, il che significa che UniTune costringe il modello a riprendere l’addestramento, con la maggior parte dei suoi livelli sbloccati (vedi sotto). Nella maggior parte dei casi, il fine-tuning ridurrà i valori di perdita generali di un modello ad alte prestazioni in favore di iniettare o raffinare alcuni altri aspetti che si desidera creare o migliorare.
Con UniTune la copia del modello utilizzata, pur potendo occupare diversi gigabyte o più, sembra trattata come un «guscio» accessorio usa e getta, eliminato al termine dopo aver servito un solo scopo. Questo enorme volume di dati sta diventando una crisi quotidiana di archiviazione per gli utenti DreamBooth, i cui modelli, anche ridotti, occupano almeno 2 GB per soggetto. Come in Imagic, la regolazione principale avviene nei due livelli inferiori dei tre di Imagen (base 64px, 64px>256px e 256px>1024px). Diversamente da Imagic, i ricercatori vedono un possibile vantaggio nel regolare anche l’ultimo e più grande livello di super-risoluzione, pur non avendoci ancora provato. Per il livello inferiore di 64px, durante l’addestramento il modello è orientato verso l’immagine base: più coppie duplicate immagine/testo vengono inserite per 128 iterazioni con batch di 4, usando Adafactor come funzione di perdita e un tasso di apprendimento di 0,0001. Solo il codificatore T5 è congelato durante questo affinamento, così come nell’addestramento principale di Imagen. L’operazione viene ripetuta per il livello 64>256px con la stessa procedura di aumento del rumore usata nell’addestramento originale di Imagen.
Campionamento
Ci sono molti metodi di campionamento possibili per cui le modifiche apportate possono essere ottenute dal modello fine-addestrato, tra cui la guida senza classificatore (CFG), una caratteristica anche di Stable Diffusion. La CFG definisce essenzialmente la misura in cui il modello è libero di “seguire la sua immaginazione” e esplorare le possibilità di rendering – o, con impostazioni inferiori, la misura in cui dovrebbe aderire ai dati di input sorgente e apportare modifiche meno ampie o drammatiche.

Come Textual Inversion (un po’ meno con DreamBooth), UniTune può applicare stili grafici distinti alle immagini originali, nonché modifiche più fotorealistiche.
I ricercatori hanno anche sperimentato la tecnica “late start” di SDEdit, dove il sistema è incoraggiato a preservare i dettagli originali essendo solo parzialmente “rumoroso” fin dall’inizio, ma piuttosto mantenendo le sue caratteristiche essenziali. Sebbene i ricercatori abbiano utilizzato questo solo nel livello più basso (64px), ritengono che potrebbe essere una tecnica di campionamento utile nel futuro.
I ricercatori hanno usato anche prompt-to-prompt come tecnica testuale aggiuntiva per condizionare il modello: QUOTEOPEN«Nella configurazione “prompt to prompt” abbiamo trovato particolarmente utile per regolare fedeltà ed espressività una tecnica che chiamiamo Prompt Guidance.»QUOTECLOSEQUOTEOPEN«Prompt Guidance è simile alla guida senza classificatore, ma il riferimento è un prompt diverso anziché il modello non condizionato. Questo guida il modello verso la differenza tra i due prompt.»QUOTECLOSE

Prompt-to-prompt in UniTune isola efficacemente le aree da modificare.
Gli autori precisano tuttavia che la guida tramite prompt era necessaria solo occasionalmente, quando CFG non otteneva il risultato desiderato. Un’altra nuova tecnica di campionamento incontrata durante lo sviluppo di UniTune è stata l’interpolazione: le aree sono abbastanza distinte e la composizione dell’immagine originale e di quella modificata abbastanza simile da consentire un’interpolazione più «ingenua».

L’interpolazione può rendere superflui i processi più impegnativi di UniTune quando le aree da trasformare sono separate e ben delimitate.
Gli autori suggeriscono che l’interpolazione potrebbe funzionare così bene per molte immagini sorgenti da diventare un’impostazione predefinita. Può inoltre produrre trasformazioni straordinarie quando non occorre gestire occlusioni complesse con metodi più intensivi. UniTune può modificare localmente con o senza maschere, ma può anche decidere autonomamente dove collocare le modifiche, combinando una notevole capacità interpretativa con la robusta conservazione degli elementi essenziali della sorgente:

Nell’immagine in alto della seconda colonna, UniTune, incaricato di inserire un «treno rosso sullo sfondo», lo colloca in una posizione appropriata e autentica. Negli altri esempi si mantiene l’integrità semantica della sorgente anche durante straordinari cambiamenti del contenuto dei pixel e degli stili fondamentali.
Latenza
Sebbene la prima iterazione di un nuovo sistema sarà sempre lenta e sebbene sia possibile che il coinvolgimento della comunità o l’impegno aziendale (di solito non entrambi) alla fine velocizzeranno e ottimizzeranno una routine risorsosa, sia UniTune che Imagic eseguono alcune importanti manovre di apprendimento automatico per creare questi incredibili editing, ed è discutibile fino a che punto un processo così risorsoso potrebbe mai essere ridotto per l’uso domestico, piuttosto che l’accesso guidato dall’API (sebbene quest’ultimo possa essere più desiderabile per Google).
Al momento, il viaggio di andata e ritorno dall’input al risultato è di circa 3 minuti su una GPU T4, con circa 30 secondi extra per l’inferenza (come per qualsiasi routine di inferenza). Gli autori ammettono che questo è un ritardo alto e che a malapena si qualifica come “interattivo”, ma notano anche che il modello rimane disponibile per ulteriori modifiche una volta inizialmente regolato, fino a quando l’utente non ha finito con il processo, il che riduce il tempo di modifica.
Pubblicato per la prima volta il 21 ottobre 2022.


