
Angolo di Anderson
Modifica di Oggetti Assistita da IA con Imagic di Google e “Erase and Replace” di Runway

 Aggiungi Unite.AI alle tue fonti preferite su Google

Questa settimana due nuovi, ma contrastanti, algoritmi grafici basati su IA offrono modalità innovative per consentire agli utenti finali di apportare modifiche estremamente granulari ed efficaci agli oggetti nelle foto.
Il primo è Imagic, di Google Research, in collaborazione con l’Istituto di Tecnologia di Israele e l’Istituto Weizmann di Scienza. Imagic consente la modifica di oggetti condizionata dal testo, con editing di precisione tramite il fine‑tuning di modelli di diffusione.

Cambia ciò che desideri e lascia intatto il resto – Imagic promette un editing granulare solo delle parti che vuoi modificare. Fonte: https://arxiv.org/pdf/2210.09276.pdf
Chiunque abbia mai provato a modificare un singolo elemento in un nuovo rendering di Stable Diffusion sa fin troppo bene che, per ogni modifica riuscita, il sistema ne altera altre cinque che erano già perfette. È una limitazione che spinge molti degli appassionati più esperti di SD a passare continuamente tra Stable Diffusion e Photoshop per correggere questo tipo di “danni collaterali”. Da questo punto di vista, i risultati di Imagic risultano notevoli.
Al momento della stesura, Imagic non dispone neanche di un video promozionale e, data l’atteggiamento cauto di Google nel rilasciare strumenti di sintesi d’immagine senza restrizioni, non è chiaro in che misura, se mai, avremo la possibilità di testare il sistema.
La seconda proposta è la funzione Erase and Replace di Runway ML, una nuova funzionalità nella sezione “AI Magic Tools” della sua suite esclusivamente online di strumenti visivi basati sul machine learning.
La funzione Erase and Replace di Runway ML, già mostrata in un’anteprima di un sistema di editing da testo a video.
Diamo prima un’occhiata all’uscita di Runway.
Cancella e Sostituisci
Come Imagic, Cancella e Sostituisci si occupa esclusivamente di immagini statiche, sebbene Runway abbia mostrato la stessa funzionalità in una soluzione di editing da testo a video ancora non rilasciata:
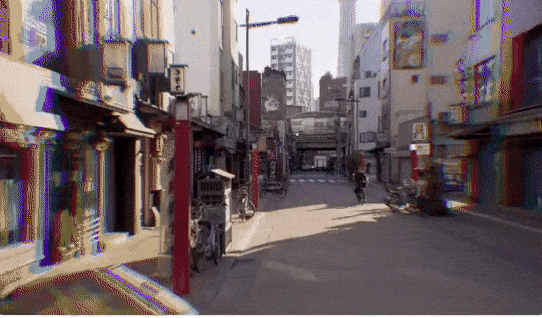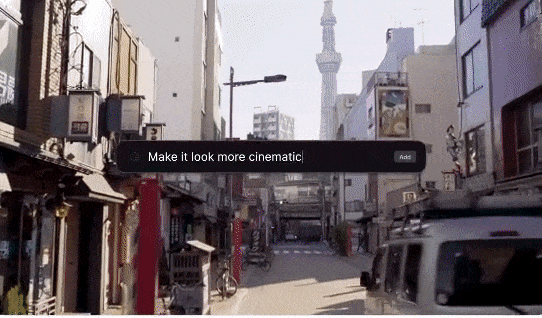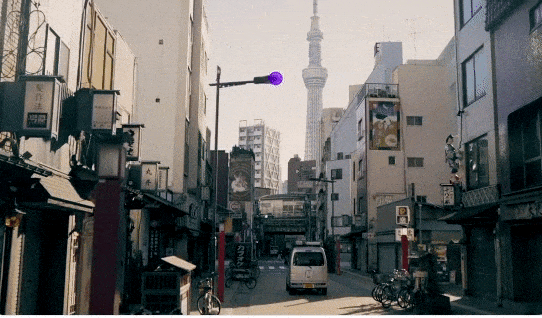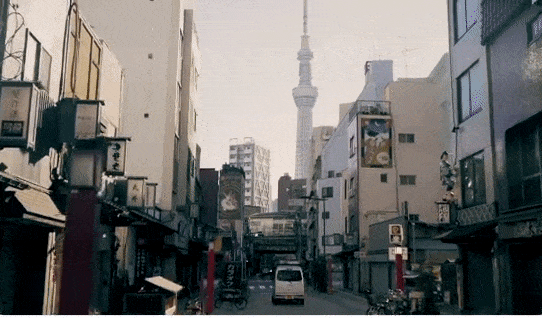
Anche se chiunque può provare il nuovo Cancella e Sostituisci su immagini, la versione video non è ancora disponibile al pubblico. Fonte: https://twitter.com/runwayml/status/1568220303808991232
Pur non avendo divulgato i dettagli delle tecnologie alla base di Cancella e Sostituisci, la velocità con cui è possibile sostituire una pianta d’appartamento con un busto ragionevolmente convincente di Ronald Reagan suggerisce che un modello di diffusione come Stable Diffusion (o, molto meno probabile, un DALL‑E 2 con licenza) sia il motore che reinventa l’oggetto scelto.

Sostituire una pianta d’appartamento con un busto di “The Gipper” non è veloce come questo, ma è comunque piuttosto rapido. Fonte: https://app.runwayml.com/
Il sistema presenta alcune limitazioni tipiche di DALL‑E 2 – immagini o testi che attivano i filtri di Cancella e Sostituisci genereranno un avviso di possibile sospensione dell’account in caso di ulteriori violazioni – praticamente una copia standard delle politiche di OpenAI per DALL‑E 2.
Molti dei risultati non mostrano i tipici bordi grezzi di Stable Diffusion. Runway ML è investitore e partner di ricerca di SD, ed è possibile che abbia addestrato un modello proprietario superiore ai pesi open‑source del checkpoint 1.4 con cui noi tutti stiamo ancora lottando (come molti altri gruppi di sviluppo, hobbyisti e professionisti, stanno attualmente addestrando o perfezionando modelli Stable Diffusion).
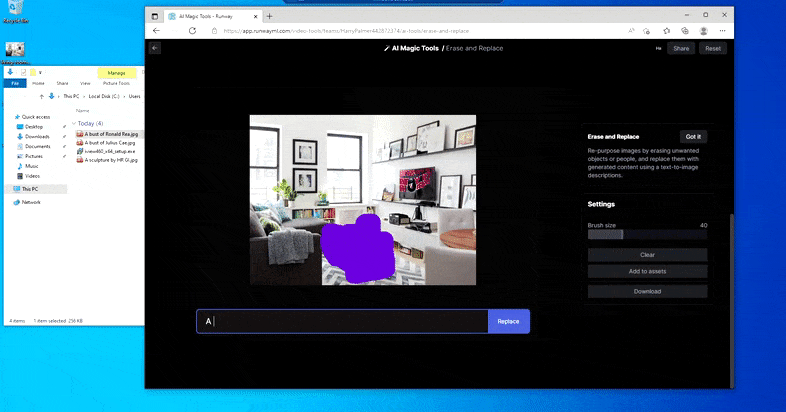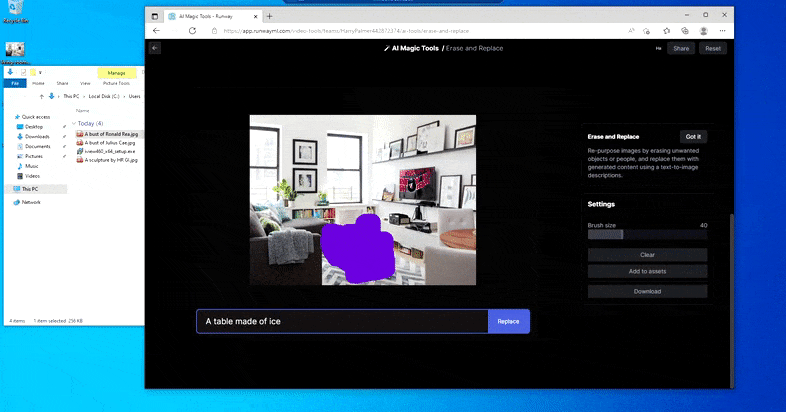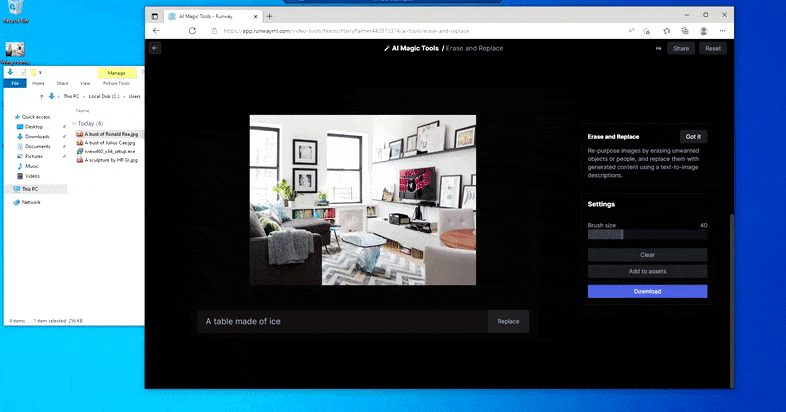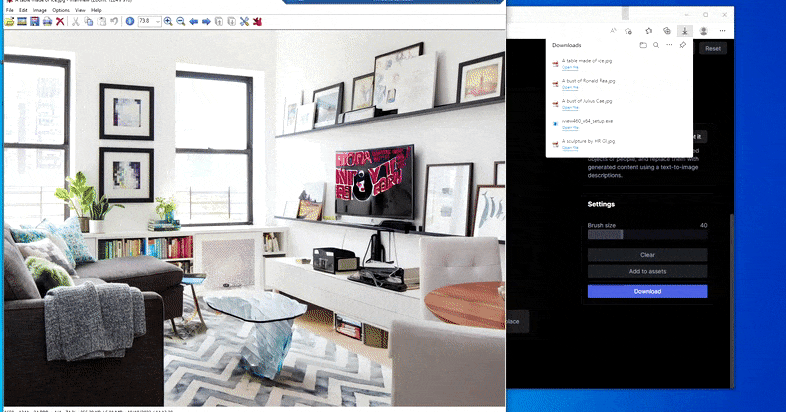
Sostituire un tavolo domestico con un “tavolo di ghiaccio” in Cancella e Sostituisci di Runway ML.
Come Imagic (vedi sotto), Cancella e Sostituisci è “orientato agli oggetti” – non è possibile cancellare una zona “vuota” dell’immagine e riempirla con il risultato del prompt testuale; in tal caso il sistema traccerà semplicemente l’oggetto più vicino lungo la linea di vista della maschera (come un muro o un televisore) e applicherà la trasformazione lì.
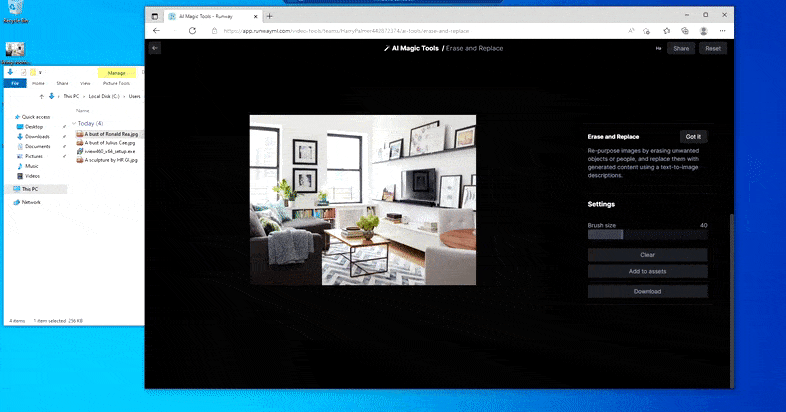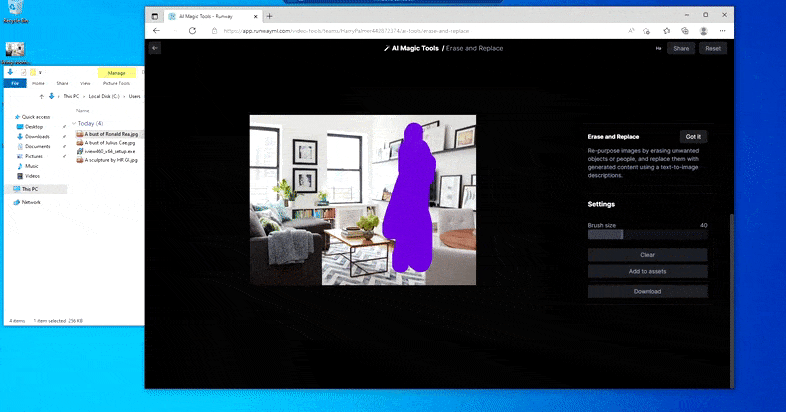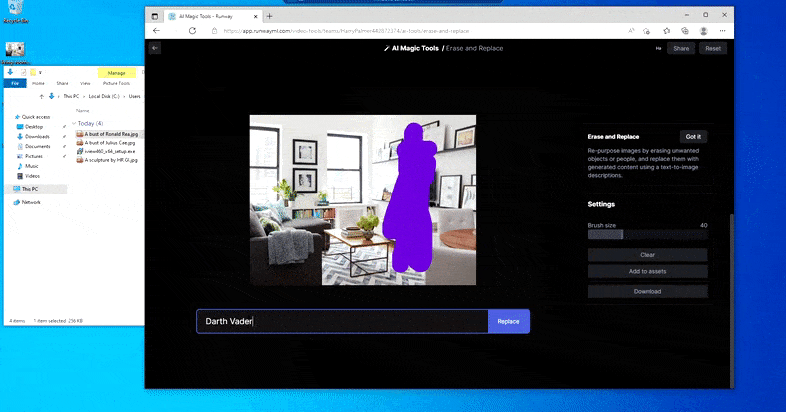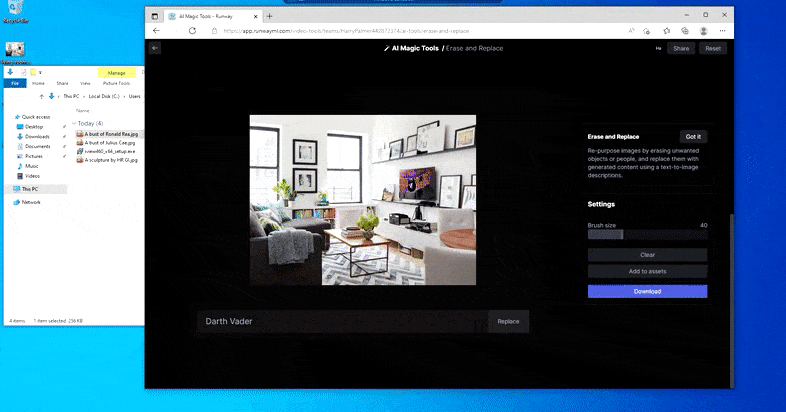
Come suggerisce il nome, non è possibile inserire oggetti in uno spazio vuoto con Cancella e Sostituisci. Qui, un tentativo di evocare il più famoso dei Signori Sith produce un bizzarro murale legato a Vader sul televisore, più o meno dove era stata disegnata l’area da “sostituire”.
È difficile capire se Cancella e Sostituisci stia evitando l’uso di immagini protette da copyright (ancora in gran parte bloccate, seppur con successo variabile, in DALL‑E 2) o se il modello impiegato nel motore di rendering non sia ottimizzato per quel tipo di contenuto.

Il leggermente NSFW “Murale di Nicole Kidman” indica che il modello (presumibilmente) basato su diffusione non possiede il rifiuto sistematico di DALL‑E 2 nei confronti di volti realistici o contenuti espliciti; i risultati per tentativi di riprodurre opere protette da copyright variano dall’ambiguo (“xenomorfo”) all’assurdo (“il Trono di Ferro”). In basso a destra, l’immagine di origine.
Sarebbe interessante capire quali metodi utilizzi Cancella e Sostituisci per isolare gli oggetti che può sostituire. Probabilmente l’immagine viene analizzata tramite una derivazione di CLIP, con gli elementi discreti individuati tramite riconoscimento oggetti e successiva segmentazione semantica. Nessuna di queste operazioni funziona altrettanto bene in un’installazione “standard” di Stable Diffusion.
Ma nulla è perfetto – a volte il sistema sembra cancellare senza sostituire, anche quando (come abbiamo visto nell’immagine sopra) il meccanismo di rendering sottostante comprende chiaramente il significato del prompt testuale. In questo caso è impossibile trasformare un tavolino da caffè in uno xenomorfo – il tavolo semplicemente scompare.
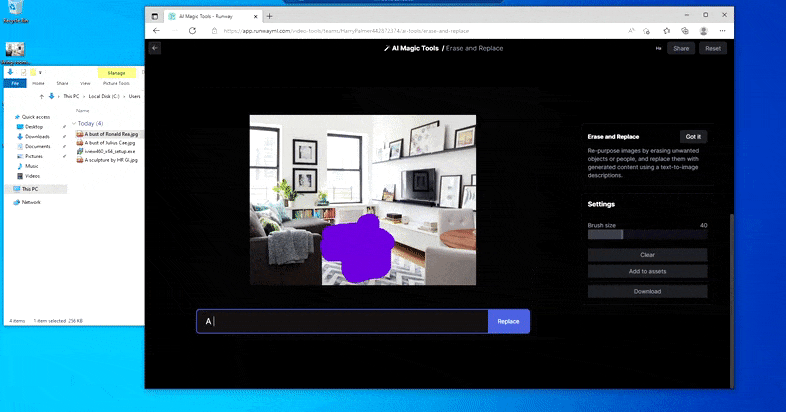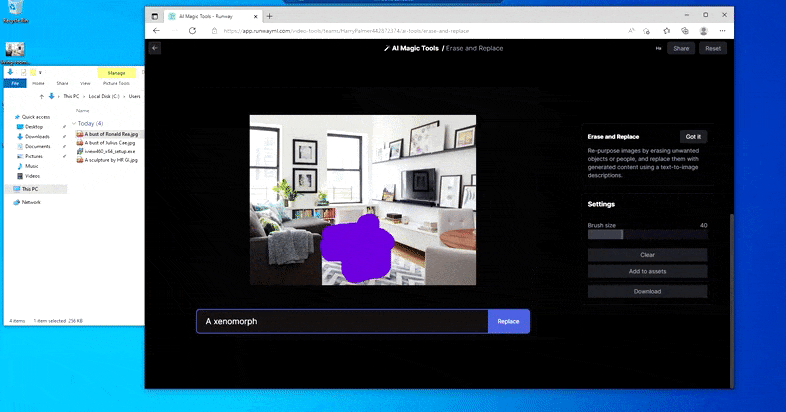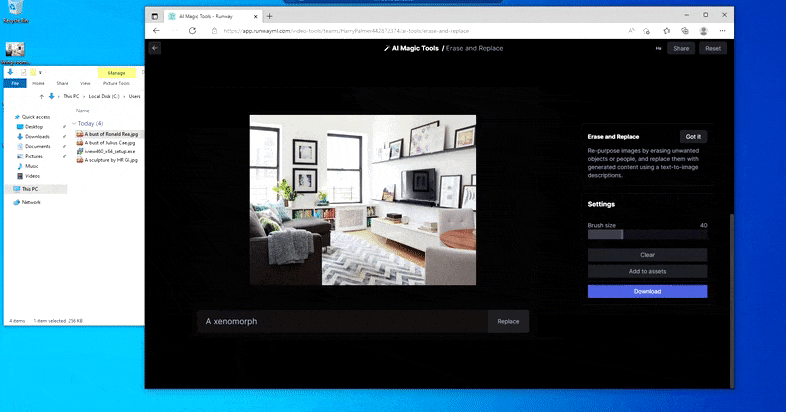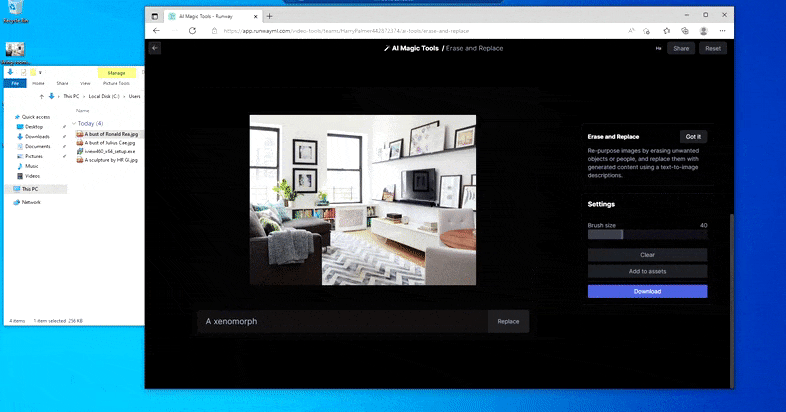
Una versione più inquietante di “Dov’è Waldo”, poiché Cancella e Sostituisci non riesce a produrre un alieno.
Cancella e Sostituisci appare come un efficace sistema di sostituzione di oggetti, con ottimo inpainting. Tuttavia, non può modificare oggetti già percepiti, ma solo sostituirli. Alterare il contenuto di un’immagine esistente senza compromettere il materiale ambientale è probabilmente un compito molto più difficile, legato alla lunga lotta del settore della visione artificiale verso la disentanglement nei vari spazi latenti dei framework più diffusi.
Imagic
È proprio questo il compito che Imagic affronta. Il nuovo articolo offre numerosi esempi di modifiche che correggono singole sfaccettature di una foto lasciando intatto il resto dell’immagine.

In Imagic, le immagini modificate non soffrono della tipica distorsione, allungamento e “indovinare l’occlusione” tipici dei deepfake, che si basano su pochi dati derivati da un’unica immagine.
Il sistema utilizza un processo a tre fasi – ottimizzazione dell’embedding testuale; fine‑tuning del modello; e, infine, generazione dell’immagine modificata.

Imagic codifica il prompt testuale target per ottenere l’embedding iniziale, lo ottimizza per ricavare l’immagine di input e poi affina il modello generativo sull’immagine di origine, aggiungendo vari parametri, prima di applicare l’interpolazione richiesta.
Non sorprende che il framework sia basato sull’architettura testuale‑video Imagen di Google, sebbene i ricercatori affermino che i principi del sistema siano ampiamente applicabili a modelli di diffusione latente.
Imagen utilizza un’architettura a tre livelli, anziché la struttura a sette livelli impiegata nella più recente iterazione testuale‑video del software dell’azienda. I tre moduli distinti comprendono un modello di diffusione generativa a risoluzione 64×64 px; un modello di super‑risoluzione che porta l’output a 256×256 px; e un ulteriore modello di super‑risoluzione che porta il risultato fino a 1024×1024 px.
Imagic interviene nella fase più precoce di questo processo, ottimizzando l’embedding testuale richiesto al livello 64 px con un ottimizzatore Adam a tasso di apprendimento statico di 0,0001.

Una lezione magistrale di disentanglement: gli utenti che hanno provato a cambiare il colore di un oggetto renderizzato in un modello di diffusione, GAN o NeRF sapranno quanto sia importante che Imagic possa eseguire tali trasformazioni senza “strappare” la coerenza del resto dell’immagine.
Il fine‑tuning avviene poi sul modello di base di Imagen, per 1500 passi per immagine di input, condizionato sull’embedding rivisto. Parallelamente, il livello secondario 64 px→256 px viene ottimizzato sull’immagine condizionata. I ricercatori osservano che un’ottimizzazione analoga per lo strato finale 256 px→1024 px ha “poco o nessun effetto” sui risultati finali, perciò non è stata implementata.
L’articolo afferma che il processo di ottimizzazione richiede circa otto minuti per ogni immagine su due chip TPU V4. Il rendering finale avviene nel nucleo di Imagen secondo lo schema di campionamento DDIM.
In comune con processi di fine‑tuning simili per il DreamBooth di Google, gli embedding risultanti possono inoltre alimentare la stilizzazione, nonché modifiche fotorealistiche che attingono a informazioni dal più ampio database sottostante che alimenta Imagen (poiché, come mostra la prima colonna qui sotto, le immagini di origine non contengono alcun contenuto necessario per effettuare tali trasformazioni).

Movimenti fotorealistici flessibili e modifiche possono essere ottenuti con Imagic, mentre i codici derivati e disentangled ottenuti nel processo possono essere usati altrettanto facilmente per output stilizzati.
I ricercatori hanno confrontato Imagic con lavori precedenti SDEdit, un approccio basato su GAN del 2021, frutto di una collaborazione tra la Stanford University e la Carnegie Mellon University; e Text2Live, una collaborazione dell’aprile 2022 tra il Weizmann Institute of Science e NVIDIA.

Confronto visivo tra Imagic, SDEdit e Text2Live.
È evidente che gli approcci precedenti faticano, ma nella riga inferiore, che prevede un cambiamento massiccio di posa, gli incumbent falliscono completamente nel riformulare il materiale di origine, mentre Imagic ottiene un notevole successo.
I requisiti di risorse e il tempo di addestramento per immagine di Imagic, sebbene brevi rispetto agli standard di tali attività, lo rendono un’inclusione improbabile in un’applicazione di editing locale su computer personali – e non è chiaro in che misura il processo di fine‑tuning possa essere ridotto a livelli consumer.
Al momento, Imagic è un’offerta impressionante più adatta a API – un ambiente in cui Google Research, cauto nei confronti delle critiche relative al facilitare il deepfaking, potrebbe sentirsi più a suo agio.
First published 18th ottobre 2022.


