
Fondamenti di IA
Modelli di Apprendimento Automatico Generativi vs. Discriminativi

 Aggiungi Unite.AI alle tue fonti preferite su Google
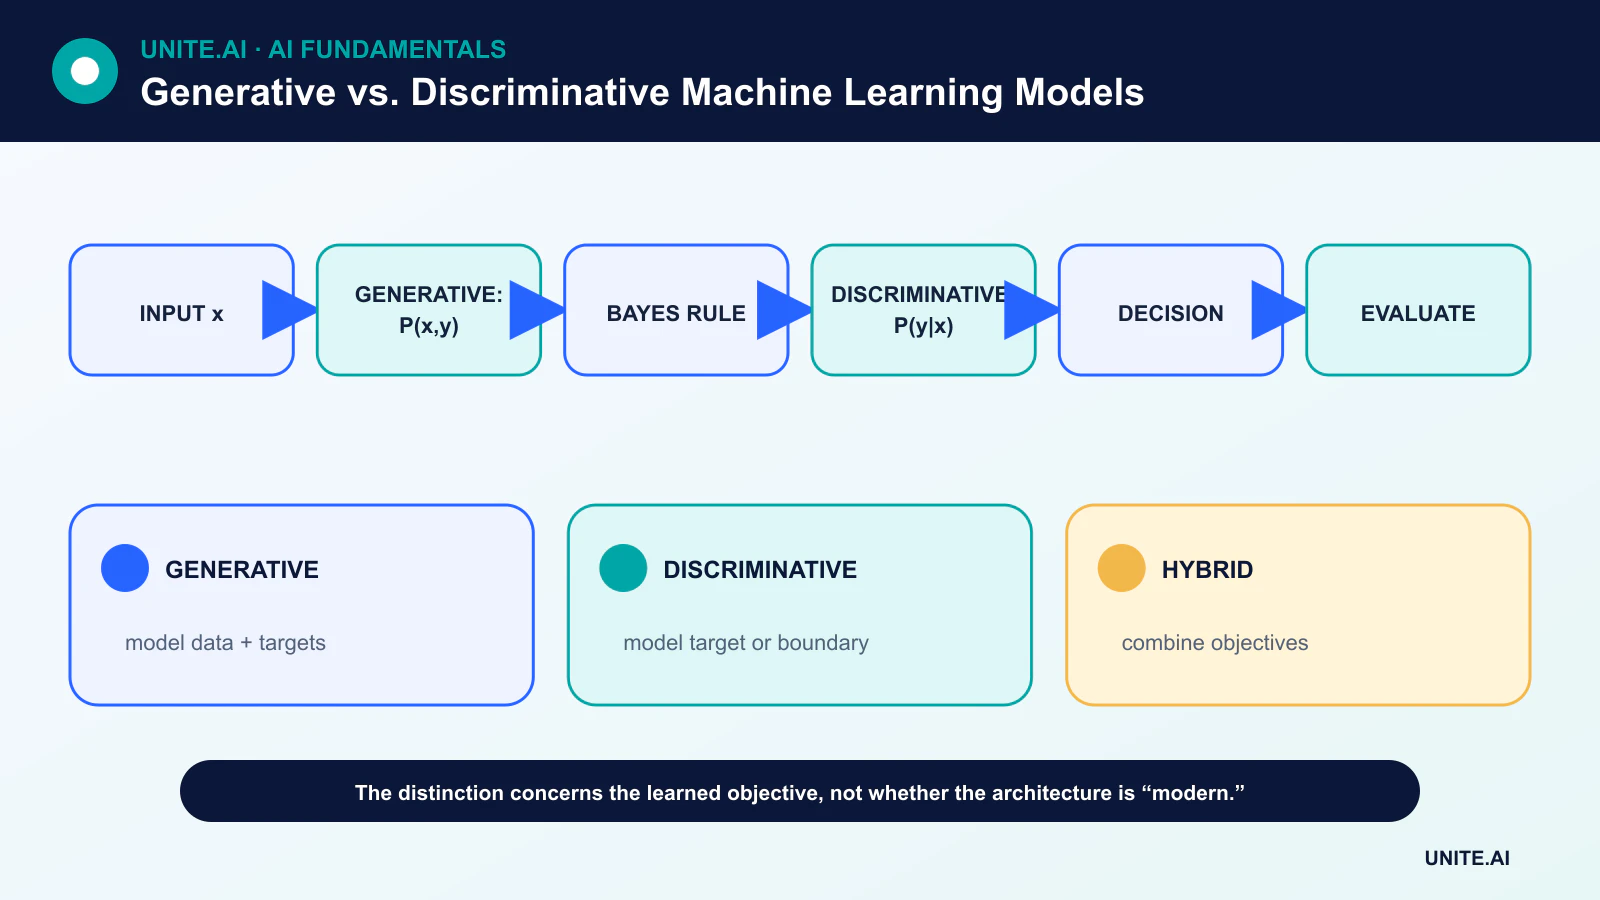
Generativo e discriminativo descrivono ciò che un modello apprende su dati e target. Nella classica classificazione supervisionata, un modello generativo apprende una distribuzione congiunta come P(x, y) o la distribuzione condizionale per classe P(x|y), mentre un modello discriminativo apprende P(y|x) o una frontiera decisionale diretta.
La distinzione è utile, ma i sistemi moderni spesso combinano gli obiettivi. Un modello può apprendere rappresentazioni generative e successivamente essere affinato per la previsione discriminativa, oppure condividere un unico backbone tra generazione e classificazione.
Punti chiave
- I classificatori generativi modellano come nascono gli input e le etichette; i classificatori discriminativi modellano l’etichetta dato l’input o una frontiera.
- Le ipotesi generative possono aiutare con dati etichettati limitati, ma possono anche essere errate.
- I metodi discriminativi spesso concentrano la capacità sul compito di previsione e possono ottenere un errore di classificazione asintotico migliore.
- GAN, VAE e modelli linguistici sono sistemi generativi, ma “generativo” non significa che ogni componente sia un classificatore generativo.
La fattorizzazione della probabilità
Un classificatore generativo può stimare P(x|y) e P(y), quindi utilizzare il teorema di Bayes per derivare P(y|x). Naive Bayes è un classico esempio. Un classificatore discriminativo come la regressione logistica stima direttamente P(y|x); un SVM apprende una frontiera separatrice.
Modellare P(x,y) è un compito più ampio rispetto a prevedere y da x. Tale struttura aggiuntiva può supportare il campionamento o il ragionamento su dati mancanti, ma richiede anche assunzioni sulla distribuzione degli input.
Efficienza dei dati e comportamento asintotico
Il confronto di Ng e Jordan tra Naive Bayes e regressione logistica ha mostrato un compromesso utile: sotto le loro assunzioni, il modello generativo può avvicinarsi alle prestazioni limite con meno esempi, mentre il modello discriminativo può raggiungere un errore asintotico più basso.
Questo non è un ranking universale. I risultati dipendono dal fatto che la famiglia di modelli si adatti ai dati, dalla dimensione, dalla regolarizzazione, dall’ottimizzazione e dalla qualità delle etichette. Un confronto empirico su un design di validazione rappresentativo rimane essenziale.
Famiglie di modelli rappresentative
I modelli generativi includono distribuzioni condizionali per classe, modelli di Markov nascosti, modelli di miscela, auto‑encoder variazionali, modelli linguistici autoregressivi, modelli di diffusione e GAN.
I modelli discriminativi includono regressione logistica, alberi decisionali, campi casuali condizionali, support vector machines e classificatori neurali. Lo stesso backbone neurale può partecipare a entrambe le categorie a seconda dell’obiettivo di addestramento e dell’output.
Sistemi ibridi e auto‑supervisionati
Un modello di linguaggio o di visione pre‑addestrato può apprendere da dati non etichettati con un obiettivo generativo o auto‑supervisionato, per poi ricevere una testa discriminativa per il compito target. I metodi semi‑supervisionati possono ottimizzare contemporaneamente la classificazione etichettata e un obiettivo su dati non etichettati.
L’ibridazione rende le etichette dell’architettura meno informative rispetto all’intero pipeline di addestramento. La documentazione dovrebbe indicare l’obiettivo, i dati, gli output e l’inferenza prevista — non limitarsi a definire un modello “generativo”.
Scegliere tra gli approcci
Usa il compito per decidere. Se l’obiettivo è una frontiera calibrata con abbondanti etichette, un modello discriminativo è una baseline naturale. Se il campionamento, la stima di densità, la struttura dei dati mancanti o i dati non etichettati sono centrali, una componente generativa può aiutare.
Confronta robustezza, efficienza di campionamento, costo computazionale, verosimiglianza o calibrazione secondo necessità. Un buon campione generato non dimostra la bontà di un classificatore, e un classificatore ad alta accuratezza non implica un modello realistico della distribuzione di input.
Direzioni della probabilità e obiettivi di modellazione
Un modello discriminativo apprende una frontiera o una distribuzione condizionale P(y|x): dato il vettore di caratteristiche x, predice l’etichetta y. Regressione logistica, support vector machines, campi casuali condizionali e molti classificatori sono discriminativi. Un modello generativo apprende una distribuzione congiunta P(x,y), una distribuzione condizionale per classe P(x|y) o una distribuzione di dati incondizionata, consentendo il campionamento o compiti legati alla verosimiglianza. Naive Bayes e analisi discriminante lineare sono classificatori generativi; GAN, auto‑encoder variazionali, modelli di diffusione e modelli autoregressivi generano dati tramite obiettivi diversi.
La distinzione riguarda quale distribuzione o regola decisionale viene modellata, non se viene usata una rete neurale. Un modello linguistico generativo può essere “promptato” per classificare, mentre un reranker discriminativo può guidare la generazione. Le ipotesi generative possono migliorare l’efficienza dei dati o gestire variabili mancanti, ma introducono il rischio di misspecificazione del modello. I metodi discriminativi spesso eccellono con dati etichettati abbondanti perché si concentrano direttamente sulla frontiera di previsione. Confronta le famiglie mantenendo pari caratteristiche, dati, sintonizzazione e risorse computazionali, anziché trattare una categoria come universalmente superiore.
Addestramento e valutazione per caso d’uso
La valutazione della classificazione utilizza precisione, richiamo, calibrazione, robustezza e costo dell’errore. La valutazione generativa deve affrontare fedeltà, diversità, copertura, verosimiglianza o utilità del compito, memorizzazione e sicurezza. Un modello può produrre campioni attraenti ma perdere modalità, oppure ottenere buona verosimiglianza con output percettivo scadente. L’utilità dei dati sintetici dovrebbe essere testata addestrando e valutando modelli a valle su dati reali indipendenti, includendo gruppi rari. Mantieni i dati di test fuori dai prompt di generazione e dalla selezione.
Nel learning semi‑supervisionato, un modello generativo può sfruttare la struttura non etichettata; nella rilevazione di anomalie, la verosimiglianza può fallire quando dati fuori distribuzione ricevono alta densità per ragioni irrilevanti. Nella generazione aumentata da recupero, un modello generativo di risposta e un retriever o reranker discriminativo formano un ibrido. Diagnostica le fasi separatamente affinché un output fluente non nasconda un fallimento di recupero. Scegli la decomposizione che rende evidenti le prove e il controllo.
Distribuzione e governance
I sistemi generativi aggiungono rischi di provenienza del contenuto, proprietà intellettuale, impersonificazione, iniezione di prompt e moderazione dell’output; i sistemi discriminativi aggiungono rischi di soglia, negazione e errori disuguali. Entrambi richiedono diritti sui dati, artefatti sicuri, versionamento, test rappresentativi, monitoraggio e autorità umana proporzionale alle conseguenze. Traccia l’obiettivo preciso e la semantica dell’output nella documentazione. Generativo vs. discriminativo è una distinzione statistica utile, ma i sistemi reali li combinano spesso, e l’affidabilità dipende dall’intero pipeline di dati e decisioni.
Esempio pratico: classificare e generare risposte di supporto
Una piattaforma di supporto utilizza un classificatore discriminativo per identificare il tipo di problema e l’urgenza e un modello generativo per redigere una risposta a partire da politiche approvate. Il classificatore è valutato con richiamo specifico per classe e calibrazione; il retriever con richiamo delle evidenze; il generatore con fondatezza, correttezza e rifiuto. Ogni fase ha un risultato incerto, e il modello generativo non può modificare la classificazione o il diritto del cliente tramite testo persuasivo.
Gli operatori vedono il percorso previsto, le fonti e la bozza, e approvano o correggono prima dell’invio. I filtri di autorizzazione si applicano prima del recupero, e l’iniezione di prompt nel testo del cliente non può autorizzare strumenti. Il monitoraggio separa errori di instradamento, lacune di recupero, affermazioni non supportate e modifiche degli operatori. Un cambiamento di policy aggiorna immediatamente le fonti e attiva test di regressione; la sintonizzazione è riservata a comportamenti stabili. Il design ibrido sfrutta i punti di forza discriminativi e generativi preservando le evidenze e l’autorità umana.
Prove di implementazione e prontezza operativa
Una decisione di produzione richiede più di una dimostrazione di successo. Definisci gli utenti target, l’ambiente operativo, gli input, gli output, le dipendenze, il responsabile e le conseguenze di ogni fallimento importante. Stabilisci una baseline riproducibile e un set di valutazione versionato prima della sintonizzazione. Testa casi ordinari, condizioni limite, input malformati o mancanti, spostamenti di distribuzione, interruzioni di dipendenze, usi impropri e i gruppi o ambienti più soggetti a carenze. Misura la qualità del compito insieme a calibrazione o incertezza, latenza, throughput, costo delle risorse, accessibilità, privacy e sicurezza. Registra ogni trasformazione e soglia così che un revisore indipendente possa riprodurre il risultato e distinguere le prove da un prototipo attraente.
Prima del lancio, assegna l’autorità per il rilascio, le eccezioni, le modifiche, il rollback e il ritiro. Usa un rollout a fasi, conserva un fallback sicuro e verifica il monitoraggio con fallimenti iniettati deliberatamente. La telemetria operativa dovrebbe rivelare la qualità dell’input, il comportamento dell’output, la versione del modello o della regola, lo stato di salute delle dipendenze, le override umane e i risultati confermati senza raccogliere dati sensibili non necessari. Definisci soglie di allarme e un responsabile della risposta, poi rivedi le prove reali dopo il deployment anziché presumere che le prestazioni offline persistano. Rivaluta ogni volta che le fonti di dati, gli utenti, i modelli, i fornitori, le politiche, l’hardware o gli obiettivi cambiano. Un sistema mantenuto necessita anche di procedure documentate di recupero, apprendimento dagli incidenti, cancellazione e conservazione, e di un punto chiaro in cui debba essere disattivato o sostituito.
Domande frequenti
Il discriminatore di un GAN è un modello discriminativo?
Esegue la discriminazione durante l’addestramento, ma il GAN nel suo complesso è un framework generativo il cui output è prodotto dal generatore.
L’apprendimento discriminativo è sempre supervisionato?
No. Il termine descrive la relazione o la frontiera modellata, mentre la supervisione descrive il segnale di addestramento. Gli obiettivi moderni possono sfumare le categorie.
Riferimenti principali












