Fondamenti di IA
Programmazione e AI: Un percorso per principianti nell’intelligenza artificiale

 Aggiungi Unite.AI alle tue fonti preferite su Google
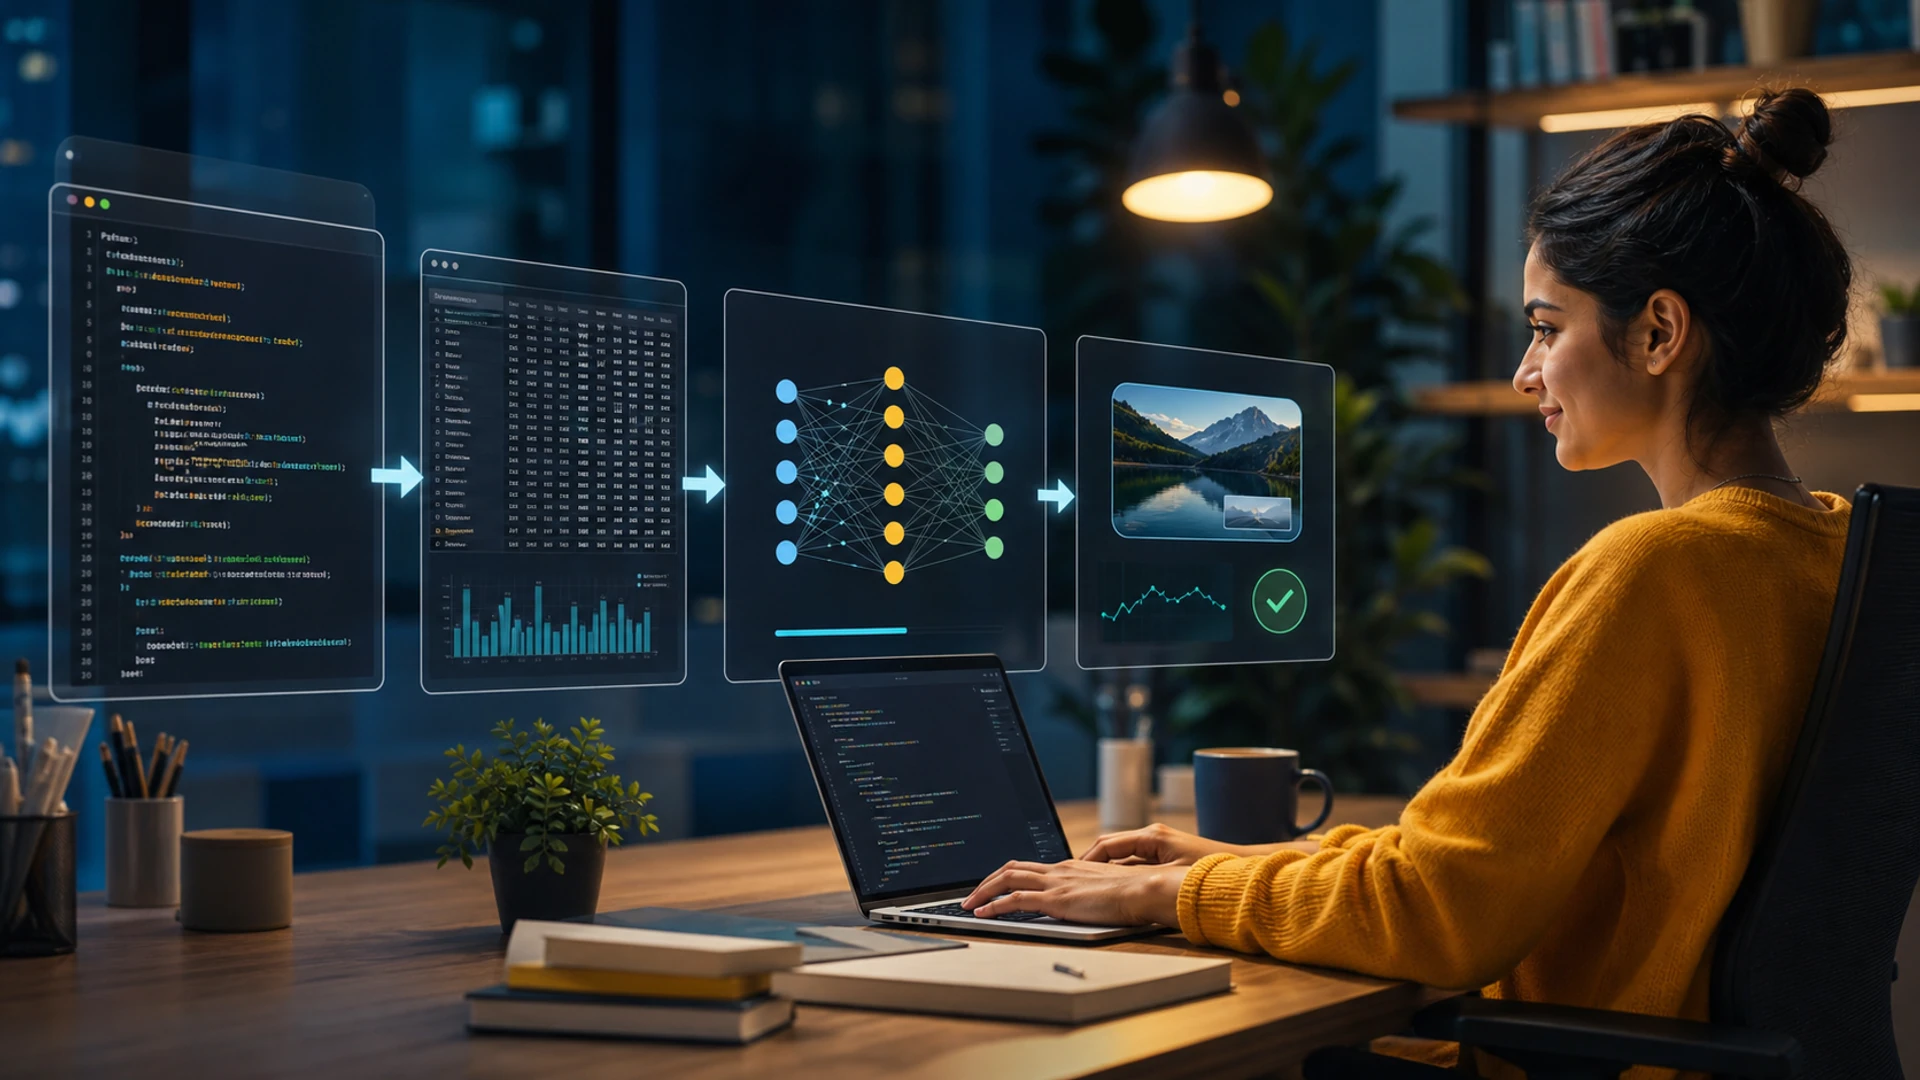
Puoi iniziare a studiare l’IA senza esperienza professionale di programmazione, ma costruire sistemi affidabili richiede alla fine competenze sufficienti di codifica, dati e valutazione per ispezionare ciò che gli strumenti stanno facendo. Il percorso più rapido è una breve sequenza di progetti legati ai fondamenti, piuttosto che un lungo tour di tutorial scollegati.
La programmazione assistita dall’IA può spiegare la sintassi, generare esempi e aiutare nel debug. Considera il suo output come una bozza: eseguilo, testalo, leggi la documentazione e comprendi i dati e le autorizzazioni prima di fidarti di esso.
Punti chiave
- Impara le basi di Python, i notebook, Git, la riga di comando e come leggere gli errori.
- Realizza un piccolo progetto di apprendimento supervisionato prima di passare ad agenti o modelli di grandi dimensioni.
- Utilizza correttamente i dati di addestramento, validazione e test; confrontali con una semplice baseline.
- Consenti all’IA di assistere il ciclo di feedback, ma verifica tu stesso codice, fonti, licenze, sicurezza e risultati.
Fase 1: fondamenti di programmazione
Impara variabili, collezioni, condizioni, cicli, funzioni, moduli, file, ambienti ed eccezioni. Esercitati a leggere un CSV, trasformare record, chiamare un’API documentata, scrivere un test e usare Git per tracciare le modifiche.
Non è necessario possedere una matematica avanzata prima di scrivere codice, ma dovresti apprendere le basi di probabilità, vettori, medie, distribuzioni e grafici man mano che diventano pertinenti. Il pensiero computazionale aiuta a trasformare un obiettivo vago in passaggi verificabili.
Fase 2: un progetto ML completo
Scegli un piccolo dataset pubblico e una chiara domanda di previsione. Esplora i dati, crea una divisione indipendente, costruisci una baseline, addestra un modello semplice, ispeziona gli errori e annota le limitazioni. Usa scikit-learn prima di una rete neurale personalizzata quando è adeguato.
Questo progetto rende concreti i concetti di machine learning: caratteristiche, etichette, leakage, overfitting, metriche, riproducibilità e la differenza tra un punteggio di modello e una decisione utile.
Fase 3: deep learning e modelli linguistici
Impara tensori, batch, loss, discesa del gradiente e backpropagation attraverso un piccolo modello di immagini o testo. Poi utilizza un modello preaddestrato tramite un’API o una libreria open source, registra i prompt e le versioni, e confrontalo con un metodo più semplice.
Esplora l’IA generativa attraverso un’applicazione delimitata con recupero o uso di strumenti. Aggiungi validazione, citazioni, autorizzazioni e fallback affinché il progetto insegni ingegneria dei sistemi oltre al prompting.
Usa gli assistenti di codifica IA in modo deliberato
Richiedi piccole funzioni, test, spiegazioni, casi limite e riferimenti alla documentazione. Esegui controlli statici e test, revisiona le modifiche alle dipendenze e non incollare mai segreti o dati privati senza autorizzazione. Se non riesci a spiegare una riga critica, rallenta.
Un portfolio utile mostra la domanda, i diritti sui dati, la baseline, il metodo, la valutazione, gli errori e cosa miglioreresti. Progetti piccoli, finiti e documentati dimostrano più giudizio rispetto a codice copiato da una grande demo.
Un percorso di apprendimento pratico dal problema al prototipo
Inizia con un compito specifico e un piccolo insieme di esempi rappresentativi anziché con un’ambizione ampia di ‘imparare l’IA’. Classificare messaggi di supporto, estrarre campi di fatture o rispondere a domande da documenti approvati fornisce input e output osservabili. Definisci come dovrebbe apparire un buon risultato prima di scegliere un modello o uno strumento.
Le interfacce no-code possono insegnare il prompting, la preparazione dei dati, la valutazione e la progettazione del flusso di lavoro, ma non eliminano la necessità di giudizio tecnico. Impara tabelle, file, API, autenticazione, variabili, condizioni e statistica di base. questi concetti spiegano come i dati si muovono, perché le integrazioni falliscono e cosa significa (e non significa) il risultato di un modello.
Costruisci una baseline con una regola semplice, un metodo di ricerca, un foglio di calcolo o un piccolo modello. Poi confronta un approccio IA sugli stessi casi di test. Una baseline rivela se la complessità aggiunge valore e fornisce ai principianti un obiettivo di debug concreto. Mantieni i dati di test separati dagli esempi usati per configurare o promptare il sistema.
Prompting, API e la transizione al codice
Un prompt utile indica il compito, il contesto rilevante, le vincoli, lo schema di output e gli esempi quando necessario. Le modifiche al prompt sono modifiche al software: versionale, testale contro un set di valutazione fisso e ispeziona i fallimenti. Non considerare le spiegazioni fluide del modello come prova che la risposta o le evidenze citate siano corrette.
I costruttori di flussi di lavoro collegano le chiamate al modello a moduli, database, file e applicazioni aziendali. Comprendi quali dati ogni fase invia a terze parti, come vengono archiviate le credenziali e cosa accade in caso di timeout o retry. Aggiungi validazione degli input, output strutturati, limiti di velocità, approvazione umana e log prima di utilizzare un prototipo con utenti reali.
Il codice diventa prezioso quando il flusso di lavoro richiede logica personalizzata, test ripetibili, scalabilità, prestazioni, portabilità o controlli di sicurezza dettagliati. Python e JavaScript sono punti di ingresso comuni, ma il linguaggio è meno importante dei fondamenti: funzioni, strutture dati, pacchetti, errori, controllo di versione e test. Usa il codice generato solo dopo averlo letto e eseguito in sicurezza.
Progetti di portfolio, valutazione e sviluppo professionale
Un progetto per principianti solido documenta il problema, gli utenti, le autorizzazioni sui dati, la baseline, l’architettura, il set di valutazione, le metriche, i fallimenti, i rischi e i prossimi passi. Un’interfaccia rifinita senza valutazione dimostra meno di un piccolo esperimento riproducibile. Rimuovi dati privati e segreti prima di pubblicare codice, screenshot, prompt o log.
Valuta il successo del compito piuttosto che l’impressione del modello. La classificazione richiede precisione e recall specifici per classe; l’estrazione richiede accuratezza dei campi; il recupero richiede copertura delle evidenze; la generazione richiede factualità, utilità, sicurezza, latenza e costo. Rivedi le prestazioni su diverse lingue, casi limite e gruppi interessati, e definisci quando un umano deve decidere.
Il lavoro nell’IA comprende product management, expertise di dominio, operazioni sui dati, valutazione, design, sicurezza, policy e gestione del cambiamento oltre allo sviluppo del modello. Acquisisci profondità in un dominio e sufficiente alfabetizzazione tecnica per collaborare tra ruoli. I portfolio credibili spiegano compromessi e limitazioni invece di presentare ogni prototipo come automazione pronta per la produzione.
Esempio pratico: un principiante crea un assistente di triage documenti
Un apprendista raccoglie un piccolo insieme di documenti pubblici o autorizzati e definisce tre categorie più un risultato ‘incerto’. Etichetta gli esempi usando una regola scritta, riserva un set di test e implementa una baseline basata su parole chiave in un foglio di calcolo. Un modello no-code o un’API restituisce quindi una categoria strutturata e una confidenza, che vengono confrontate con gli stessi casi. Esempi errati e ambigui diventano il materiale di apprendimento, non qualcosa di nascosto in una demo.
Il flusso di lavoro accetta un file, estrae il testo, rimuove formati non supportati, chiama il modello con uno schema fisso, valida la risposta e invia i casi incerti per la revisione. Memorizza solo i campi necessari e non include mai credenziali nei prompt o negli screenshot condivisi. L’apprendente registra nome del modello, versione del prompt, latenza, costo e output affinché le modifiche possano essere testate invece di essere giudicate a memoria.
Una descrizione nel portfolio riporta precisione e recall per classe, ipotesi sulla privacy, esempi di fallimento e il confine tra prototipo e produzione. Il prossimo passo di codifica può sostituire un’integrazione manuale fragile con una piccola funzione testata o un’API. Questa progressione insegna competenze trasferibili: definizione del problema, qualità dei dati, valutazione, interfacce, gestione degli errori, sicurezza e comunicazione. Questi fondamenti contano più di affermare di aver costruito un agente sofisticato dopo un unico esempio di successo.
Checklist di implementazione pratica
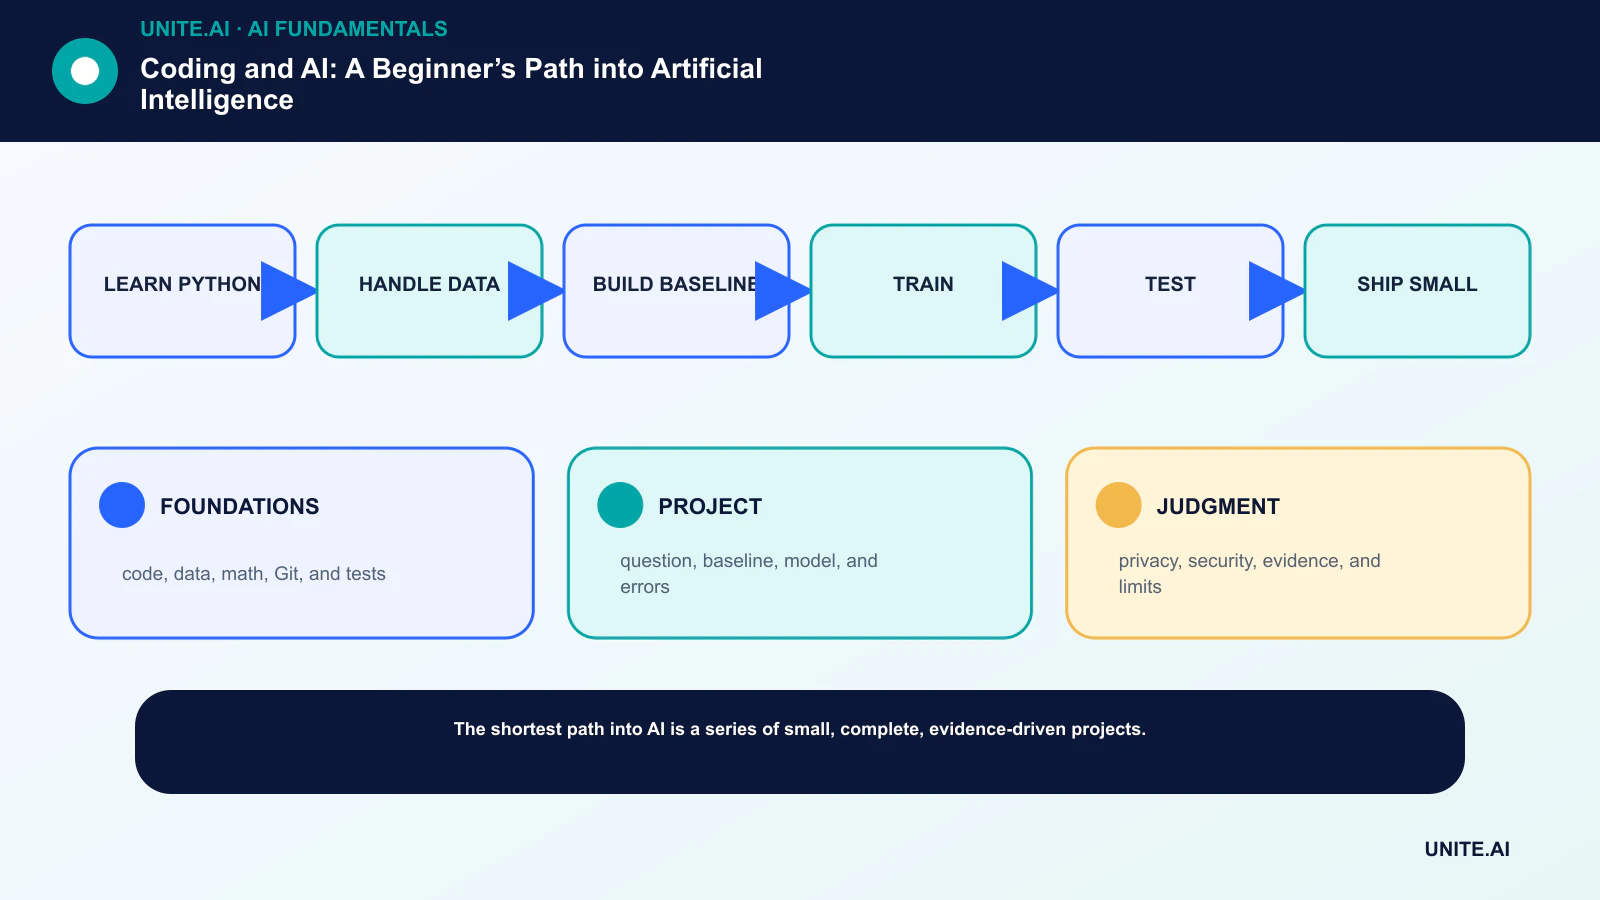
Trasforma il concetto in un flusso di lavoro delimitato e testabile: impara python → gestisci i dati → costruisci una baseline → addestra → testa → rilascia in piccolo. Assegna un responsabile, documenta i dati e le dipendenze, stabilisci una baseline semplice, definisci criteri di accettazione e di interruzione, testa i fallimenti rappresentativi e definisci monitoraggio, rollback e revisione prima di ampliare lo scopo. Registra versioni e ipotesi affinché un altro team possa riprodurre il risultato e capire cosa è cambiato.
Prima del lancio, esegui una revisione di prontezza documentata con le persone che costruiscono, gestiscono, mettono in sicurezza e sono interessate dal sistema. Testa casi normali, condizioni di confine, fallimenti di dipendenze e usi impropri; conserva le evidenze e i rischi non risolti. Definisci chi può approvare il rilascio, modificare una soglia, sovrascrivere un output o interrompere l’operazione. Rivedi la decisione quando arrivano dati reali, perché un pilota tecnicamente riuscito non garantisce prestazioni affidabili su scala più ampia.
- FONDAMENTI: codice, dati, matematica, Git e test.
- PROGETTO: domanda, baseline, modello e errori.
- GIUDIZIO: privacy, sicurezza, evidenze e limiti.
Domande frequenti
Devo avere una laurea in informatica per lavorare nell’IA?
No. I ruoli includono ingegneria, ricerca, prodotto, design, operazioni, dati, valutazione, policy e competenza di dominio. Ognuno richiede un diverso livello di programmazione.
Quale linguaggio di programmazione dovrebbe imparare un principiante?
Python è una scelta pratica iniziale perché la sua sintassi è accessibile e il suo ecosistema di dati e ML è ampio. Le competenze di problem solving di base si trasferiscono ad altri linguaggi.
Riferimenti principali