Dasar-dasar AI
Apa itu Transfer Learning?

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
Transfer learning menggunakan kembali pengetahuan yang dipelajari untuk satu masalah guna meningkatkan pembelajaran pada masalah yang terkait. Alih‑alih menginisialisasi setiap parameter secara acak, seorang praktisi memulai dari model atau representasi yang telah dilatih sebelumnya dan menyesuaikannya dengan tugas target.
Pendekatan ini sangat berguna ketika dataset target kecil, pelabelan mahal, atau pra‑pelatihan membutuhkan komputasi lebih banyak daripada yang dapat dibenarkan oleh tim target. Melatih model dari awal adalah alternatif dari transfer learning—bukan jenis transfer learning.
Poin-poin utama
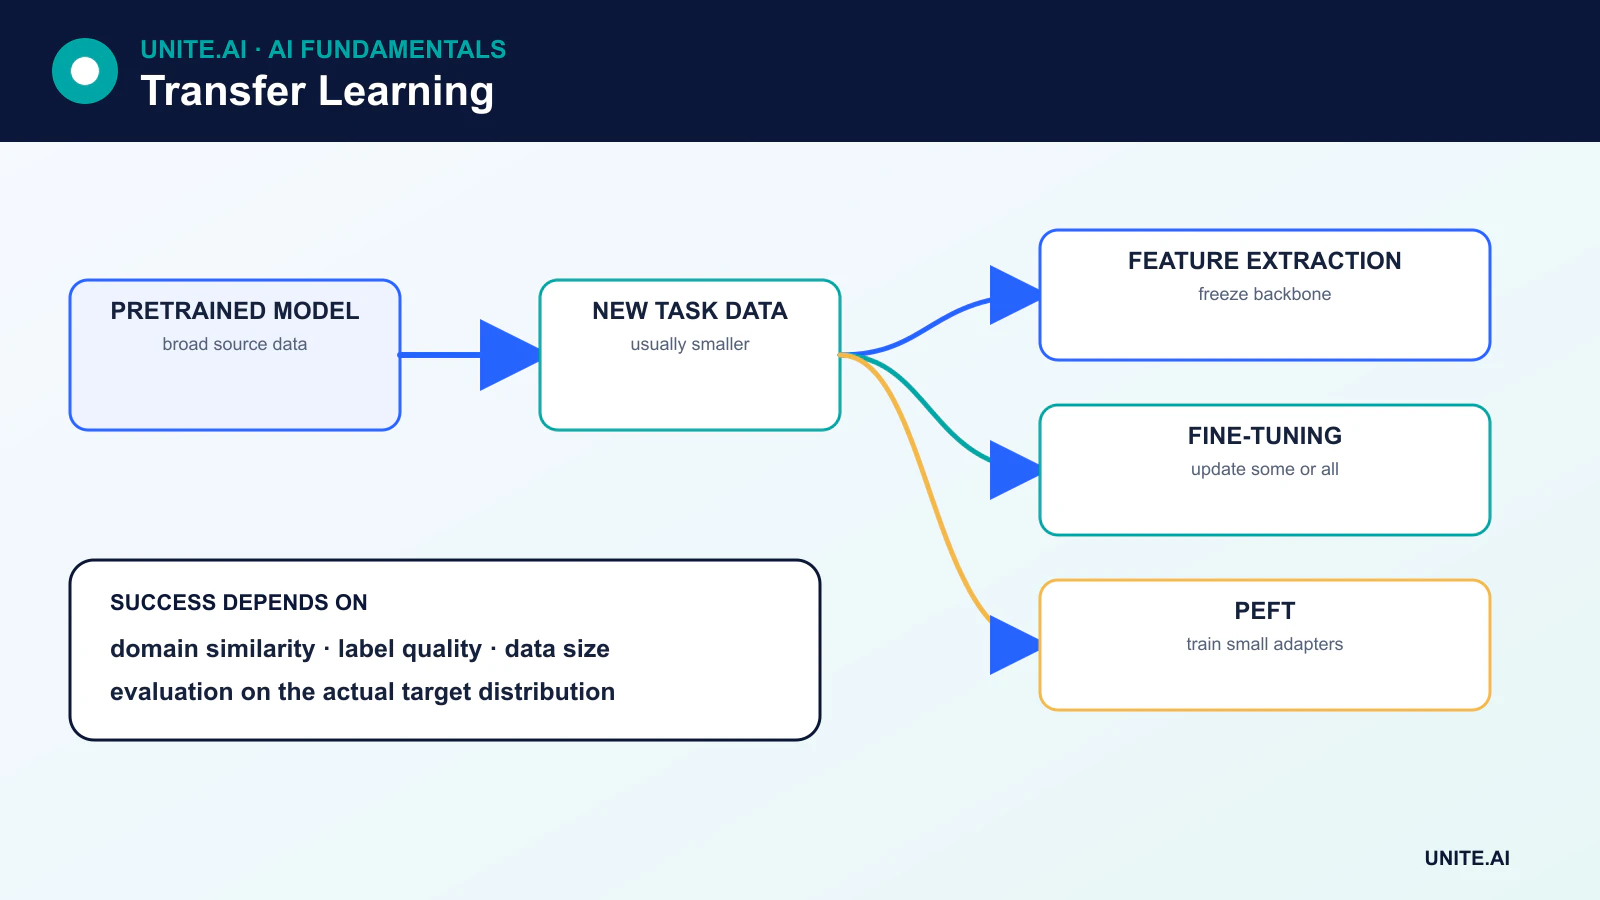
- Ekstraksi fitur menjaga basis yang telah dilatih sebelumnya tetap beku dan melatih kepala baru yang spesifik untuk tugas.
- Fine‑tuning memperbarui sebagian atau seluruh parameter yang telah dilatih sebelumnya menggunakan data domain target.
- Metode efisien parameter seperti adapter dan LoRA memperbarui sebagian kecil model.
- Transfer dapat gagal ketika domain sumber dan target berbeda, lisensi berbenturan, atau model sumber mengandung bias yang tidak cocok.
Mengapa transfer learning berhasil
Model seringkali mempelajari representasi yang berguna di luar data tepat yang mereka latih. Lapisan awal dari model gambar dapat menangkap pola lokal yang dapat digunakan kembali; model bahasa dapat mempelajari sintaks, semantik, dan asosiasi luas dari prediksi self‑supervised. Tugas target dapat membangun di atas representasi tersebut alih‑alih mempelajari semuanya kembali dari contoh terbatas.
Manfaatnya bergantung pada kesamaan antara tugas sumber dan target, skala serta kualitas pra‑pelatihan, dan cara model disesuaikan. Penggunaan kembali tidak dijamin: fitur yang dipindahkan dapat tidak relevan atau bahkan merugikan.
Ekstraksi fitur
Dalam ekstraksi fitur, basis yang telah dilatih sebelumnya dibekukan sehingga parameternya tidak berubah. Output‑nya menjadi input bagi classifier, regressor, atau kepala tugas‑spesifik baru. Hanya kepala baru yang dilatih.
Ini cepat dan efisien data, serta mengurangi risiko merusak representasi pra‑latih yang berguna. Namun dapat mengalami underfit ketika domain target berbeda secara signifikan dari pra‑pelatihan. Lapisan seperti batch normalization memerlukan perhatian khusus karena statistik yang disimpan dan perilaku pelatihan dapat memengaruhi adaptasi meskipun sebagian besar bobot dibekukan.
Fine‑tuning
Fine-tuning memperbarui parameter pra‑latih pada data target. Alur kerja umum adalah:
- Muat model pra‑latih dan ganti atau tambahkan kepala output.
- Bekukan basis dan latih kepala baru.
- Lepaskan beku pada lapisan terpilih—atau seluruh model—dan lanjutkan dengan laju belajar yang lebih kecil.
- Validasi untuk overfitting, pelupaan, dan kinerja domain target.
Tidak ada aturan universal bahwa hanya lapisan akhir yang harus disetel. Pilihan terbaik bergantung pada arsitektur, ukuran data target, kesamaan domain, lapisan normalisasi, memori, dan komputasi. Fine‑tuning penuh dapat memberikan kapasitas lebih tetapi memerlukan lebih banyak sumber daya dan dapat menyebabkan pelupaan katastrofik.
Fine‑tuning efisien parameter
Transformer besar transformer membuat fine‑tuning penuh menjadi mahal. Fine‑tuning efisien parameter (PEFT) memodifikasi atau menambahkan sejumlah kecil parameter sambil membiarkan sebagian besar model dasar tetap beku.
- Adapters menyisipkan modul kecil yang dapat dilatih ke dalam jaringan.
- LoRA merepresentasikan pembaruan bobot dengan matriks berperingkat rendah, mengurangi parameter yang dapat dilatih dan memori optimizer.
- Prompt and prefix tuning mempelajari masukan kontinu yang spesifik tugas atau prefiks internal.
PEFT dapat menyimpan banyak adaptasi tugas di sekitar satu model dasar, meskipun penyajian inferensi, kompatibilitas adapter, dan manajemen bobot gabungan tetap memerlukan rekayasa yang cermat.
Transfer learning lintas tipe data
Klasifier gambar biasanya dimulai dari model yang telah dilatih pada dataset gambar besar. Sistem bahasa dimulai dari model fondasi dan menyesuaikannya melalui fine‑tuning terawasi, optimisasi preferensi, pencarian kembali, atau penggunaan alat. Model suara, audio, protein, dan multimodal mengikuti pola serupa.
Transfer juga dapat terjadi tanpa mengubah model asli. Model beku dapat menghasilkan embedding untuk classifier hilir, sistem pencarian kemiripan vektor, atau pipeline pencarian kembali.
Pergeseran domain dan transfer negatif
Domain shift terjadi ketika masukan target berbeda dari data sumber. Misalnya, model gambar medis dapat menemui peralatan, populasi, atau protokol akuisisi yang tidak ada dalam pra‑pelatihan. Transfer negatif berarti penggunaan kembali membuat kinerja target lebih buruk daripada baseline yang dibangun dari awal yang sesuai.
Tim harus membandingkan strategi adaptasi, mengevaluasi subkelompok yang bermakna, dan menjaga set tes domain target. Jika tugas sumber tidak cocok, model spesifik domain yang lebih kecil dapat mengungguli model umum yang lebih besar.
Lisensi, asal‑usul, dan keamanan
Model yang dapat diunduh tidak otomatis aman untuk dipasang. Tinjau lisensi, penggunaan yang diizinkan, pengungkapan data pelatihan, batasan kartu model, dan rantai ketergantungan. Model dapat mereproduksi bias, mengingat data sensitif, atau berisi kode berseri yang berbahaya. Gunakan format tepercaya, pindai artefak, dan muat bobot yang tidak tepercaya dalam lingkungan terisolasi.
Kapan menggunakan transfer learning
Transfer learning menjadi pilihan default yang kuat ketika model pra‑latih yang relevan ada dan data target terbatas. Melatih dari awal mungkin lebih disukai ketika domain sangat khusus, lisensi tidak kompatibel, ukuran model melebihi batas penyebaran, atau tugas sederhana tidak mendapat manfaat dari representasi pra‑latih yang besar. Keputusan harus divalidasi secara empiris, bukan diasumsikan dari skala model.
Apa yang dapat ditransfer dan bagaimana menyesuaikannya
Transfer learning menggunakan kembali representasi yang dipelajari pada tugas atau dataset sumber untuk tugas target. Pada visi, fitur awal sering menangkap tepi dan tekstur; pada bahasa, model pra‑latih menyandi pola statistik di seluruh token dan konteks. Transfer berhasil ketika representasi sumber mengandung informasi yang relevan bagi target, namun perbedaan domain, label, modalitas, dan akuisisi dapat menghasilkan transfer negatif. Mulailah dengan baseline pra‑latih, periksa lisensi pelatihan dan dokumentasinya, serta bandingkan dengan melatih model kecil yang spesifik untuk target dari awal.
Ekstraksi fitur membekukan backbone dan melatih kepala baru; fine‑tuning parsial membuka beku pada lapisan terpilih; fine‑tuning penuh memperbarui seluruh model. Metode efisien parameter menambahkan adapter atau pembaruan berperingkat rendah, mengurangi parameter yang dapat dilatih tetapi tidak selalu mengurangi memori inferensi. Gunakan laju belajar yang lebih rendah untuk bobot pra‑latih, pertahankan perilaku normalisasi, dan hindari pelupaan katastrofik dengan jadwal, regularisasi, rehearsal, atau pembaruan terbatas bila diperlukan. Pilih checkpoint pada data validasi target dan uji beberapa seed karena dataset target kecil menghasilkan varians tinggi.
Pertukaran data, evaluasi, dan penyebaran
Data target harus mewakili kondisi penyebaran dan subkelompok penting, bukan sekadar sampel berlabel yang mudah. Bagi berdasarkan subjek, sumber, waktu, atau lokasi untuk mencegah contoh terkait melintasi partisi. Uji baik dalam kondisi dalam‑domain maupun bergeser. Bandingkan varian beku, parsial, dan penuh pada kualitas, kalibrasi, biaya pelatihan, latensi, dan ketahanan. Peningkatan skor rata‑rata dapat menyembunyikan penurunan pada kelas langka yang diwarisi dari bias sumber. Tinjau contoh kegagalan untuk jalan pintas spesifik sumber, kesenjangan kosakata, atau perbedaan sensor.
Lacak model dasar, bobot, tokenizer atau preprocessing, adapter, data, dan lisensi sebagai satu grafik ketergantungan. Model dasar yang dihosting dapat mengubah perilaku; bobot terbuka dapat memperkenalkan tanggung jawab rantai pasokan dan patching. Validasi artefak yang digabung atau diekspor dan pindai file model dari sumber yang tidak tepercaya. Dalam produksi, pantau drift target dan kinerja, serta pertahankan kemampuan untuk mengembalikan baik adaptasi maupun versi dasar. Transfer mengurangi data target yang diperlukan; namun tidak menghilangkan kebutuhan pelabelan, evaluasi, privasi, atau keahlian domain.
Contoh kerja: menyesuaikan model visi ke klinik baru
Sebuah klinik menyesuaikan encoder pencitraan yang telah dilatih sebelumnya untuk mengklasifikasikan kualitas gambar sebelum tinjauan diagnostik. Klinik memverifikasi lisensi model sumber dan modalitas yang dimaksud, mengumpulkan perangkat lokal serta kondisi akuisisi, dan membagi data berdasarkan pasien. Varian fitur beku, adapter, parsial, dan fine‑tuning penuh dibandingkan dengan baseline lokal kecil. Metrik meliputi recall kelas, kalibrasi, perilaku subkelompok, komputasi, dan sensitivitas terhadap perangkat, lokasi, serta artefak langka.
Model yang disesuaikan tidak dapat membuat diagnosis dan mengarahkan gambar dengan kepercayaan rendah atau tidak didukung ke teknolog. Validasi ekspor mengonfirmasi preprocessing lokal dan kesetaraan numerik. Versi model, adapter, perangkat, dan dataset dihubungkan dalam catatan. Pemantauan mendeteksi pemindai baru, perubahan protokol, dan drift output, sementara sampel yang ditinjau secara berkala memperkirakan kinerja nyata. Peningkatan model sumber diperlakukan sebagai ketergantungan baru yang memerlukan validasi; transfer learning tidak secara otomatis membenarkan penggunaan kembali bukti lama.
Bukti implementasi dan kesiapan operasional
Keputusan produksi memerlukan lebih dari sekadar demonstrasi yang berhasil. Tentukan pengguna yang dimaksud, lingkungan operasional, masukan, keluaran, ketergantungan, pemilik, dan konsekuensi setiap kegagalan penting. Bangun baseline yang dapat direproduksi dan set evaluasi berversi sebelum penyetelan. Uji kasus biasa, kondisi batas, masukan yang rusak atau hilang, pergeseran distribusi, gangguan ketergantungan, penyalahgunaan, serta kelompok atau lingkungan yang paling mungkin kurang terlayani. Ukur kualitas tugas bersama dengan kalibrasi atau ketidakpastian, latensi, throughput, biaya sumber daya, aksesibilitas, privasi, dan keamanan. Catat setiap transformasi dan ambang batas sehingga peninjau independen dapat mereproduksi hasil dan membedakan bukti dari prototipe yang menarik.
Sebelum peluncuran, tetapkan otoritas untuk rilis, pengecualian, perubahan, rollback, dan pensiun. Gunakan peluncuran bertahap, pertahankan fallback yang aman, dan verifikasi pemantauan dengan kegagalan yang disuntikkan secara sengaja. Telemetri operasional harus mengungkap kualitas masukan, perilaku keluaran, versi model atau aturan, kesehatan ketergantungan, intervensi manusia, dan hasil yang dikonfirmasi tanpa mengumpulkan data sensitif yang tidak perlu. Tentukan ambang batas peringatan dan pemilik respons, kemudian tinjau bukti dunia nyata setelah penyebaran alih‑alih mengasumsikan kinerja offline akan bertahan. Evaluasi kembali setiap kali sumber data, pengguna, model, vendor, kebijakan, perangkat keras, atau tujuan berubah. Sistem yang dipelihara juga memerlukan prosedur pemulihan terdokumentasi, pembelajaran insiden, penghapusan dan retensi, serta titik yang jelas di mana sistem harus dinonaktifkan atau diganti.
Referensi utama