
AGI dan AI masa depan
Apa Itu Tes Turing dan Mengapa Itu Penting?

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
Turing test muncul dari makalah Alan Turing tahun 1950 “Computing Machinery and Intelligence.” Alih‑alih berusaha mendefinisikan pemikiran, Turing mengusulkan permainan imitasi: seorang interogator manusia menukar pesan tertulis dengan peserta yang tidak terlihat dan menilai mana yang manusia dan mana yang mesin.
Tes ini tetap berpengaruh karena mengubah pertanyaan filosofis abstrak menjadi interaksi yang dapat diamati. Namun ia juga terbatas: tampak manusia dalam percakapan tidak sama dengan menjadi jujur, berpengetahuan, aman, sadar, atau secara umum cerdas.
Poin-poin utama
- Permainan imitasi asli Turing adalah tes perilaku berbasis teks, bukan daftar periksa sifat kognitif internal.
- Hasil bergantung pada evaluator, prompt, durasi, instruksi peserta, dan aturan penilaian.
- Sebuah model dapat meniru percakapan manusia sambil mengarang fakta atau gagal pada tes ketahanan sederhana.
- Evaluasi modern memerlukan metrik tugas, pengujian adversarial, tinjauan manusia, dan bukti spesifik risiko selain percakapan.
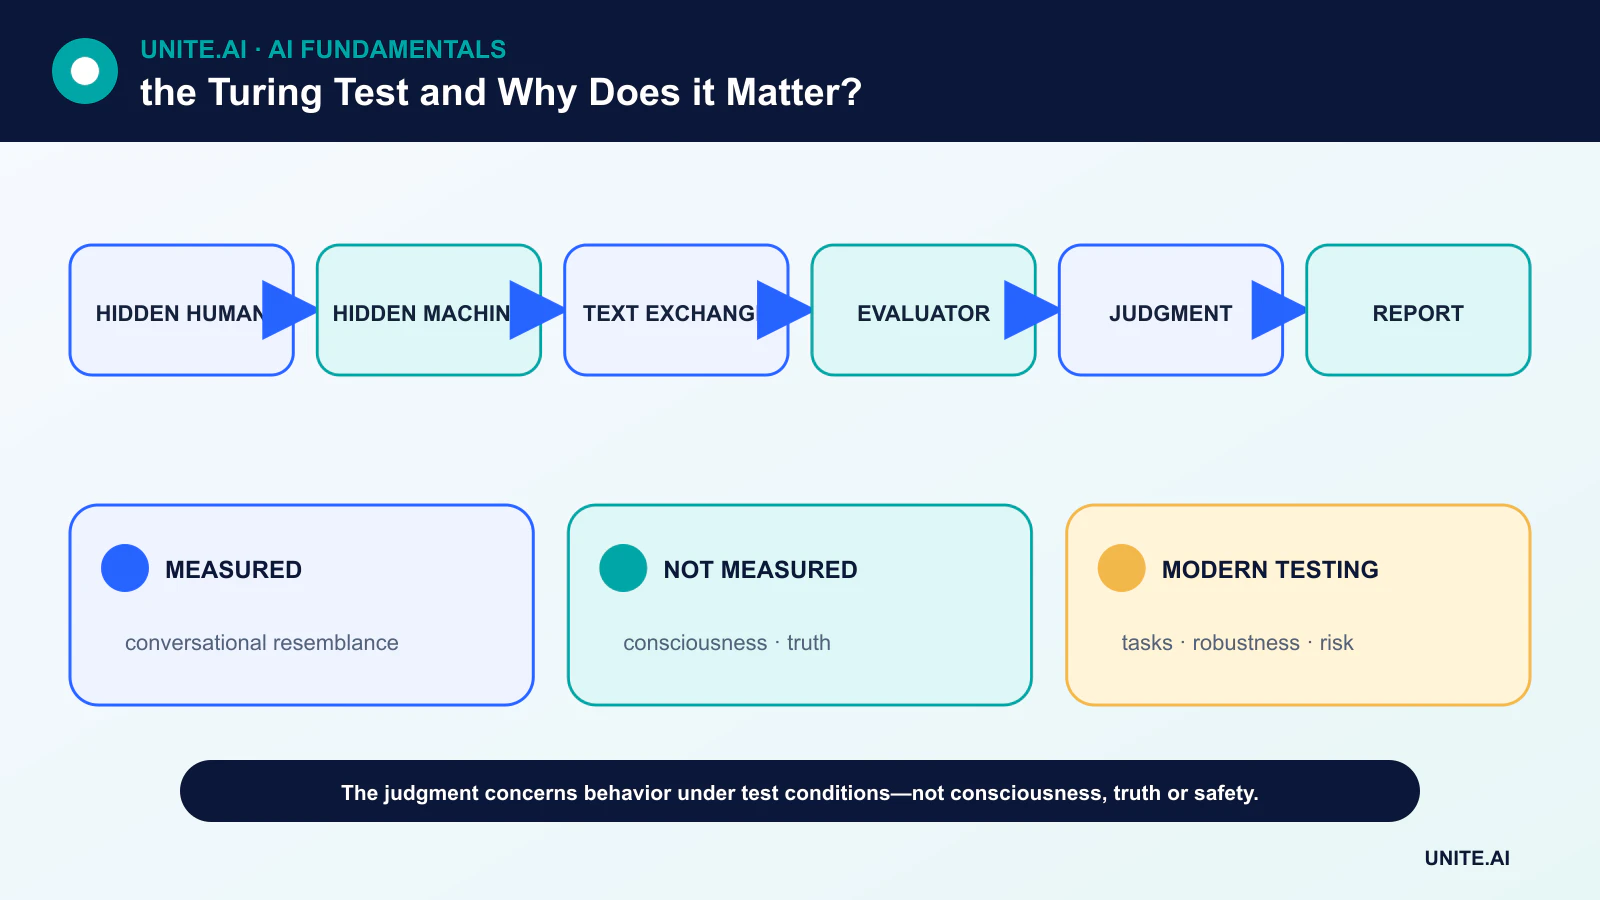
Permainan imitasi Turing
Dalam pengaturan asli, seorang interogator berkomunikasi dari jarak jauh sehingga suara dan penampilan tidak mengungkapkan identitas. Turing menanyakan apakah sebuah mesin dapat tampil cukup baik dalam permainan sehingga evaluator tidak dapat secara andal membedakannya dari manusia.
Kerangka operasional ini menghindari kebutuhan untuk menetapkan satu definisi berpikir. Ia tidak mengklaim bahwa setiap pertukaran yang meyakinkan membuktikan kecerdasan, juga tidak menentukan ambang batas lulus universal yang berlaku untuk demonstrasi chatbot selanjutnya.
Apa yang sebenarnya diukur oleh hasil
Sebuah percobaan mengukur ketidakmampuan membedakan perilaku di bawah kondisi yang ditentukan. Percakapan singkat, hakim yang tidak berpengalaman, atau prompt yang dipilih oleh pembuat sistem dapat mempermudah tugas. Laporan yang ketat harus mengungkapkan pemilihan transkrip, jumlah dan latar belakang hakim, manusia pembanding, batas waktu, dan metode statistik.
Sebuah sistem juga dapat memanfaatkan ekspektasi: menghindar, humor, kesalahan tipografi, dan peran dapat tampak manusiawi tanpa menunjukkan penalaran yang dapat diandalkan. Sebaliknya, respons manusia yang sangat formal dapat salah diklasifikasikan sebagai buatan mesin.
Apa yang tidak ditetapkan oleh tes Turing
Tes ini tidak secara langsung mengukur kesadaran, pengalaman subjektif, akurasi fakta, pemahaman kausal, atau agensi moral. Ia tidak mengungkapkan data pelatihan, arsitektur model, atau mode kegagalan di luar percakapan. Ia juga memberikan sedikit informasi tentang kecerdasan non‑linguistik seperti manipulasi fisik.
Sistem bahasa modern dibangun dengan transformer neural networks dan deep learning, namun keluaran mereka yang fasih masih dapat dihasilkan dari struktur statistik yang dipelajari, bukan dari model dunia yang terverifikasi.
Bagaimana evaluasi AI modern memperluas pertanyaan
Evaluasi kontemporer menggunakan set tugas yang ditahan, ketidakpastian terkalibrasi, tes ketahanan, red teaming, pemeriksaan faktualitas, dan studi preferensi manusia. Metrik text-classification dapat menguji perilaku yang didefinisikan, sementara evaluasi berbasis skenario dapat menguji apakah sistem mengikuti kebijakan di bawah tekanan.
Tidak ada satu benchmark pun yang mencakup semua penerapan. Kontaminasi tes dapat meningkatkan skor, dan benchmark statis mendorong overfitting. Evaluasi harus diulang seiring perubahan model, data, prompt, alat, dan populasi pengguna.
Mengapa tes ini masih penting
Tes Turing mengantisipasi pelajaran inti evaluasi AI: menilai kemampuan yang dapat diamati daripada bergantung pada klaim tentang esensi internal. Ia juga memaksa kita menanyakan perilaku manusia mana yang dihitung sebagai bukti dan bagaimana pengaturan eksperimen membentuk kesimpulan.
Penggunaan modern terbaiknya adalah sebagai dasar historis dan konseptual. Lulus dalam permainan imitasi dapat menarik, namun keputusan penerapan memerlukan bukti yang terkait dengan tugas nyata, pengguna yang terpengaruh, dan potensi bahaya yang dapat diperkirakan.
Apa yang diukur oleh Tes Turing
Permainan imitasi Alan Turing menanyakan apakah seorang interogator yang berkomunikasi melalui teks dapat secara andal membedakan mesin dari manusia. Ia mengubah debat abstrak tentang apakah mesin berpikir menjadi eksperimen percakapan yang dapat diamati. Tes ini bergantung pada peserta, durasi, protokol, topik, dan aturan penilaian; tidak ada satu skor universal. Lulus berarti menghasilkan respons yang mirip manusia dalam pengaturan tersebut. Ia tidak secara langsung mengukur akurasi fakta, penalaran, kesadaran, otonomi, persepsi, perwujudan, keandalan, atau perilaku dunia nyata yang bermanfaat.
Peniruan manusia dapat memberi penghargaan pada penghindaran, persona, kesalahan, humor, atau manipulasi. Seorang hakim dapat salah mengira manusia sebagai mesin atau dipengaruhi oleh ekspektasi, bahasa, dan konteks budaya. Percakapan singkat memungkinkan trik yang gagal pada interaksi berkelanjutan. Sebaliknya, sistem yang sangat berguna untuk matematika, terjemahan, atau pemodelan protein mungkin gagal karena tidak berpura‑pura menjadi manusia. Oleh karena itu, tes ini mengukur kemampuan sosial dan linguistik yang dibentuk oleh evaluator, bukan urutan lengkap kecerdasan.
Model bahasa modern dan evaluasi yang lebih kuat
Model bahasa besar dapat mempertahankan dialog fasih dengan memprediksi urutan dari data pelatihan yang luas dan penyesuaian selanjutnya, namun kefasihan merupakan bukti lemah tentang kebenaran atau pemahaman. Pola yang dihafal, akses alat, prompt tersembunyi, latensi, dan pengaturan sampling memengaruhi hasil. Evaluasi terkontrol harus mengungkapkan model dan protokol, mencegah kebocoran informasi, menyertakan pertanyaan adversarial dan domain, serta menilai ketidakpastian dan sitasi. Demonstrasi yang dipilih dari percakapan sukses tidak dapat memperkirakan keandalan di seluruh distribusi penggunaan.
Evaluasi modern bersifat multidimensi: akurasi tugas, kalibrasi, ketahanan, konsistensi jangka panjang, keamanan, bias, privasi, keamanan, efisiensi, dan hasil bagi manusia. Tes perilaku harus dilengkapi dengan bukti proses, red teaming, benchmark yang dapat direproduksi, dan pemantauan dunia nyata. Benchmark dapat jenuh atau masuk ke data pelatihan, sehingga diperlukan set tes pribadi dan yang diperbarui. Untuk sistem yang beraksi, evaluasi izin alat, pemulihan, dan konsekuensi secara terpisah dari kualitas percakapan.
Mengapa tes ini masih penting
Tes Turing tetap penting secara historis karena menitikberatkan pada perilaku dan kesulitan mendefinisikan kecerdasan. Ia juga menimbulkan pertanyaan berkelanjutan tentang antropomorfisme dan penipuan. Antarmuka harus mengidentifikasi agen sintetis alih‑alih menganggap identitas yang keliru sebagai keberhasilan, terutama dalam konteks yang berdampak. Gunakan tes ini sebagai lensa filosofis dan satu evaluasi percakapan, bukan sebagai sertifikasi kecerdasan umum atau kepribadian. Pertanyaan penting dalam penerapan adalah apa yang dapat dilakukan sistem secara andal, dengan bukti dan batas apa, serta siapa yang bertanggung jawab ketika gagal.
Contoh kerja: evaluasi percakapan terkontrol
Evaluator membandingkan manusia dan beberapa sistem AI dalam percakapan teks dengan durasi, topik, bahasa, dan identitas yang dibutakan secara tetap. Hakim mencatat apakah mereka percaya setiap peserta adalah manusia serta menilai faktualitas, konsistensi, kegunaan, ketidakpastian, dan manipulasi. Beberapa hakim dan percakapan memperkirakan variasi, dan protokol mencegah pengembang model memilih transkrip yang menguntungkan. Salah klasifikasi manusia memberikan dasar yang diperlukan untuk menafsirkan hasil.
Sistem yang menipu hakim tetapi mengarang fakta tidak dinyatakan cerdas secara umum, sementara model spesialis yang jelas diungkapkan dapat sangat berguna meskipun gagal meniru. Hasil mencakup prompt, model, sampler, akses alat, dan karakteristik hakim. Eksperimen ini dibingkai sebagai satu tes percakapan mirip manusia. Keputusan penerapan menggunakan bukti terpisah untuk kebenaran tugas, keamanan, privasi, dan pemulihan, serta antarmuka mengidentifikasi agen alih‑alih menjadikan penipuan sebagai tujuan produk.
Bukti implementasi dan kesiapan operasional
Keputusan produksi memerlukan lebih dari sekadar demonstrasi yang berhasil. Tentukan pengguna yang dituju, lingkungan operasional, masukan, keluaran, ketergantungan, pemilik, dan konsekuensi setiap kegagalan penting. Bangun baseline yang dapat direproduksi dan set evaluasi berversi sebelum penyesuaian. Uji kasus biasa, kondisi batas, masukan yang rusak atau hilang, pergeseran distribusi, kegagalan ketergantungan, penyalahgunaan, serta kelompok atau lingkungan yang paling mungkin kurang terlayani. Ukur kualitas tugas bersama dengan kalibrasi atau ketidakpastian, latensi, throughput, biaya sumber daya, aksesibilitas, privasi, dan keamanan. Catat setiap transformasi dan ambang batas sehingga peninjau independen dapat mereproduksi hasil dan membedakan bukti dari prototipe yang menarik.
Sebelum peluncuran, tetapkan otoritas untuk rilis, pengecualian, perubahan, rollback, dan pensiun. Gunakan peluncuran bertahap, pertahankan fallback yang aman, dan verifikasi pemantauan dengan kegagalan yang sengaja disuntikkan. Telemetri operasional harus mengungkapkan kualitas masukan, perilaku keluaran, versi model atau aturan, kesehatan ketergantungan, intervensi manusia, dan hasil yang dikonfirmasi tanpa mengumpulkan data sensitif yang tidak diperlukan. Tentukan ambang batas peringatan dan pemilik respons, kemudian tinjau bukti dunia nyata setelah penerapan alih‑alih mengasumsikan kinerja offline akan bertahan. Evaluasi kembali setiap kali sumber data, pengguna, model, vendor, kebijakan, perangkat keras, atau tujuan berubah. Sistem yang dipelihara juga memerlukan prosedur pemulihan, pembelajaran insiden, penghapusan dan retensi yang terdokumentasi, serta titik jelas kapan harus dinonaktifkan atau diganti.
Pertanyaan yang sering diajukan
Apakah ada AI yang secara definitif lulus tes Turing?
Tidak ada otoritas tes resmi tunggal atau protokol yang diterima secara universal. Demonstrasi publik menggunakan aturan yang berbeda, sehingga klaim “lulus” tidak dapat dibandingkan secara langsung.
Apakah gagal dalam tes membuktikan bahwa sistem tidak cerdas?
Tidak. Sistem khusus dapat sangat mampu tanpa meniru gaya percakapan manusia.
Referensi utama












