
Dasar-dasar AI
Apa itu Operasi TI (ITOps)?

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
IT operations (ITOps) adalah pekerjaan menjalankan layanan teknologi yang menjadi andalan organisasi. Ini mencakup komputasi, jaringan, identitas, endpoint, platform cloud, basis data, penyimpanan, cadangan, serta proses operasional yang menjaga komponen tersebut tersedia, aman, dan dapat didukung.
ITOps modern tidak terbatas pada pusat operasi jaringan yang hanya memantau dasbor. Tim semakin banyak mengelola infrastruktur berbasis perangkat lunak, layanan platform, otomatisasi, dan kepemilikan terdistribusi sambil tetap bertanggung jawab atas insiden, kapasitas, kesinambungan, dan tingkat layanan.
Poin-poin utama
- ITOps mengelola layanan dan ketergantungannya di lingkungan on-premises, cloud, dan edge.
- Observabilitas, konfigurasi, dan inventaris menyediakan konteks yang diperlukan untuk menafsirkan kegagalan.
- Manajemen insiden memulihkan layanan; manajemen masalah menangani penyebab yang berulang atau sistemik.
- ITOps tumpang tindih dengan ITSM, SRE, DevOps, SecOps, dan AIOps namun tidak identik dengan salah satunya.
Layanan, aset, dan konfigurasi
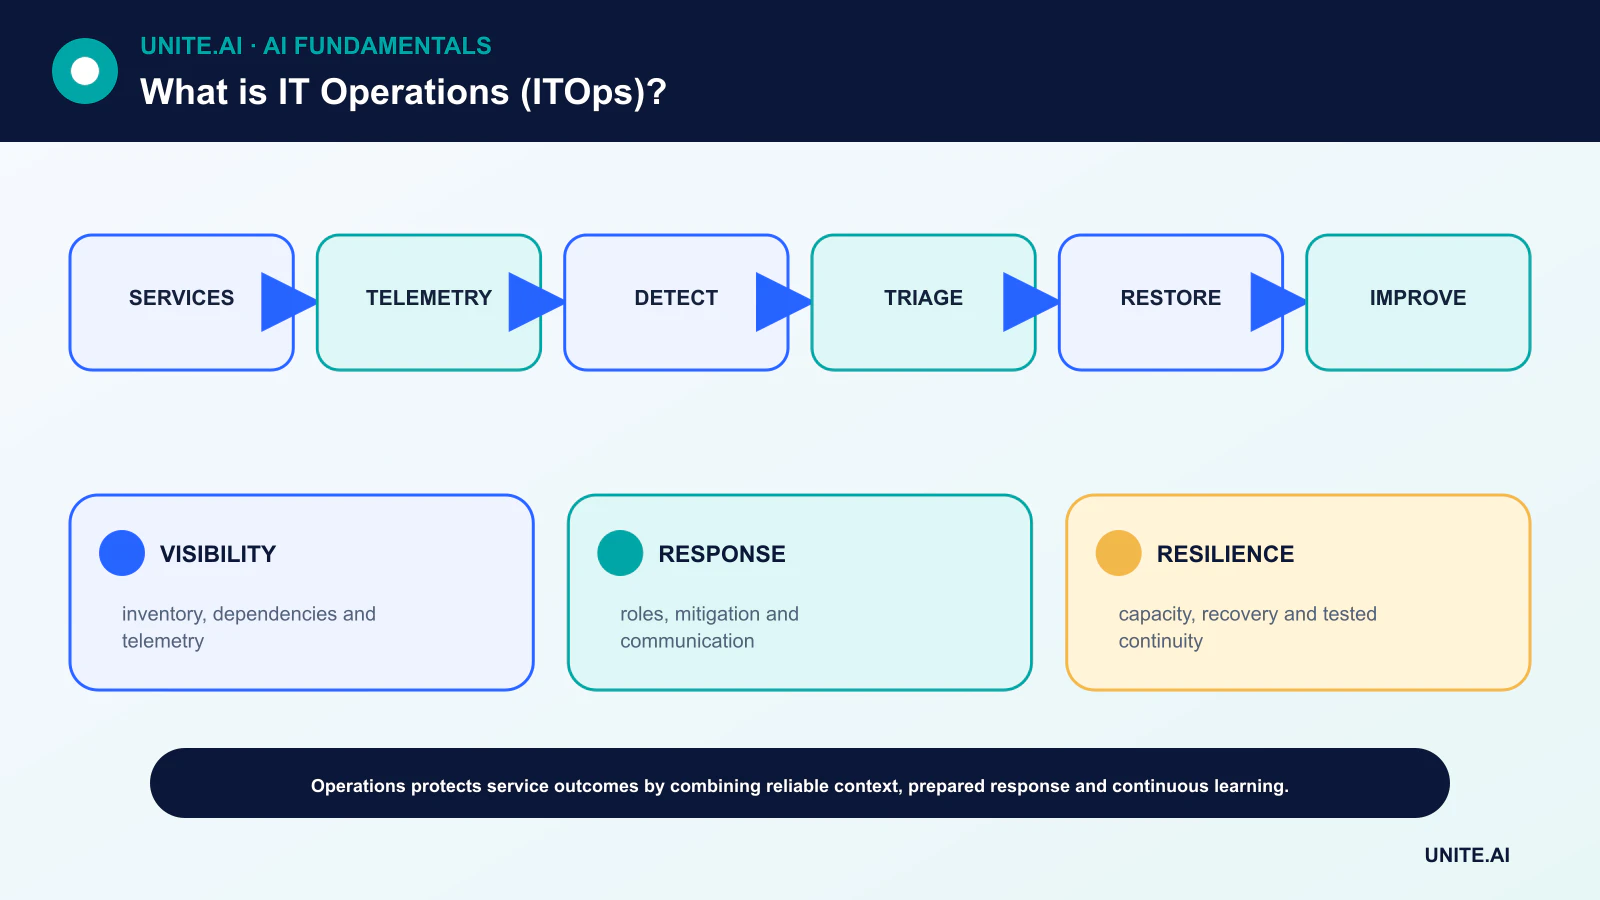
Operasi dimulai dengan mengetahui layanan apa yang ada, siapa pemiliknya, pengguna mana yang bergantung padanya, dan infrastruktur apa yang mendukungnya. Inventaris aset mencatat komponen; manajemen konfigurasi mencatat hubungan relevan dan keadaan yang terkendali.
Inventaris yang tidak pernah direkonsiliasi menjadi menyesatkan. Otomatiskan penemuan bila berguna, identifikasi sumber otoritatif, dan catat tingkat kepercayaan atau kebaruan alih-alih berpura-pura bahwa setiap peta ketergantungan lengkap.
Observabilitas dan tujuan layanan
Metrik mengkuantifikasi perilaku, log mencatat peristiwa, dan jejak mengikuti alur kerja lintas layanan. Pemeriksaan sintetis dapat menguji perjalanan pengguna. Observabilitas yang berguna dimulai dengan pertanyaan dan tujuan layanan, kemudian mengumpulkan sinyal yang diperlukan untuk menjawabnya.
Peringatan harus mengidentifikasi kondisi yang memerlukan tindakan tepat waktu. Ambang batas tanpa dampak pada pengguna menghasilkan kebisingan, sementara kurangnya konteks ketergantungan memperlambat diagnosis. AIOps dapat membantu korelasi, namun memerlukan telemetri yang dapat dipercaya dan umpan balik operasional.
Manajemen insiden, masalah, dan perubahan
Manajemen insiden mengoordinasikan deteksi, triase, mitigasi, komunikasi, dan pemulihan. Peran yang jelas mengurangi kebingungan di bawah tekanan. Solusi sementara dapat memulihkan layanan sementara penyelidikan masalah selanjutnya menangani penyebab yang lebih dalam.
Manajemen perubahan mengevaluasi dan mencatat risiko tanpa menjadikan setiap perubahan sebagai antrean. Perubahan standar, otomatis, dan berisiko rendah dapat mengikuti jalur yang telah disetujui sebelumnya; perubahan berdampak tinggi memerlukan bukti yang lebih kuat, penjadwalan, dan persiapan rollback.
Kapasitas, ketahanan, dan kesinambungan
Tim memproyeksikan permintaan sumber daya, menghilangkan bottleneck, dan menguji perilaku di bawah beban. Cadangan berguna hanya ketika pemulihan diuji. Redundansi membantu hanya bila mode kegagalan independen dan failover benar‑benar berfungsi.
Keberlanjutan bisnis menentukan prioritas, waktu pemulihan, dan kehilangan data yang dapat diterima. Ketergantungan pada identitas, DNS, kontrol plane cloud, dan vendor harus dimasukkan dalam latihan, bukan diasumsikan tersedia.
ITOps, ITSM, SRE, dan DevOps
Manajemen layanan TI menyediakan proses untuk menyelaraskan layanan dengan kebutuhan organisasi. Site Reliability Engineering menerapkan rekayasa perangkat lunak pada operasi dan menggunakan tujuan tingkat layanan serta anggaran kesalahan. DevOps menggabungkan umpan balik pengembangan dan operasi.
SecOps berfokus pada ancaman dan respons, sementara ITOps menjaga kesehatan layanan yang lebih luas. Struktur organisasi berbeda; persyaratan penting adalah kepemilikan yang eksplisit dan bukti bersama di antara disiplin ini.
Model operasional ITOps
Operasi TI menjaga layanan teknologi organisasi tetap tersedia, berkinerja, aman, dan dapat dipulihkan. Lingkup biasanya mencakup endpoint, identitas, jaringan, server, cloud, penyimpanan, kolaborasi, basis data, pemantauan, service desk, cadangan, dan layanan vendor. ITOps modern mencakup infrastruktur milik sendiri dan platform yang dikelola, sehingga tanggung jawab harus eksplisit bahkan ketika operasi dialihdayakan. Inventaris konfigurasi atau layanan menghubungkan komponen teknis dengan pemilik, pengguna, ketergantungan, klasifikasi data, dan kritikalitas bisnis.
Manajemen layanan mengatur insiden, permintaan, masalah, perubahan, aset, pengetahuan, dan tingkat layanan. Manajemen insiden memulihkan layanan; manajemen masalah menyelidiki penyebab berulang; pemberdayaan perubahan menilai dan mengoordinasikan risiko. Menganggap setiap perubahan sebagai persetujuan lambat menciptakan celah, sementara otomatisasi tanpa pengawasan menghasilkan kegagalan tak terkendali. Perubahan berisiko rendah standar dapat dipraotorisasi dan diotomatisasi; perubahan berisiko tinggi memerlukan bukti, komunikasi, rollback, dan penjadwalan berdasarkan dampak.
Keandalan, kapasitas, dan kesinambungan
Pemantauan harus mengikuti layanan yang berhadapan dengan pengguna dan ketergantungannya, bukan hanya jumlah perangkat. Tentukan tujuan ketersediaan, latensi, kapasitas, kebaruan, dan dukungan bersama pemilik bisnis. Beri peringatan pada gejala yang dapat ditindaklanjuti dan konsumsi anggaran kesalahan; perkaya peristiwa dengan kepemilikan dan perubahan terbaru. Model perencanaan kapasitas mencakup permintaan, saturasi, lisensi, dan lead time. Elastisitas cloud mengurangi penundaan penyediaan namun tidak menghilangkan kuota, batas regional, atau kontrol biaya.
Keberlanjutan bisnis memerlukan cadangan yang diuji, pemulihan, pemulihan identitas, alternatif jaringan, kontak vendor, dan prosedur manual. Tentukan tujuan waktu pemulihan (recovery-time) dan titik pemulihan (recovery-point) per layanan. Cadangan bukan bukti pemulihan sampai dipulihkan dan divalidasi. Latih skenario ransomware, kehilangan wilayah, sertifikat kedaluwarsa, gangguan identitas, dan kegagalan pemasok. Lacak konfigurasi dan infrastruktur sebagai kode bila memungkinkan sehingga pemulihan dapat direproduksi.
Keamanan, otomatisasi, dan metrik
Gunakan prinsip hak minimum, manajemen patch dan kerentanan, kontrol endpoint, segmentasi jaringan, pencatatan, dan respons insiden. Otomatiskan pekerjaan berulang dengan idempotensi, batas, persetujuan, dan audit. Ukur ketersediaan layanan, pengulangan insiden, pemenuhan permintaan, kegagalan perubahan, pemulihan, paparan patch, kapasitas, biaya, dan kepuasan pengguna—bukan hanya penutupan tiket. ITOps berhasil ketika teknologi mendukung pekerjaan secara dapat diprediksi dan dapat pulih dari kegagalan, bukan ketika infrastruktur tampak sibuk atau dasbor penuh indikator hijau.
Contoh kerja: memulihkan layanan kolaborasi
Sebuah perusahaan menetapkan tujuan waktu pemulihan empat jam dan tujuan titik pemulihan satu jam untuk platform kolaborasi. Mereka menginventarisasi identitas, DNS, jaringan, data, kunci, konfigurasi, integrasi, dan ketergantungan vendor. Latihan pemulihan mengasumsikan wilayah utama dan akun admin tidak tersedia. Operator mengaktifkan identitas darurat yang dilindungi secara independen, memulihkan konfigurasi layanan dan data ke wilayah terisolasi, serta memvalidasi izin, pesan, integrasi, dan akses klien. Pemilik bisnis memverifikasi layanan yang dipulihkan dengan perjalanan pengguna realistis, bukan hanya mengandalkan pemeriksaan kesehatan infrastruktur.
Latihan tersebut mencatat kehilangan data aktual, waktu yang berlalu, langkah manual, kontak yang gagal, dan ketergantungan tersembunyi. Cadangan yang memulihkan file tetapi tidak kunci enkripsi atau kebijakan identitas dianggap tidak lengkap. Tindakan korektif mencantumkan pemilik dan tanggal, dan buku pedoman (runbook) diperbarui serta diuji kembali. Template pemantauan dan komunikasi disertakan. Organisasi mengukur bukti pemulihan, bukan keberhasilan pekerjaan cadangan, menyadari bahwa ITOps yang dapat diandalkan harus memulihkan layanan yang dibutuhkan pengguna dalam kondisi kegagalan yang realistis.
Bukti implementasi dan kesiapan operasional
Keputusan produksi memerlukan lebih dari demonstrasi yang berhasil. Tentukan pengguna yang dituju, lingkungan operasi, masukan, keluaran, ketergantungan, pemilik, dan konsekuensi setiap kegagalan penting. Bangun baseline yang dapat direproduksi dan set evaluasi berversi sebelum penyesuaian. Uji kasus biasa, kondisi batas, masukan yang rusak atau hilang, pergeseran distribusi, gangguan ketergantungan, penyalahgunaan, serta grup atau lingkungan yang paling mungkin kurang terlayani. Ukur kualitas tugas bersama dengan kalibrasi atau ketidakpastian, latensi, throughput, biaya sumber daya, aksesibilitas, privasi, dan keamanan. Catat setiap transformasi dan ambang sehingga peninjau independen dapat mereproduksi hasil dan membedakan bukti dari prototipe yang menarik.
Sebelum peluncuran, tetapkan otoritas untuk rilis, pengecualian, perubahan, rollback, dan pensiun. Gunakan peluncuran bertahap, pertahankan fallback yang aman, dan verifikasi pemantauan dengan kegagalan yang sengaja disuntikkan. Telemetri operasional harus mengungkap kualitas masukan, perilaku keluaran, versi model atau aturan, kesehatan ketergantungan, intervensi manusia, dan hasil yang terkonfirmasi tanpa mengumpulkan data sensitif yang tidak diperlukan. Tentukan ambang peringatan dan pemilik respons, kemudian tinjau bukti dunia nyata setelah penerapan alih-alih mengasumsikan kinerja offline akan bertahan. Evaluasi kembali setiap kali sumber data, pengguna, model, vendor, kebijakan, perangkat keras, atau tujuan berubah. Sistem yang dipelihara juga memerlukan prosedur pemulihan, pembelajaran insiden, penghapusan dan retensi yang terdokumentasi, serta titik yang jelas kapan harus dinonaktifkan atau diganti.
Pertanyaan yang sering diajukan
Apa tujuan utama ITOps?
Untuk menyediakan dan memulihkan layanan teknologi yang dapat diandalkan dalam batasan keamanan, kinerja, kesinambungan, dan biaya yang telah disepakati.
Apakah infrastruktur cloud dioperasikan sepenuhnya oleh penyedia cloud?
Tidak. Penyedia mengoperasikan bagian-bagian platform dasar, sementara pelanggan tetap bertanggung jawab atas konfigurasi, identitas, data, beban kerja, pemantauan, dan banyak keputusan tingkat layanan.
Referensi utama












