
Dasar-dasar AI
Apa itu AIOps? Kecerdasan Buatan untuk Operasi TI

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
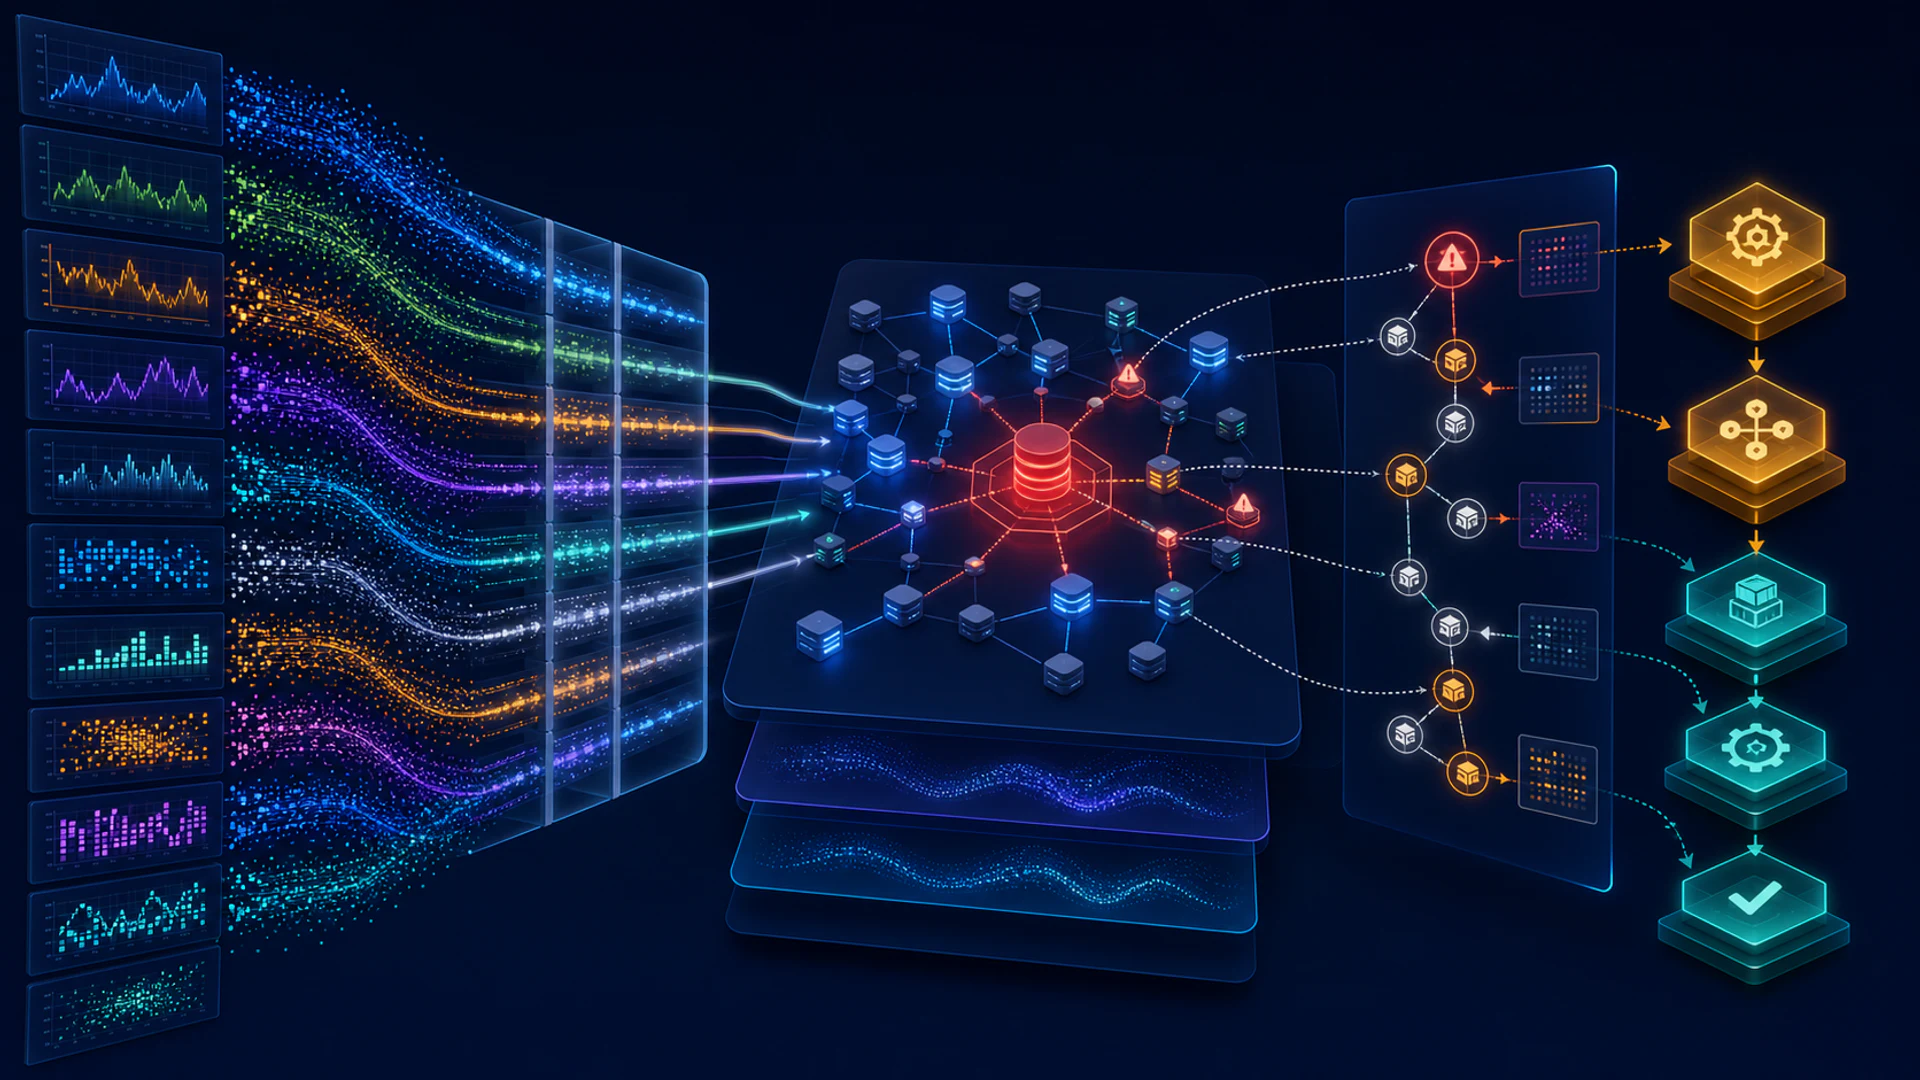
AIOps menerapkan pembelajaran mesin dan otomatisasi pada data operasi TI sehingga tim dapat mendeteksi perilaku tidak biasa, mengurangi peringatan duplikat, menghubungkan peristiwa terkait, memberi peringkat kemungkinan penyebab, dan merekomendasikan atau mengeksekusi tindakan respons.
AIOps bukan pengganti otonom untuk operasi. Ia merupakan lapisan di dalam sistem ITOps, dan nilainya bergantung pada kualitas telemetri, topologi layanan, riwayat perubahan, umpan balik manusia, serta batasan otomatisasi yang aman.
Poin-poin utama
- Normalisasi peristiwa dan tambahkan konteks layanan sebelum menerapkan model yang canggih.
- Deteksi anomali mengidentifikasi penyimpangan, bukan berarti kegagalan atau penyebab utama.
- Korelasi dan peringkat penyebab yang mungkin harus menampilkan bukti dan ketidakpastian.
- Remediasi otomatis memerlukan hak paling minimal, persetujuan, canary, rollback, dan pemantauan hasil.
Membangun lapisan data operasional
Platform AIOps mengkonsumsi metrik, log, jejak, peringatan, tiket, topologi, penyebaran, dan perubahan konfigurasi. Stempel waktu, pengidentifikasi, serta kepemilikan layanan harus diselaraskan agar sistem dapat menghubungkan sinyal yang merujuk pada insiden yang sama.
Konteks yang hilang atau tidak konsisten menyebabkan korelasi palsu. Retensi data, akses, dan privasi juga penting karena log dapat berisi kredensial atau informasi pribadi. Terapkan tata kelola yang sama seperti pada sistem data produksi lainnya.
Deteksi dan pengurangan kebisingan
Ambang batas statis berfungsi untuk batas yang diketahui; metode statistik dan pembelajaran mesin dapat memodelkan musiman atau pola multivariat. Dedupplikasi mengelompokkan notifikasi berulang, sementara penekanan menghapus peringatan yang tidak dapat ditindaklanjuti berdasarkan aturan yang ditetapkan.
Anomali hanyalah penyimpangan dari perilaku yang diharapkan. Rilis terencana, kampanye lalu lintas, dan siklus bisnis mungkin tidak biasa namun tetap sehat. Evaluasilah presisi, recall, penundaan deteksi, dan beban kerja operator alih-alih merayakan jumlah peringatan yang dihilangkan.
Korelasi dan penyebab yang mungkin
Korelasi peristiwa menghubungkan gejala melalui grafik ketergantungan dan jendela waktu. Model penyebab yang mungkin dapat memberi peringkat komponen atau perubahan terbaru yang mungkin menjelaskan insiden. Ini memprioritaskan penyelidikan; tidak menetapkan kausalitas.
Tampilkan bukti yang berkontribusi, hipotesis alternatif, dan tingkat kepercayaan. AI yang dapat dijelaskan sangat penting ketika operator harus memutuskan apakah akan mengisolasi layanan atau melakukan rollback penyebaran.
Dari rekomendasi ke otomatisasi
Runbook dapat mengumpulkan diagnostik, memulai ulang pekerja tanpa status, atau meningkatkan kapasitas. Copilot dapat merangkum insiden dan mengambil prosedur. Agen dapat merencanakan pemanggilan alat, namun izin produksi harus terbatas dan tindakan harus divalidasi terhadap keadaan saat ini.
Mulailah dengan rekomendasi hanya-baca. Tingkatkan tindakan matang melalui simulasi, persetujuan manusia, canary, dan rollback otomatis. Catat masukan, versi model, otorisasi, dan hasil untuk setiap tindakan.
Evaluasi dan umpan balik operasional
Putar ulang insiden historis tanpa membocorkan label akhir mereka ke dalam fitur. Uji pada layanan dan perubahan baru, ukur penekanan palsu, waktu deteksi, waktu mitigasi, penerimaan operator, dan kejadian berulang. Bandingkan dengan aturan yang ada dan baseline sederhana.
Drift terjadi ketika arsitektur, lalu lintas, atau praktik respons berubah. Tutup siklus dengan membiarkan operator memperbaiki korelasi dan hasil, lalu tinjau apakah sistem mengurangi beban kerja tanpa menyembunyikan risiko atau menciptakan kepuasan berlebihan pada otomatisasi.
Pipeline data dan analitik AIOps
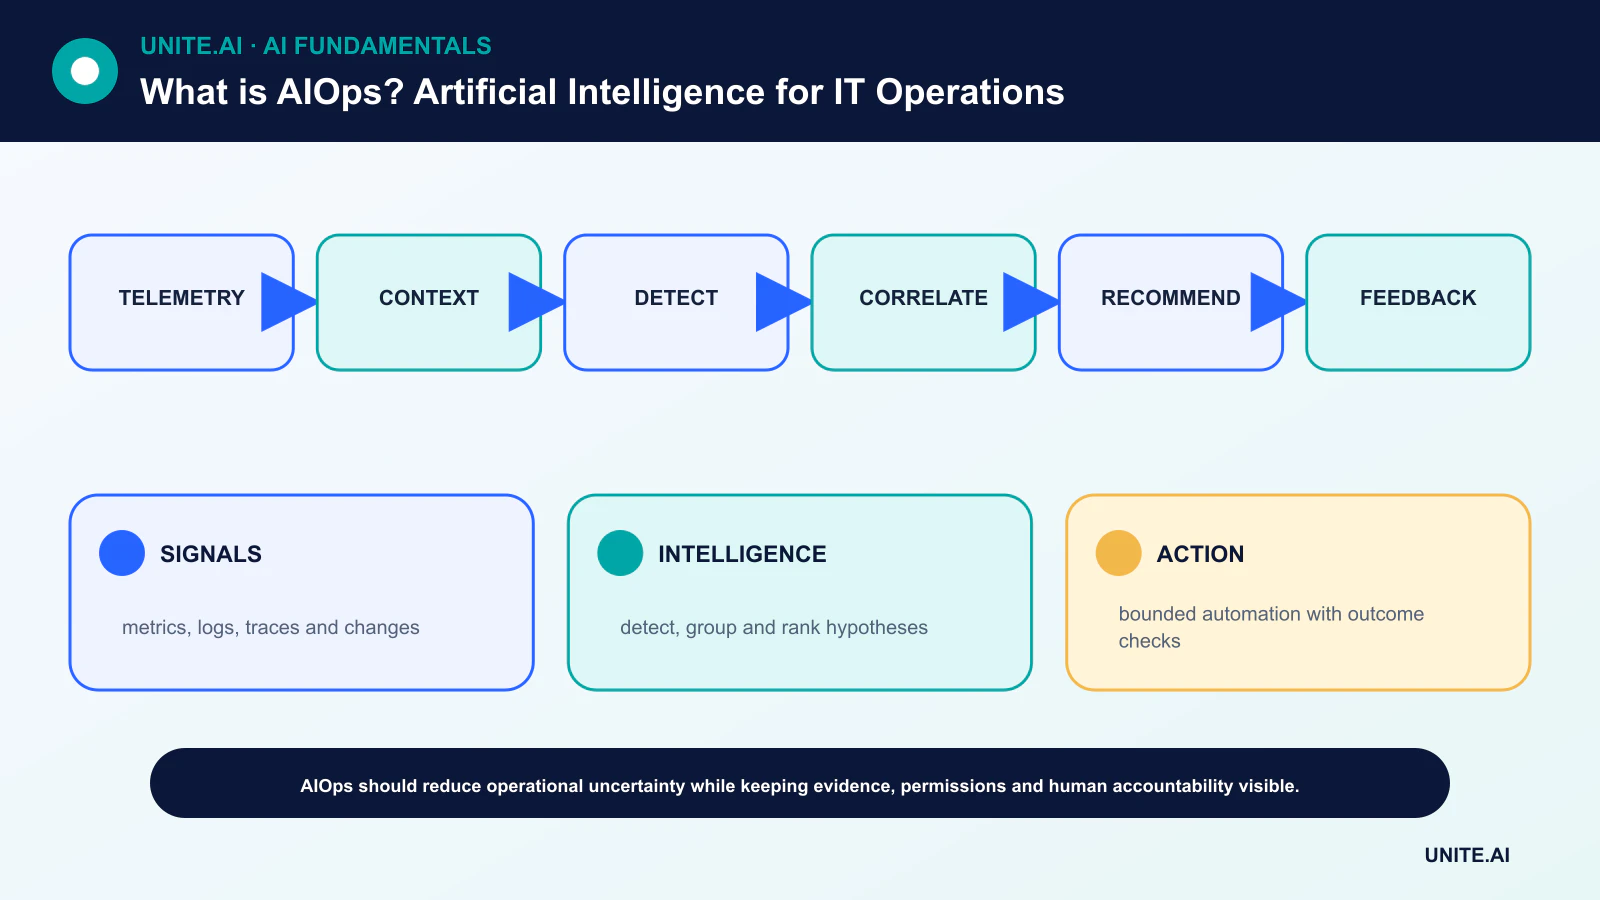
AIOps menerapkan metode statistik dan pembelajaran mesin pada data operasi seperti metrik, log, jejak, peristiwa, topologi, tiket, dan perubahan. Pipeline mengumpulkan dan menormalisasi sinyal, memperkaya mereka dengan konteks layanan dan kepemilikan, mendeteksi anomali, mengkorelasikan peristiwa terkait, memperkirakan penyebab yang mungkin, dan merekomendasikan atau memicu tindakan. Kualitas bergantung pada stempel waktu, pengidentifikasi, topologi, dan catatan perubahan. Model yang canggih tidak dapat secara andal mengkorelasikan peringatan yang merujuk pada layanan yang sama dengan nama yang tidak konsisten.
Deteksi anomali mempelajari baseline berdasarkan layanan, musim, dan keadaan operasi; ambang batas statis mungkin lebih baik untuk batas keselamatan yang diketahui. Korelasi peristiwa mengelompokkan gejala menjadi sebuah insiden menggunakan waktu, topologi, teks, dan pola historis. Peringkat penyebab akar mengusulkan hipotesis namun dapat membingungkan kegagalan pertama yang terlihat dengan penyebab sebenarnya atau melewatkan ketergantungan bersama yang tidak ada dalam topologi. Ringkasan bahasa alami dapat membantu responden tetapi harus terhubung ke bukti mentah dan menyatakan ketidakpastian.
Otomatisasi, evaluasi, dan umpan balik
Mulailah dengan dukungan keputusan dan remediasi berisiko rendah yang dapat dibalik. Setiap tindakan otomatis memerlukan otorisasi, prasyarat, ruang lingkup terbatas, batas waktu, verifikasi pasca-kondisi, rollback, dan jejak audit. Model tidak boleh memberikan kredensial kepada dirinya sendiri atau memperlakukan teks log sebagai instruksi yang dapat dipercaya. Responden manusia harus menerima, menolak, atau memperbaiki rekomendasi, dan hasil tersebut harus memperbarui aturan atau data pelatihan melalui tinjauan, bukan pembelajaran mandiri yang tidak terkendali.
Evaluasilah pengurangan peringatan tanpa melewatkan insiden, waktu tunggu deteksi, presisi korelasi, peringkat penyebab akar, keberhasilan remediasi, waktu pemulihan, kejadian berulang, dan beban kerja responden. Gunakan pemutaran ulang historis dan kesalahan yang disuntikkan, namun perhitungkan label insiden yang tidak lengkap. Ukur per layanan dan tipe insiden; rata-rata dapat menyembunyikan kegagalan berbahaya pada sistem kritis yang jarang. Bandingkan dengan aturan deterministik dan observabilitas yang ditingkatkan sebelum menambahkan kompleksitas AI.
Tata kelola dan mode kegagalan
AIOps dapat memperbesar kesenjangan telemetri, mengotomatisasi diagnosis yang salah, atau menciptakan tindakan terkoordinasi di seluruh armada. Isolasi lingkungan, batasi konkruensi, pertahankan tombol mati di luar model, dan latih kegagalan platform AIOps itu sendiri. Lindungi log dan tiket yang berisi rahasia atau data pribadi. Pantau drift model, kebaruan topologi, tindakan palsu, dan override. AIOps mendukung operasi yang dapat diandalkan ketika ia mempercepat bukti dan tindakan terbatas; ia bukan pengganti otonom untuk kepemilikan layanan, komando insiden, atau penilaian teknik.
Contoh kerja: AIOps untuk insiden pembayaran
AIOps mengelompokkan lonjakan kesalahan API, saturasi basis data, dan peringatan regional menjadi satu insiden serta memperkaya dengan penyebaran terbaru, topologi, dan pemilik. Ia memberi peringkat penyebaran sebagai kontributor yang mungkin tetapi menampilkan telemetri mentah dan alternatif. Kebijakan deterministik menghentikan penyebaran lebih lanjut; komandan insiden manusia menyetujui pergeseran lalu lintas setelah memeriksa bahwa kapasitas dan konsistensi data aman.
Sistem mengukur presisi pengelompokan, waktu tunggu deteksi, akurasi peringkat, penerimaan responden, pemulihan, dan remediasi palsu dalam pemutaran ulang historis dan hari simulasi. Semua tindakan otomatis memiliki batas, idempotensi, pemeriksaan pasca-kondisi, dan rollback. Log disanitasi dan teks berbahaya tidak dapat menjadi perintah. Setelah insiden, penyebab yang dikonfirmasi dan hasil tindakan memperbarui aturan yang ditinjau serta data evaluasi. Platform AIOps membantu bukti dan koordinasi; ia tidak pernah menggantikan komando insiden atau otorisasi eksternal.
Bukti implementasi dan kesiapan operasional
Keputusan produksi memerlukan lebih dari sekadar demonstrasi yang berhasil. Tentukan pengguna yang dituju, lingkungan operasi, masukan, keluaran, ketergantungan, pemilik, dan konsekuensi dari setiap kegagalan penting. Bangun baseline yang dapat direproduksi dan set evaluasi berversi sebelum penyetelan. Uji kasus biasa, kondisi batas, masukan yang rusak atau hilang, pergeseran distribusi, kegagalan ketergantungan, penyalahgunaan, serta grup atau lingkungan yang paling mungkin kurang terlayani. Ukur kualitas tugas bersama dengan kalibrasi atau ketidakpastian, latensi, throughput, biaya sumber daya, aksesibilitas, privasi, dan keamanan. Catat setiap transformasi dan ambang batas sehingga peninjau independen dapat mereproduksi hasil dan membedakan bukti dari prototipe yang menarik.
Sebelum peluncuran, tetapkan otoritas untuk rilis, pengecualian, perubahan, rollback, dan pensiun. Gunakan penyebaran bertahap, pertahankan fallback yang aman, dan verifikasi pemantauan dengan kegagalan yang disuntikkan secara sengaja. Telemetri operasional harus mengungkap kualitas masukan, perilaku keluaran, versi model atau aturan, kesehatan ketergantungan, override manusia, dan hasil yang dikonfirmasi tanpa mengumpulkan data sensitif yang tidak diperlukan. Tentukan ambang peringatan dan pemilik respons, lalu tinjau bukti dunia nyata setelah penerapan daripada mengasumsikan kinerja offline akan bertahan. Evaluasi kembali setiap kali sumber data, pengguna, model, vendor, kebijakan, perangkat keras, atau tujuan berubah. Sistem yang dipelihara juga memerlukan prosedur pemulihan, pembelajaran insiden, penghapusan dan retensi yang terdokumentasi, serta titik jelas di mana sistem harus dinonaktifkan atau diganti.
Pertanyaan yang sering diajukan
Apakah AIOps sama dengan observabilitas?
Tidak. Observabilitas menyediakan dan mengeksplorasi sinyal sistem; AIOps menggunakan analitik dan otomatisasi atas sinyal tersebut. Keduanya dapat ada secara terpisah.
Dapatkah AIOps menentukan penyebab utama secara otomatis?
Ia dapat memberi peringkat hipotesis dan mengumpulkan bukti, tetapi klaim kausal memerlukan topologi, konteks perubahan, dan validasi. Banyak insiden memiliki penyebab yang saling berinteraksi.
Referensi utama












