
Dasar-dasar AI
Model Pembelajaran Generatif vs. Diskriminatif

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
Generatif dan diskriminatif menggambarkan apa yang dipelajari model tentang data dan target. Dalam klasifikasi terawasi klasik, model generatif mempelajari distribusi bersama seperti P(x, y) atau distribusi bersyarat kelas P(x|y), sedangkan model diskriminatif mempelajari P(y|x) atau batas keputusan langsung.
Perbedaan ini berguna, namun sistem modern sering menggabungkan tujuan. Sebuah model dapat mempelajari representasi generatif dan kemudian di‑fine‑tune untuk prediksi diskriminatif, atau berbagi satu backbone antara generasi dan klasifikasi.
Ringkasan utama
- Klasifier generatif memodelkan bagaimana input dan label muncul; klasifier diskriminatif memodelkan label diberikan input atau sebuah batas.
- Asumsi generatif dapat membantu bila data berlabel terbatas, namun juga dapat salah.
- Metode diskriminatif biasanya memusatkan kapasitas pada tugas prediksi dan dapat mencapai kesalahan klasifikasi asimptotik yang lebih rendah.
- GAN, VAE, dan model bahasa merupakan sistem generatif, namun “generatif” tidak berarti setiap komponen adalah klasifier generatif.
Faktorisasi probabilitas
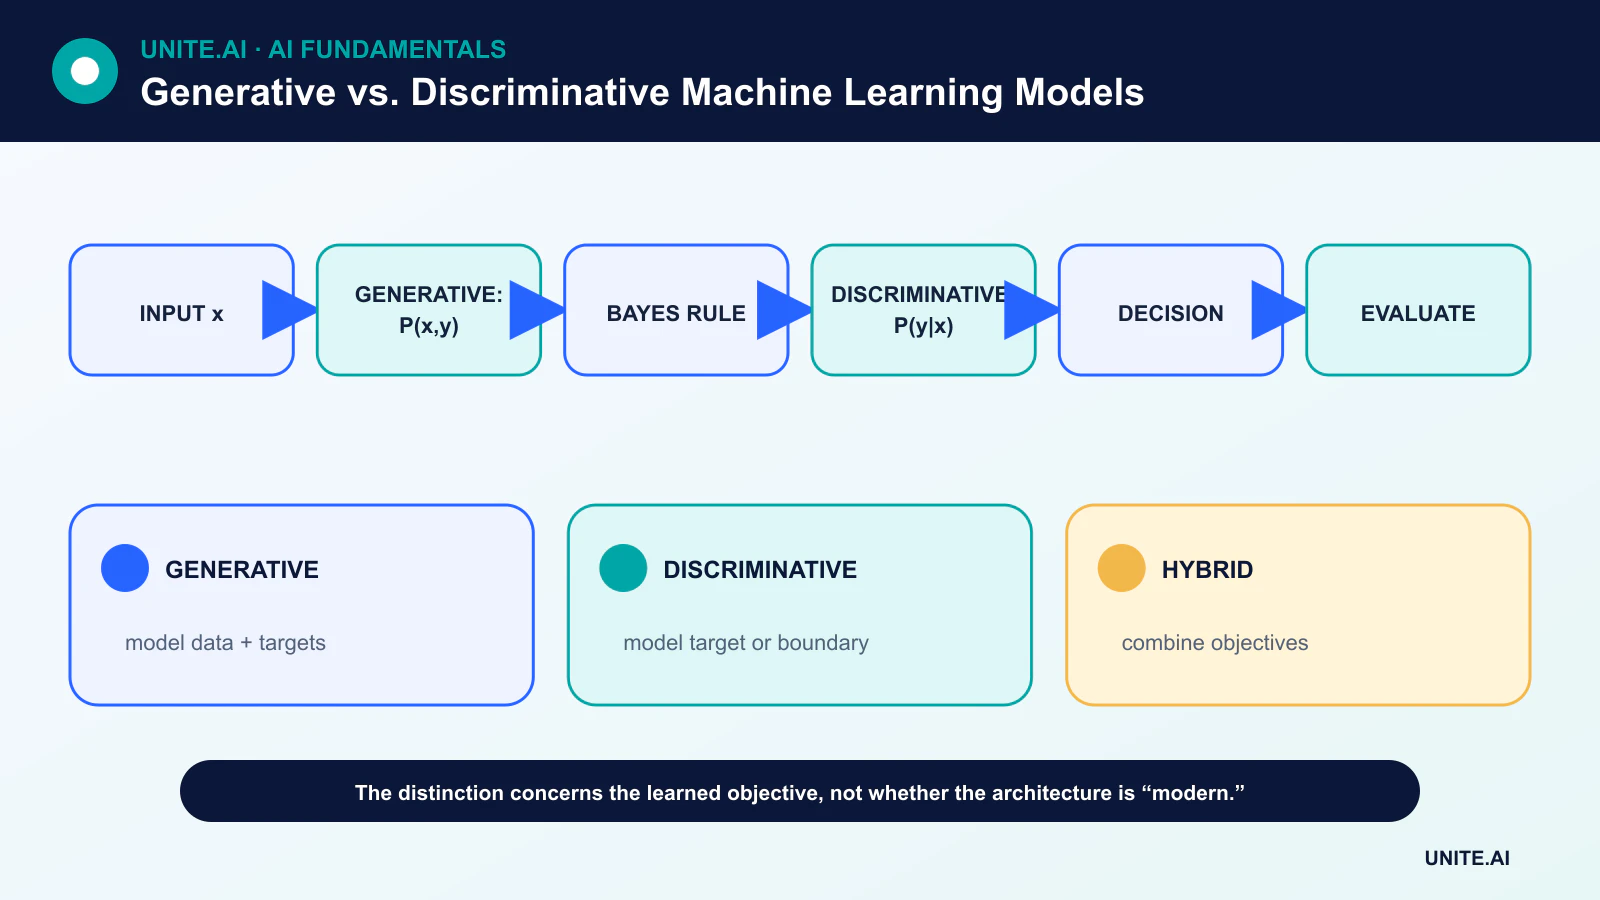
Sebuah klasifier generatif dapat memperkirakan P(x|y) dan P(y), kemudian menggunakan teorema Bayes untuk menghasilkan P(y|x). Naive Bayes adalah contoh klasik. Sebuah klasifier diskriminatif seperti regresi logistik memperkirakan P(y|x) secara langsung; SVM belajar batas pemisahan.
Memodelkan P(x,y) adalah tugas yang lebih luas daripada memprediksi y dari x. Struktur tambahan ini dapat mendukung sampling atau penalaran data yang hilang, namun juga memerlukan asumsi tentang distribusi input.
Efisiensi data dan perilaku asimptotik
Perbandingan Ng dan Jordan antara naive Bayes dan regresi logistik menunjukkan kompromi yang berguna: di bawah asumsi mereka, model generatif dapat mencapai performa batasnya dengan contoh yang lebih sedikit, sementara model diskriminatif dapat mencapai kesalahan asimptotik yang lebih rendah.
Ini bukan peringkat universal. Hasil bergantung pada apakah keluarga model cocok dengan data, dimensi, regularisasi, optimisasi, dan kualitas label. Perbandingan empiris pada desain validasi yang representatif tetap penting.
Keluarga model representatif
Model generatif meliputi distribusi bersyarat kelas, model Markov tersembunyi, model campuran, variational autoencoders, model bahasa autoregresif, model difusi, dan GAN.
Model diskriminatif meliputi regresi logistik, pohon keputusan, conditional random fields, support vector machines, dan klasifier neural. Backbone neural yang sama dapat berpartisipasi dalam salah satu kategori tergantung pada tujuan pelatihan dan outputnya.
Sistem hibrida dan self‑supervised
Model bahasa atau visi yang telah dipra‑latih dapat belajar dari data tak berlabel dengan tujuan generatif atau self‑supervised, kemudian menerima kepala diskriminatif untuk tugas target. Metode semi‑supervised dapat mengoptimalkan klasifikasi berlabel dan tujuan data tak berlabel secara bersamaan.
Hibridisasi membuat label arsitektur kurang informatif dibandingkan dengan keseluruhan alur pelatihan. Dokumentasi harus menyatakan tujuan, data, output, dan inferensi yang dimaksud—bukan sekadar menyebut model sebagai generatif.
Memilih antara pendekatan
Gunakan tugas untuk memutuskan. Jika tujuan adalah batas yang terkalibrasi dengan label melimpah, model diskriminatif menjadi baseline alami. Jika sampling, estimasi kepadatan, struktur data yang hilang, atau data tak berlabel menjadi pusat, komponen generatif dapat membantu.
Bandingkan robustitas, efisiensi sampel, komputasi, likelihood, atau kalibrasi sesuai kebutuhan. Sampel yang dihasilkan dengan baik tidak membuktikan klasifier yang baik, dan klasifier berakurasi tinggi tidak serta‑merta menunjukkan model input yang realistis.
Arah probabilitas dan tujuan pemodelan
Sebuah model diskriminatif mempelajari batas atau distribusi bersyarat P(y|x): diberikan fitur x, prediksi label y. Regresi logistik, support vector machines, conditional random fields, dan banyak klasifier lainnya bersifat diskriminatif. Sebuah model generatif mempelajari distribusi bersama P(x,y), distribusi bersyarat kelas P(x|y), atau distribusi data tak bersyarat, yang memungkinkan sampling atau tugas terkait likelihood. Naive Bayes dan linear discriminant analysis adalah klasifier generatif; GAN, variational autoencoders, model difusi, dan model autoregresif menghasilkan data melalui tujuan yang berbeda.
Perbedaan terletak pada distribusi atau aturan keputusan yang dimodelkan, bukan pada penggunaan jaringan neural. Model bahasa generatif dapat diprompt untuk klasifikasi, sementara reranker diskriminatif dapat mengarahkan generasi. Asumsi generatif dapat meningkatkan efisiensi data atau menangani variabel yang hilang, namun menimbulkan risiko miss‑specification model. Metode diskriminatif sering unggul dengan data berlabel melimpah karena mereka fokus langsung pada batas prediksi. Bandingkan keluarga model dengan fitur, data, penyetelan, dan komputasi yang setara, alih‑alih menganggap satu kategori selalu superior.
Pelatihan dan evaluasi berdasarkan kasus penggunaan
Evaluasi klasifikasi menggunakan presisi, recall, kalibrasi, robustitas, dan biaya kesalahan. Evaluasi generatif harus menilai fidelitas, keragaman, cakupan, likelihood atau kegunaan tugas, memorisasi, dan keamanan. Sebuah model dapat menghasilkan sampel menarik sambil kehilangan mode, atau mencapai likelihood tinggi dengan output perseptual yang buruk. Utilitas data sintetis harus diuji dengan melatih dan mengevaluasi model hilir pada data nyata yang independen, termasuk kelompok langka. Jaga data uji agar tidak masuk ke prompt generasi maupun seleksi.
Dalam pembelajaran semi‑supervised, model generatif dapat memanfaatkan struktur tak berlabel; dalam deteksi anomali, likelihood dapat gagal ketika data di luar distribusi memperoleh densitas tinggi karena alasan yang tidak relevan. Dalam generasi yang diperkaya dengan retrieval, model jawaban generatif dan retriever atau reranker diskriminatif membentuk hibrida. Diagnosa tiap tahap secara terpisah agar output yang fasih tidak menyembunyikan kegagalan retrieval. Pilih dekomposisi yang membuat bukti dan kontrol dapat diamati.
Penerapan dan tata kelola
Sistem generatif menambah risiko provenance konten, hak kekayaan intelektual, impersonasi, penyisipan prompt, dan moderasi output; sistem diskriminatif menambah risiko ambang, penolakan, dan kesalahan tidak merata. Keduanya memerlukan hak data, artefak yang aman, versi, pengujian representatif, pemantauan, dan otoritas manusia yang proporsional dengan konsekuensi. Catat tujuan tepat dan semantik output dalam dokumentasi. Generatif vs. diskriminatif adalah perbedaan statistik yang berguna, namun sistem nyata biasanya menggabungkannya, dan keandalan bergantung pada seluruh alur data dan keputusan.
Contoh terapan: mengklasifikasikan dan menghasilkan balasan dukungan
Sebuah platform dukungan menggunakan klasifier diskriminatif untuk mengidentifikasi tipe masalah dan urgensi, serta model generatif untuk menyusun balasan berdasarkan kebijakan yang disetujui. Klasifier dievaluasi dengan recall per kelas dan kalibrasi; retriever dengan recall bukti; generator dengan groundedness, kebenaran, dan penolakan. Setiap tahap memiliki hasil yang tidak diketahui, dan model generatif tidak dapat mengubah klasifikasi atau hak pelanggan melalui teks persuasif.
Agen melihat rute yang diprediksi, sumber, serta draft dan dapat menyetujui atau memperbaiki sebelum mengirim. Filter izin diterapkan sebelum retrieval, dan penyisipan prompt pada teks pelanggan tidak dapat memberi otorisasi alat. Pemantauan memisahkan kesalahan routing, kesenjangan retrieval, pernyataan yang tidak didukung, dan edit agen. Perubahan kebijakan memperbarui sumber secara langsung dan memicu tes regresi; penyetelan disediakan hanya untuk perilaku yang stabil. Desain hibrida memanfaatkan kekuatan diskriminatif dan generatif sambil mempertahankan bukti serta otoritas manusia.
Bukti implementasi dan kesiapan operasional
Keputusan produksi memerlukan lebih dari demonstrasi yang berhasil. Tentukan pengguna yang dimaksud, lingkungan operasi, input, output, dependensi, pemilik, serta konsekuensi setiap kegagalan penting. Bangun baseline yang dapat direproduksi dan set evaluasi berversi sebelum penyetelan. Uji kasus biasa, kondisi batas, input yang rusak atau hilang, pergeseran distribusi, kegagalan dependensi, penyalahgunaan, serta kelompok atau lingkungan yang paling berisiko terabaikan. Ukur kualitas tugas bersamaan dengan kalibrasi atau ketidakpastian, latensi, throughput, biaya sumber daya, aksesibilitas, privasi, dan keamanan. Catat setiap transformasi dan ambang sehingga peninjau independen dapat mereproduksi hasil dan membedakan bukti dari prototipe yang menarik.
Sebelum peluncuran, tugaskan otoritas untuk rilis, pengecualian, perubahan, rollback, dan pensiun. Gunakan rollout bertahap, pertahankan fallback aman, dan verifikasi pemantauan dengan kegagalan yang disuntikkan secara sengaja. Telemetri operasional harus mengungkap kualitas input, perilaku output, versi model atau aturan, kesehatan dependensi, intervensi manusia, dan hasil yang terkonfirmasi tanpa mengumpulkan data sensitif yang tidak perlu. Tentukan ambang peringatan dan pemilik respons, lalu tinjau bukti dunia nyata setelah penerapan alih‑alih mengasumsikan kinerja offline akan tetap. Evaluasi kembali setiap kali sumber data, pengguna, model, vendor, kebijakan, perangkat keras, atau tujuan berubah. Sistem yang dipelihara juga memerlukan dokumentasi pemulihan, pembelajaran insiden, prosedur penghapusan dan retensi, serta titik yang jelas dimana harus dinonaktifkan atau diganti.
Pertanyaan yang sering diajukan
Apakah diskriminator GAN merupakan model diskriminatif?
Ia melakukan diskriminasi selama pelatihan, namun keseluruhan GAN adalah kerangka kerja generatif yang output‑nya dihasilkan oleh generator.
Apakah pembelajaran diskriminatif selalu bersifat terawasi?
Tidak. Istilah tersebut menggambarkan hubungan atau batas yang dimodelkan, sementara supervision menggambarkan sinyal pelatihan. Tujuan modern dapat mengaburkan kategori.
Referensi utama












