
Βασικές αρχές της AI
Τι είναι η Ενισχυτική Μάθηση;

 Προσθέστε το Unite.AI στις προτιμώμενες πηγές σας στο Google
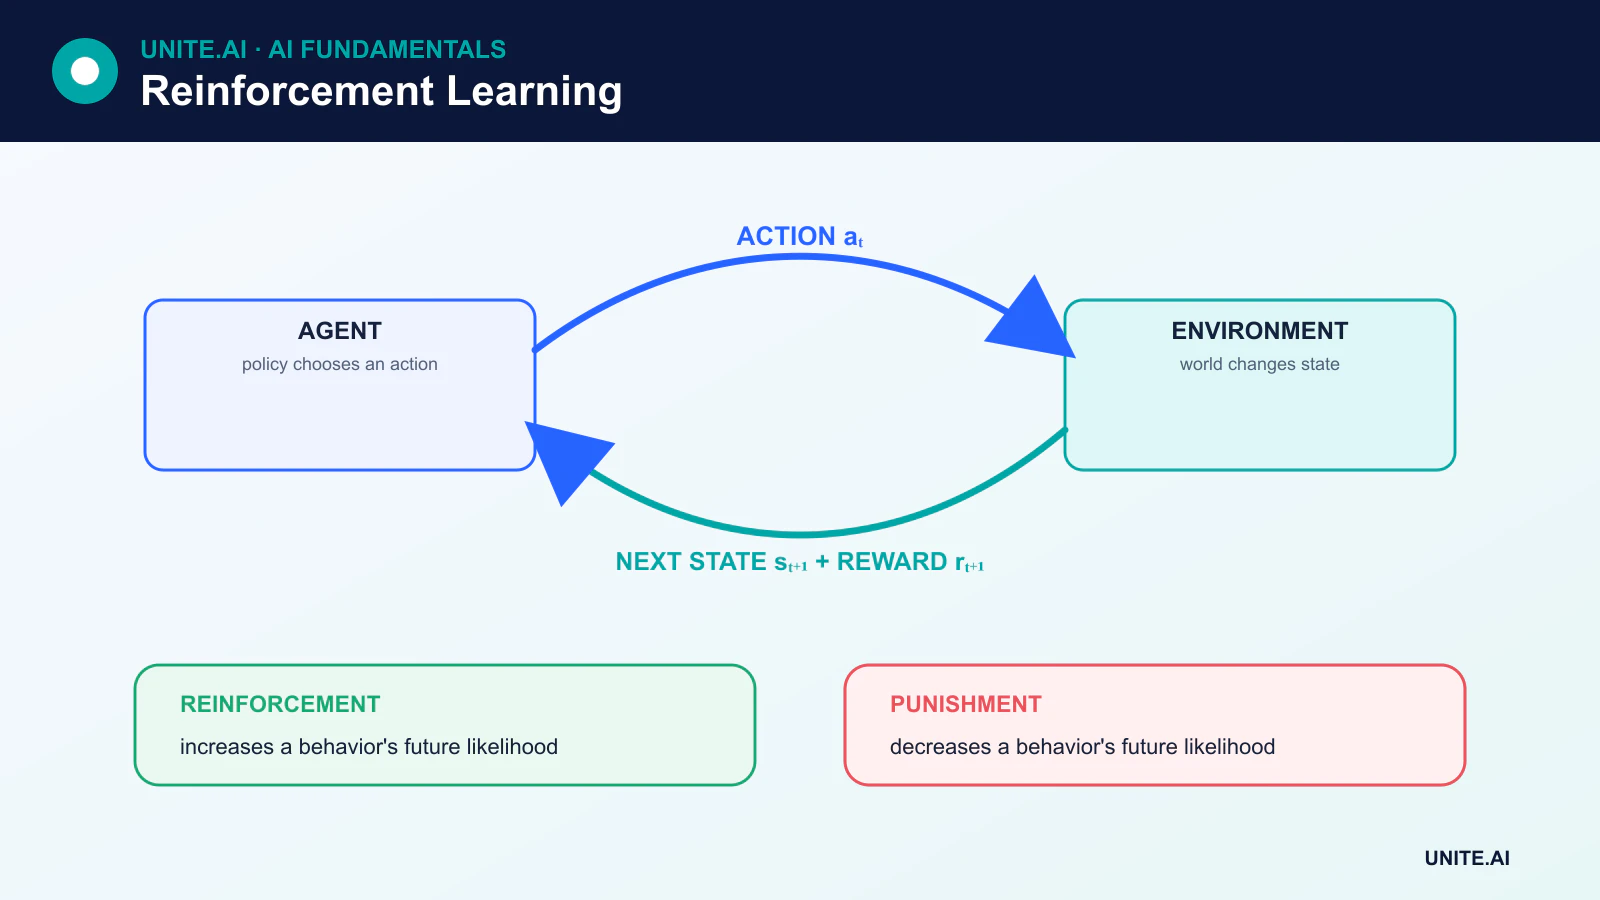
Ενισχυτική μάθηση (RL) είναι ένα πλαίσιο μηχανικής μάθησης στο οποίο ένας πράκτορας μαθαίνει πώς να ενεργεί αλληλεπιδρώντας με ένα περιβάλλον. Μετά από κάθε ενέργεια, το περιβάλλον αλλάζει και μπορεί να επιστρέψει μια ανταμοιβή. Ο στόχος του πράκτορα είναι να μάθει μια πολιτική που μεγιστοποιεί την αναμενόμενη συνολική ανταμοιβή, όχι μόνο την ανταμοιβή της επόμενης κίνησής του.
Η Ενισχυτική Μάθηση χρησιμοποιείται όταν οι αποφάσεις εξελίσσονται με την πάροδο του χρόνου και μια ενέργεια επηρεάζει το τι θα συμβεί στη συνέχεια. Είναι εννοιολογικά διαφορετική από τη επιβλεπόμενη μάθηση, όπου ένα σύνολο δεδομένων παρέχει μια στόχο απάντηση για κάθε παράδειγμα εκπαίδευσης.
Βασικά σημεία
- Ένα πρόβλημα Ενισχυτικής Μάθησης περιλαμβάνει έναν πράκτορα, περιβάλλον, καταστάσεις, ενέργειες, ανταμοιβές και μια πολιτική.
- Θετική και αρνητική ενίσχυση και οι δύο αυξάνουν τη συμπεριφορά· η τιμωρία μειώνει τη συμπεριφορά.
- Ο πράκτορας πρέπει να ισορροπεί μεταξύ εξερεύνησης άγνωστων ενεργειών και αξιοποίησης ενεργειών που ήδη γνωρίζονται ότι λειτουργούν.
- Μέθοδοι βασισμένες στην αξία, στην πολιτική, actor-critic, μοντέλο-βασισμένες και εκτός σύνδεσης λύνουν διαφορετικές ρυθμίσεις Ενισχυτικής Μάθησης.
Τα συστατικά της ενισχυτικής μάθησης
Πολλά προβλήματα Ενισχυτικής Μάθησης μοντελοποιούνται ως Διαδικασία Απόφασης Markov (MDP). Ένα MDP περιλαμβάνει:
- Κατάσταση: πληροφορίες που περιγράφουν την τρέχουσα κατάσταση.
- Ενέργεια: μια επιλογή διαθέσιμη στον πράκτορα.
- Μετάβαση: πώς η κατάσταση αλλάζει μετά από μια ενέργεια.
- Ανταμοιβή: άμεση ανάδραση που παράγεται από μια μετάβαση.
- Πολιτική: η στρατηγική του πράκτορα για την επιλογή ενεργειών.
- Συντελεστής προεξόφλησης: πόσο έντονα οι μελλοντικές ανταμοιβές μετράνε σε σχέση με τις άμεσες ανταμοιβές.
Μια κατάσταση δεν χρειάζεται να αποκαλύπτει όλα για τον κόσμο. Όταν σημαντικές πληροφορίες κρύβονται, το πρόβλημα μπορεί να είναι μερικώς παρατηρήσιμο και ο πράκτορας μπορεί να χρειάζεται μνήμη ή κατάσταση πίστης.
Η ενίσχυση δεν είναι το ίδιο με την τιμωρία
Η ορολογία προέρχεται από την ψυχολογία συμπεριφοράς. Η θετική ενίσχυση προσθέτει μια συνέπεια που κάνει μια συμπεριφορά πιο πιθανή. Η αρνητική ενίσχυση αφαιρεί μια δυσάρεστη κατάσταση και επίσης κάνει μια συμπεριφορά πιο πιθανή. Μία ποινή που προορίζεται να κάνει μια ενέργεια λιγότερο πιθανή είναι τιμωρία, όχι αρνητική ενίσχυση.
Στη μηχανική μάθηση, οι επαγγελματίες συχνά μιλούν άμεσα για θετικές ανταμοιβές, αρνητικές ανταμοιβές, κόστη και ποινές. Το ουσιώδες ζήτημα είναι πώς αυτά τα σήματα διαμορφώνουν την απόδοση που προσπαθεί να μεγιστοποιήσει ο πράκτορας.
Απόδοση, αξία και ανάθεση πίστωσης
Μια ανταμοιβή περιγράφει μία μετάβαση. Η απόδοση συνδυάζει τις ανταμοιβές με την πάροδο του χρόνου, συνήθως προεξοφλώντας τις ανταμοιβές που έρχονται πιο μακριά στο μέλλον. Μία συνάρτηση αξίας κατάστασης εκτιμά την αναμενόμενη απόδοση από μια κατάσταση, ενώ μια συνάρτηση αξίας ενέργειας εκτιμά την αναμενόμενη απόδοση μετά τη λήψη μιας συγκεκριμένης ενέργειας σε αυτήν την κατάσταση.
Αυτό δημιουργεί το πρόβλημα ανάθεσης πίστωσης: εάν ένα χρήσιμο αποτέλεσμα εμφανιστεί πολύ αργότερα, ποιες πρώιμες ενέργειες αξίζουν την πίστωση; Οι αλγόριθμοι Ενισχυτικής Μάθησης διαφέρουν στο πώς εκτιμούν αυτή τη σχέση.
Μέθοδοι Monte Carlo και χρονικής διαφοράς
Οι μέθοδοι Monte Carlo μαθαίνουν από πλήρεις δειγματοληπτικές αποδόσεις, συνήθως μετά το τέλος ενός επεισοδίου. Οι μέθοδοι χρονικής διαφοράς (TD) ενημερώνουν μια εκτίμηση πριν το τελικό αποτέλεσμα, συνδυάζοντας την παρατηρηθείσα ανταμοιβή με μια εκτίμηση του τι έρχεται στη συνέχεια. Η μάθηση TD επομένως εκκινείται από τις τρέχουσες εκτιμήσεις αξίας της.
Κανένα από τα δύο σύνολα δεν είναι καθολικά καλύτερο. Οι στόχοι Monte Carlo είναι αμερόληπτοι υπό την δειγματοληπτική πολιτική, αλλά μπορούν να έχουν υψηλή διακύμανση και απαιτούν την ολοκλήρωση του επεισοδίου. Οι μέθοδοι TD μπορούν να μαθαίνουν σε πραγματικό χρόνο και από συνεχόμενες εργασίες, αλλά οι εκκινήσεις τους εισάγουν μεροληψία.
Εξερεύνηση έναντι αξιοποίησης
Η εξερεύνηση συλλέγει πληροφορίες δοκιμάζοντας ενέργειες των οποίων η αξία είναι αβέβαιη. Η αξιοποίηση επιλέγει την ενέργεια που πιστεύεται ότι προσφέρει την καλύτερη απόδοση. Ένας πράκτορας που ποτέ δεν εξερευνά μπορεί να εγκαταλείψει μια φτωχή στρατηγική· ένας πράκτορας που ποτέ δεν αξιοποιεί δεν εκμεταλλεύεται όσα έχει μάθει.
Απλές στρατηγικές περιλαμβάνουν την επιλογή ενέργειας epsilon-greedy, την εξερεύνηση βάσει εμπιστοσύνης, τα μπόνους εντροπίας και τις μεθόδους εσωτερικής ανταμοιβής. Σε περιβάλλοντα κρίσιμης ασφάλειας, η ανεξέλεγκτη εξερεύνηση μπορεί να είναι απαράδεκτη, οπότε η προσομοίωση, οι περιορισμοί, τα δεδομένα εκτός σύνδεσης ή η ανθρώπινη επίβλεψη γίνονται σημαντικά.
Κύριες προσεγγίσεις ενισχυτικής μάθησης
Μέθοδοι βασισμένοι στην αξία
Το Q-learning και συναφείς αλγόριθμοι μαθαίνουν τις αξίες των ενεργειών και παράγουν μια πολιτική επιλέγοντας ενέργειες υψηλής αξίας. Η Βαθιά ενισχυτική μάθηση χρησιμοποιεί νευρωνικά δίκτυα για την προσέγγιση των συναρτήσεων αξίας ή των πολιτικών όταν οι χώροι καταστάσεων είναι πολύ μεγάλοι για έναν πίνακα.
Μέθοδοι βαθμιδωτής πολιτικής
Οι μέθοδοι βαθμιδωτής πολιτικής προσαρμόζουν άμεσα μια παραμετρική πολιτική για τη βελτίωση της αναμενόμενης απόδοσης. Είναι χρήσιμες για συνεχείς ενέργειες και στοχαστικές πολιτικές, αλλά μπορούν να έχουν εκτιμήσεις κλίσης με υψηλή διακύμανση.
Μέθοδοι actor-critic
Ένας actor επιλέγει ενέργειες ενώ ένας critic εκτιμά την αξία και παρέχει σήμα μάθησης. Αυτό συνδυάζει την άμεση βελτιστοποίηση της πολιτικής με την εκτίμηση αξίας.
Μοντέλο-βασισμένη και μοντέλο-ελεύθερη Ενισχυτική Μάθηση
Τα μοντέλο-βασισμένα συστήματα μαθαίνουν ή χρησιμοποιούν ένα μοντέλο μεταβάσεων και ανταμοιβών ώστε να μπορούν να σχεδιάσουν. Τα μοντέλο-ελεύθερα συστήματα μαθαίνουν αξίες ή πολιτικές χωρίς ρητή μοντελοποίηση του περιβάλλοντος. Οι μοντέλο-βασισμένες μέθοδοι μπορούν να αξιοποιούν την εμπειρία αποδοτικά, αλλά τα σφάλματα στο εκπαιδευμένο μοντέλο μπορούν να παραπλανήσουν τον προγραμματισμό.
Ενισχυτική Μάθηση εκτός σύνδεσης
Η Ενισχυτική Μάθηση εκτός σύνδεσης μαθαίνει από ένα σταθερό σύνολο δεδομένων αντί να συλλέγει νέες αλληλεπιδράσεις κατά τη διάρκεια της εκπαίδευσης. Μπορεί να μειώσει το κόστος ή τον κίνδυνο της εξερεύνησης, αλλά ο πράκτορας πρέπει να αποφεύγει την υπερεκτίμηση ενεργειών που είναι κακώς αντιπροσωπευόμενες στα δεδομένα.
RLHF και ανθρώπινες προτιμήσεις
Η Ενισχυτική μάθηση από ανθρώπινη ανάδραση (RLHF) χρησιμοποιεί δεδομένα προτιμήσεων για την εκπαίδευση ενός σήματος ανταμοιβής ή την άμεση βελτιστοποίηση μιας πολιτικής. Έχει χρησιμοποιηθεί για την εναρμόνιση της συμπεριφοράς μοντέλων γλώσσας με ανθρώπινες κρίσεις. Η βελτιστοποίηση προτιμήσεων δεν εγγυάται την αλήθεια ή την ασφάλεια: τα αποτελέσματα εξαρτώνται από το ποιος παρείχε την ανάδραση, τι του ζητήθηκε να κρίνει και πώς σχεδιάστηκε ο στόχος.
Περιορισμοί
Η Ενισχυτική Μάθηση μπορεί να απαιτεί τεράστιους αριθμούς αλληλεπιδράσεων, να συμπεριφέρεται ασταθώς κατά την εκπαίδευση και να εκμεταλλεύεται ακούσιες συντομεύσεις σε μια συνάρτηση ανταμοιβής. Η αξιολόγηση είναι δύσκολη επειδή τα αποτελέσματα μπορούν να διαφέρουν ανάλογα με τυχαίους σπόρους και λεπτομέρειες του περιβάλλοντος. Η ισχυρή πρακτική περιλαμβάνει πολλαπλές εκτελέσεις, διαφανείς βάσεις, περιορισμένους στόχους, δοκιμές εκτός κατανομής και παρακολούθηση για παραποίηση ανταμοιβής.
Σχεδίαση προβλήματος Ενισχυτικής Μάθησης: κατάσταση, ενέργεια, ανταμοιβή και ορίζοντας
Η ενισχυτική μάθηση μοντελοποιεί διαδοχικές αποφάσεις. Το περιβάλλον παράγει μια παρατήρηση, ο πράκτορας επιλέγει μια ενέργεια βάσει μιας πολιτικής, και μια μετάβαση αποδίδει μια ανταμοιβή και την επόμενη παρατήρηση. Μια διαδικασία απόφασης Markov υποθέτει ότι η κατάσταση περιέχει τις πληροφορίες που απαιτούνται για την πρόβλεψη μελλοντικών μεταβάσεων και ανταμοιβών· η μερική παρατηρησιμότητα απαιτεί μνήμη, κατάσταση πίστης ή επαναληπτικές αναπαραστάσεις. Η προεξόφληση ελέγχει το βάρος των καθυστερημένων αποτελεσμάτων, ενώ τα επεισοδιακά και συνεχόμενα καθήκοντα απαιτούν διαφορετικούς ορισμούς απόδοσης. Κακή σχεδίαση κατάστασης ή ενέργειας μπορεί να κάνει ένα επιλύσιμο στόχο μη εκπαιδεύσιμο.
Ο σχεδιασμός της ανταμοιβής καθορίζει τη συμπεριφορά έμμεσα και αποτελεί σημαντική πηγή αποτυχίας. Ένας μεσολαβητής μπορεί να εκμεταλλευτείται: ένας πράκτορας που ανταμείβεται για ταχύτητα μπορεί να αγνοήσει την ασφάλεια, ενώ ένας που ανταμείβεται μόνο κατά την ολοκλήρωση της εργασίας μπορεί να λαμβάνει πολύ μικρό σήμα μάθησης. Προσθέστε περιορισμούς και κανόνες τερματισμού βάσει πραγματικών απαιτήσεων, δοκιμάστε την ευαισθησία της ανταμοιβής και εξετάστε τις διαδρομές για ανεπιθύμητες στρατηγικές. Οι μέθοδοι εξερεύνησης ισορροπούν τη συλλογή πληροφοριών με την αξιοποίηση της τρέχουσας γνώσης. Τα δεδομένα εκτός πολιτικής μπορούν να βελτιώσουν την αποδοτικότητα δειγμάτων, αλλά η ασυμφωνία μεταξύ της συμπεριφοράς και της στόχευσης πολιτικής απαιτεί αλγόριθμους σχεδιασμένους γι’ αυτό.
Αξιολόγηση, προσομοίωση και ασφαλής υλοποίηση
Οι μέθοδοι βασισμένες στην αξία εκτιμούν την αναμενόμενη απόδοση για καταστάσεις ή ενέργειες· οι μέθοδοι βαθμιδωτής πολιτικής βελτιστοποιούν μια παραμετρική πολιτική· οι μέθοδοι actor–critic μαθαίνουν και τα δύο. Η μοντέλο-βασισμένη Ενισχυτική Μάθηση μαθαίνει ή χρησιμοποιεί τη δυναμική των μεταβάσεων για προγραμματισμό. Η κατάλληλη οικογένεια εξαρτάται από τον τύπο της ενέργειας, τα δεδομένα, την πιστότητα του προσομοιωτή, το ορίζοντα και τις απαιτήσεις σταθερότητας. Συγκρίνετε με ευρετικές, επιβλεπόμενες και βάσεις ελέγχου θεωρίας. Αξιολογήστε τη μέση και τη χειρότερη απόδοση, τις παραβιάσεις περιορισμών, την αποδοτικότητα δειγμάτων, την ανθεκτικότητα σε αλλαγές του περιβάλλοντος και τη διακύμανση μεταξύ σπόρων αντί να επιλέξετε μια εκτέλεση με την καλύτερη καμπύλη μάθησης.
Η διαδικτυακή εξερεύνηση μπορεί να είναι απαράδεκτη στην υγειονομική περίθαλψη, τα χρηματοοικονομικά, τη ρομποτική και τις υποδομές. Εκπαιδεύστε σε προσομοίωση ή καταγεγραμμένα δεδομένα όπου είναι δυνατόν, ποσοτικοποιήστε το χάσμα προσομοιωτή-πραγματικότητας και χρησιμοποιήστε προσεκτικά την αξιολόγηση εκτός πολιτικής επειδή οι αόρατες ενέργειες δεν έχουν υποστήριξη. Η υλοποίηση πρέπει να περιορίζει τις ενέργειες, το ρυθμό, τους πόρους και την περιοχή λειτουργίας· να περιλαμβάνει ανθρώπινη έγκριση για κρίσιμες επιλογές· και να παρέχει έναν ασφαλή ελεγκτή ή τερματισμό. Παρακολουθήστε την ανταμοιβή μαζί με τα πραγματικά αποτελέσματα επειδή ένας πράκτορας μπορεί να βελτιώσει το σκορ του ενώ βλάπτει τον προοριζόμενο στόχο. Επαναεπαληθεύστε μετά από αλλαγές στο περιβάλλον, την πολιτική ή την ανταμοιβή.
Παράδειγμα εφαρμογής: έλεγχος ενέργειας με ενισχυτική μάθηση
Ένας διαχειριστής κτιρίου μοντελοποιεί τη θερμοκρασία, την κατοίκηση, τον καιρό, την κατάσταση του εξοπλισμού και την τιμή του ηλεκτρικού ρεύματος, με ενέργειες περιορισμένες σε ασφαλείς ρυθμίσεις σημείου. Η ανταμοιβή συνδυάζει άνεση, ενέργεια, χρεώσεις ζήτησης και περιορισμούς εξοπλισμού, αλλά οι πραγματικές παραβιάσεις άνεσης αξιολογούνται ξεχωριστά ώστε η βελτιστοποίηση της ανταμοιβής να μην κρύβει βλάβες. Ο ιστορικός έλεγχος και ο έλεγχος προβλέψεων μοντέλου παρέχουν βάσεις. Η εκπαίδευση χρησιμοποιεί ένα βαθμονομημένο προσομοιωτή με τυχαίο καιρό, θόρυβο αισθητήρων και αποδοτικότητα εξοπλισμού.
Πριν επηρεάσει το κτίριο, η πολιτική εκτελείται σε ζωντανές παρατηρήσεις χωρίς ενέργεια. Οι μηχανικοί ελέγχουν τις διαδρομές, τα περιθώρια περιορισμών και τη συμπεριφορά κατά τις διακοπές, τις κυμάτων θερμότητας, τις διακοπές ρεύματος και τις ελλιπείς αισθητήρες. Η υλοποίηση περιορίζει το ρυθμό και το εύρος των ενεργειών και διατηρεί τον υπάρχοντα ελεγκτή ασφαλείας. Ένα άτομο μπορεί να παρέμβει ανά πάσα στιγμή. Η παρακολούθηση συγκρίνει την ενέργεια και την άνεση με αντίστοιχες περιόδους, καταγράφει παρεμβάσεις και επαναφέρει εάν οι παραβιάσεις, η απρόσμενη κυκλική λειτουργία ή η ασυμφωνία μοντέλου υπερβαίνουν τα καθορισμένα όρια.
Απόδειξη υλοποίησης και ετοιμότητα λειτουργίας
Μια απόφαση παραγωγής απαιτεί περισσότερα από μια επιτυχημένη επίδειξη. Ορίστε τους προοριζόμενους χρήστες, το λειτουργικό περιβάλλον, τις εισόδους, τις εξόδους, τις εξαρτήσεις, τον κάτοχο και τις συνέπειες κάθε σημαντικής αποτυχίας. Καθιερώστε μια επαναλήψιμη βάση και ένα εκδοσιακό σύνολο αξιολόγησης πριν τη ρύθμιση. Δοκιμάστε τυπικές περιπτώσεις, όρια, εσφαλμένες ή ελλιπείς εισόδους, μεταβολή κατανομής, διακοπή εξαρτήσεων, κακή χρήση και τις ομάδες ή τα περιβάλλοντα που είναι πιο πιθανό να παραμελούνται. Μετρήστε την ποιότητα της εργασίας μαζί με την βαθμονόμηση ή την αβεβαιότητα, την καθυστέρηση, τη διαπερατότητα, το κόστος πόρων, την προσβασιμότητα, την ιδιωτικότητα και την ασφάλεια. Καταγράψτε κάθε μετασχηματισμό και όριο ώστε ένας ανεξάρτητος ελεγκτής να μπορεί να αναπαράγει το αποτέλεσμα και να διακρίνει την απόδειξη από ένα ελκυστικό πρωτότυπο.
Πριν την κυκλοφορία, εκχωρήστε εξουσία για την κυκλοφορία, εξαιρέσεις, αλλαγές, επαναφορά και απόσυρση. Χρησιμοποιήστε σταδιακή κυκλοφορία, διατηρήστε ένα ασφαλές εφεδρικό σύστημα και επαληθεύστε την παρακολούθηση με σκόπιμα ενσωματωμένες αποτυχίες. Η λειτουργική τηλεμετρία πρέπει να αποκαλύπτει την ποιότητα των εισόδων, τη συμπεριφορά των εξόδων, την έκδοση του μοντέλου ή του κανόνα, την υγεία των εξαρτήσεων, τις ανθρώπινες παρεμβάσεις και τα επιβεβαιωμένα αποτελέσματα χωρίς τη συλλογή περιττών ευαίσθητων δεδομένων. Ορίστε όρια ειδοποίησης και υπεύθυνο απόκρισης, στη συνέχεια ελέγξτε τα πραγματικά αποδεικτικά στοιχεία μετά την υλοποίηση αντί να υποθέτετε ότι η εκτός σύνδεσης απόδοση θα παραμείνει. Επανεκτιμήστε όποτε αλλάξουν οι πηγές δεδομένων, οι χρήστες, τα μοντέλα, οι προμηθευτές, οι πολιτικές, το υλικό ή οι στόχοι. Ένα διατηρημένο σύστημα χρειάζεται επίσης τεκμηριωμένη αποκατάσταση, εκμάθηση περιστατικών, διαδικασίες διαγραφής και διατήρησης και ένα σαφές σημείο στο οποίο πρέπει να απενεργοποιηθεί ή να αντικατασταθεί.
Κύριες αναφορές












