
Βασικές αρχές της AI
Τι είναι η Βαθιά Ενισχυτική Μάθηση;

 Προσθέστε το Unite.AI στις προτιμώμενες πηγές σας στο Google
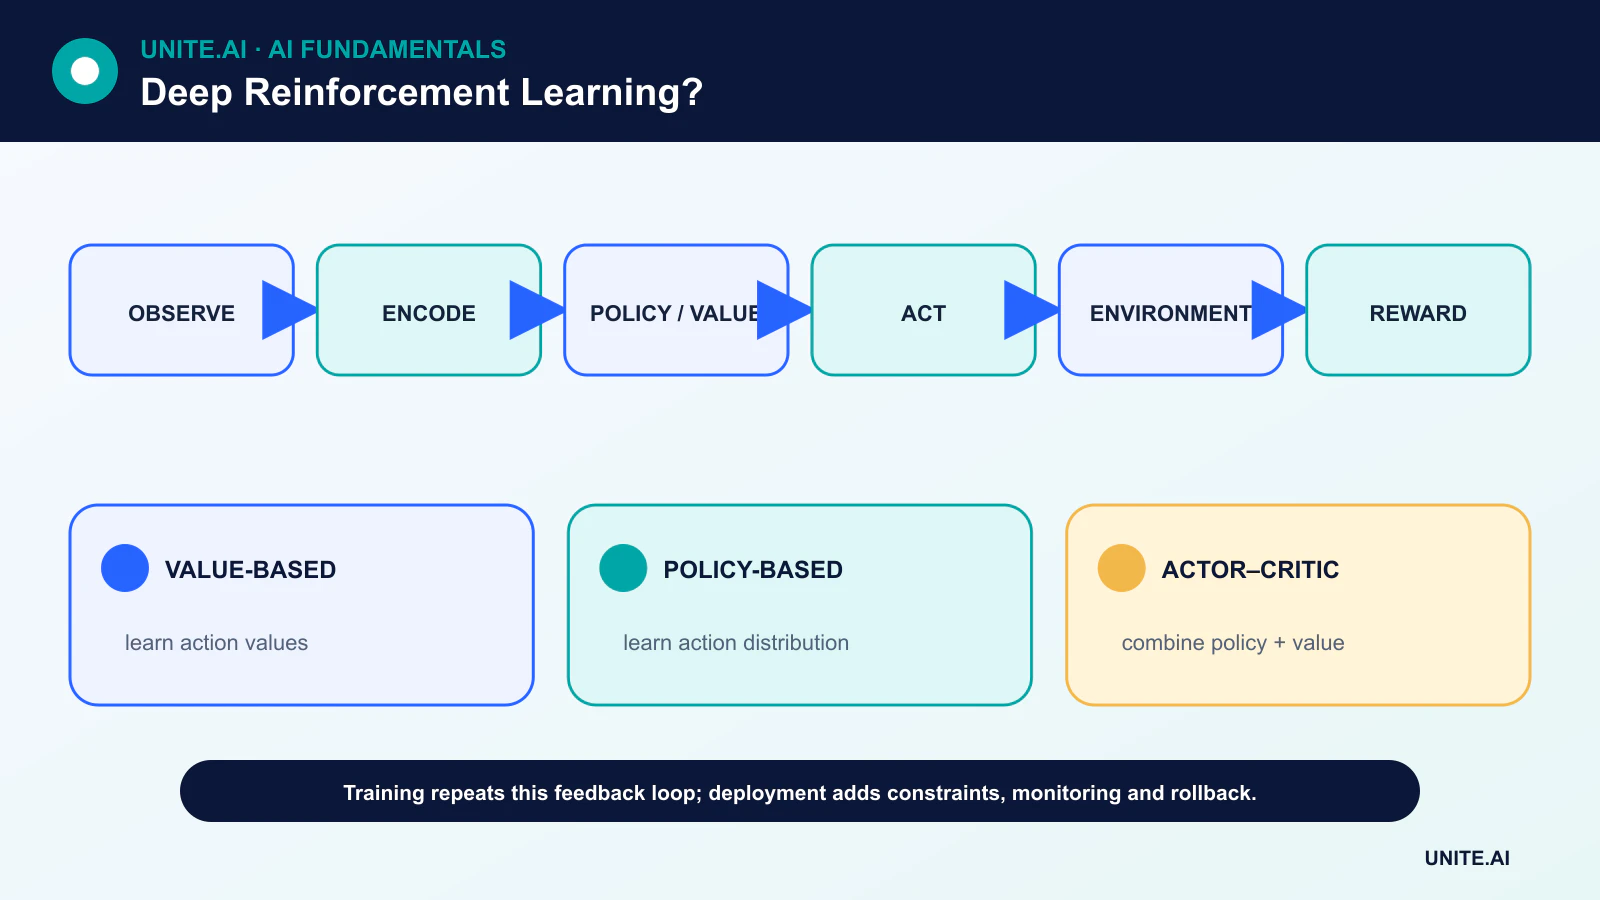
Βαθιά ενισχυτική μάθηση (deep RL) συνδυάζει την ενισχυτική μάθηση με βαθιά νευρωνικά δίκτυα. Ένας πράκτορας παρατηρεί μια κατάσταση, επιλέγει μια ενέργεια, λαμβάνει μια ανταμοιβή και μια νέα παρατήρηση, έπειτα προσαρμόζει μια πολιτική ή συνάρτηση αξίας για να βελτιώσει τις μελλοντικές αποφάσεις.
Το βαθύ δίκτυο δεν αφαιρεί τα δύσκολα μέρη της ενισχυτικής μάθησης. Παρέχει έναν ευέλικτο τρόπο για την αναπαράσταση εικόνων, ροών αισθητήρων, μεγάλων χώρων ενεργειών ή σύνθετων συναρτήσεων αξίας. Η εξερεύνηση, η καθυστερημένη αποζημίωση, η ασταθής εκπαίδευση και η ασφαλής αξιολόγηση στον πραγματικό κόσμο παραμένουν κεντρικά προβλήματα μηχανικής.
Βασικά σημεία
- Η βαθιά ενισχυτική μάθηση μαθαίνει διαδοχικές αποφάσεις από αλληλεπίδραση αντί για έναν σταθερό πίνακα επισημασμένων παραδειγμάτων.
- Οι μέθοδοι βάσει αξίας εκτιμούν πόσο καλές είναι οι ενέργειες· οι μέθοδοι πολιτικής μαθαίνουν άμεσα την κατανομή των ενεργειών· οι μέθοδοι ηθοποιού‑κριτικού συνδυάζουν και τα δύο.
- Οι προσωρινές μνήμες επανάληψης, τα δίκτυα‑στόχοι και ο προσεκτικός σχεδιασμός ανταμοιβής μπορούν να βελτιώσουν την εκπαίδευση, αλλά κανένα δεν εγγυάται αξιόπιστη συμπεριφορά.
- Ένα υψηλό σκορ προσομοιωτή δεν αποτελεί απόδειξη ανθεκτικότητας, ασφάλειας ή επιτυχούς μεταφοράς στον φυσικό κόσμο.
Το πρόβλημα λήψης αποφάσεων: καταστάσεις, ενέργειες και ανταμοιβές
Πολλές εργασίες βαθιάς ενισχυτικής μάθησης μοντελοποιούνται ως διαδικασία λήψης αποφάσεων Markov. Στο χρόνο t, ο πράκτορας λαμβάνει κατάσταση ή παρατήρηση st, επιλέγει ενέργεια at, στη συνέχεια λαμβάνει ανταμοιβή rt+1 και την επόμενη κατάσταση. Ο στόχος είναι η αναμενόμενη προεξοφλημένη απόδοση, όχι απαραίτητα μόνο η επόμενη ανταμοιβή.
Ο παράγοντας προεξόφλησης ελέγχει πόσο σημαντικές είναι οι απομακρυσμένες ανταμοιβές. Μια συνάρτηση ανταμοιβής ορίζει τι θα επιδιώκει η διαδικασία βελτιστοποίησης, έτσι ώστε ένας ελλιπής δείκτης μπορεί να παράγει συμπεριφορά που είναι τεχνικά επιτυχής αλλά λειτουργικά ανεπιθύμητη. Αυτός είναι ένας λόγος για τον οποίο ο σχεδιασμός ανταμοιβής και οι δοκιμές περιορισμών αξίζουν την ίδια προσοχή με την αρχιτεκτονική του μοντέλου.
Μέθοδοι βάσει αξίας, βάσει πολιτικής και ηθοποιού‑κριτικού
Ένας αλγόριθμος βάσει αξίας εκτιμά την αξία μιας κατάστασης ή μιας ενέργειας. Τα Deep Q‑networks χρησιμοποιούν ένα νευρωνικό δίκτυο για την προσέγγιση των Q‑τιμών και συνήθως επιλέγουν την ενέργεια με τη μεγαλύτερη εκτίμηση, διατηρώντας κάποια εξερεύνηση. Ένας αλγόριθμος gradient πολιτικής, αντίθετα, βελτιστοποιεί μια παραμετροποιημένη πολιτική που παράγει μια κατανομή ενεργειών.
Τα συστήματα ηθοποιού‑κριτικού διατηρούν τόσο έναν ηθοποιό, που προτείνει ενέργειες, όσο και έναν κριτικό, που εκτιμά την αξία τους. Αυτός ο σχεδιασμός υποστηρίζει συνεχή έλεγχο, αλλά εισάγει αλληλεπιδραστικές πηγές σφάλματος εκτίμησης. Η βαθιά ενισχυτική μάθηση εξαρτάται επομένως από τις ίδιες βάσεις όπως το deep learning, η gradient descent και η backpropagation.
Γιατί οι προσωρινές μνήμες επανάληψης και τα δίκτυα‑στόχοι βοηθούν
Διαδοχικά δείγματα εμπειρίας είναι συσχετισμένα, ενώ μια ενημέρωση δικτύου αλλάζει τους στόχους που χρησιμοποιούνται από μεταγενέστερες ενημερώσεις. Η επανάληψη εμπειρίας σπάζει μέρος αυτής της χρονικής συσχέτισης επιλέγοντας παλαιότερες μεταβάσεις. Ένα δίκτυο‑στόχος αλλάζει πιο αργά από το διαδικτυακό δίκτυο, καθιστώντας τους εκτιμώμενους στόχους λιγότερο ασταθείς.
Αυτοί οι μηχανισμοί βελτιώνουν τη σταθερότητα της εκπαίδευσης, αλλά η ρύθμιση παραμένει σημαντική. Ο ρυθμός μάθησης, το πρόγραμμα εξερεύνησης, η κλίμακα ανταμοιβής, η σύνθεση της επανάληψης και η χωρητικότητα του δικτύου μπορούν όλα να αλλάξουν το αποτέλεσμα. Πρέπει να αναφέρονται πολλαπλοί τυχαίοι σπόροι, επειδή μια μοναδική εκτέλεση μπορεί να είναι παραπλανητική.
Ανενεργή Ενισχυτική Μάθηση, Μοντέλο‑βασισμένη Ενισχυτική Μάθηση και προσομοίωση‑προς‑πραγματικότητα
Η ανενεργή ενισχυτική μάθηση μαθαίνει από ένα σταθερό καταγεγραμμένο σύνολο δεδομένων χωρίς τη συλλογή νέων αλληλεπιδράσεων. Μπορεί να είναι χρήσιμη όταν η εξερεύνηση είναι δαπανηρή ή μη ασφαλής, αλλά η πολιτική πρέπει να αποφεύγει ενέργειες που είναι κακώς αντιπροσωπευμένες στο αρχείο. Η μοντέλο‑βασισμένη ενισχυτική μάθηση μαθαίνει ή χρησιμοποιεί ένα μοντέλο μετάβασης για να σχεδιάσει, ανταλλάσσοντας πρόσθετες υποθέσεις για αποδοτικότητα δειγμάτων.
Η ρομποτική συχνά εκπαιδεύεται σε προσομοίωση, τυχαιοποιεί φυσικές παραμέτρους, και στη συνέχεια κάνει λεπτορύθμιση ή επικυρώνεται σε υλικό. Το χάσμα πραγματικότητας μπορεί ακόμη να αποκαλύψει σφάλματα στην αντίληψη, το χρονοπρογραμματισμό, τη δυναμική επαφής και αμεταχειρισμένες ακραίες περιπτώσεις. Ένα σύστημα reinforcement‑learning πρέπει να αξιολογείται υπό διαταραχές, μεταβολή κατανομής και ρητούς περιορισμούς ασφαλείας.
Αξιολόγηση και υλοποίηση
Μια χρήσιμη αξιολόγηση διαχωρίζει τα περιβάλλοντα εκπαίδευσης και δοκιμής, αναφέρει τις κατανομές απόδοσης αντί μόνο του καλύτερου σκορ, και ελέγχει τις παραβιάσεις περιορισμών, τη συχνότητα παρεμβάσεων και τη συμπεριφορά στην χειρότερη περίπτωση. Για πραγματικά συστήματα, οι ομάδες χρειάζονται επίσης παρακολούθηση, διαδικασίες επαναφοράς, περιορισμένους χώρους ενεργειών και ανθρώπινη παρέμβαση.
Η βαθιά ενισχυτική μάθηση είναι πιο ελκυστική όταν οι αποφάσεις είναι διαδοχικές, υπάρχει ανάδραση και οι χειροκίνητοι κανόνες ελέγχου είναι ανεπαρκείς. Είναι ακατάλληλη ως προεπιλογή όταν υπάρχουν άφθονα επιβλεπόμενα ετικέτες, ένας συμβατικός βελτιστοποιητής λύνει το πρόβλημα ή η εξερεύνηση θα θέσει σε κίνδυνο ανθρώπους ή περιουσιακά στοιχεία.
Αρχιτεκτονικές βαθιάς Ενισχυτικής Μάθησης και σήματα εκπαίδευσης
Η βαθιά ενισχυτική μάθηση χρησιμοποιεί νευρωνικά δίκτυα για την αναπαράσταση μιας συνάρτησης αξίας, πολιτικής, μοντέλου περιβάλλοντος ή κάποιου συνδυασμού. Ένα deep Q‑network προβλέπει τις αξίες ενεργειών και μαθαίνει από στόχους χρονικής διαφοράς· η επανάληψη εμπειρίας μειώνει τη συσχέτιση μεταξύ των ενημερώσεων, ενώ ένα δίκτυο‑στόχος σταθεροποιεί το μεταβαλλόμενο στόχο. Οι μέθοδοι gradient πολιτικής βελτιστοποιούν άμεσα την αναμενόμενη απόδοση, και οι μέθοδοι ηθοποιού‑κριτικού χρησιμοποιούν έναν εκπαιδευμένο κριτικό για τη μείωση της διακύμανσης του gradient. Οι συνεχείς ενέργειες συχνά απαιτούν καθοριστικές ή στοχαστικές παραλλαγές ηθοποιού‑κριτικού, ενώ οι διακριτές υψηλής διάστασης ενέργειες χρειάζονται προσεκτική εξερεύνηση και σχεδίαση εξόδου.
Η εκπαίδευση είναι μη στάσιμη επειδή η πολιτική αλλάζει τα δεδομένα που συλλέγει. Τα δεδομένα επανάληψης γίνονται εκτός‑πολιτικής, οι εκτιμώμενοι στόχοι εξαρτώνται από τις τρέχουσες εκτιμήσεις, και η προσέγγιση συναρτήσεων μπορεί να ενισχύσει τα σφάλματα — ο συνδυασμός αυτός μερικές φορές αποκαλείται η θανατηφόρα τριάδα. Οι διπλοί εκτιμητές μειώνουν την υπερεκτίμηση αξίας· οι συναρτήσεις πλεονεκτήματος βελτιώνουν την ανάθεση πίστωσης· τα μπόνους εντροπίας ενθαρρύνουν την εξερεύνηση· οι περιορισμένες (clipped) στόχοι περιορίζουν καταστροφικές ενημερώσεις πολιτικής. Κανονικοποιήστε τις παρατηρήσεις και τις ανταμοιβές μόνο με κατάσταση ασφαλής διαρροής, και καταγράψτε το περιβάλλον, το wrapper, την επανάληψη ενέργειας, τον τερματισμό και την προεπεξεργασία ανταμοιβής, επειδή το καθένα αλλάζει το πρόβλημα.
Αξιολόγηση, προσομοιωτές και ασφάλεια υλοποίησης
Αναφέρετε τις κατανομές απόδοσης σε ανεξάρτητα σπόρους και παραδείγματα περιβάλλοντος, όχι μόνο την καλύτερη εκτέλεση. Αξιολογήστε την αποδοτικότητα δειγμάτων, τις παραβιάσεις περιορισμών, τις καταστροφικές εκβάσεις, την ευαισθησία στην κλίμακα ανταμοιβής και την ανθεκτικότητα στον θόρυβο παρατήρησης, την καθυστέρηση, το σφάλμα ενεργοποιητή και τις αλλαγές δυναμικής. Συγκρίνετε με ελεγχόμενη σκριπτοποίηση, κλασικό έλεγχο, επιβλεπόμενη μίμηση και πιο απλή ενισχυτική μάθηση. Διατηρήστε εκτός τις παραλλαγές του περιβάλλοντος και δοκιμάστε μετρικές αποτελεσμάτων χωρίς ανταμοιβή, επειδή ένας πράκτορας μπορεί να εκμεταλλευτεί την προγραμματισμένη ανταμοιβή ενώ αποτυγχάνει τον προοριζόμενο στόχο. Η επιθεώρηση βίντεο και τροχιών συχνά αποκαλύπτει συμπεριφορές κρυμμένες από τη συνολική απόδοση.
Η προσομοίωση επιτρέπει την εξερεύνηση αλλά εισάγει ένα χάσμα πραγματικότητας. Τυχαιοποιήστε τη σχετική φυσική και αντίληψη, βαθμονομήστε με πραγματικές μετρήσεις και χρησιμοποιήστε συντηρητική μεταφορά. Τα καταγεγραμμένα δεδομένα ή η ανενεργή ενισχυτική μάθηση αποφεύγουν την online εξερεύνηση, αλλά δεν μπορούν να αξιολογήσουν αξιόπιστα ενέργειες που δεν υποστηρίζονται από την πολιτική συμπεριφοράς. Τα παραγωγικά συστήματα πρέπει να περιορίζουν το σύνολο ενεργειών, το ρυθμό, τους πόρους και το λειτουργικό εύρος· να απαιτούν έγκριση για ενέργειες υψηλής επίπτωσης· και να περιλαμβάνουν έναν επαληθευμένο ασφαλή ελεγκτή ή διακοπή. Παρακολουθείτε τις εισόδους της πολιτικής, την κατανομή ενεργειών, την ανταμοιβή, τα πραγματικά αποτελέσματα και τις παρεμβάσεις, με επαναφορά σε δοκιμασμένη έκδοση πολιτικής.
Ένα συγκεκριμένο παράδειγμα ελέγχου
Για τη δρομολόγηση ρομπότ αποθήκης, ορίστε την κατάσταση από την τοποθεσία, το φορτίο, την μπαταρία, την κοντινή κίνηση και την ουρά εργασιών· τις ενέργειες από τις επιτρεπτές κινήσεις και τις αποφάσεις φόρτισης· και την ανταμοιβή από την ολοκληρωμένη εργασία, την ενέργεια, τη συμφόρηση και τους περιορισμούς ασφαλείας. Εκπαιδεύστε πρώτα σε ένα βαθμονομημένο προσομοιωτή με τυχαία ζήτηση και σφάλματα αισθητήρων, έπειτα σκιώστε τις πραγματικές αποφάσεις. Ποτέ μην επιτρέψετε στην εκπαιδευμένη πολιτική να παρακάμψει την αποφυγή σύγκρουσης. Αξιολογήστε τη ροή εργασιών μαζί με τα σχεδόν ατυχήματα, τα μπλοκαρίσματα, τις εκτάκτες μπαταρίας και την χειρότερη καθυστέρηση. Το έργο επιτυγχάνει μόνο εάν το στρωματοποιημένο σύστημα βελτιώνει τις λειτουργίες χωρίς να μεταφέρει ανεπίτρεπτο κίνδυνο εξερεύνησης σε ανθρώπους ή εξοπλισμό.
Παράδειγμα εφαρμογής: DRL για ψύξη κέντρου δεδομένων
Ένα κέντρο δεδομένων περιορίζει έναν πράκτορα RL σε εγκεκριμένα σημεία ψύξης και το εκπαιδεύει σε προσομοιωτή βαθμονομημένο από ιστορικά δεδομένα καιρού, φορτίου εργασίας, θερμοκρασιών και ανταπόκριση εξοπλισμού. Η ανταμοιβή περιλαμβάνει την ενέργεια, αλλά σκληροί περιορισμοί προστατεύουν ξεχωριστά τη θερμοκρασία, την υγρασία και τον κύκλο λειτουργίας του εξοπλισμού. Ο έλεγχος προβλεπτικού μοντέλου και οι υπάρχουσες κανόνες αποτελούν βασικές γραμμές. Η αξιολόγηση καλύπτει εποχές, θόρυβο αισθητήρων, καθυστέρηση ενεργοποιητή, απώλεια εξοπλισμού, ασυνήθιστα φορτία και πολλαπλούς σπόρους, αναφέροντας ενέργεια, παραβιάσεις, διακύμανση και αποκατάσταση.
Η εκπαιδευμένη πολιτική λειτουργεί σε λειτουργία σκιάς πριν από μια δοκιμή περιορισμένης ζώνης. Ένας εξωτερικός ελεγκτής ασφαλείας περιορίζει τις ενέργειες και οι χειριστές μπορούν να παρέμβουν. Ο ρυθμός ενεργειών, η κάλυψη κατάστασης, η αβεβαιότητα του μοντέλου και τα πραγματικά αποτελέσματα της εγκατάστασης παρακολουθούνται· η ασυμφωνία προσομοιωτή ή η επαναλαμβανόμενη παρέμβαση ενεργοποιούν επαναφορά. Η ενημέρωση εξοπλισμού ή λογικής ελέγχου δημιουργεί μια νέα έκδοση περιβάλλοντος και επικύρωση. Οι εξοικονομήσεις ενέργειας γίνονται αποδεκτές μόνο όταν η αξιοπιστία, το θερμικό περιθώριο, η συντήρηση και η ανταπόκριση σε σφάλματα παραμένουν τουλάχιστον τόσο ισχυρές όσο η βασική γραμμή.
Απόδειξη υλοποίησης και ετοιμότητα λειτουργίας
Μια απόφαση παραγωγής απαιτεί περισσότερα από μια επιτυχημένη επίδειξη. Ορίστε τους προοριζόμενους χρήστες, το λειτουργικό περιβάλλον, τις εισόδους, τις εξόδους, τις εξαρτήσεις, τον ιδιοκτήτη και τις συνέπειες κάθε σημαντικής αποτυχίας. Καθιερώστε μια επαναλήψιμη βάση και ένα εκδοχικό σύνολο αξιολόγησης πριν από τη ρύθμιση. Δοκιμάστε τυπικές περιπτώσεις, όρια, εσφαλμένες ή ελλιπείς εισόδους, μεταβολή κατανομής, διακοπή εξαρτήσεων, κακή χρήση, και τις ομάδες ή τα περιβάλλοντα που είναι πιο πιθανό να υπολειτουργούν. Μετρήστε την ποιότητα της εργασίας μαζί με τη βαθμονόμηση ή την αβεβαιότητα, την καθυστέρηση, τη ροή εργασιών, το κόστος πόρων, την προσβασιμότητα, την ιδιωτικότητα και την ασφάλεια. Καταγράψτε κάθε μετασχηματισμό και όριο ώστε ένας ανεξάρτητος αξιολογητής να μπορεί να αναπαράγει το αποτέλεσμα και να διακρίνει την απόδειξη από ένα ελκυστικό πρωτότυπο.
Πριν την κυκλοφορία, εκχωρήστε εξουσία για την έκδοση, τις εξαιρέσεις, τις αλλαγές, την επαναφορά και τη συνταγική. Χρησιμοποιήστε σταδιακή κυκλοφορία, διατηρήστε ένα ασφαλές εφεδρικό και επαληθεύστε την παρακολούθηση με σκόπιμα ενσωματωμένες αποτυχίες. Η λειτουργική τηλεμετρία πρέπει να αποκαλύπτει την ποιότητα των εισόδων, τη συμπεριφορά των εξόδων, την έκδοση του μοντέλου ή του κανόνα, την υγεία των εξαρτήσεων, τις ανθρώπινες παρεμβάσεις και τα επιβεβαιωμένα αποτελέσματα χωρίς τη συλλογή περιττών ευαίσθητων δεδομένων. Ορίστε όρια ειδοποιήσεων και υπεύθυνο αντίδρασης, έπειτα ελέγξτε τα πραγματικά αποδεικτικά στοιχεία μετά την υλοποίηση αντί να υποθέτετε ότι η εκτός‑γραμμής απόδοση θα παραμείνει. Επαναξιολογήστε όποτε αλλάξουν οι πηγές δεδομένων, οι χρήστες, τα μοντέλα, οι προμηθευτές, οι πολιτικές, το υλικό ή οι στόχοι. Ένα συντηρημένο σύστημα χρειάζεται επίσης τεκμηριωμένη αποκατάσταση, εκμάθηση περιστατικών, διαδικασίες διαγραφής και διατήρησης, και ένα σαφές σημείο στο οποίο πρέπει να απενεργοποιηθεί ή να αντικατασταθεί.
Συχνές ερωτήσεις
Είναι η βαθιά ενισχυτική μάθηση η ίδια με τη βαθιά μάθηση;
Όχι. Η βαθιά μάθηση παρέχει τους προσεγγιστικούς συναρτήσεων· η ενισχυτική μάθηση παρέχει την αλληλεπίδραση, την ανταμοιβή και τον στόχο διαδοχικής λήψης αποφάσεων.
Σημαίνει μια υψηλή ανταμοιβή ότι ο πράκτορας έμαθε τη ζητούμενη συμπεριφορά;
Όχι απαραίτητα. Σημαίνει ότι η πολιτική βρήκε συμπεριφορά που αποδίδει καλά σύμφωνα με την υλοποιημένη ανταμοιβή και το περιβάλλον. Απαιτούνται ακόμη ανεξάρτητες δοκιμές ασφαλείας και ευθυγράμμισης με τον στόχο.
Κύριες αναφορές












