
Τα καλύτερα
10 Καλύτεροι Αλγόριθμοι Μηχανικής Μάθησης

 Προσθέστε το Unite.AI στις προτιμώμενες πηγές σας στο Google
Βασικά σημείαΤα Transformers επανάστασαν την Επεξεργασία Φυσικής Γλώσσας (NLP) επιτρέποντας…
Δείτε περισσότερα
- Τα Transformers επανάστασαν την Επεξεργασία Φυσικής Γλώσσας (NLP) επιτρέποντας παράλληλη επεξεργασία και μόνιμη μνήμη, σε αντίθεση με τα RNNs.
- Τα GANs αναγκάζουν τους γεννήτορες να εξερευνούν ποικίλες λύσεις, αποκρύπτοντας την ανατροφοδότηση σφάλματος του διακριτή.
- Οι K-Πλησιέστεροι Γείτονες του 1951 εξακολουθούν να υπερέχουν έναντι σύγχρονων αλγορίθμων στην πρόβλεψη αποχώρησης εργαζομένων.
Αν και ζούμε σε μια εποχή εξαιρετικής καινοτομίας στη μηχανική μάθηση με επιτάχυνση GPU, οι τελευταίες έρευνες συχνά (και εξέχοντα) περιλαμβάνουν αλγόριθμους που είναι δεκαετίες, σε ορισμένες περιπτώσεις 70 χρόνια παλιοί.
Ορισμένοι μπορεί να υποστηρίξουν ότι πολλές από αυτές τις παλαιότερες μεθόδους ανήκουν στην κατηγορία της ‘στατιστικής ανάλυσης’ και όχι της μηχανικής μάθησης, και προτιμούν να χρονολογούν την έναρξη του τομέα μόνο μέχρι το 1957, με την εφεύρεση του Perceptron.
Λόγω του βαθμού στον οποίο αυτοί οι παλαιότεροι αλγόριθμοι υποστηρίζουν και είναι διαπλεγμένοι στις τελευταίες τάσεις και τις εξελίξεις της μηχανικής μάθησης, είναι μια αμφισβητούμενη θέση. Έτσι, ας δούμε μερικά από τα ‘κλασικά’ δομικά στοιχεία που υποστηρίζουν τις τελευταίες καινοτομίες, καθώς και μερικά νέα που κάνουν μια πρώιμη προσφορά για το πάνθεον της τεχνητής νοημοσύνης.
1: Μετασχηματιστές
Το 2017, η ερευνητική ομάδα του Google ηγήθηκε μιας ερευνητικής συνεργασίας που οδήγησε στην έκδοση του εγγράφου Attention Is All You Need. Το έργο περιέγραψε μια νέα αρχιτεκτονική που προώθησε μηχανισμούς προσοχής από βοηθητικά στοιχεία μοντέλων κωδικοποιητή/αποκωδικοποιητή και αναδρομικών δικτύων σε αυτοτελή κεντρική μετασχηματιστική τεχνολογία.
Η προσέγγιση ονομάστηκε Μετασχηματιστής, και έχει γίνει μια επαναστατική μεθοδολογία στην επεξεργασία φυσικής γλώσσας (NLP), ενεργοποιώντας, μεταξύ άλλων, το αυτοπαλινδρομικό γλωσσικό μοντέλο και σύμβολο της τεχνητής νοημοσύνης GPT-3.

Οι μετασχηματιστές έλυσαν με επιτυχία το πρόβλημα της μετατροπής ακολουθιών, επίσης γνωστό ως ‘μετασχηματισμός’, το οποίο ασχολείται με την επεξεργασία εισαγωγικών ακολουθιών σε εξαγωγικές ακολουθίες. Ένας μετασχηματιστής επίσης λαμβάνει και διαχειρίζεται δεδομένα με συνεχή τρόπο, αντί σε ακολουθίες δέσμης, επιτρέποντας μια ‘διατήρηση της μνήμης’ που οι αρχιτεκτονικές RNN δεν είναι σχεδιασμένες να επιτύχουν. Για μια πιο λεπτομερή επισκόπηση των μετασχηματιστών, δείτε το άρθρο αναφοράς μας.
Σε αντίθεση με τα Αναδρομικά Νευρωνικά Δίκτυα (RNN) που είχαν αρχίσει να κυριαρχούν στην έρευνα ML στην εποχή CUDA, η αρχιτεκτονική των Μετασχηματιστών μπορούσε επίσης να παραλληλοποιηθεί εύκολα, ανοίγοντας τον δρόμο για να αντιμετωπιστούν παραγωγικά ένα πολύ μεγαλύτερο σώμα δεδομένων από τα RNN.
Συνήθεις χρήσεις
Οι μετασχηματιστές κατέλαβαν τη φαντασία του κοινού το 2020 με την κυκλοφορία του GPT-3 της OpenAI, το οποίο είχε ένα τότε ρεκόρ-σπάζοντα 175 δισεκατομμύρια παραμέτρους. Αυτό το φαινομενικά εκπληκτικό επίτευγμα τελικά επισκιάστηκε από μεταγενέστερα έργα, όπως η εκδοση του Megatron-Turing NLG 530B της Microsoft το 2021, το οποίο (όπως υποδηλώνει το όνομα) διαθέτει πάνω από 530 δισεκατομμύρια παραμέτρους.

Χρονοδιάγραμμα υπερκλίμακας έργων NLP Μετασχηματιστών. Πηγή: Microsoft
Η αρχιτεκτονική των μετασχηματιστών έχει επίσης διασχίσει από την NLP στην οπτική αναγνώριση, ενεργοποιώντας μια νέα γενιά πλαισίων σύνθεσης εικόνων όπως το CLIP και το DALL-E της OpenAI, τα οποία χρησιμοποιούν χαρτογράφηση τομέα κειμένου-εικόνας για να ολοκληρώσουν ατελείς εικόνες και να συνθέσουν νέες εικόνες από εκπαιδευμένους τομείς, μεταξύ μιας αυξανόμενης σειράς σχετικών εφαρμογών.
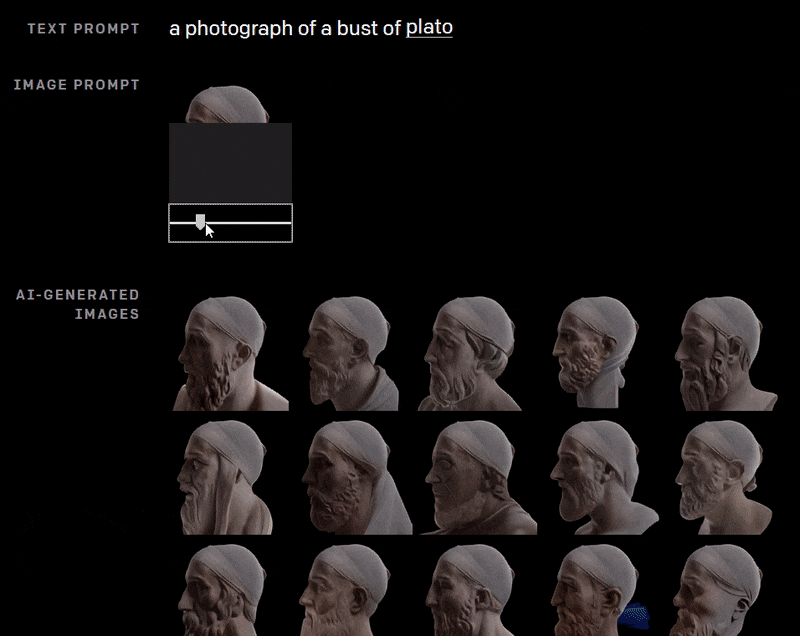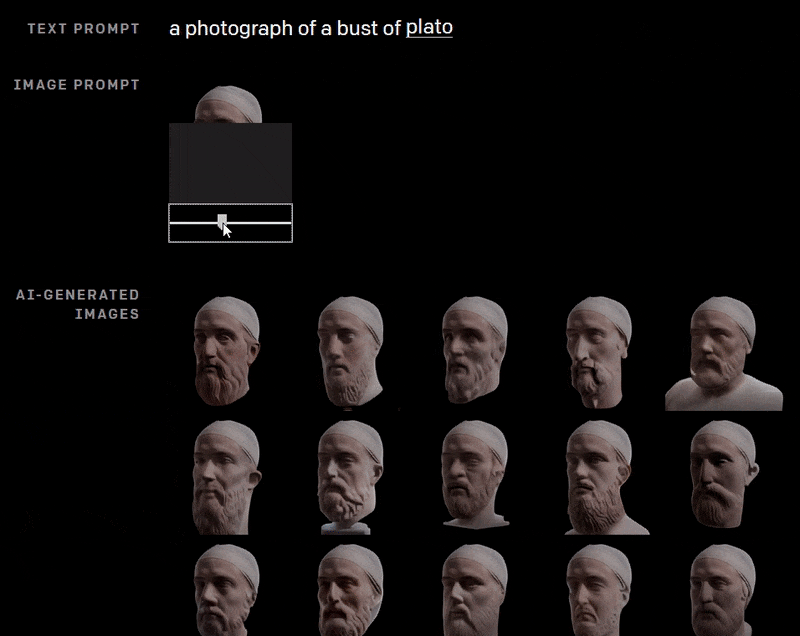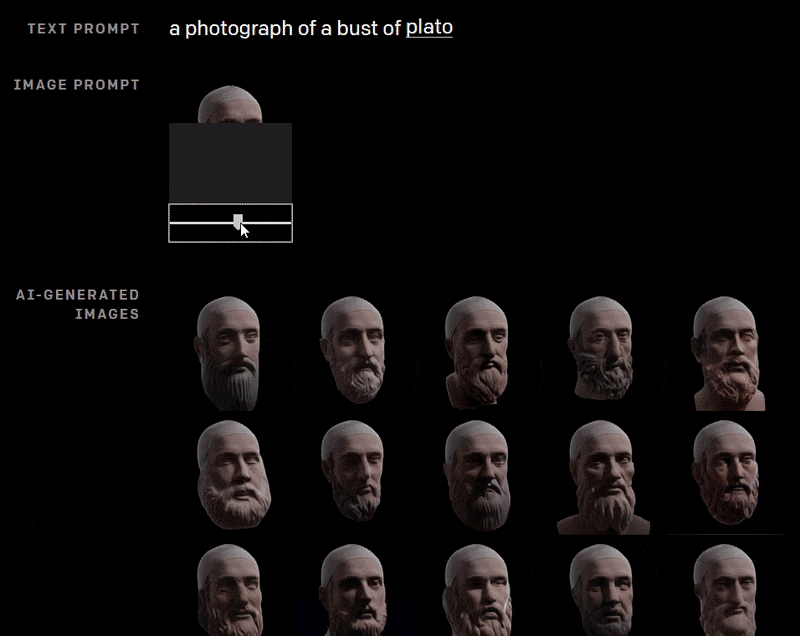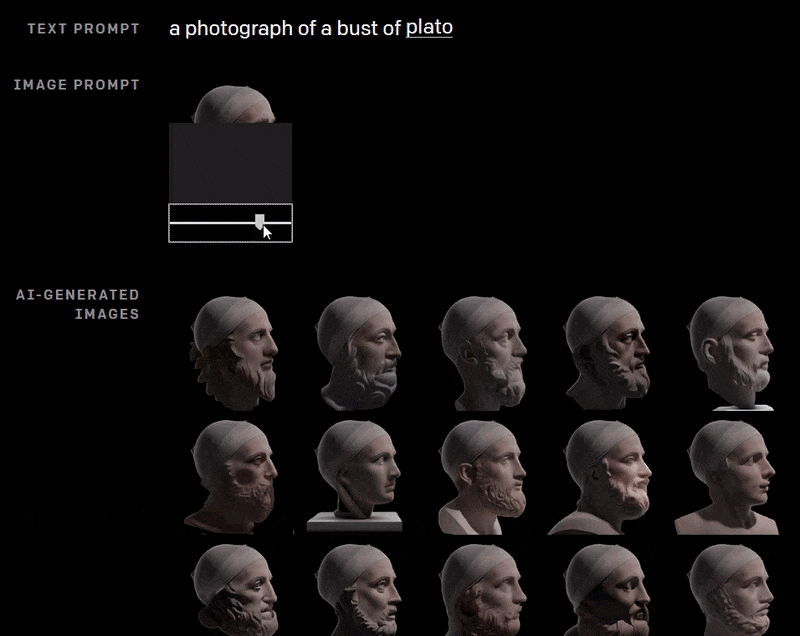
Το DALL-E προσπαθεί να ολοκληρώσει μια μερική εικόνα μιας προτομής του Πλάτωνα. Πηγή: https://openai.com/blog/dall-e/
2: Παραγωγικά ανταγωνιστικά δίκτυα (GANs)
Αν και οι μετασχηματιστές έχουν κερδίσει εξαιρετική κάλυψη από τα μέσα ενημέρωσης μέσω της κυκλοφορίας και της υιοθέτησης του GPT-3, τα Παραγωγικά ανταγωνιστικά Δίκτυα (GANs) έχουν γίνει ένα αναγνωρίσιμο brand με δικά τους δικαιώματα, και μπορεί τελικά να ενταχθούν στο deepfake ως ρήμα.
Πρώτα προτάθηκαν το 2014 και χρησιμοποιούνται κυρίως για σύνθεση εικόνων, μια αρχιτεκτονική GAN αποτελείται από έναν Γεννήτορα και έναν διαχωριστή. Ο Γεννήτορας επαναλαμβάνει χιλιάδες εικόνες σε ένα σύνολο δεδομένων, επαναλαμβάνοντας την προσπάθεια να τις ανακατασκευάσει. Για κάθε προσπάθεια, ο διαχωριστής βαθμολογεί το έργο του Γεννήτορα και στέλνει τον Γεννήτορα πίσω για να κάνει καλύτερα, αλλά χωρίς καμία πληροφορία για το πού έσφαλε η προηγούμενη ανακατασκευή.

Πηγή: https://developers.google.com/machine-learning/gan/gan_structure
Αυτό αναγκάζει τον Γεννήτορα να εξερευνήσει μια ποικιλία οδών, αντί να ακολουθήσει τις πιθανές τυφλές οδούς που θα προέκυπταν αν ο διαχωριστής του είχε πει πού πήγε λάθος (βλέπε #8 παρακάτω). Μέχρι το τέλος της εκπαίδευσης, ο Γεννήτορας έχει μια λεπτομερή και ολοκληρωμένη χαρτογραφία των σχέσεων μεταξύ σημείων στο σύνολο δεδομένων.
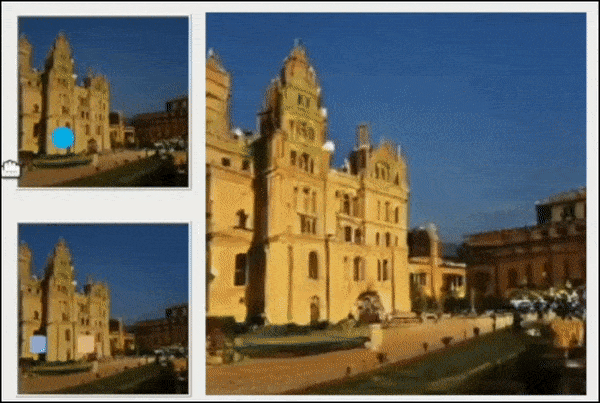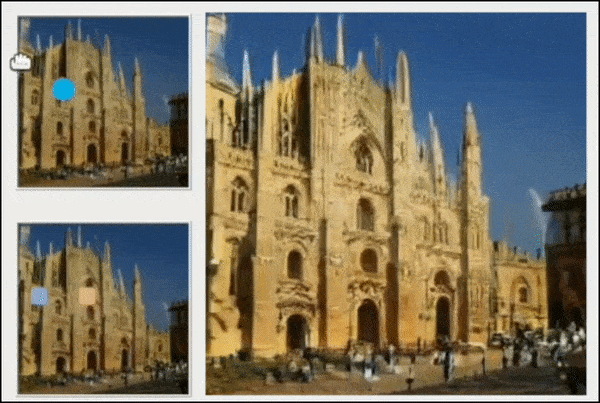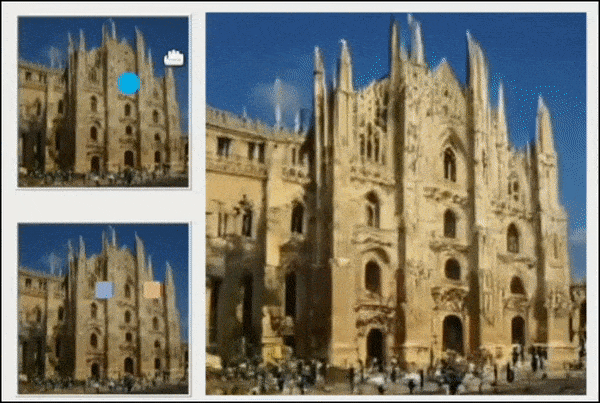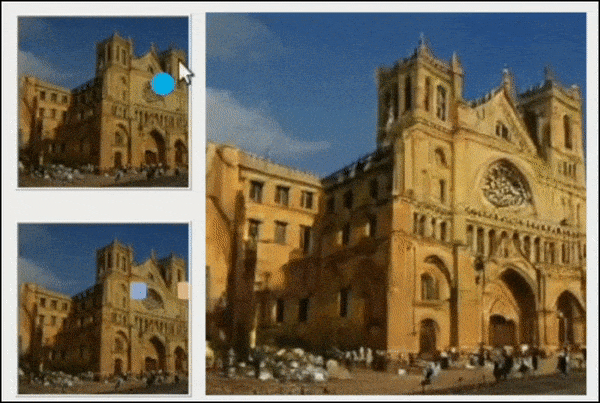
Από το έγγραφο Βελτίωση της ισορροπίας GAN με την αύξηση της χωρικής ευαισθησίας: ένα νέο πλαίσιο επαναλαμβάνει τον λανθάνοντα χώρο ενός GAN, παρέχοντας δυνατότητα διαδραστικού χειρισμού για μια αρχιτεκτονική σύνθεσης εικόνων. Πηγή: https://genforce.github.io/eqgan/
Με αναλογία, αυτό είναι η διαφορά μεταξύ της μάθησης μιας μοναδικής και ανιαρής διαδρομής στο κέντρο του Λονδίνου, ή της εξαντλητικής απόκτησης Γνώσης.
Το αποτέλεσμα είναι μια υψηλού επιπέδου συλλογή χαρακτηριστικών στον λανθάνοντα χώρο του εκπαιδευμένου μοντέλου. Ο σημασιολογικός δείκτης για ένα υψηλό επίπεδο χαρακτηριστικό θα μπορούσε να είναι ‘άτομο’, ενώ μια κάθοδος μέσω της ειδικότητας που σχετίζεται με το χαρακτηριστικό μπορεί να ανακαλύψει άλλα μαθαμένα χαρακτηριστικά, όπως ‘άντρας’ και ‘γυναίκα’. Σε χαμηλότερα επίπεδα, τα υπο-χαρακτηριστικά μπορούν να διασπαστούν σε, ‘ξανθό’, ‘Καυκάσιος’, κ.λπ.
Η διαπλοκή χαρακτηριστικών είναι ένα σημαντικό ζήτημα στον λανθάνοντα χώρο των GAN και των πλαισίων κωδικοποιητή/αποκωδικοποιητή: είναι το χαμόγελο σε ένα GAN-γεννημένο γυναικείο πρόσωπο ένα χαρακτηριστικό που συνδέεται άρρηκτα με την ‘ταυτότητά’ της στον λανθάνοντα χώρο, ή είναι μια παράλληλη διακλάδωση;

GAN-γεννημένα πρόσωπα από το thispersondoesnotexist. Πηγή: https://this-person-does-not-exist.com/en
Τα τελευταία δύο χρόνια έχουν φέρει μια αυξανόμενη σειρά νέων ερευνητικών πρωτοβουλιών σε αυτόν τον τομέα, ενδεχομένως ανοίγοντας τον δρόμο για μια επίπεδο-χαρακτηριστικών, Photoshop-στυλ επεξεργασία για τον latent χώρο ενός GAN, αλλά προς το παρόν, πολλές μετασχηματίσεις είναι αποτελεσματικά ‘όλα ή τίποτα’ πακέτα. Ιδιαίτερα, η κυκλοφορία EditGAN της NVIDIA στα τέλη του 2021 επιτύγχαίνει ένα υψηλό επίπεδο ερμηνευσιμότητας στον λανθάνοντα χώρο χρησιμοποιώντας μάσκες σημασιολογικής κατάτμησης.
Συνήθεις χρήσεις
Παρά την (πραγματικά αρκετά περιορισμένη) εμπλοκή τους σε δημοφιλή deepfake βίντεο, εικόνα/βίντεο-κεντρικά GAN έχουν πολλαπλασιαστεί τα τελευταία τέσσερα χρόνια, ενθουσιάζοντας ερευνητές και το κοινό. Το να κρατάς το ρυθμό με το ταχύ ρυθμό και τη συχνότητα των νέων κυκλοφοριών είναι μια πρόκληση, αν και το αποθετήριο GitHub Awesome GAN Applications στοχεύει να παρέχει μια ολοκληρωμένη λίστα.
Παραγωγικά ανταγωνιστικά Δίκτυα μπορούν θεωρητικά να εξαγάγουν χαρακτηριστικά από οποιοδήποτε καλά ορισμένο τομέα, συμπεριλαμβανομένου του κειμένου.
3: SVM
Προέκυψε το 1963, το Μηχανή Υποστήριξης Διανύσματος (SVM) είναι ένας βασικός αλγόριθμος που εμφανίζεται συχνά σε νέες έρευνες. Υπό το SVM, διανύσματα χαρτογραφούν τη σχετική διάθεση των σημείων δεδομένων σε ένα σύνολο δεδομένων, ενώ υποστηρικτικά διανύσματα οριοθετούν τα όρια μεταξύ διαφορετικών ομάδων, χαρακτηριστικών ή ιδιοτήτων.

Υποστηρικτικά διανύσματα οριοθετούν τα όρια μεταξύ ομάδων. Πηγή: https://www.kdnuggets.com/2016/07/support-vector-machines-simple-explanation.html
Το προκύπτον όριο ονομάζεται υπερεπίπεδο.
Σε χαμηλά επίπεδα χαρακτηριστικών, το SVM είναι δισδιάστατο (εικόνα παραπάνω), αλλά όπου υπάρχει μεγαλύτερος αναγνωρισμένος αριθμός ομάδων ή τύπων, γίνεται τριδιάστατο.

Ένα βαθύτερο πλέγμα σημείων και ομάδων απαιτεί ένα τριδιάστατο SVM. Πηγή: https://cml.rhul.ac.uk/svm.html
Συνήθεις χρήσεις
Εφόσον οι Μηχανές Υποστήριξης Διανύσματος μπορούν να αντιμετωπίσουν αποτελεσματικά και αγνωστικά υψηλοδιάστατα δεδομένα πολλών τύπων, εμφανίζονται ευρέως σε μια ποικιλία τομέων μηχανικής μάθησης, συμπεριλαμβανομένων ανίχνευσης deepfake, ταξινόμησης εικόνων, ταξινόμησης μίσους, ανάλυσης DNA και προσδιορισμού πληθυσμιακής δομής, μεταξύ άλλων.
4: K-Means Clustering
Η ομαδοποίηση γενικά είναι μια μη επιβλεπόμενη προσέγγιση που αναζητά να κατηγοριοποιήσει σημεία δεδομένων μέσω εκτίμησης πυκνότητας, δημιουργώντας μια χαρτογραφία της κατανομής των δεδομένων που μελετώνται.

K-Means ομαδοποίηση αποκαλύπτει τμήματα, ομάδες και κοινότητες σε δεδομένα. Πηγή: https://aws.amazon.com/blogs/machine-learning/k-means-clustering-with-amazon-sagemaker/
Η Ομαδοποίηση K-Means έχει γίνει η πιο δημοφιλής εφαρμογή αυτής της προσέγγισης, οδηγώντας σημεία δεδομένων σε διακριτά ‘K Ομάδες’, οι οποίες μπορεί να υποδηλώνουν δημογραφικές τομές, online κοινότητες ή οποιαδήποτε άλλη πιθανή κρυφή ομαδοποίηση που περιμένει να ανακαλυφθεί σε ακατέργαστα στατιστικά δεδομένα.

Ομάδες σχηματίζονται σε ανάλυση K-Means. Πηγή: https://www.geeksforgeeks.org/ml-determine-the-optimal-value-of-k-in-k-means-clustering/
Η ίδια η τιμή K είναι ο καθοριστικός παράγοντας στη χρησιμότητα της διαδικασίας, και στον καθορισμό μιας βέλτιστης τιμής για μια ομάδα. Αρχικά, η τιμή K ανατίθεται τυχαία, και τα χαρακτηριστικά και οι διανυσματικές ιδιότητές της συγκρίνονται με τους γειτόνες της. Οι γείτονες που μοιάζουν περισσότερο με το σημείο δεδομένων με την τυχαία ανατεθειμένη τιμή ανατίθενται στην ομάδα της επαναλαμβανόμενα μέχρι τα δεδομένα να έχουν παραδώσει όλες τις ομαδοποιήσεις που η διαδικασία επιτρέπει.
Το διάγραμμα για το τετραγωνικό σφάλμα, ή ‘κόστος’ των διαφορετικών τιμών μεταξύ των ομάδων θα αποκαλύψει έναν αγκώνα για τα δεδομένα:

Ο αγκώνας σε ένα γράφημα ομάδας. Πηγή: https://www.scikit-yb.org/en/latest/api/cluster/elbow.html
Ο αγκώνας είναι παρόμοιος με την έννοια του τρόπου με τον οποίο η απώλεια εξομαλύνεται σε ολοένα μικρότερα οφέλη στο τέλος μιας συνεδρίας εκπαίδευσης για ένα σύνολο δεδομένων. Αντιπροσωπεύει το σημείο στο οποίο δεν θα γίνουν πλέον εμφανείς διακρίσεις μεταξύ ομάδων, υποδεικνύοντας το σημείο να προχωρήσετε σε επόμενες φάσεις στη διαδικασία δεδομένων, ή να αναφέρει ευρήματα.
Συνήθεις χρήσεις
Η ομαδοποίηση K-Means, για προφανείς λόγους, είναι μια πρωταρχική τεχνολογία στην ανάλυση πελατών, επειδή προσφέρει μια σαφή και εξηγημένη μεθοδολογία για τη μετάφραση μεγάλων ποσοτήτων εμπορικών εγγραφών σε δημογραφικές πληροφορίες και ‘υποψήφιους πελάτες’.
Εκτός από αυτήν την εφαρμογή, η ομαδοποίηση K-Means χρησιμοποιείται επίσης για πρόβλεψη κατολισθήσεων, κατάτμηση ιατρικών εικόνων, σύνθεση εικόνων με GANs, ταξινόμηση εγγράφων, και πολεοδομικό σχεδιασμό, μεταξύ πολλών άλλων πιθανών και πραγματικών χρήσεων.
5: Τυχαίος Δρυμός
Ο Τυχαίος Δρυμός είναι μια συσσωρευτική μάθηση μέθοδος που υπολογίζει τον μέσο όρο των αποτελεσμάτων από μια σειρά δέντρων απόφασης για να καθορίσει μια γενική πρόβλεψη για το αποτέλεσμα.

Πηγή: https://www.tutorialandexample.com/wp-content/uploads/2019/10/Decision-Trees-Root-Node.png
Εάν έχετε ερευνήσει το ζήτημα ακόμη και τόσο λίγο όσο να παρακολουθήσετε την Τριλογία Επιστροφή στο Μέλλον, ένα δέντρο απόφασης είναι σχετικά εύκολο να κατανοηθεί: ένας αριθμός δρόμων βρίσκεται μπροστά σας, και κάθε δρόμος διακλαδίζεται σε ένα νέο αποτέλεσμα που περιέχει περαιτέρω πιθανές οδούς.
Στην ενισχυτική μάθηση, μπορείτε να υποχωρήσετε από μια οδό και να ξεκινήσετε ξανά από μια προηγούμενη στάση, ενώ τα δέντρα απόφασης δεσμεύονται για τα ταξίδια τους.
Έτσι, ο αλγόριθμος Τυχαίου Δρυμού είναι ουσιαστικά ένα στοίχημα για αποφάσεις. Ο αλγόριθμος ονομάζεται ‘τυχαίος’ επειδή κάνει ad hoc επιλογές και παρατηρήσεις για να κατανοήσει το διάμεσο άθροισμα των αποτελεσμάτων από τη σειρά δέντρων απόφασης.
Καθώς λαμβάνει υπόψη eine ποικιλία παραγόντων, μια προσέγγιση Τυχαίου Δρυμού μπορεί να είναι πιο δύσκολο να μετατραπεί σε σημαντικά γραφήματα από ένα δέντρο απόφασης, αλλά είναι πιθανό να είναι σημαντικά πιο παραγωγικό.
Τα δέντρα απόφασης υπόκεινται σε υπερπροσαρμογή, όπου τα αποτελέσματα που λαμβάνονται είναι δεδομένα-ειδικά και δεν είναι πιθανό να γενικευθούν. Η τυχαία επιλογή δεδομένων του Τυχαίου Δρυμού καταπολεμά αυτή τη τάση, διατρυπούοντας μέχρι τις σημαντικές και χρήσιμες αντιπροσωπευτικές τάσεις στα δεδομένα.

Παλινδρόμηση δέντρου απόφασης. Πηγή: https://scikit-learn.org/stable/auto_examples/tree/plot_tree_regression.html
Συνήθεις χρήσεις
Όπως και με πολλούς από τους αλγόριθμους σε αυτήν τη λίστα, ο Τυχαίος Δρυμός λειτουργεί συνήθως ως ‘πρώιμος’ ταξινομητής και φίλτρο δεδομένων, και ως εκ τούτου εμφανίζεται συνεχώς σε νέες έρευνες. Ορισμένα παραδείγματα χρήσης Τυχαίου Δρυμού περιλαμβάνουν σύνθεση εικόνων μαγνητικού συντονισμού, προσδιορισμό τιμής Bitcoin, ταξινόμηση πληθυσμού, ταξινόμηση κειμένου και ανίχνευση απάτης πιστωτικών καρτών.
Ο Τυχαίος Δρυμός είναι ένας αλγόριθμος χαμηλού επιπέδου στις αρχιτεκτονικές μηχανικής μάθησης, και μπορεί επίσης να συμβάλλει στην απόδοση άλλων χαμηλού επιπέδου μεθόδων, καθώς και αλγορίθμων οπτικοποίησης, συμπεριλαμβανομένων Επαγωγικής Ομαδοποίησης, Μετασχηματισμών Χαρακτηριστικών, ταξινόμησης εγγράφων κειμένου χρησιμοποιώντας αραιά χαρακτηριστικά, και οπτικοποίηση ροών επεξεργασίας.
6: Αφελής Bayes
Συνδυασμένος με την εκτίμηση πυκνότητας (βλέπε 4, παραπάνω), ένας Αφελής Bayes ταξινομητής είναι ένας ισχυρός αλλά σχετικά ελαφρύς αλγόριθμος ικανός να εκτιμάει πιθανότητες με βάση τα υπολογισμένα χαρακτηριστικά των δεδομένων.

Σχέσεις χαρακτηριστικών σε έναν Αφελής Bayes ταξινομητή. Πηγή: https://www.sciencedirect.com/topics/computer-science/naive-bayes-model
Ο όρος ‘αφελής’ αναφέρεται στην υπόθεση στο Θεώρημα Bayes ότι τα χαρακτηριστικά είναι ασχετά, γνωστό ως υπό συνθήκη ανεξαρτησία. Εάν υιοθετήσετε αυτήν την άποψη, το να περπατάτε και να μιλάτε σαν πάπια δεν είναι αρκετό για να καθορίσετε ότι έχουμε να κάνουμε με μια πάπια, και δεν υπάρχουν ‘πρόδηλες’ υποθέσεις που έχουν υιοθετηθεί πρόωρα.
Αυτός ο βαθμός ακαδημαϊκής και ερευνητικής αυστηρότητας θα ήταν υπερβολικός όπου ‘κοινή λογική’ είναι διαθέσιμη, αλλά είναι ένα πολύτιμο πρότυπο όταν διασχίζετε τις πολλές αμφιθυμίες και πιθανώς μη σχετιζόμενες συσχετίσεις που μπορεί να υπάρχουν σε ένα σύνολο δεδομένων μηχανικής μάθησης.
Σε ένα αρχικό μπεϊζιανό δίκτυο, τα χαρακτηριστικά υπόκεινται σε συνάρτηση βαθμολόγησης, συμπεριλαμβανομένης του ελάχιστου μήκους περιγραφής και βαθμολόγησης Bayes, οι οποίες μπορούν να επιβάλλουν περιορισμούς στα δεδομένα όσον αφορά τις εκτιμώμενες συνδέσεις που βρέθηκαν μεταξύ των σημείων δεδομένων, και την κατεύθυνση με την οποία αυτές οι συνδέσεις ρέουν.
Ένας Αφελής Bayes ταξινομητής, αντιθέτως, λειτουργεί με την υπόθεση ότι τα χαρακτηριστικά ενός δεδομένου αντικειμένου είναι ανεξάρτητα, και στη συνέχεια χρησιμοποιεί το Θεώρημα Bayes για να υπολογίσει την πιθανότητα ενός δεδομένου αντικειμένου, με βάση τα χαρακτηριστικά του.
Συνήθεις χρήσεις
Αφελής Bayes φίλτρα είναι καλά αναπαραστάθηκαν σε προσδιορισμό ασθενειών και ταξινόμηση εγγράφων, φίλτρο spam, ταξινόμηση συναισθήματος, συστήματα συστάσεων, και ανίχνευση απάτης, μεταξύ άλλων εφαρμογών.
7: K-Πλησιέστεροι Γείτονες (KNN)
Πρώτα προτάθηκε από την Αεροπορική Σχολή Ιατρικής των ΗΠΑ το 1951, και έχοντας να προσαρμοστεί στο στάδιο της τεχνολογίας υπολογιστών της μεσαίας του 20ου αιώνα, ο K-Πλησιέστεροι Γείτονες (KNN) είναι ένας λιτός αλγόριθμος που εξακολουθεί να εμφανίζεται σε ακαδημαϊκές εργασίες και ιδιωτικές έρευνες μηχανικής μάθησης.
Ο KNN έχει ονομαστεί ‘ο τεμπέλης μαθητής’, επειδή σαρώνει εξαντλητικά ένα σύνολο δεδομένων για να αξιολογήσει τις σχέσεις μεταξύ των σημείων δεδομένων, αντί να απαιτεί την εκπαίδευση ενός πλήρως ανεπτυγμένου μοντέλου μηχανικής μάθησης.

Μια ομαδοποίηση KNN. Πηγή: https://scikit-learn.org/stable/modules/neighbors.html
Αν και ο KNN είναι αρχιτεκτονικά λεπτός, η συστηματική του προσέγγιση τοποθετεί μια αξιοσημείωτη ζήτηση στις λειτουργίες ανάγνωσης/εγγραφής, και η χρήση του σε πολύ μεγάλα σύνολα δεδομένων μπορεί να είναι προβληματική χωρίς βοηθητικές τεχνολογίες όπως η Principal Component Analysis (PCA), η οποία μπορεί να μετατρέψει σύνθετα και υψηλού όγκου σύνολα δεδομένων σε αντιπροσωπευτικές ομαδοποιήσεις που ο KNN μπορεί να διασχίσει με λιγότερη προσπάθεια.
Μια πρόσφατη μελέτη αξιολόγησε την αποτελεσματικότητα και οικονομία ενός αριθμού αλγορίθμων που είχαν ανατεθεί να προβλέψουν εάν ένας υπάλληλος θα εγκαταλείψει μια εταιρεία, βρήκε ότι ο KNN των 70 ετών παρέμεινε ανώτερος σε σύγκριση με πιο σύγχρονους ανταγωνιστές όσον αφορά την ακρίβεια και την προβλεπτική αποτελεσματικότητα.
Συνήθεις χρήσεις
Για όλες τις δημοφιλείς απλότητες της έννοιας και της εκτέλεσης, ο KNN δεν είναι κολλημένος στο 1950 – έχει προσαρμοστεί σε μια προσέγγιση περισσότερο εστιασμένη στα βαθιά νευρωνικά δίκτυα (DNN) σε μια πρόταση του 2018 από το Πανεπιστήμιο της Πενσυλβάνια, και παραμένει μια κεντρική πρώιμη-στάδιο διαδικασία (ή μετα-επεξεργασία αναλυτικό εργαλείο) σε πολλές πιο σύνθετες πλαισια μηχανικής μάθησης.
Σε διάφορες διαμορφώσεις, ο KNN έχει χρησιμοποιηθεί ή για διαδικτυακή επαλήθευση υπογραφής, ταξινόμηση εικόνων, εξόρυξη κειμένου, προσδιορισμό καλλιέργειας, και αναγνώριση προσώπου, μεταξύ άλλων εφαρμογών και ενσωματώσεων.

Ένα βασισμένο σε KNN σύστημα αναγνώρισης προσώπου σε εκπαίδευση. Πηγή: https://pdfs.semanticscholar.org/6f3d/d4c5ffeb3ce74bf57342861686944490f513.pdf
8: Μαρκόφια Διαδικασία Απόφασης (MDP)
Ένα μαθηματικό πλαίσιο που εισήχθη από τον Αμερικανό μαθηματικό Richard Bellman το 1957, η Μαρκόφια Διαδικασία Απόφασης (MDP) είναι ένα από τα βασικά δομικά στοιχεία των ενισχυτικής μάθησης αρχιτεκτονικών. Ένας εννοιολογικός αλγόριθμος με δικά του δικαιώματα, έχει προσαρμοστεί σε πολλούς άλλους αλγορίθμους, και επανεμφανίζεται συχνά στην τρέχουσα σοδιά AI/ML ερευνών.
Η MDP εξερευνά ένα περιβάλλον δεδομένων χρησιμοποιώντας την αξιολόγηση της τρέχουσας κατάστασης (δηλ. ‘πού’ είναι στο δεδομένο) για να αποφασίσει ποιο κόμβο του δεδομένου να εξερευνήσει επόμενο.

Πηγή: https://www.sciencedirect.com/science/article/abs/pii/S0888613X18304420
Μια βασική Μαρκόφια Διαδικασία Απόφασης θα προτιμήσει το βραχυπρόθεσμο όφελος έναντι πιο επιθυμητών μακροπρόθεσμων στόχων. Για αυτόν τον λόγο, είναι συνήθως ενσωματωμένη στο πλαίσιο μιας πιο ολοκληρωμένης αρχιτεκτονικής πολιτικής στην ενισχυτική μάθηση, και είναι συχνά υποκειμένη σε περιοριστικούς παράγοντες όπως η εκπτωτική ανταμοιβή, και άλλες τροποποιητικές περιβαλλοντικές μεταβλητές που θα την εμποδίσουν να σπεύσει προς έναν άμεσο στόχο χωρίς να λάβει υπόψη το ευρύτερο επιθυμητό αποτέλεσμα.
Συνήθεις χρήσεις
Η MDP είναι ευρέως διαδεδομένη σε έρευνα και ενεργές αναπτύξεις μηχανικής μάθησης. έχει προταθεί για αμυντικά συστήματα IoT, αλιεία, και πρόβλεψη της αγοράς.
Εκτός από την πρόδηλη εφαρμογή στο σκάκι και άλλα αυστηρά σειριακά παιχνίδια, η MDP είναι επίσης ένας φυσικός υποψήφιος για την διαδικασία εκπαίδευσης ρομποτικών συστημάτων, όπως μπορούμε να δούμε στο βίντεο παρακάτω.
9: Συχνότητα Λέξης-Αντιστρόφου Συχνότητας Εγγράφου
Η Συχνότητα Λέξης (TF) διαιρεί τον αριθμό των φορών που μια λέξη εμφανίζεται σε ένα έγγραφο με το συνολικό αριθμό λέξεων σε αυτό το έγγραφο. Έτσι, η λέξη φώκια που εμφανίζεται μια φορά σε ένα άρθρο 1000 λέξεων έχει μια συχνότητα λέξης 0,001. Από μόνη της, η TF είναι σε μεγάλο βαθμό άχρηστη ως δείκτης της σημασίας της λέξης, λόγω του γεγονότος ότι άσχετες λέξεις (όπως a, and, the και it) κυριαρχούν.
Για να ληφθεί μια σημαντική τιμή για μια λέξη, η Αντιστρόφου Συχνότητας Εγγράφου (IDF) υπολογίζει τη TF μιας λέξης σε πολλά έγγραφα σε ένα σύνολο δεδομένων, αναθέτοντας χαμηλή βαθμολογία σε πολύ συχνές λέξεις διακοπής, όπως άρθρα. Τα διανύσματα χαρακτηριστικών που προκύπτουν κανονικοποιούνται σε ακέραιες τιμές, με κατάλληλο βάρος για κάθε λέξη.

TF-IDF ζυγίζει τη σχετικότητα των όρων με βάση τη συχνότητα σε πολλά έγγραφα, με σπανιότερη εμφάνιση ως δείκτης σαφήνειας. Πηγή: https://moz.com/blog/inverse-document-frequency-and-the-importance-of-uniqueness
Αν και αυτή η προσέγγιση εμποδίζει σημασιολογικά σημαντικές λέξεις από το να χαθούν ως ακραίες τιμές, η αντιστροφή της συχνότητας βάρους δεν σημαίνει αυτόματα ότι μια σπανιότερη λέξη δεν αποτελεί ακραία τιμή, επειδή κάποια πράγματα είναι σπάνια και άχρηστα. Έτσι, μια σπανιότερη λέξη θα πρέπει να αποδείξει την αξία της στο ευρύτερο αρχιτεκτονικό πλαίσιο, εμφανιζόμενη (ακόμη και σε μια χαμηλή συχνότητα ανά έγγραφο) σε πολλά έγγραφα στο σύνολο δεδομένων.
Παρά την ηλικία της, η TF-IDF είναι μια ισχυρή και δημοφιλής μέθοδος για αρχικές φίλτρες σε πλαισια NLP.
Συνήθεις χρήσεις
Εφόσον η TF-IDF έχει παίξει τουλάχιστον κάποιο ρόλο στην ανάπτυξη του αλγορίθμου PageRank της Google τα τελευταία είκοσι χρόνια, έχει γίνει πολύ ευρέως υιοθετημένη ως μια χειραγωγική τεχνική SEO, παρά την απάρνηση του John Mueller το 2019.
Λόγω του μυστηρίου γύρω από τον PageRank, δεν υπάρχει καθαρή απόδειξη ότι η TF-IDF δεν είναι σήμερα μια αποτελεσματική τακτική για την αύξηση της κατάταξης στο Google. Η έντονη συζήτηση μεταξύ επαγγελματιών IT τελευταία υποδηλώνει μια δημοφιλή κατανόηση, σωστή ή όχι, ότι η κακοποίηση όρων μπορεί ακόμη να οδηγήσει σε βελτιωμένη τοποθέτηση SEO (αν και πρόσθετες κατηγορίες μονοπωλιακής κακοποίησης και υπερβολικής διαφήμισης θολώνουν τα όρια αυτής της θεωρίας).
10: Στοχαστική κάθοδος κλίσης
Η Στοχαστική κάθοδος κλίσης (SGD) είναι μια ολοένα πιο δημοφιλής μέθοδος για τη βελτιστοποίηση της εκπαίδευσης μοντέλων μηχανικής μάθησης.
Η ίδια η κάθοδος κλίσης είναι μια μέθοδος για τη βελτιστοποίηση και την υπολογιστική βελτίωση που κάνει ένα μοντέλο κατά την εκπαίδευση.
Σε αυτήν την έννοια, ‘κλίση’ υποδηλώνει μια πλαγιά προς τα κάτω (αντί μιας χρωματικής βαθμίδας, βλέπε εικόνα παρακάτω), όπου το υψηλότερο σημείο του ‘βουνού’, στην αριστερή πλευρά, αντιπροσωπεύει την αρχή της διαδικασίας εκπαίδευσης. Σε αυτό το στάδιο, το μοντέλο δεν έχει ακόμη δει το σύνολο των δεδομένων ούτε μια φορά, και δεν έχει μάθει αρκετά για τις σχέσεις μεταξύ των δεδομένων για να παράγει αποτελεσματικές μετασχηματίσεις.

Μια κάθοδος κλίσης σε μια συνεδρία εκπαίδευσης FaceSwap. Βλέπουμε ότι η εκπαίδευση είχε σταθεροποιηθεί για κάποιο διάστημα στο δεύτερο μισό, αλλά έχει τελικά ανακτήσει τον δρόμο της προς μια αποδεκτή σύγκλιση.
Το χαμηλότερο σημείο, στη δεξιά πλευρά, αντιπροσωπεύει τη σύγκλιση (το σημείο στο οποίο το μοντέλο είναι τόσο αποτελεσματικό όσο θα γίνει ποτέ υπό τους επιβεβλημένους περιορισμούς και ρυθμίσεις).
Η κλίση λειτουργεί ως ένα αρχείο και προβλέπτης για την απόσταση μεταξύ του ρυθμού σφάλματος (πώς ακριβώς το μοντέλο έχει χαρτογραφηθεί τις σχέσεις δεδομένων) και των βαρών (τις ρυθμίσεις που επηρεάζουν τον τρόπο με τον οποίο το μοντέλο θα μάθει).
Αυτή η εγγραφή της πρόοδου μπορεί να χρησιμοποιηθεί για να καθοδηγήσει ένα χρονοδιάγραμμα ρυθμού μάθησης, μια αυτόματη διαδικασία που λέει στην αρχιτεκτονική να γίνει πιο λεπτομερής και ακριβής καθώς οι πρώτες ασαφείς λεπτομέρειες μετατρέπονται σε σαφείς σχέσεις και χαρτογραφήσεις. Σε πραγματικό χρόνο, η απώλεια κλίσης παρέχει έναν χάρτη του πού πρέπει να πάει η εκπαίδευση επόμενη, και πώς πρέπει να προχωρήσει.
Η καινοτομία της Στοχαστικής καθόδου κλίσης είναι ότι ενημερώνει τις παραμέτρους του μοντέλου σε κάθε εκπαιδευτικό παράδειγμα ανά επανάληψη, το οποίο γενικά επιταχύνει το ταξίδι προς τη σύγκλιση. Λόγω της εμφάνισης υπερκλιμακίων συνόλων δεδομένων τα τελευταία χρόνια, η SGD έχει αυξηθεί σε δημοφιλία τελευταία ως μια πιθανή μέθοδος για την αντιμετώπιση των επόμενων εφοδιαστικών προβλημάτων.
Από την άλλη πλευρά, η SGD έχει αρνητικές επιπτώσεις για την κλιμάκωση χαρακτηριστικών, και μπορεί να απαιτεί περισσότερες επαναλήψεις για να επιτύχει το ίδιο αποτέλεσμα, απαιτώντας πρόσθετο σχεδιασμό και πρόσθετες παραμέτρους, σε σύγκριση με την κανονική Κατηφόρα Κλίσης.
Συνήθεις χρήσεις
Λόγω της δυνατότητας παραμετροποίησής της και παρά τα ελαττώματά της, η SGD έχει γίνει ο πιο δημοφιλής αλγόριθμος βελτιστοποίησης για την προσαρμογή νευρωνικών δικτύων. Μια διαμόρφωση της SGD που γίνεται κυρίαρχη σε νέες έρευνες AI/ML είναι η επιλογή του Adaptive Moment Estimation (ADAM, εισαχθεί το 2015) βελτιστοποιητή.
Το ADAM προσαρμόζει το ρυθμό μάθησης για κάθε παράμετρο δυναμικά (‘προσαρμοστικός ρυθμός μάθησης’), καθώς και ενσωματώνει αποτελέσματα από προηγούμενες ενημερώσεις στην επόμενη διαμόρφωση (‘ορμή’). Επιπλέον, μπορεί να ρυθμιστεί για να χρησιμοποιήσει μεταγενέστερες καινοτομίες, όπως Nesterov Momentum.
Ωστόσο, ορισμένοι υποστηρίζουν ότι η χρήση της ορμής μπορεί επίσης να οδηγήσει το ADAM (και παρόμοιους αλγορίθμους) σε μια υπο-βέλτιστη σύγκλιση. Όπως και με την πλειοψηφία του αιχμής της έρευνας μηχανικής μάθησης, η SGD είναι μια εργασία σε εξέλιξη.
Πρώτη δημοσίευση 10ης Φεβρουαρίου 2022. Τροποποιήθηκε 10ης Φεβρουαρίου 20.05 EET – μορφοποίηση.


