Βασικές αρχές της AI
Τι είναι το Gradient Descent;

 Προσθέστε το Unite.AI στις προτιμώμενες πηγές σας στο Google
Gradient descent είναι μια μέθοδος βελτιστοποίησης που προσαρμόζει τις παραμέτρους του μοντέλου ώστε να μειώσει μια συνάρτηση στόχου. Στην εκπαίδευση νευρωνικών δικτύων, ο στόχος αυτός είναι συνήθως η απώλεια που υπολογίζεται πάνω σε παραδείγματα. Το gradient δείχνει την κατεύθυνση της πιο απότομης τοπικής αύξησης, έτσι η gradient descent κάνει ένα βήμα στην αντίθετη κατεύθυνση.
Το gradient περιγράφει την τοπική ευαισθησία· το μέγεθός του δεν αποτελεί άμεσο μέτρο του πόσο γρήγορα «μαθαίνει» ένα μοντέλο. Η πραγματική πρόοδος εξαρτάται επίσης από το learning rate, την καμπυλότητα, τον θόρυβο, την παραμετροποίηση, την κατάσταση του βελτιστοποιητή και τα δεδομένα.
Σημαντικά σημεία
- Backpropagation υπολογίζει τα gradients, ενώ το gradient descent τα χρησιμοποιεί για την ενημέρωση των παραμέτρων.
- Η βελτιστοποίηση με mini-batch είναι η τυπική πρακτική προσέγγιση για το deep learning.
- Το learning rate ελέγχει το μέγεθος των ενημερώσεων και μπορεί να ακολουθεί ένα πρόγραμμα αντί να μειώνεται μετά από κάθε βήμα.
- Το Momentum, το AdamW, το clipping και η κανονικοποίηση αντιμετωπίζουν διαφορετικά προβλήματα βελτιστοποίησης.
Ο βασικός κανόνας ενημέρωσης
Για το διάνυσμα παραμέτρων θ, το learning rate η και την απώλεια L:
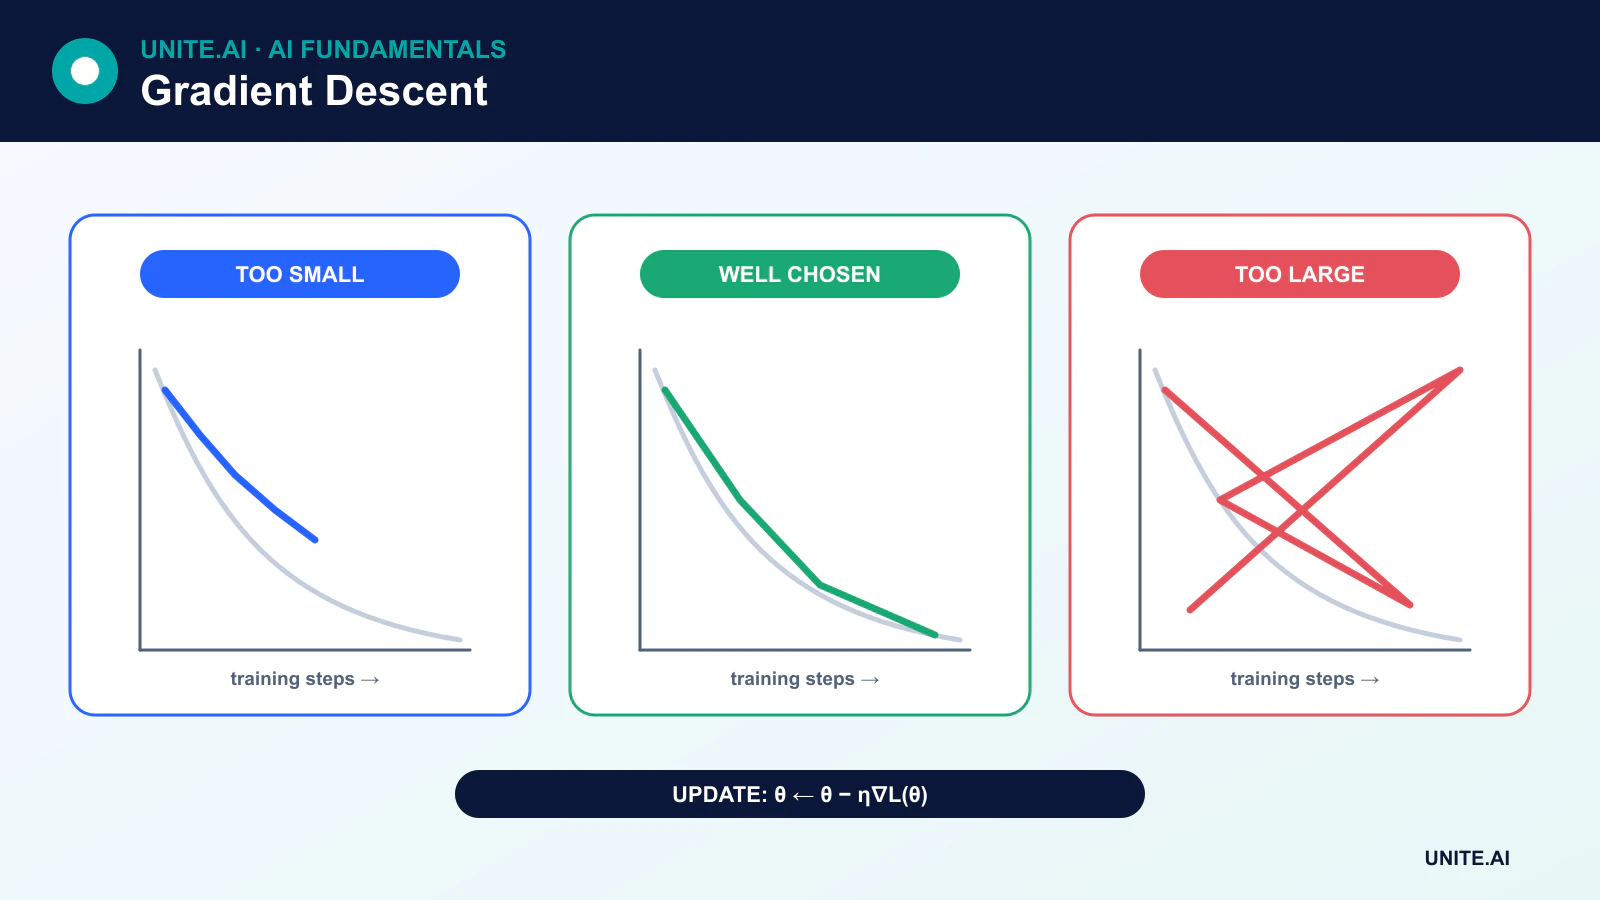
θ ← θ - η∇L(θ)
Το gradient ∇L(θ) περιέχει μία μερική παράγωγο ανά παράμετρο. Η αφαίρεσή του μετακινεί το μοντέλο τοπικά προς τα κάτω. Ένα σταθερό σημείο έχει gradient μηδέν, αλλά μπορεί να είναι ελάχιστο, μέγιστο, σημείο σέλας ή επίπεδη περιοχή. Οι επιφάνειες απώλειας στο deep learning είναι μη κυρτές, επομένως η εκπαίδευση δεν εγγυάται ότι θα βρεθεί ένα μοναδικό παγκόσμιο ελάχιστο ή μηδενική απώλεια.
Μέθοδοι batch, stochastic και mini-batch
Batch gradient descent
Το Batch gradient descent υπολογίζει το gradient χρησιμοποιώντας ολόκληρο το σύνολο εκπαίδευσης για κάθε ενημέρωση. Η εκτίμηση είναι σταθερή, αλλά μπορεί να είναι δαπανηρή σε χρόνο και μνήμη, και μια ενημέρωση μπορεί να υποχρησιμοποιεί τους σύγχρονους επιταχυντές.
Stochastic gradient descent
Το αυστηρό stochastic gradient descent χρησιμοποιεί ένα τυχαία επιλεγμένο παράδειγμα ανά ενημέρωση. Τα gradients του είναι θορυβώδη, κάτι που μπορεί να βοηθήσει την εξερεύνηση της επιφάνειας απώλειας, αλλά οι λειτουργίες με ένα μόνο παράδειγμα μπορεί να είναι αναποτελεσματικές σε παράλληλο υλικό.
Mini-batch gradient descent
Η εκπαίδευση με mini-batch εκτιμά το gradient από ένα υποσύνολο παραδειγμάτων. Ισορροπεί τον στατιστικό θόρυβο με αποδοτικές λειτουργίες πινάκων και είναι η συνήθης προσέγγιση στο deep learning. Το μέγεθος του batch επηρεάζει τη μνήμη, το throughput, το θόρυβο του gradient, την κανονικοποίηση και μερικές φορές τη γενίκευση.
Επιλογή learning rate
Ένα ρυθμό που είναι πολύ μεγάλος μπορεί να υπερβεί τις χρήσιμες περιοχές ή να προκαλέσει απόκλιση. Ένας ρυθμός που είναι πολύ μικρός μπορεί να κάνει την εκπαίδευση μη πρακτικά αργή ή να κολλήσει σε επίπεδες περιοχές. Η βέλτιστη κλίμακα εξαρτάται από τον βελτιστοποιητή, το μέγεθος του batch, το μοντέλο, την αρχικοποίηση και τον στόχο.
Τα προγράμματα μπορούν να ζεσταθούν σταδιακά, να μειωθούν σε ορόσημα, να ακολουθήσουν καμπύλη συνημιτόνου ή να ανταποκριθούν στην πρόοδο της επικύρωσης. Ο ρυθμός δεν χρειάζεται να μειώνεται μονοτονικά μετά από κάθε ενημέρωση. Τα warm restarts και τα κυκλικά προγράμματα αυξάνουν σκόπιμα τον ρυθμό σε μέρη της εκπαίδευσης.
Momentum
Το Momentum διατηρεί έναν εκθετικό κινητό μέσο των προηγούμενων gradients. Μπορεί να επιταχύνει την πρόοδο κατά μήκος συνεπών κατευθύνσεων και να μειώσει τις ταλαντώσεις σε απότομες, στενές κατευθύνσεις. Το Momentum τύπου Nesterov αξιολογεί ή προσεγγίζει το gradient αφού κοιτάξει μπροστά κατά την κατεύθυνση του momentum.
Προσαρμοστικοί βελτιστοποιητές
Το RMSProp κλιμακώνει τις ενημερώσεις χρησιμοποιώντας έναν κινητό μέσο των τετραγωνικών gradients. Το Adam συνδυάζει πρώτες στιγμές τύπου momentum με κλιμάκωση δεύτερης στιγμής. Το AdamW αποσυνδέει το weight decay από την προσαρμοστική ενημέρωση του gradient και χρησιμοποιείται ευρέως για transformers.
Οι προσαρμοστικοί βελτιστοποιητές συχνά διευκολύνουν την αρχική εκπαίδευση, αλλά δεν είναι αυτόματα ανώτεροι για κάθε μοντέλο ή τελικό στόχο γενίκευσης. Οι συγκρίσεις βελτιστοποιητών απαιτούν ταιριαστά προγράμματα και προσεκτική ρύθμιση.
Κοπή (clipping) και συσσώρευση gradient
Η κοπή gradient περιορίζει το νόρμα ή τις τιμές ενός gradient για να μειώσει την επίδραση των εκρηκτικών gradients, ιδιαίτερα σε επαναλαμβανόμενη ή ασταθή εκπαίδευση. Η συσσώρευση gradient προσθέτει gradients από αρκετά μικρότερα batches πριν από μια ενημέρωση, προσεγγίζοντας ένα μεγαλύτερο αποτελεσματικό batch όταν η μνήμη είναι περιορισμένη.
Παρακολούθηση βελτιστοποίησης
Παρακολουθήστε την απώλεια εκπαίδευσης και επικύρωσης, τις μετρικές εργασίας, το learning rate, τα νόρμα των gradients, τα νόρμα των παραμέτρων και τα αριθμητικά σφάλματα. Μείωση της απώλειας εκπαίδευσης με επιδείνωση της απόδοσης επικύρωσης υποδεικνύει overfitting, όχι επιτυχία βελτιστοποίησης που πρέπει αυτόματα να συνεχιστεί.
Η βελτιστοποίηση ελαχιστοποιεί τον δοσμένο στόχο. Μια χαμηλή απώλεια δεν αποδεικνύει ότι τα δεδομένα, η μετρική ή η πραγματική συμπεριφορά είναι κατάλληλα. Διαρροή, κακές ετικέτες και ένας μη ευθυγραμμισμένος στόχος μπορούν να παράγουν ένα καλά βελτιστοποιημένο αλλά επιβλαβές μοντέλο.
Γεωμετρία βελτιστοποίησης και κανόνες ενημέρωσης
Το Gradient descent ενημερώνει τις παραμέτρους αντίθετα προς το gradient μιας απώλειας. Το full‑batch descent χρησιμοποιεί κάθε παράδειγμα εκπαίδευσης ανά βήμα· το stochastic descent χρησιμοποιεί ένα· οι μέθοδοι mini‑batch εκτιμούν το gradient από ένα υποσύνολο και κυριαρχούν στο deep learning. Το learning rate καθορίζει το μέγεθος του βήματος. Πολύ μικρό σπαταλά υπολογισμούς ή κολλά· πολύ μεγάλο ταλαντώνεται ή αποκλίνει. Το Momentum συσσωρεύει μια κινητή κατεύθυνση, ενώ προσαρμοστικές μέθοδοι όπως το Adam κλιμακώνουν τις συντεταγμένες χρησιμοποιώντας στιγμές του gradient. Οι διαφορετικές έμμεσες προκαταλήψεις τους μπορούν να παράγουν μοντέλα με παρόμοια απώλεια εκπαίδευσης αλλά διαφορετική γενίκευση.
Οι επιφάνειες απώλειας στα νευρωνικά δίκτυα περιέχουν επίπεδες και απότομες περιοχές, σημεία σέλας, συμμετρίες και κακές συνθήκες κατευθύνσεων. Η κλιμάκωση χαρακτηριστικών, η κανονικοποίηση, η αρχικοποίηση, οι συνδέσεις residual και η προεπεξεργασία αλλάζουν τη γεωμετρία που βλέπει ο βελτιστοποιητής. Τα προγράμματα μπορούν να ζεσταθούν, να μειωθούν, να κυκλώσουν ή να αντιδράσουν σε επίπεδες περιοχές. Το weight decay διαφέρει από το απλό πρόσθετο L2 penalty σε ορισμένους προσαρμοστικούς βελτιστοποιητές. Το μέγεθος batch επηρεάζει τον θόρυβο, τη μνήμη, το παράλληλο και το καθεστώς του learning‑rate, επομένως οι συγκρίσεις βελτιστοποιητών απαιτούν ταιριανούς προϋπολογισμούς εκπαίδευσης και προσεκτική ρύθμιση.
Διάγνωση, αναπαραγωγιμότητα και τερματισμός
Παρακολουθήστε την απώλεια εκπαίδευσης και επικύρωσης, τις μετρικές εργασίας, τα νόρμα των gradients και των παραμέτρων, το learning rate, το throughput και τις αριθμητικές προειδοποιήσεις. Η απόκλιση μπορεί να προέλθει από κατεστραμμένα batches, μη έγκυρες ετικέτες, ασταθή μεικτή ακρίβεια ή λανθασμένη μείωση της απώλειας. Οι επίπεδες περιοχές μπορεί να υποδεικνύουν ανεπαρκή χωρητικότητα, κορεσμένες ενεργοποιήσεις, κακές χαρακτηριστικές, υπερβολική κανονικοποίηση ή πρόβλημα προγράμματος. Το overfitting απαιτεί δεδομένα, επαύξηση, κανονικοποίηση ή νωρίς τερματισμό· όχι μια δήλωση ότι ο βελτιστοποιητής απέτυχε. Εξετάστε αντιπροσωπευτικά σφάλματα και συγκρίνετε μια απλή βάση πριν αυξήσετε την πολυπλοκότητα της εκπαίδευσης.
Η αναπαραγωγιμότητα απαιτεί σπόρους, σειρά δεδομένων, κώδικα, ρυθμίσεις, εκδόσεις υλικού και βιβλιοθηκών, αν και ορισμένοι πυρήνες επιταχυντών παραμένουν μη ντετερμινιστικοί. Αποθηκεύστε checkpoints με την κατάσταση του βελτιστοποιητή και του scheduler ώστε η εκπαίδευση να μπορεί να συνεχιστεί σταθερά. Επιλέξτε ένα checkpoint βάσει κριτηρίων επικύρωσης που έχουν οριστεί εκ των προτέρων και κρατήστε ένα αδιάβαστο σύνολο δοκιμών. Σε κατανεμημένη εκπαίδευση, επιβεβαιώστε το αποτελεσματικό μέγεθος batch, τη μέση τιμή των gradients και τη διαχείριση αποτυχημένων εργατών. Η βελτιστοποίηση ελαχιστοποιεί τον επιλεγμένο στόχο στα διαθέσιμα δεδομένα· δεν εγγυάται βαθμονομημένες πιθανότητες, αιτιώδη λογική, δικαιοσύνη, ασφάλεια ή πραγματική χρηστικότητα.
Παράδειγμα εφαρμογής: ρύθμιση βελτιστοποιητή για μοντέλο γλώσσας
Μια ομάδα καθορίζει τον tokenizer, τη σειρά δεδομένων, το μοντέλο, το αποτελεσματικό batch και τον προϋπολογισμό token εκπαίδευσης, και στη συνέχεια συγκρίνει το SGD με momentum και το AdamW σε αξιόπιστα προγράμματα learning‑rate. Καταγράφονται το warm‑up, η μείωση, το weight decay, το clipping και η ακρίβεια. Κάθε υποψήφιος εκτελείται με πολλαπλούς σπόρους, και η επικύρωση χρησιμοποιεί ένα απομονωμένο χρονικό τμήμα μαζί με αξιολογήσεις εργασίας. Το throughput και η ενέργεια αναφέρονται μαζί με την απώλεια ώστε ένας ελαφρώς καλύτερος βελτιστοποιητής να μην επιλεγεί με ανισομερή κόστος.
Οι διαγνώσεις αποκαλύπτουν αν η αστάθεια προέρχεται από ένα τμήμα δεδομένων, υπερβολικό μέγεθος βήματος, υπορροή ή αρχιτεκτονική μοντέλου. Τα checkpoints διατηρούν την κατάσταση του βελτιστοποιητή και του scheduler και επανεκκινούνται σε μια δοκιμή. Η τελική επιλογή βασίζεται στην ποιότητα και την ανθεκτικότητα της επικύρωσης, όχι στη χαμηλότερη απώλεια εκπαίδευσης. Ένα κλειστό σύνολο δοκιμών εκτελείται μία φορά μετά την επιλογή. Η παραγωγική πρόβλεψη είναι ξεχωριστά βαθμονομημένη και παρακολουθείται επειδή η επιτυχία του βελτιστοποιητή κατά την προ‑εκπαίδευση δεν εγγυάται ασφαλή ή αληθή συμπεριφορά.
Απόδειξη υλοποίησης και ετοιμότητα λειτουργίας
Μια απόφαση παραγωγής απαιτεί περισσότερα από μια επιτυχημένη επίδειξη. Ορίστε τους προοριζόμενους χρήστες, το λειτουργικό περιβάλλον, τις εισόδους, τις εξόδους, τις εξαρτήσεις, τον ιδιοκτήτη και τις συνέπειες κάθε σημαντικής αποτυχίας. Καθιερώστε μια αναπαραγώγιμη βάση και ένα εκδόσιμη σύνολο αξιολόγησης πριν τη ρύθμιση. Δοκιμάστε τυπικές περιπτώσεις, όρια, κατεστραμμένες ή ελλιπείς εισόδους, μετατόπιση κατανομής, αποτυχία εξαρτήσεων, κακή χρήση και τις ομάδες ή τα περιβάλλοντα που είναι πιο πιθανό να παραμελούνται. Μετρήστε την ποιότητα εργασίας μαζί με τη βαθμονόμηση ή την αβεβαιότητα, την καθυστέρηση, το throughput, το κόστος πόρων, την προσβασιμότητα, την ιδιωτικότητα και την ασφάλεια. Καταγράψτε κάθε μετασχηματισμό και κατώφλι ώστε ένας ανεξάρτητος ελεγκτής να μπορεί να αναπαράγει το αποτέλεσμα και να διακρίνει την απόδειξη από ένα ελκυστικό πρωτότυπο.
Πριν την κυκλοφορία, ορίστε την εξουσία για κυκλοφορία, εξαιρέσεις, αλλαγές, επαναφορά και απόσυρση. Χρησιμοποιήστε σταδιακή κυκλοφορία, διατηρήστε ασφαλή εναλλακτική λύση και επαληθεύστε την παρακολούθηση με σκόπιμα ενσωματωμένες αποτυχίες. Η λειτουργική τηλεμετρία θα πρέπει να αποκαλύπτει την ποιότητα εισόδου, τη συμπεριφορά εξόδου, την έκδοση του μοντέλου ή του κανόνα, την υγεία των εξαρτήσεων, τις ανθρώπινες παρεμβάσεις και τα επιβεβαιωμένα αποτελέσματα χωρίς τη συλλογή περιττών ευαίσθητων δεδομένων. Ορίστε όρια ειδοποίησης και υπεύθυνο απόκρισης, και στη συνέχεια ελέγξτε αποδείξεις πραγματικού κόσμου μετά την υλοποίηση αντί να υποθέτετε ότι η εκτός σύνδεσης απόδοση θα παραμείνει. Επαναξιολογήστε όποτε οι πηγές δεδομένων, οι χρήστες, τα μοντέλα, οι προμηθευτές, οι πολιτικές, το υλικό ή οι στόχοι αλλάζουν. Ένα συντηρημένο σύστημα χρειάζεται επίσης τεκμηριωμένη αποκατάσταση, εκμάθηση περιστατικών, διαδικασίες διαγραφής και διατήρησης, και ένα σαφές σημείο όπου πρέπει να απενεργοποιηθεί ή να αντικατασταθεί.
Συχνές ερωτήσεις
Το gradient descent φτάνει πάντα στο παγκόσμιο ελάχιστο;
Όχι. Για κυρτά (convex) αντικειμενικά, οι κατάλληλες συνθήκες παρέχουν ισχυρές εγγυήσεις. Οι στόχοι των deep‑network είναι μη κυρτοί, και οι πρακτικοί βελτιστοποιητές συνήθως αναζητούν μια χρήσιμη λύση αντί να αποδείξουν ότι βρήκαν το μοναδικό παγκόσμιο ελάχιστο.
Γιατί ένα μηδενικό gradient μπορεί να είναι παραπλανητικό;
Ένα μηδενικό ή πολύ μικρό gradient μπορεί να υποδεικνύει ελάχιστο, μέγιστο, σημείο σέλας, κορεσμό ή επίπεδη πλάκα. Η διάγνωση της εκπαίδευσης πρέπει να λαμβάνει υπόψη το ιστορικό της απώλειας, την καμπυλότητα, το μέγεθος των παραμέτρων και την απόδοση επικύρωσης.
Κύριες αναφορές