
Βασικές αρχές της AI
Πώς Λειτουργεί η Κατηγοριοποίηση Κειμένου;

 Προσθέστε το Unite.AI στις προτιμώμενες πηγές σας στο Google
Κατηγοριοποίηση κειμένου αναθέτει μία ή περισσότερες ετικέτες σε ένα έγγραφο, μήνυμα ή απόσπασμα κειμένου. Παραδείγματα περιλαμβάνουν την ανίχνευση ανεπιθύμητης αλληλογραφίας, τη δρομολόγηση προθέσεων, την ανάλυση συναισθήματος, την ετικετοποίηση θεμάτων, τη διαχείριση και την προτεραιοποίηση αιτημάτων υποστήριξης.
Ένας παραγωγικός ταξινομητής είναι περισσότερο από ένα μοντέλο. Εξαρτάται από μια ακριβή ταξινομία ετικετών, αντιπροσωπευτικές σημειώσεις, διαχωρισμούς χωρίς διαρροή, έναν βαθμονομημένο κανόνα απόφασης και παρακολούθηση για αλλαγές στη γλώσσα και την επικράτηση των κλάσεων.
Βασικά σημεία
- Ορίστε τις ετικέτες και τις ασαφείς περιπτώσεις πριν επιλέξετε αρχιτεκτονική.
- Απλοί αλγόριθμοι bag‑of‑words παραμένουν χρήσιμοι· οι προεκπαιδευμένοι κωδικοποιητές προσθέτουν συμφραζόμενα και μεταφορά μάθησης.
- Η ακρίβεια μπορεί να κρύβει κακή απόδοση σε μειονεκτικές κλάσεις, γι’ αυτό χρησιμοποιήστε μετρικές που λαμβάνουν υπόψη τις κλάσεις και ανάλυση σφαλμάτων.
- Η βαθμονόμηση πιθανοτήτων, η αποχή και η ανθρώπινη ανασκόπηση μετατρέπουν τις βαθμολογίες σε ασφαλέστερες αποφάσεις.
Ορισμός της ταξινομίας και της πολιτικής σημειώσεων
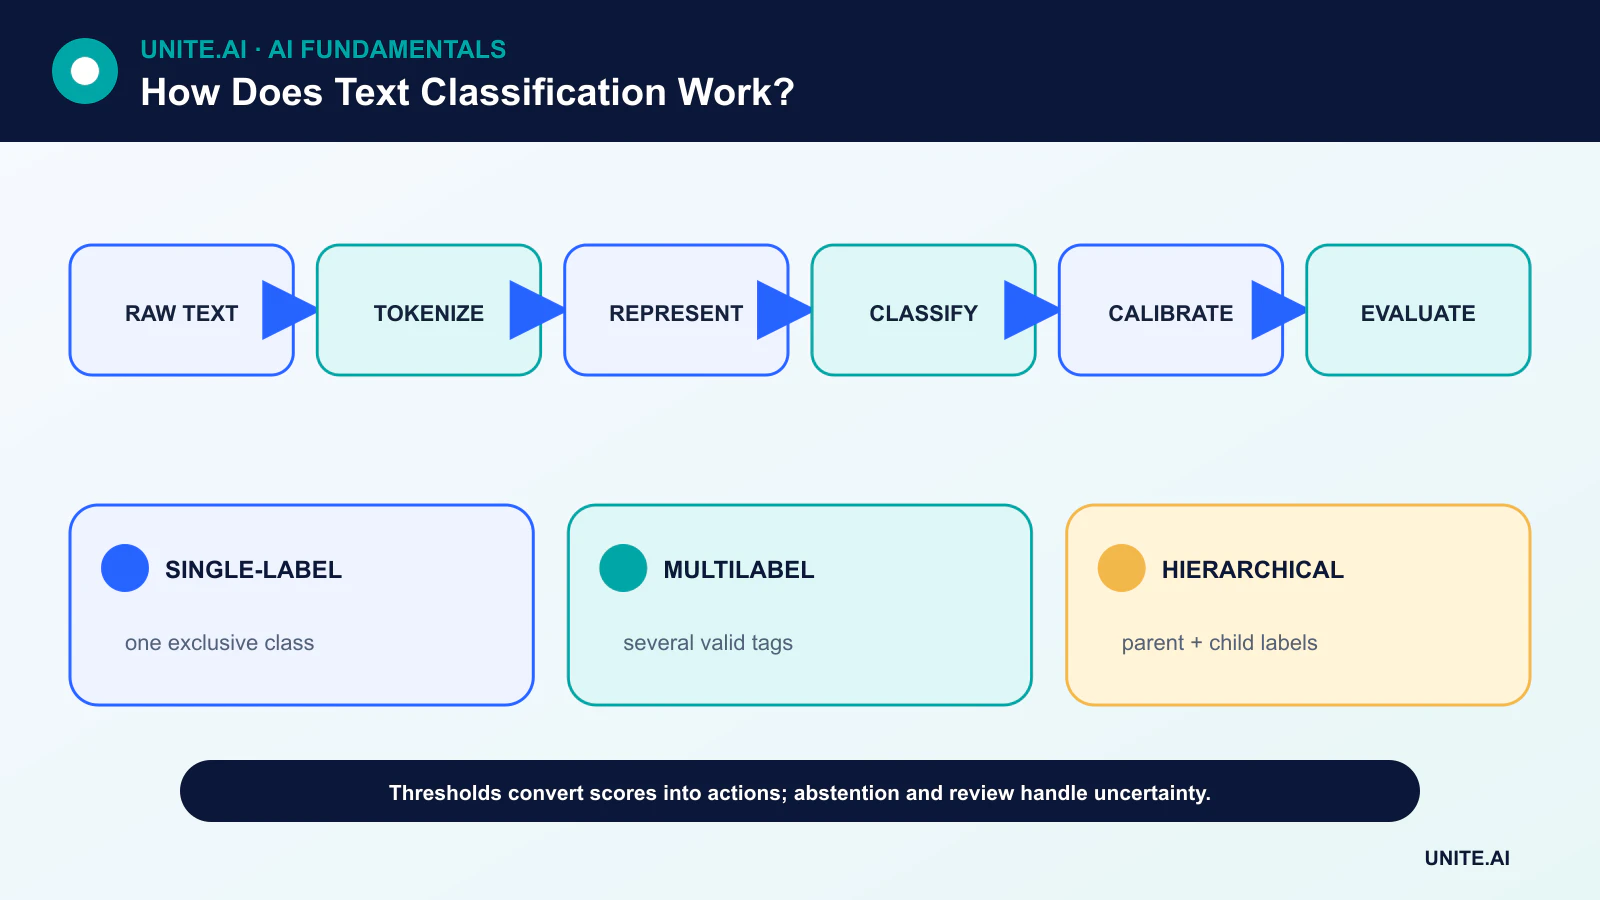
Μία εργασία μονής ετικέτας επιλέγει μία αμοιβαία αποκλειστική κλάση. Μία εργασία πολλαπλών ετικετών μπορεί να αναθέσει αρκετές ανεξάρτητες ετικέτες. Οι ιεραρχικές ταξινομίες περιλαμβάνουν γονικές και θυγατρικές ετικέτες. Πρόκειται για διαφορετικά προβλήματα μάθησης και απαιτούν διαφορετικές εξόδους και μετρικές.
Οι σημειωτές χρειάζονται ορισμούς, θετικά και αρνητικά παραδείγματα, κανόνες για έλλειψη συμφραζομένων και διαδρομή κλιμάκωσης. Τα στατιστικά συμφωνίας μπορούν να αποκαλύψουν μια ασαφή εργασία, αλλά η διαφωνία μπορεί επίσης να αντιπροσωπεύει πραγματική αμφισημία που το σύστημα πρέπει να διατηρήσει.
Αναπαράσταση κειμένου
Παραδοσιακές αλυσίδες χρησιμοποιούν καταμετρήσεις token, n‑grams και TF‑IDF με γραμμικούς ταξινομητές ή support vector machines. Εκπαιδεύονται γρήγορα, αποκαλύπτουν επιδραστικούς όρους και παρέχουν ισχυρή βάση.
Νευρωνικά συστήματα αντιστοιχούν tokens σε ενσωματώσεις. Προεκπαιδευμένοι κωδικοποιητές μετασχηματιστών χρησιμοποιούν προσοχή για να δημιουργήσουν συμφραζόμενες αναπαραστάσεις και μπορούν να βελτιστοποιηθούν με επισημασμένα παραδείγματα. Τα μοντέλα με προτροπή ή zero‑shot μπορούν να μειώσουν την αρχική σήμανση, αλλά η διατύπωση των ετικετών, η έκδοση του μοντέλου και η βαθμονόμηση πρέπει να αξιολογηθούν στον πραγματικό τομέα.
Εκπαίδευση χωρίς διαρροή
Το σύνολο δεδομένων χωρίζεται σε εκπαίδευση, επικύρωση και τελικό σύνολο δοκιμών. Έγγραφα ή μηνύματα που είναι σχεδόν διπλότυπα, ή προτύπους από την ίδια πηγή, πρέπει να παραμένουν στο ίδιο τμήμα. Για χρονικά εξαρτημένες χρήσεις, ένας χρονολογικός διαχωρισμός αντιπροσωπεύει καλύτερα την παραγωγή.
Η ανισορροπία κλάσεων μπορεί να αντιμετωπιστεί με ζύγισμα, επαναδειγματοληψία, επιλογή ορίου ή πρόσθετα δεδομένα. Τα συνθετικά παραδείγματα δεν πρέπει να αντικαθιστούν την ανασκόπηση πραγματικών αποτυχιών μειονεκτικών κλάσεων και μπορεί να εισάγουν τεχνητά χαρακτηριστικά που το μοντέλο μαθαίνει πολύ εύκολα.
Μετρικές και βαθμονομημένες αποφάσεις
Ένα confusion matrix δείχνει ποιες ετικέτες συγχέονται. Η ακρίβεια (precision) μετρά πόσες προβλεπόμενες θετικές είναι σωστές· η ανάκληση (recall) μετρά πόσες πραγματικές θετικές βρέθηκαν. Οι μέσοι macro ζυγίζουν τις κλάσεις εξίσου, ενώ οι μέσοι micro ζυγίζουν τα μεμονωμένα παραδείγματα.
Μια ακατέργαστη βαθμολογία softmax δεν είναι αυτόματα αξιόπιστη πιθανότητα. Η βαθμονόμηση συγκρίνει την εμπιστοσύνη με την παρατηρούμενη ορθότητα. Οι ομάδες μπορούν να θέσουν κλασικά όρια ανά κλάση, να αποχωρήσουν όταν η εμπιστοσύνη είναι χαμηλή και να δρομολογούν ευαίσθητες περιπτώσεις σε ανασκόπηση.
Παράδοση, πολυγλωσσική χρήση και drift
Το κείμενο αλλάζει με προϊόντα, γεγονότα, αργκό και εχθρική συμπεριφορά. Η παρακολούθηση πρέπει να παρακολουθεί τη γλώσσα εισόδου, το μήκος, τα μοτίβα εκτός λεξιλογίου, τα ποσοστά κλάσεων, την εμπιστοσύνη και τα καθυστερημένα αποτελέσματα. Η επανεκπαίδευση απαιτεί δεδομένα με έκδοση και μια σειρά ελέγχου παλινδρόμησης με σημαντικά παραδείγματα.
Η πολυγλωσσική απόδοση πρέπει να δοκιμάζεται ανά γλώσσα και διάλεκτο. Η μετάφραση όλων σε μία γλώσσα μπορεί να αλλάξει το συναίσθημα ή τις οντότητες· ένας πολυγλωσσικός κωδικοποιητής μπορεί ακόμη να παρουσιάζει άνιση απόδοση επειδή η προεκπαίδευσή του και οι ετικέτες δεν είναι εξίσου αντιπροσωπευτικές.
Αναπαραστάσεις και οικογένειες ταξινομητών
Η κατηγοριοποίηση κειμένου αντιστοιχίζει ένα έγγραφο, πρόταση ή ακολουθία token σε μία ή περισσότερες ετικέτες. Ορίστε αν οι ετικέτες είναι αμοιβαία αποκλειστικές, πολλαπλές, ιεραρχικές, διατεταγμένες ή ανοιχτού συνόλου. Οι παραδοσιακές αλυσίδες tokenizούν το κείμενο, δημιουργούν χαρακτηριστικά bag‑of‑words ή TF‑IDF και εκπαιδεύουν λογιστική παλινδρόμηση, naive Bayes ή γραμμικό SVM. Τα νευρωνικά συστήματα μαθαίνουν ενσωματώσεις με συνελικτικά, επαναληπτικά ή μετασχηματιστικά μοντέλα. Τα μοντέλα γλώσσας με προτροπή μπορούν να ταξινομήσουν χωρίς εξειδικευμένη εκπαίδευση, αλλά οι περιορισμοί εξόδου, το κόστος, το drift και τα αποδεικτικά στοιχεία χρειάζονται αξιολόγηση έναντι πιο απλών βάσεων.
Η προεπεξεργασία εξαρτάται από την αναπαράσταση. Η μετατροπή σε πεζά ή η αφαίρεση σημεία στίξης μπορεί να καταστρέψει σήματα για ονόματα, συναίσθημα, κώδικα ή γλώσσα· η ρίζωση (stemming) μπορεί να συγχωνεύσει διαφορετικές έννοιες. Οι tokenizers μετασχηματιστών λειτουργούν σε υπολέξεις και έχουν όρια μήκους, επομένως η στρατηγική περικοπής έχει σημασία. Μακρά έγγραφα μπορεί να απαιτούν κομμάτια και συγκέντρωση. Διατηρήστε το ακατέργαστο κείμενο και την έκδοση μετασχηματισμού, και χωρίστε κατά συγγραφέα, συζήτηση, πηγή ή χρόνο για να αποτρέψετε σχεδόν διπλότυπα και επαναλαμβανόμενα πρότυπα να διασχίσουν την εκπαίδευση και τη δοκιμή.
Ετικέτες, μετρικές και ανάλυση σφαλμάτων
Ένας οδηγός σημειώσεων πρέπει να ορίζει το πεδίο, παραδείγματα, ασαφείς περιπτώσεις και επιλογή «άγνωστο» ή αποχής. Μετρήστε τη συμφωνία και διαπραγματευτείτε τη διαφωνία αντί να την κρύψετε με πλειοψηφική ψήφο. Για ανισομερείς κλάσεις, η ακρίβεια είναι ανεπαρκής· αναφέρετε precision, recall, F1, confusion, calibration και φόρτο εργασίας ανά όριο ανά κλάση. Οι εργασίες πολλαπλών ετικετών χρειάζονται μετρικές micro, macro και επιπέδου ετικέτας. Αξιολογήστε γλώσσες, διαλέκτους, τομείς, μήκος μηνύματος και χρόνο. Ένας τυχαίος διαχωρισμός μπορεί να υπερεκτιμήσει την ποιότητα όταν το λεξιλόγιο ή τα πρότυπα drift.
Η ανάλυση σφαλμάτων πρέπει να διαχωρίζει αποτυχία αναπαράστασης, ανεπαρκή συμφραζόμενα, αμφισημία ετικέτας, σπάνιο λεξιλόγιο, άρνηση, σαρκασμό και ψευδείς ενδείξεις. Χρησιμοποιήστε αντισυμβατικά τεστ που αλλάζουν ονόματα, δείκτες διαλέκτου ή άσχετα μεταδεδομένα διατηρώντας το νόημα. Εξετάστε λάθη υψηλής εμπιστοσύνης και απορριφθέντες περιπτώσεις. Ένα μοντέλο μπορεί να μάθει ότι ένα κανάλι πελάτη ή υπογραφή προβλέπουν ετικέτα αντί να ερμηνεύουν το περιεχόμενο. Αφαιρέστε τη διαρροή και αναθεωρήστε τα δεδομένα πριν απλώς αυξήσετε την ικανότητα του μοντέλου.
Σχεδίαση παραγωγής
Παρέχετε έναν σταθερό tokenizer και μοντέλο με επικύρωση σχήματος, όρια μήκους, ομαδοποίηση και εναλλακτική λύση για μη υποστηριζόμενη γλώσσα ή χαμηλή εμπιστοσύνη. Παρακολουθείτε την κατανομή εισόδου, τα ποσοστά ετικετών, τη βαθμονόμηση, την καθυστέρηση και τα ανασκοπημένα αποτελέσματα. Προστατέψτε το κείμενο επειδή μπορεί να περιέχει προσωπικές, εμπιστευτικές ή εχθρικές οδηγίες. Για αυτοματοποιημένη διαχείριση, επιλεξιμότητα ή δρομολόγηση, παρέχετε δυνατότητα έφεσης και μετρήστε διαφορικές σφάλματα. Ενημερώστε ετικέτες και όρια με επιχειρηματική πολιτική. Η κατηγοριοποίηση κειμένου είναι αξιόπιστη μόνο εντός του ορισμένου συστήματος ετικετών και της κατανομής δεδομένων· οι ρέουσες εξηγήσεις του μοντέλου δεν αποδεικνύουν ότι μια ταξινόμηση είναι σωστή.
Παράδειγμα εφαρμογής: ταξινόμηση εισερχόμενων αιτημάτων υποστήριξης
Μία ομάδα υποστήριξης ορίζει αμοιβαία αποκλειστικές ετικέτες δρομολόγησης συν επιπλέον σημαίες επείγοντος, πολυγλωσσικότητας και άγνωστου. Οι σημειωτές επισημαίνουν ανώνυμα μηνύματα με οδηγίες για μεικτά ζητήματα και μετρούν τη συμφωνία. Ένα baseline TF‑IDF logistic, ένας προεκπαιδευμένος κωδικοποιητής και ένα μοντέλο με προτροπή χρησιμοποιούν το ίδιο σύνολο δοκιμών βάσει χρόνου. Οι εκθέσεις αξιολόγησης περιλαμβάνουν precision και recall ανά κλάση, ψευδώς αρνητικά επείγοντα, βαθμονόμηση, εγκυρότητα σχήματος, καθυστέρηση και κόστος, με ομαδοποίηση σχεδόν διπλότυπων προτύπων για αποφυγή διαρροής.
Ο αναπτυγμένος ταξινομητής επικυρώνει τη γλώσσα και το μήκος, αποχωρεί όταν τα αποδεικτικά είναι αδύναμα και επιτρέπει στους πράκτορες να διορθώνουν τις δρομολογήσεις. Οι προτροπές και τα μηνύματα θεωρούνται μη αξιόπιστα· η πρόσβαση σε εργαλεία δεν υπάρχει. Η παρακολούθηση παρακολουθεί την επικράτηση ετικετών, την εμπιστοσύνη, τις διορθώσεις, το χρόνο απόκρισης και τα αναδυόμενα θέματα. Μια πολιτική ή αλλαγή προϊόντος ενημερώνει την ταξινομία και τα δεδομένα επανεκπαίδευσης μέσω ανασκόπησης. Το σύστημα βελτιώνει την τοποθέτηση στην ουρά, αλλά δεν ερμηνεύει ποτέ το συναίσθημα ή το δικαίωμα του πελάτη πέρα από τις επικυρωμένες ετικέτες.
Απόδειξη υλοποίησης και ετοιμότητα λειτουργίας
Μια παραγωγική απόφαση απαιτεί περισσότερα από μια επιτυχημένη επίδειξη. Ορίστε τους προοριζόμενους χρήστες, το περιβάλλον λειτουργίας, τις εισόδους, τις εξόδους, τις εξαρτήσεις, τον υπεύθυνο και τις συνέπειες κάθε σημαντικής αποτυχίας. Καθιερώστε μια αναπαραγώγιμη βάση και ένα εκδοτικό σύνολο αξιολόγησης πριν από την παραμετροποίηση. Δοκιμάστε τυπικές περιπτώσεις, άκρα, εσφαλμένη ή ελλιπή είσοδο, μετατόπιση κατανομής, αποτυχία εξαρτήσεων, κακή χρήση και τις ομάδες ή περιβάλλοντα που είναι πιο πιθανό να υπολειτουργούν. Μετρήστε την ποιότητα της εργασίας μαζί με τη βαθμονόμηση ή την αβεβαιότητα, την καθυστέρηση, την απόδοση, το κόστος πόρων, την προσβασιμότητα, την ιδιωτικότητα και την ασφάλεια. Καταγράψτε κάθε μετασχηματισμό και όριο ώστε ένας ανεξάρτητος ελεγκτής να μπορεί να αναπαράγει το αποτέλεσμα και να διακρίνει την απόδειξη από ένα ελκυστικό πρωτότυπο.
Πριν την κυκλοφορία, αναθέστε εξουσία για κυκλοφορία, εξαιρέσεις, αλλαγές, επαναφορά και συνταγική λήξη. Χρησιμοποιήστε σταδιακή κυκλοφορία, διατηρήστε ασφαλή εναλλακτική λύση και επαληθεύστε την παρακολούθηση με σκόπιμα ενσωματωμένες αποτυχίες. Η λειτουργική τηλεμετρία πρέπει να αποκαλύπτει την ποιότητα εισόδου, τη συμπεριφορά εξόδου, την έκδοση μοντέλου ή κανόνα, την υγεία εξαρτήσεων, τις ανθρώπινες παρεμβάσεις και τα επιβεβαιωμένα αποτελέσματα χωρίς τη συλλογή περιττών ευαίσθητων δεδομένων. Ορίστε όρια ειδοποίησης και υπεύθυνο ανταπόκρισης, έπειτα ανασκοπήστε τα πραγματικά δεδομένα μετά την παραγωγή αντί να υποθέτετε ότι η εκτός σύνδεσης απόδοση θα διατηρηθεί. Επανεκτιμήστε όποτε αλλάζουν πηγές δεδομένων, χρήστες, μοντέλα, προμηθευτές, πολιτικές, υλικό ή στόχοι. Ένα συντηρημένο σύστημα χρειάζεται επίσης τεκμηριωμένη αποκατάσταση, μάθηση από περιστατικά, διαδικασίες διαγραφής και διατήρησης, και σαφές σημείο στο οποίο πρέπει να απενεργοποιηθεί ή να αντικατασταθεί.
Συχνές ερωτήσεις
Η ανάλυση συναισθήματος είναι εργασία κατηγοριοποίησης κειμένου;
Συνήθως ναι, αλλά το συναίσθημα μπορεί να είναι πολλαπλών ετικετών, βασισμένο σε πτυχή ή συνεχές αντί για μία ενιαία ετικέτα θετικό/ουδέτερο/αρνητικό.
Πότε πρέπει ένας ταξινομητής κειμένου να αποχωρήσει;
Όταν η εμπιστοσύνη είναι χαμηλή, το κείμενο είναι εκτός πεδίου, λείπουν τα απαιτούμενα συμφραζόμενα ή το κόστος μιας λανθασμένης αυτόματης ενέργειας υπερβαίνει το κόστος της ανασκόπησης.
Πρωτεύουσες αναφορές












