
Andersons vinkel
En bemærkelsesværdig fremgang i menneskedrevet AI-video

 Føj Unite.AI til dine foretrukne kilder på Google
Bemærk: Projektets side for dette arbejde indeholder 33 autoplaying high-res videoer, der i alt udgør en halv gigabyte, hvilket destabiliserede mit system under indlæsning. Af denne grund vil jeg ikke linke direkte til den. Læsere kan finde URL’en i abstract eller PDF, hvis de ønsker.
En af de primære mål i nuværende video-syntese-forskning er at generere en komplet AI-drevet video-præstation fra et enkelt billede. Denne uge offentliggjorde Bytedance Intelligent Creation en ny artikel, der måske er det mest omfattende system af denne type hidtil, i stand til at producere fuld- og semi-kroppsanimationer, der kombinerer udtryksfulde ansigtsdetaljer med præcis stor-skala-bevægelse, samtidig med at de opnår forbedret identitets-konsistens – et område, hvor selv førende kommercielle systemer ofte mangler.
I eksemplet nedenfor ser vi en præstation drevet af en skuespiller (øverst til venstre) og afledt fra et enkelt billede (øverst til højre), der giver en bemærkelsesværdigt fleksibel og behændig gengivelse, uden de sædvanlige problemer omkring oprettelse af store bevægelser eller ‘gætning’ om skjulte områder (dvs. dele af tøj og ansigtsvinkler, der må infæres eller opfindes, fordi de ikke er synlige i det eneste kildefoto):
LYDINDHOLD. Klik for at afspille. En præstation opstår fra to kilder, herunder lip-sync, som normalt er forbeholdt dedikerede hjælpe-systemer. Dette er en reduceret version fra kilde-sitet (se bemærkning i begyndelsen af artiklen – gælder for alle andre indlejrede videoer her).
Selv om vi kan se nogle resterende udfordringer i forhold til vedvarende identitet i hver klip, er dette det første system, jeg har set, der generelt (omend ikke altid) opretholder ID over en længere periode uden brug af LoRAs:
LYDINDHOLD. Klik for at afspille. Yderligere eksempler fra DreamActor-projektet.
Det nye system, kaldet DreamActor, bruger et tredelt hybrid kontrolsystem, der giver dedikeret opmærksomhed til ansigtsudtryk, hovedrotation og kerneskematisk design, hvilket muliggør AI-drevne præstationer, hvor hverken ansigt eller krop lider under det andet – en sjælden, muligvis ukendt kapacitet blandt lignende systemer.
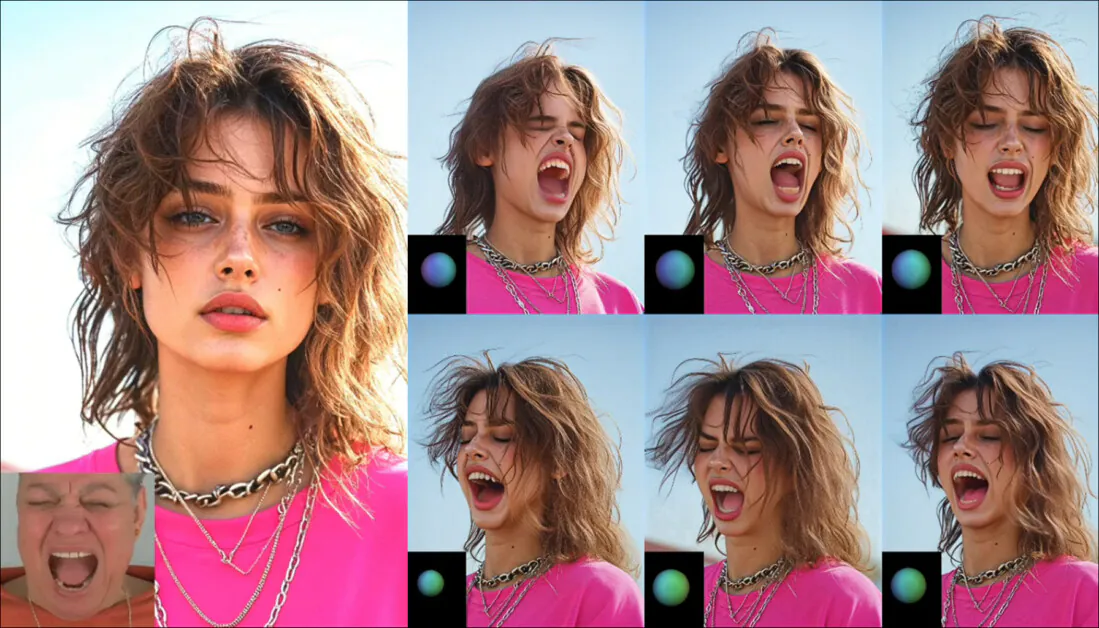
Længere nede ser vi en af disse aspekter, hovedrotation, i aktion. Den farvede bold i hjørnet af hver miniature til højre indikerer en slags virtuel gimbal, der definerer hoved-orientering uafhængigt af ansigtsbevægelse og udtryk, der her er drevet af en skuespiller (nederst til venstre).
Klik for at afspille. Den multicolorede bold visualiseret her repræsenterer rotationsaksen for avatar-hovedet, mens udtrykket er drevet af en separat modul og informeret af en skuespillers præstation (set her nederst til venstre).
Et af projektets mest interessante funktioner, der ikke engang er inkluderet ordentligt i papirets tests, er dets evne til at aflede lip-sync-bevægelse direkte fra lyd – en kapacitet, der fungerer usædvanligt godt, selv uden en drivende skuespiller-video.
Forskerne har taget på de bedste etablerede systemer i denne forfølgning, herunder den meget rostede Runway Act-One og LivePortrait, og rapporterer, at DreamActor var i stand til at opnå bedre kvantitative resultater.
Da forskere kan fastsætte deres egne kriterier, er kvantitative resultater ikke nødvendigvis en empirisk standard; men de tilhørende kvalitative tests synes at støtte forfatternes konklusioner.
Desværre er dette system ikke tiltænkt offentlig udgivelse, og den eneste værdi, som fællesskabet potentielt kan udlede fra arbejdet, er i at reproducere de metoder, der er beskrevet i artiklen (som det blev gjort med bemærkelsesværdig effekt for den ligeledes lukkede kilde Google Dreambooth i 2022 ).
Artiklen siger*:
‘Menneske-billede-animasjon har mulige sociale risici, som at blive misbrugt til at lave falske videoer. Den foreslåede teknologi kunne blive brugt til at lave falske videoer af mennesker, men eksisterende detektionsværktøjer [Demamba, Dormant] kan spotte disse falske videoer.
‘For at reducere disse risici er klare etiske regler og ansvarlige brugsvejledninger nødvendige. Vi vil strengt begrænse adgangen til vores kerne-modeller og -koder for at forhindre misbrug.’
Naturligvis er etiske overvejelser af denne type praktiske fra et kommercielt synspunkt, da det giver en begrundelse for API-kun adgang til modellen, som derefter kan moniteres. ByteDance har allerede gjort dette en gang i 2025 ved at gøre den meget rostede Omnihuman tilgængelig for betalte kredit på Dreamina-sitet. Derfor synes det sandsynligt, at DreamActor følger samme skæbne. Det, der blot skal ses, er, i hvilken udstrækning dets principper, så vidt de er beskrevet i artiklen, kan hjælpe det åbne fællesskab.
Den nye artikel er kaldt DreamActor-M1: Holistisk, udtryksfuld og robust menneske-billede-animasjon med hybrid vejledning, og kommer fra seks Bytedance-forskere.
Metode
DreamActor-systemet, der er foreslået i artiklen, sigter mod at generere menneske-animasjon fra et reference-billede og en drivende video, ved hjælp af en Diffusion Transformer (DiT) ramme, tilpasset til latent rum (apparentligt en slags Stable Diffusion, selv om artiklen kun citerer 2022-udgivelsespublikationen).
I stedet for at afhænge af eksterne moduler til reference-betingelse, kombinerer forfatterne udseende- og bevægelsesfunktioner direkte indenfor DiT-baggrunden, hvilket tillader interaktion mellem rum og tid gennem opmærksomhed:

Schema for det nye system: DreamActor koder stilling, ansigtsbevægelse og udseende i separate latenter, kombinerer dem med støjede video-latenter produceret af en 3D VAE. Disse signaler kombineres indenfor en Diffusion Transformer ved hjælp af selv- og kryds-opmærksomhed, med fælles vægte på tværs af grene. Modellen er overvåget ved at sammenligne afstøjede udgang med rene video-latenter. Kilde: https://arxiv.org/pdf/2504.01724
For at gøre dette, bruger modellen en forudtrænet 3D variational autoencoder til at koda både input-videoen og reference-billedet. Disse latenter patchificeres, konkateneres og føres ind i DiT, som behandler dem fælles.
Dette arkitektur afviger fra den almindelige praksis med at tilføje et sekundært netværk til reference-injektion, som var tilgangen for det indflydelsesrige Animate Anyone og Animate Anyone 2 projekter.
I stedet bygger DreamActor fusionen ind i hovedmodellen selv, hvilket forenkler designet og forbedrer informationsflowet mellem udseende- og bevægelseskilder. Modellen trænes derefter ved hjælp af flow-matching i stedet for den standardmæssige diffusion-objektive (Flow-matching træner diffusion-modeller ved direkte at forudsige hastighedsfelter mellem data og støj, og springer score-estimation over).
Hybrid Bevægelses-Vejledning
Hybrid Bevægelses-Vejlednings-metoden, der informerer de neurale renderinger, kombinerer stillingstokens afledt fra 3D-legeme-skeletter og hoved-sfærer; implicit ansigts-repræsentationer ekstraheret af en forudtrænet ansigts-encoder; og reference-udseende-tokens samplet fra kilde-billedet.
Disse elementer integreres indenfor Diffusion Transformer ved hjælp af distinkte opmærksomheds-mekanismer, hvilket tillader systemet at koordinere global bevægelse, ansigtsudtryk og visuel identitet på tværs af genereringsprocessen.
For det første af disse, i stedet for at afhænge af ansigts-landemærker, bruger DreamActor implicit ansigts-repræsentationer til at guide udtryks-generering, hvilket tilsyneladende muliggør en finere kontrol over ansigts-dynamik, samtidig med at det adskiller identitet og hoved-stilling fra udtryk.
Til at oprette disse repræsentationer, behandler pipeline først og cropper ansigts-området i hver frame af drivende video, og ændrer størrelsen til 224×224. De afkortede ansigter behandles af en ansigts-bevægelses-encoder forudtrænet på PD-FGC dataset, og derefter betinget af en MLP lag.

PD-FGC, anvendt i DreamActor, genererer en talende hoved fra et reference-billede med adskilt kontrol over lip-sync (fra lyd), hoved-stilling, øje-bevægelse og udtryk (fra separate videoer), hvilket tillader præcis, uafhængig manipulation af hver af dem. Kilde: https://arxiv.org/pdf/2211.14506
Resultatet er en sekvens af ansigts-bevægelses-tokens, der injiceres ind i Diffusion Transformer gennem en kryds-opmærksomheds lag.
Samme ramme understøtter også en lyd-drevet variant, hvor en separat encoder er trænet, der kortlægger tale-input direkte til ansigts-bevægelses-tokens. Dette gør det muligt at generere synkroniseret ansigts-animasjon – herunder lip-bevægelse – uden en drivende video.
LYDINDHOLD. Klik for at afspille. Lip-sync afledt ren fra lyd, uden en drivende skuespiller-reference. Den eneste karakter-input er det statiske billede set øverst til højre.
Anden, for at kontrollere hoved-stilling uafhængigt af ansigts-udtryk, introducerer systemet en 3D hoved-sfærisk repræsentation (se video indlejret tidligere i denne artikel), der adskiller ansigts-dynamik fra global hoved-bevægelse, hvilket forbedrer præcision og fleksibilitet under animation.
Hoved-sfærer genereres ved at trække 3D ansigts-parametre – såsom rotation og kamera-stilling – fra drivende video ved hjælp af FaceVerse sporing-metoden.

Schema for FaceVerse-projektet. Kilde: https://www.liuyebin.com/faceverse/faceverse.html
Disse parametre bruges til at rendre en farvet sfære projiceret på 2D-billedplanet, spatialt tilpasset til drivende hoved. Sfærens størrelse matcher reference-hovedet, og dens farve reflekterer hovedets orientering. Denne abstraktion reducerer kompleksiteten af at lære 3D hoved-bevægelse, hvilket hjælper med at bevare stiliserede eller overdrevne hoved-former i tegneserie-figurer.

Visualisering af kontrol-sfæren, der påvirker hoved-orientering.
Til sidst, for at guide fuld-kropps-bevægelse, bruger systemet 3D-legeme-skeletter med adaptiv ben-længde-normalisering. Legeme- og hånd-parametre estimeres ved hjælp af 4DHumans og hånd-fokuseret HaMeR, begge opererer på SMPL-X legeme-modellen.

SMPL-X anvender en parametrisk mesh over hele legemet i et billede, tilpasset til estimeret stilling og udtryk for at muliggøre stilling-bevidst manipulation ved hjælp af mesh’en som en volumetrisk guide. Kilde: https://arxiv.org/pdf/1904.05866
Fra disse udgang, vælges nøgle-led, projiceres ind i 2D, og forbinder til linje-baserede skelet-kort. I modsætning til metoder som Champ, der render fuld-kropps-mesh, undgår denne tilgang at påføre forudbestemte form-forudsætninger, og ved at afhænge udelukkende af skelet-struktur, opmuntres modellen til at slutte legeme-form og udseende direkte fra reference-billederne, reducerer bias mod faste legeme-typer og forbedrer generalisering på tværs af en række stillinger og bygninger.
Under træning kombineres 3D-legeme-skeletter med hoved-sfærer og passerer gennem en stilling-encoder, der udgang funktioner, der derefter kombineres med støjede video-latenter for at producere støj-tokens brugt af Diffusion Transformer.
Ved slutning af træning tager systemet hensyn til skelet-forskelle mellem emner ved at normalisere ben-længder. SeedEdit forudtrænet billed-redigering-model transformerer både reference- og drivende billeder til en standard kanonisk konfiguration. RTMPose bruges derefter til at trække skelet-proportioner, der bruges til at tilpasse drivende-skelettet til at matche anatomien af reference-emnet.

Oversigt over slutnings-pipeline. Pseudo-references kan genereres for at berige udseende-kilder, mens hybrid kontrol-signaler – implicit ansigts-bevægelse og ekspllicit stilling fra hoved-sfærer og legeme-skeletter – trækkes fra drivende video. Disse føres derefter ind i en DiT-model for at producere animeret udgang, med ansigts-bevægelse adskilt fra krop-stilling, hvilket tillader brug af lyd som driver.
Udseende-Vejledning
For at forbedre udseende-trofasthed, især i skjulte eller sjældent synlige områder, supplerer systemet det primære reference-billede med pseudo-references samplet fra input-videoen.
Klik for at afspille . Systemet forudser behovet for at gengive skjulte områder nøjagtigt og konsekvent. Dette er omkring det tætteste, jeg har set, i et projekt af denne type, på en CGI-stil bitmap-tekstur-tilgang.
Disse ekstra frames vælges for stilling-mangfoldighed ved hjælp af RTMPose og filtreres ved hjælp af CLIP-baseret lighed for at sikre, at de forbliver konsistente med emnets identitet.
Alle reference-frames (primære og pseudo) kodes af samme visuel encoder og kombineres gennem en selv-opmærksomheds-mekanisme, hvilket tillader modellen at få adgang til komplementære udseende-kilder. Denne opsætning forbedrer dækning af detaljer såsom profil-views eller lem-texturer. Pseudo-references bruges altid under træning og valgfrit under slutning.
Træning
DreamActor blev trænet i tre faser for at introducere kompleksitet og forbedre stabilitet.
I den første fase brugtes kun 3D-legeme-skeletter og 3D-hoved-sfærer som kontrol-signaler, og ansigts-repræsentationer udelades. Dette tillod den grundlæggende video-genererings-model, initialiseret fra MMDiT, at tilpasse sig menneske-animasjon uden at blive overvældet af fin-granedede kontroller.
I den anden fase tilføjedes implicit ansigts-repræsentationer, men alle andre parametre frosne. Kun ansigts-bevægelses-encoder og ansigts-opmærksomheds-lag trænedes på dette punkt, hvilket muliggjorde, at modellen lærte udtryksfulde detaljer i isolation.
I den endelige fase blev alle parametre af-frosne for fælles optimering på tværs af udseende, stilling og ansigts-dynamik.
Data og Tests
Til test-fasen initialiseres modellen fra en forudtrænet image-to-video DiT checkpoint† og trænes i tre faser: 20.000 skridt for hver af de første to faser og 30.000 skridt for den tredje.
For at forbedre generalisering på tværs af forskellige varighed og opløsninger, samples video-klip tilfældigt med længder mellem 25 og 121 frames. Disse resizes til 960x640px, mens de bevareder aspekt-forhold.
Træning udføres på otte (China-fokuseret) NVIDIA H20 GPU’er, hver med 96GB VRAM, ved hjælp af AdamW optimizer med en (tolerabelt høj) læringsrate på 5e−6.
Ved slutning af træning indeholder hver video-segment 73 frames. For at opretholde konsistens på tværs af segmenter, genbruges den endelige latent fra et segment som den initiale latent for det næste, hvilket kontekstualiserer opgaven som sekventiel image-to-video-generering.
Klassifikator-fri vejledning anvendes med en vægt på 2,5 for både reference-billeder og bevægelses-kontrol-signaler.
Forskerne konstruerede en trænings-dataset (ingen kilder er nævnt i artiklen) bestående af 500 timer video fra diverse domæner, der omfatter eksempler på (bl.a.) dans, sport, film og offentlige taler. Datasettet var designet til at fange en bred spektrum af menneske-bevægelse og udtryk, med en jævn fordeling mellem fuld-kropps- og halv-kropps-shots.
For at forbedre ansigts-syntese-kvalitet inkorporeredes Nersemble i data-forberedelses-processen.

Eksempler fra Nersemble-dataset, brugt til at supplere data for DreamActor. Kilde: https://www.youtube.com/watch?v=a-OAWqBzldU
Til evaluering brugte forskerne deres dataset også som en benchmark til at vurdere generalisering på tværs af forskellige scenarier.
Modellens præstation måles ved hjælp af standard-metrikker fra tidligere arbejde: Fréchet Inception Distance (FID); Structural Similarity Index (SSIM); Learned Perceptual Image Patch Similarity (LPIPS); og Peak Signal-to-Noise Ratio (PSNR) for frame-niveau-kvalitet. Fréchet Video Distance (FVD) bruges til at vurdere temporal kohærens og samlet video-trofasthed.
Forskerne udførte eksperimenter på både krop-animasjon og portræt-animasjon-opgaver, alle anvendende en enkelt (mål) reference-billede.
For krop-animasjon sammenlignedes DreamActor-M1 med Animate Anyone; Champ; MimicMotion, og DisPose.

Kvantitative sammenligninger mod rivaliserende rammer.
Selv om PDF’en giver en statisk billed-sammenligning, kan en af videoer fra projekt-sitet måske højligere fremhæve forskellene:
LYDINDHOLD. Klik for at afspille. En visuel sammenligning på tværs af udfordrer-rammer. Drivende video ses øverst til venstre, og forfatternes konklusion om, at DreamActor producerer de bedste resultater, synes rimelig.
For portræt-animasjon-tests blev modellen evalueret mod LivePortrait; X-Portrait; SkyReels-A1; og Act-One.

Kvantitative sammenligninger for portræt-animasjon.
Forskerne påstår, at deres metode vinder i kvantitative tests, og hævder, at den også er overlegen kvalitativt.
LYDINDHOLD. Klik for at afspille. Eksempler på portræt-animasjon-sammenligninger.
Argumenteret som den tredje og sidste af klipene vist i videoen ovenfor udstiller en mindre overbevisende lip-sync sammenlignet med nogle af de rivaliserende rammer, selv om den generelle kvalitet er bemærkelsesværdigt høj.
Konklusion
I forventning om, at teksturer, der er antydet, men ikke faktisk til stede i det enlige mål-billede, der driver disse rekonstruktioner, har Bytedance adresseret en af de største udfordringer for diffusion-baseret video-generering – konsekvente, vedvarende teksturer. Det næste logiske skridt efter at perfektionere en sådan tilgang ville være at oprette en reference-atlas fra den oprindelige genererede klip, der kan anvendes til efterfølgende, forskellige generationer, for at opretholde udseende uden LoRAs.
Selv om en sådan tilgang ville være en ekstern reference, adskiller det sig ikke fra texture-mapping i traditionel CGI-teknik, og kvaliteten af realisme og troværdighed er langt højere end, hvad disse ældre metoder kan opnå.
Det mest imponerende aspekt af DreamActor er dog det kombinerede tre-delt vejledningssystem, der brobygger den traditionelle kløft mellem ansigt-fokuseret og krop-fokuseret menneske-syntese på en genial måde.
Det eneste, der blot skal ses, er, om nogle af disse kerne-principper kan udnyttes i mere tilgængelige tilbud; som det står, synes DreamActor at være bestemt til at blive endnu et syntese-som-en-service-tilbud, alvorligt begrænset af brugsbegrænsninger og af ulemperne ved at eksperimentere omfattende med en kommerciel arkitektur.
* Min erstatning af hyperlinks for forfatterne; inline-citationer
† Som nævnt tidligere, er det ikke klart, hvilken smag af Stable Diffusion, der blev brugt i dette projekt.
Først offentliggjort fredag, 4. april 2025


