
Andersons vinkel
Tilføjelse af dialog til virkelige videoer med AI

 Føj Unite.AI til dine foretrukne kilder på Google
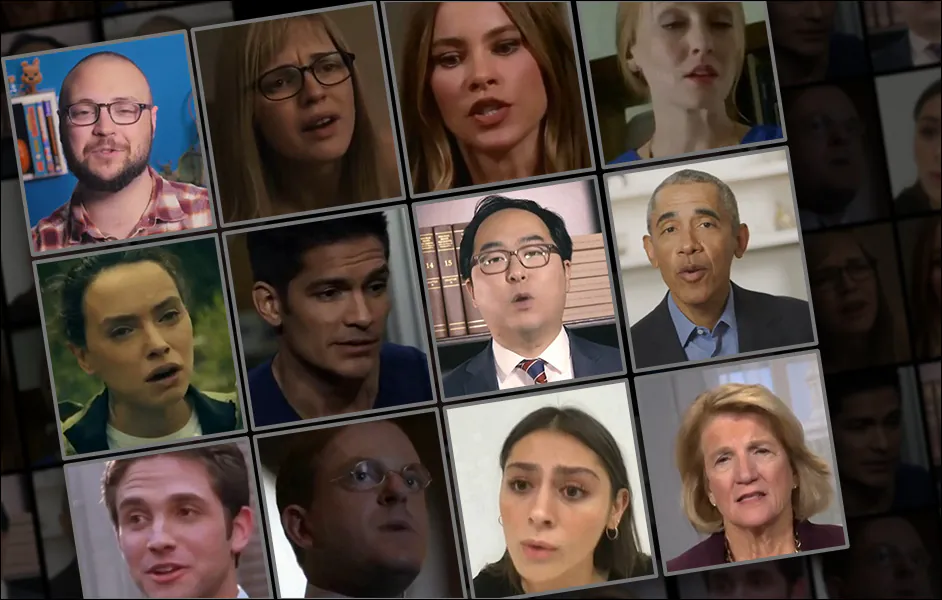
En ny AI-ramme kan omskrive, fjerne eller tilføje en persons ord i en video uden at skulle optage det hele igen, i et enkelt slut-til-slut-system.
For tre år siden ville internettet have været chokeret over enhver af de 20-30 AI-video-ændringsrammer, der offentliggøres på akademiske portaler hver uge; som det er, er denne populære forskningsstrøm nu blevet så produktiv, at den næsten udgør en ny gren af ‘AI-Slop’, og jeg dækker langt færre af disse udgivelser end jeg ville have for to eller tre år siden.
En af de nuværende udgivelser i denne linje fik dog min opmærksomhed: Et integreret system, der kan gribe ind i virkelige videooptagelser og indsætte nyt tale i den eksisterende video (i stedet for at oprette en hel genereret klip fra et ansigt eller en ramme, hvilket er langt mere almindeligt).
I eksemplerne nedenfor, som jeg har redigeret sammen fra en mængde af samplevideoer, der er tilgængelige på projektets webside, ser vi først den virkelige kildeklip, og derefter, under den, det påtvungne AI-tale i midten af klippet, herunder stemmesyntese og læbesynkronisering:
Klik for at afspille. Lokal redigering med syning – en af de flere modaliteter, der er tilgængelige i FacEDiT. Henvis til kildewebside for bedre opløsning. Kilde – https://facedit.github.io/
Dette tilgangsmåde er en af tre, der er udviklet til den nye metode, og den, der interesserer forfatterne (såvel som mig) mest. Essentielt set udvides klippet ved at bruge en af de midterste rammer som udgangspunkt for ny AI-tolkning, og dens efterfølgende (virkelige) ramme som mål, som den genererede indsættede klip skal sigte mod. I de klip, der ses ovenfor, er disse ‘frø’ og ‘mål’-rammer repræsenteret ved, at den øverste video standser, mens den ændrede video nedenfor giver genereret infill.
Forfatterne rammer denne ansigts- og vokal-syntese-tilgang som den første fuldt integrerede slut-til-slut-metode for AI-video-ændringer af denne type, og observerer potentialet for en fuldt udviklet ramme af denne type til TV- og filmproduktion:
‘Filminstruktører og medieproducenter har ofte brug for at revidere bestemte dele af optagede videoer – måske er et ord blevet udtalt forkert eller er manuskriptet ændret efter optagelse. For eksempel i den ikoniske scene fra Titanic (1997), hvor Rose siger, “I’ll never let go, Jack,” kan instruktøren senere beslutte, at det skal være “I’ll never forget you, Jack”.
‘Traditionelt set kræver sådanne ændringer, at hele scenen optages igen, hvilket er dyrt og tidskrævende. Taleansigts-syntese tilbyder en praktisk alternativ ved at automatisk ændre ansigtsbevægelser for at matche den reviderede tale, og eliminerer dermed behovet for genoptagelse.’
Selvom AI-indgreb af denne type kan møde kulturelle eller brancheresistens, kan de også udgøre en ny type funktionalitet i menneskeledede VFX-systemer og værktøjs-samlinger. I hvert fald er udfordringerne for øjeblikket strengt tekniske.
Ud over at udvide en klip gennem yderligere AI-genereret dialog, kan det nye system også ændre eksisterende tale:
Klik for at afspille.Et eksempel på ændring af eksisterende dialog i stedet for at indsætte yderligere dialog. Henvis til kildewebside for bedre opløsning.
Tilstand af kunsten
Der er for øjeblikket ingen slut-til-slut-systemer, der tilbyder denne type syntese-kapacitet; selvom en voksende mængde af generative AI-platforme, såsom Google’s Veo-serie, kan generere audio, og diverse andre rammer kan oprette deepfaked audio, skal man nu oprette en ret kompliceret pipeline af diverse arkitekturer og tricks for at kunne indgribe i virkeligt footage på den måde, som det nye system – titlen FacEDiT – kan opnå.
Systemet bruger Diffusion Transformers (DiT) i kombination med Flow Matching til at oprette ansigtsbevægelser, der er betinget af omgivende (kontekstuelle) bevægelser og tale-audio-indhold. Systemet udnytter eksisterende populære pakker, der beskæftiger sig med ansigtsrekonstruktion, herunder LivePortrait (som nylig er overtaget af Kling).
Ud over denne metode har forfatterne, da deres tilgang er den første til at integrere disse udfordringer i en enkelt løsning, oprettet en ny benchmark kaldet FacEDiTBench, sammen med flere helt nye evalueringsskalaer, der er egnet til denne meget specifikke opgave.
Det nye arbejde er titlen FacEDiT: Unified Talking Face Editing and Generation via Facial Motion Infilling, og kommer fra fire forskere på Koreas Pohang University of Science and Technology (POSTECH), Korea Advanced Institute of Science & Technology (KAIST) og The University of Texas at Austin.
Metode
FacEDiT er trænet til at genskabe ansigtsbevægelser ved at lære, hvordan man kan udfylde manglende dele af en skuespillers oprindelige præstation, baseret på den omgivende bevægelse og tale-audio. Som vist i skemaet nedenfor, giver denne proces modellen mulighed for at fungere som en gap-fylder under træning, og forudsiger ansigtsbevægelser, der matcher stemmen, samtidig med at den holder sig konsistent med den oprindelige video:

Oversigt over FacEDiT-systemet, der viser, hvordan ansigtsbevægelse læres gennem selv-supervised infilling under træning, guidede af redigeret tale under slutning, og endelig renderet tilbage til video ved at genbruge udseendet af den oprindelige footage, mens kun den målrettede bevægelse erstattes. Kilde
Under slutning støtter den samme arkitektur to forskellige outputs, afhængigt af, hvor meget af videoen der er maskeret: partielle redigeringer, hvor kun en frase ændres, og resten forbliver urørt; eller fuld-sætning-generering, hvor ny bevægelse syntetiseres helt fra scratch.
Modellen er trænet via flow matching, som behandler video-redigeringer som en slags vej mellem to versioner af ansigtsbevægelse.
I stedet for at lære at gætte, hvordan en redigeret ansigt skal se ud fra scratch, lærer flow matching at bevæge sig gradvist og jævnt mellem en støjende placeholder og den korrekte bevægelse. For at facilitere dette repræsenterer systemet ansigtsbevægelse som en kompakt samling af tal, der er udtrukket fra hver ramme ved hjælp af en version af den ovennævnte LivePortrait-system (se skema ovenfor).
Disse bevægelsesvektorer er designet til at beskrive udtryk og hovedstilling uden at binde identitet, sådan at taleændringer kan lokaliseres uden at påvirke personens overordnede udseende.
FacEDiT Træning
For at træne FacEDiT blev hver video-klip delt op i en række af ansigtsbevægelses-snapshots, og hver ramme parret med den tilsvarende del af audio. Tilfældige dele af bevægelsesdataene blev herefter skjult, og modellen bedt om at gætte, hvordan disse manglende bevægelser skulle se ud, ved at bruge både tale og omgivende umaskerede bevægelser som kontekst.
Fordi de maskerede span og deres positioner varierer fra den ene trænings-eksempel til den anden, lærer modellen gradvist, hvordan man kan håndtere både små interne redigeringer og længere huller, for fuld-sætning-generering, afhængigt af, hvor meget information den får.
Systemets ovennævnte Diffusion Transformer lærer at genskabe maskeret bevægelse ved at forfine støjende inputs over tid. I stedet for at føre tale og bevægelse ind i modellen på én gang, trådes audioen ind i hver behandlingsblok gennem cross-attention, hvilket hjælper systemet med at matche læbesbevægelser mere præcist til tale-audioen.
For at bevare realisme over redigeringer er opmærksomheden biaset mod nærliggende rammer i stedet for hele tidslinjen, hvilket tvinger modellen til at fokusere på lokal kontinuitet og forhindre flimren eller bevægelses-spring ved kanten af ændrede regioner. Positionelle indlejring (der fortæller modellen, hvor hver ramme optræder i sekvensen) hjælper yderligere med at opretholde naturlig tidsmæssig kontinuitet og kontekst.
Under træning lærer systemet at forudsige manglende ansigtsbevægelse ved at genskabe maskerede span baseret på tale og nærliggende umaskerede bevægelse. Under slutning genbruges dette samme setup, men med maskerne nu guidede af redigeringer i tale.
Når et ord eller en frase indsættes, fjernes eller ændres, lokaliserer systemet den berørte region, maskerer den og regenererer bevægelse, der matcher den nye audio. Fuld-sætning-generering behandles som en specialtilfælde, hvor hele regionen maskeres og syntetiseres fra scratch.
Data og Tests
Systemets bagben består af 22 lag for Diffusion Transformer, hver med 16 attention heads og feedforward-dimensioner på 1024 og 2024px. Bevægelses- og udseendes-egenskaber udtrækkes ved hjælp af frosne LivePortrait-komponenter, og tale kodificeres via WavLM og modificeres ved hjælp af VoiceCraft.
En dedikeret projekteringslag mapper de 786-dimensionale tale-egenskaber ind i DiT’s latente rum, med kun DiT og projekteringsmodulerne trænet fra scratch.
Træning blev udført under AdamW-optimeringen ved et mål-læringsrate på 1e-4, i en million trin, på to A6000-GPU’er (hver med 48GB VRAM), ved en samlet batch-størrelse på otte.
FacEDiTBench
FacEDiTBench-datasættet indeholder 250 eksempler, hver med en video-klip af den oprindelige og redigerede tale, samt transkriptionerne for begge. Videoerne kommer fra tre kilder, med 100 klip fra HDTF, 100 fra Hallo3 og 50 fra CelebV-Dub. Hver af dem blev manuelt kontrolleret for at bekræfte, at både audio og video var klare nok til evaluering.
GPT-4o blev brugt til at revidere hver transkription for at oprette grammatiske gyldige redigeringer. Disse reviderede transkriptioner, sammen med den oprindelige tale, blev givet til VoiceCraft for at producere ny audio; og på hvert trin blev både transkriptionen og den genererede tale manuelt gennemgået for kvalitet.
Hver prøve blev mærket med redigeringstypen, tidspunktet for ændringen og længden af den ændrede del, og redigeringer klassificeret som indsættelser, sletninger eller erstatninger. Antallet af ord, der ændredes, varierede fra korte redigeringer på 1-3 ord, medium-redigeringer på 4-6 ord og længere redigeringer på 7-10 ord.
Tre brugerdefinerede målinger blev defineret for at evaluere redigeringens kvalitet. Fotometrisk kontinuitet, for at måle, hvor godt en redigeret del blander sig med den omgivende video, ved at sammenligne pixel-niveau-forskelle ved grænserne; bevægelses-kontinuitet, for at bedømme konsistensen af ansigtsbevægelse, ved at måle optisk flow-ændringer over redigerede og uredigerede rammer; og identitetsbevarelse, for at estimere, om subjektets udseende forbliver konsistent efter redigering, ved at sammenligne ansigts-embeddings fra den oprindelige og den genererede sekvens ved hjælp af ArcFace-ansigtsgenkendelsesmodellen.
Tests
Testmodellen blev trænet på materiale fra de tre ovennævnte datasæt, i alt omkring 200 timers videoindhold, herunder vlogs og film, samt højopløste YouTube-videoer.
For at evaluere taleansigt-redigering blev FacEDiTBench brugt, samt HDTF-test-delen, som er blevet en standard for denne type opgaver.
Da der ikke var direkte sammenlignelige systemer, der kunne omfatte denne type slut-til-slut-funktionalitet, valgte forfatterne en række rammer, der kunne reproducere mindst nogle af de mål-funktioner, og som kunne fungere som baseline; navnlig KeyFace; EchoMimic; EchoMimicV2; Hallo; Hallo2; Hallo3; V-Express; AniPortrait; og SadTalker.
Flere etablerede målinger blev også brugt for at evaluere genererings- og redigeringens kvalitet, med læbesynkroniserings-nøjagtighed vurderet gennem SyncNet, og både den absolutte fejl mellem læbebevægelser og audio (LSE-D) og en tillids-score (LSE-C) rapporteret; Fréchet Video Distance (FVD) kvantificerer, hvor realistisk videoen ser ud; og Lærte Perceptuelle Lighedsmål (LPIPS), der måler perceptuel lighed mellem genererede og originale rammer.
For redigering blev alle målinger, undtagen LPIPS, kun anvendt på den ændrede del; for generering blev hele videoen vurderet, med grænse-kontinuitet ekskluderet.
Hver model blev bedt om at syntetisere en matchende video-sekvens, som herefter blev indssat i den oprindelige klip (forskerne bemærker, at denne metode ofte introducerede synlige diskontinuiteter, hvor den redigerede del mødte den omgivende footage). En anden tilgang blev også testet, hvor hele videoen blev regenereret fra den ændrede audio – men dette overskrev uvilkårligt uredigerede regioner og lykkedes ikke med at bevare den oprindelige præstation:

Sammenligning af redigeringens præstation over systemer, der oprindeligt er designet til taleansigtsgenerering, med FacEDiT, der overgår alle baseline-systemer over alle målinger, og opnår lavere læbesynkroniserings-fejl (LSE-D), højere synkroniserings-tillid (LSE-C), stærkere identitetsbevarelse (IDSIM), større perceptuel realisme (FVD) og glattere overgange over redigerings-grænser (P-kontinuitet, M-kontinuitet). Gråtonede kolonner fremhæver de vigtigste kriterier for at evaluere grænse-kvalitet; fed og underliniede værdier angiver de bedste og næstbedste resultater, henholdsvis.
Med hensyn til disse resultater kommenterer forfatterne:
‘[Vores] model overgår eksisterende metoder på redigerings-opgaven. Den opnår stærk grænse-kontinuitet og høj identitetsbevarelse, og demonstrerer sin evne til at opretholde tidsmæssig og visuel konsistens under redigering. Derudover viser dens overlegne læbesynkroniserings-nøjagtighed og lav FVD den realisme, der er til stede i den syntetiserede video.’
Klik for at afspille. Resultater, samlet af denne forfatter fra de offentliggjorte videoer på projektets webside. Henvis til kildewebside for bedre opløsning.
Yderligere blev en menneske-studie udført for at evaluere den opfattede kvalitet over både redigering og generering.
For hver sammenligning så deltagere seks videoer og rangerede dem efter overordnet kvalitet, hvor de overvejede læbesynkroniserings-nøjagtighed, naturlighed og realisme af hovedbevægelse. I redigerings-forsøg rangerede deltagere også glatheden af overgange mellem redigerede og uredigerede dele:

Gennemsnitlige rangeringer tildelt af menneskelige evalueringer, hvor lavere er bedre. I både redigering og generering vurderede deltagere, hvor naturlig og synkroniseret hver video så ud. For redigering vurderede de også, hvor glat overgangen var mellem redigerede og uredigerede dele. Fed og underliniede tal viser de to bedste resultater.
I studiet blev FacEDiT konsekvent rangeret som nummer ét af en klar margin, både for redigeringskvalitet og overgangs-glatthed, og modtog også stærke score i genererings-indstillingen, hvilket antyder, at dens målte fordele oversætter sig til perceptuelt foretrukne outputs.
På grund af pladsmangel henviser vi læseren til kilde-papiret for yderligere detaljer om ablations-studier og andre tests, der blev kørt og rapporteret i det nye arbejde. I virkeligheden kæmper prototypiske forsknings-tilbud af denne type med at generere meningsfulde test-resultat-sektioner, da selve tilbuddet i sig selv er uundgåeligt en potentiel baseline for senere arbejde.
Konklusion
Selv for slutning kan systemer som dette kræve betydelige beregningsressourcer, hvilket gør det svært for downstream-brugere – her, formodentlig VFX-butikker – at holde arbejdet på stedet. Derfor vil tilgange, der kan tilpasses til realistiske lokale ressourcer, altid være at foretrække af udbydere, der er under lovpligt til at beskytte kundernes footage og generel IP.
Det betyder ikke, at det nye tilbud skal kritiseres, som meget vel kan fungere perfekt under kvantificerede vægte eller andre optimeringer, og som er det første tilbud af sin art, der har tiltrukket mig tilbage til denne forskningsvej i ganske lang tid.
Først offentliggjort onsdag, den 17. december 202. Redigeret 20.10 EET, samme dag, for ekstra plads i første tekst-afsnit.


