
Základy AI
Co jsou IT operace (ITOps)?

 Přidejte Unite.AI mezi své preferované zdroje na Google
IT operace (ITOps) představují činnost provozování technologických služeb, na které organizace spoléhá.
Moderní ITOps není omezeno na síťové operační centrum sledující dashboardy. Týmy stále častěji spravují softwarově definovanou infrastrukturu, platformové služby, automatizaci a distribuované vlastnictví, přičemž si zachovávají odpovědnost za incidenty, kapacitu, kontinuitu a úrovně služeb.
Klíčové body
- ITOps spravuje služby a jejich závislosti napříč on‑premise, cloudovými a edge prostředími.
- Pozorovatelnost, konfigurace a inventář poskytují kontext potřebný k interpretaci selhání.
- Řízení incidentů obnovuje službu; řízení problémů řeší opakující se nebo systémové příčiny.
- ITOps se překrývá s ITSM, SRE, DevOps, SecOps a AIOps, ale není identické s žádným z nich.
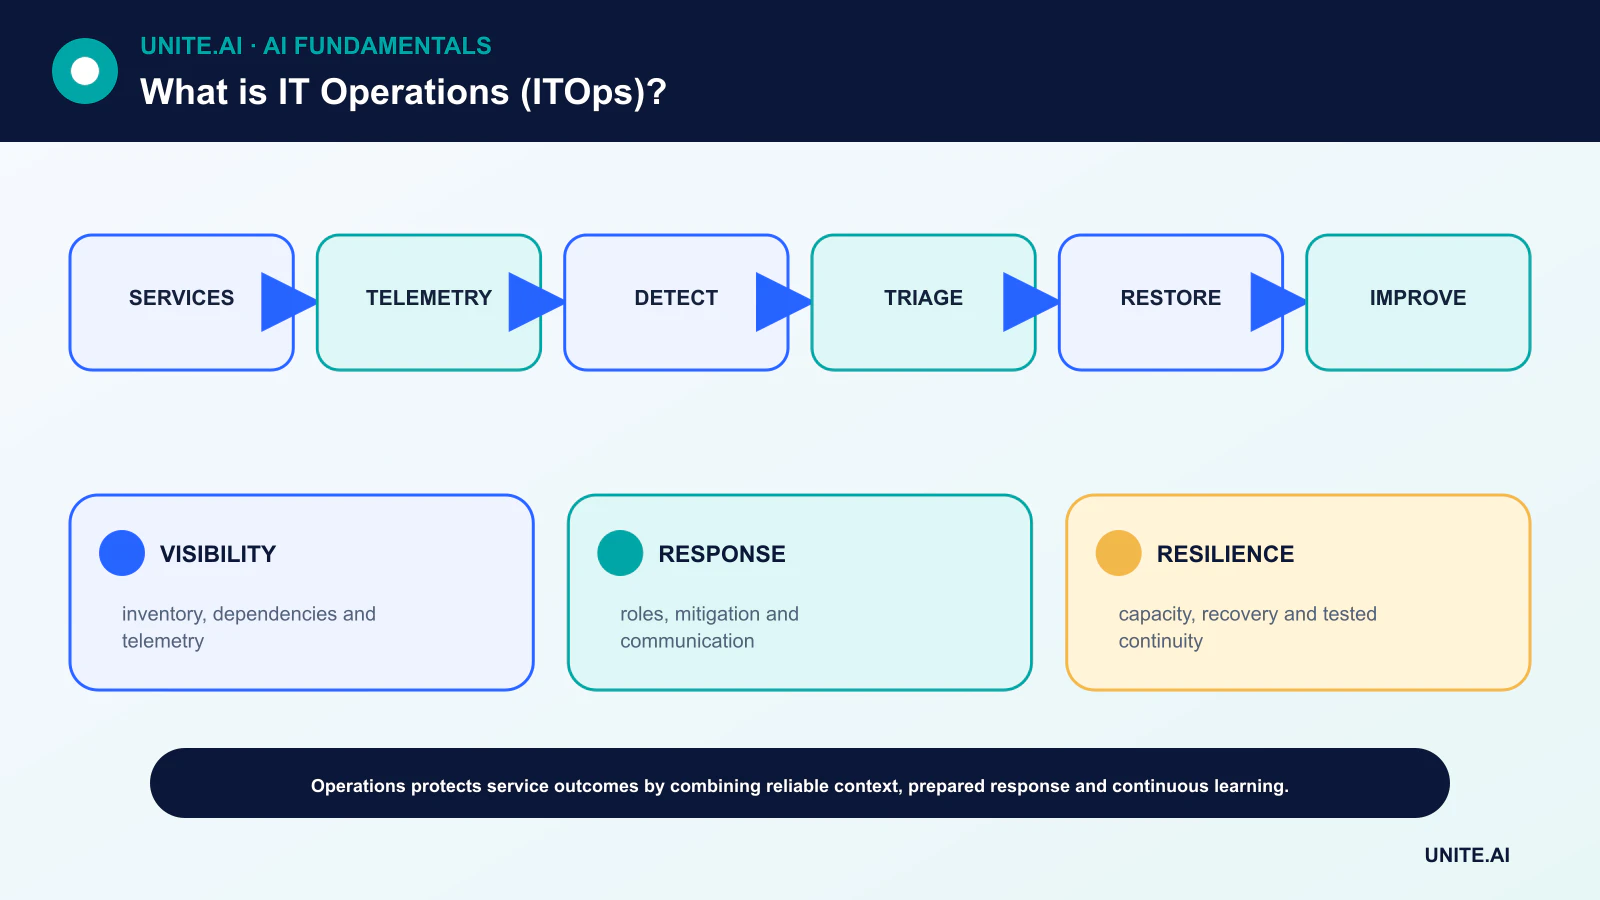
Služby, aktiva a konfigurace
Operace začíná poznáním, které služby existují, kdo je vlastní, na které uživatele se spoléhají a jaká infrastruktura je podporuje. Inventář aktiv zaznamenává komponenty; správa konfigurace zaznamenává relevantní vztahy a řízený stav.
Inventář, který se nikdy nevyrovná, se stává zavádějícím. Automatizujte objevování tam, kde je užitečné, identifikujte autoritativní zdroje a zaznamenávejte důvěryhodnost nebo aktuálnost místo předstírání, že každá mapa závislostí je kompletní.
Pozorovatelnost a cíle služby
Metriky kvantifikují chování, logy zaznamenávají události a sledování (traces) sledují práci napříč službami. Syntetické kontroly mohou testovat uživatelskou cestu. Užitečná pozorovatelnost začíná otázkami a cíli služby, poté sbírá signály potřebné k jejich zodpovězení.
Upozorňování by mělo identifikovat podmínky vyžadující včasnou akci. Práhy bez dopadu na uživatele vytvářejí šum, zatímco chybějící kontext závislostí zpomaluje diagnostiku. AIOps může pomoci s korelací, ale potřebuje spolehlivou telemetrii a provozní zpětnou vazbu.
Řízení incidentů, problémů a změn
Řízení incidentů koordinuje detekci, třídění, zmírnění, komunikaci a obnovu. Jasné role snižují zmatek pod tlakem. Dočasné řešení může obnovit službu, zatímco pozdější vyšetřování problému řeší hlubší příčiny.
Řízení změn hodnotí a zaznamenává riziko, aniž by každou změnu proměnilo v frontu. Standardní, automatizované a nízkorizikové změny mohou následovat předschválené cesty; změny s vysokým dopadem vyžadují silnější důkazy, plánování a přípravu návratu.
Kapacita, odolnost a kontinuita
Týmy předpovídají poptávku po zdrojích, odstraňují úzká místa a testují chování pod zátěží. Zálohy jsou užitečné jen tehdy, když je testována obnova. Redundance pomáhá jen tehdy, když jsou režimy selhání nezávislé a přepnutí skutečně funguje.
Obchodní kontinuita stanovuje priority, dobu obnovy a přijatelné ztráty dat. Závislosti na identitě, DNS, cloudových řídicích rovinách a dodavatelích by měly být zahrnuty do cvičení, nikoli předpokládány jako dostupné.
ITOps, ITSM, SRE a DevOps
Řízení IT služeb poskytuje procesy pro sladění služeb s potřebami organizace. Site reliability engineering (SRE) aplikuje softwarové inženýrství na provoz a používá cíle úrovně služby a rozpočty chyb. DevOps spojuje vývoj a provozní zpětnou vazbu.
SecOps se zaměřuje na hrozby a reakce, zatímco ITOps udržuje širší zdraví služby. Organizační schémata se liší; důležitým požadavkem je explicitní vlastnictví a sdílené důkazy napříč těmito disciplínami.
Provozní model ITOps
IT operace udržuje technologické služby organizace dostupné, výkonné, zabezpečené a obnovitelné. Rozsah běžně zahrnuje koncové body, identitu, sítě, servery, cloud, úložiště, spolupráci, databáze, monitorování, servisní desk, zálohy a služby dodavatelů. Moderní ITOps zahrnuje vlastněnou infrastrukturu i spravované platformy, takže odpovědnost musí být explicitní i v případě outsourcingu provozu. Inventář konfigurací nebo služeb propojuje technické komponenty s vlastníky, uživateli, závislostmi, klasifikací dat a obchodní kritičností.
Řízení služeb organizuje incidenty, požadavky, problémy, změny, aktiva, znalosti a úrovně služeb. Řízení incidentů obnovuje službu; řízení problémů zkoumá opakující se příčiny; umožnění změn hodnotí a koordinuje riziko. Považování každé změny za pomalé schválení vytváří obchvaty, zatímco neřízená automatizace způsobuje nekontrolované selhání. Standardní nízkorizikové změny mohou být předautorizovány a automatizovány; změny s vysokým rizikem potřebují důkazy, komunikaci, návrat a plánování na základě dopadu.
Spolehlivost, kapacita a kontinuita
Monitorování by mělo sledovat služby směrované k uživateli a jejich závislosti, nikoli jen počet zařízení. Definujte dostupnost, latenci, kapacitu, aktuálnost a cíle podpory s obchodními vlastníky. Upozorňujte na akční symptomy a spotřebu rozpočtu chyb; obohacujte události o vlastnictví a nedávné změny. Modely plánování kapacity zahrnují poptávku, nasycení, licence a dodací lhůtu. Elasticita cloudu snižuje prodlevu při poskytování, ale neodstraňuje kvóty, regionální limity ani kontrolu nákladů.
Obchodní kontinuita vyžaduje testované zálohy, obnovu, obnovu identity, alternativní sítě, kontakty na dodavatele a manuální postupy. Definujte cíle doby obnovy a bodu obnovy pro každou službu. Záloha není důkazem obnovy, dokud není obnovena a ověřena. Procvičujte scénáře ransomware, ztráty regionu, vypršených certifikátů, výpadku identity a selhání dodavatele. Sledujte konfiguraci a infrastrukturu jako kód, kde je to možné, aby byla obnova reprodukovatelná.
Bezpečnost, automatizace a metriky
Používejte princip nejmenších oprávnění, správu záplat a zranitelností, kontrolu koncových bodů, segmentaci sítí, logování a reakci na incidenty. Automatizujte opakovanou práci s idempotencí, limity, schváleními a auditem. Měřte dostupnost služby, opakování incidentů, plnění požadavků, selhání změn, obnovu, expozici záplat, kapacitu, náklady a spokojenost uživatelů – ne jen uzavření ticketu. ITOps je úspěšné, když technologie podporuje práci předvídatelně a dokáže se zotavit z selhání, nikoli když infrastruktura vypadá vytíženě nebo dashboardy obsahují více zelených indikátorů.
Praktický příklad: obnovení kolaborační služby
Společnost stanoví čtyřhodinový cíl doby obnovy a jednouhodinový cíl bodu obnovy pro kolaborační platformu. Inventarizuje identitu, DNS, síť, data, klíče, konfiguraci, integrace a závislosti na dodavatelích. Cvičení obnovy předpokládá, že primární region a administrátorský účet nejsou k dispozici. Operátoři aktivují nezávisle chráněnou nouzovou identitu, obnoví konfiguraci služby a data do izolovaného regionu a ověří oprávnění, zprávy, integrace a přístup klientů. Obchodní vlastníci ověřují obnovenou službu pomocí realistických uživatelských cest místo spoléhání se jen na kontrolu zdraví infrastruktury.
Cvičení zaznamenává skutečnou ztrátu dat, uplynulý čas, manuální kroky, neúspěšné kontakty a skryté závislosti. Záloha, která obnoví soubory, ale ne šifrovací klíče ani politiku identity, je označena jako neúplná. Opravné akce jsou přiřazeny vlastníkům a datům a provozní příručka je aktualizována a znovu testována. Jsou zahrnuty šablony pro monitorování a komunikaci. Organizace měří důkazy o obnově místo úspěšnosti zálohovací úlohy, uznávajíc, že spolehlivé ITOps musí obnovit službu, kterou uživatelé potřebují, za realistických podmínek selhání.
Důkazy o implementaci a provozní připravenost
Rozhodnutí o nasazení do produkce vyžaduje více než úspěšnou demonstraci. Definujte zamýšlené uživatele, provozní prostředí, vstupy, výstupy, závislosti, vlastníka a důsledek každého důležitého selhání. Vytvořte reprodukovatelnou výchozí úroveň a verzovanou sadu hodnocení před laděním. Testujte běžné případy, hraniční podmínky, poškozené nebo chybějící vstupy, posun distribuce, výpadek závislosti, zneužití a skupiny nebo prostředí, která jsou pravděpodobně nedostatečně obsloužena. Měřte kvalitu úkolu spolu s kalibrací nebo nejistotou, latencí, propustností, náklady na zdroje, přístupností, soukromím a bezpečností. Zaznamenejte každou transformaci a práh, aby nezávislý recenzent mohl výsledek reprodukovat a odlišit důkazy od atraktivního prototypu.
Před spuštěním přiřaďte pravomoci pro vydání, výjimky, změny, návrat a ukončení. Použijte postupné nasazení, zachovejte bezpečnou záložní možnost a ověřte monitorování s úmyslně vloženými selháními. Provozní telemetrie by měla odhalit kvalitu vstupů, chování výstupů, verzi modelu nebo pravidla, stav závislostí, lidské zásahy a potvrzené výsledky, aniž by sbírala zbytečná citlivá data. Definujte prahy upozornění a odpovědného za reakci, poté po nasazení přezkoumejte reálné důkazy místo předpokladu, že offline výkon bude přetrvávat. Přehodnoťte vždy, když se změní zdroje dat, uživatelé, modely, dodavatelé, zásady, hardware nebo cíle. Udržovaný systém také potřebuje dokumentovanou obnovu, učení z incidentů, postupy mazání a uchování a jasný bod, kdy má být deaktivován nebo nahrazen.
Často kladené otázky
Jaký je hlavní cíl ITOps?
Poskytovat a obnovovat spolehlivé technologické služby v rámci dohodnutých bezpečnostních, výkonnostních, kontinuitních a nákladových omezení.
Je cloudová infrastruktura provozována zcela poskytovatelem cloudu?
Ne. Poskytovatelé provozují části podkladové platformy, zatímco zákazníci zůstávají odpovědní za konfiguraci, identitu, data, pracovní zatížení, monitorování a řadu rozhodnutí na úrovni služby.
Primární reference












