
Základy AI
Co je automatizace incidentů? Pracovní postupy, ochranné zábrany a příklady použití

 Přidejte Unite.AI mezi své preferované zdroje na Google
Automatizace incidentů používá software k detekci, obohacení, směrování, koordinaci a někdy i nápravě provozních nebo bezpečnostních incidentů. Propojuje monitorovací signály s runbooky, ticketingem, komunikací, přístupovými kontrolami a akcemi obnovy, takže respondenti tráví méně času kopírováním dat a více času rozhodováním.
Automatizace neznamená odstranění lidské odpovědnosti. Bezpečný program rozlišuje nízkorizikové deterministické kroky od akcí, které mohou ovlivnit zákazníky nebo produkci, a následně podle dopadu uplatňuje schválení, omezené přihlašovací údaje, auditní záznamy, časové limity a návrat k předchozímu stavu.
Klíčové poznatky
- Automatizujte opakovatelný sběr důkazů před pokusem o autonomní nápravu.
- Používejte závažnost, důvěru, dosah dopadu a reverzibilitu k výběru úrovně schválení.
- Považujte každý runbook za verzovaný produkční kód s testy a vlastníkem.
- Měřte detekci, potvrzení, obnovu, opakování a dopad na uživatele – ne jen objem upozornění.
Od signálu k koordinované reakci
Pracovní postup může deduplifikovat upozornění, připojit nedávné nasazení a logy, identifikovat vlastníka služby, otevřít záznam incidentu, vyvolat on‑call tým, vytvořit komunikační kanál a zahájit časovou osu. Tyto kroky snižují kognitivní zátěž, aniž by automaticky prováděly rizikovou diagnostiku.
Korelace musí zachovat důkazy. Pokud platforma příliš agresivně seskupuje symptomy, může skrýt souběžné incidenty. Propojte automatizaci s vlastnictvím IT operací a zachovejte surové signály, které mohou respondenti potřebovat.
Volba akcí podle rizika
Čtení pouze dotazů, snímky a reverzibilní přesměrování provozu jsou obecně snazší k automatizaci než mazání dat, rotace širokých přihlašovacích údajů nebo změna produkčního schématu. Pro každou akci definujte předpodmínky, časový limit provedení, následné podmínky a návrat k předchozímu stavu.
Používejte identitu služby s nejmenšími oprávněními a oddělte autorizaci od workflow engine. Kroky s vysokým dopadem by měly vyžadovat identifikovaného schvalujícího. Pokud AIOps navrhne příčinu nebo opravu, respondenti stále potřebují podpůrné důkazy a bezpečný způsob, jak to odmítnout.
Vytvořte spolehlivé runbooky
Runbook by měl uvádět vstupy, závislosti, vlastníka, rozsah, chování při selhání a vytvořené důkazy. Otestujte jej ve stagingu a během cvičných dnů. Idempotentní kroky jsou cenné, protože jejich opakování nevytváří další škodu.
Verzujte a revidujte automatizaci jako ostatní software. Sledujte vypršení platnosti přihlašovacích údajů, změny API, limity rychlosti, částečné provedení a skryté propojení mezi službami. Manuální postupy zůstávají nutné, když je samotná platforma automatizace nedostupná.
Učte se po obnově
Automatizace by měla zachovat časově označený záznam signálů, rozhodnutí, akcí, schválení a výsledků. Beze viny provedená revize pak může oddělit přispívající podmínky systému od konečného spouštěče a proměnit poučení v otestovaná vylepšení.
Užitečné metriky zahrnují průměrnou dobu k potvrzení a obnovení, procento automatizovaných bezpečných kroků, míru neúspěšných akcí, opakované incidenty a dopad na zákazníky. Výsledky propojte s plánováním DevOps místo optimalizace počtu uzavřených tiketů.
Typy automatizace incidentů
Automatizace událostí normalizuje a obohacuje příchozí signály. Automatizace koordinace vytváří záznam incidentu, vyvolává vlastníky, otevírá komunikační kanály a zveřejňuje aktualizace stavu. Diagnostická automatizace provádí dotazy jen pro čtení nebo zachycuje snímky. Automatizace nápravy mění stav systému, zatímco automatizace obnovy ověřuje zdraví služby a uzavírá dočasná zmírnění.
Tyto kategorie by neměly sdílet jednotnou výchozí úroveň důvěry. Obohacování může často běžet automaticky; přepnutí produkce může vyžadovat kontrolu důvěry a schvalovatele; obnovení dat obvykle potřebuje velitele incidentu a vlastníka aplikace. Kontrola by měla vycházet z potenciálního dopadu, nikoli z toho, zda je krok implementován pravidlem nebo modelem strojového učení.
Bezpečnostní incidenty přidávají požadavky na zachování důkazů. Automatizace musí zabránit úpravě kompromitovaného hosta před zachycením volatilních dat, zveřejnění citlivých indikátorů ve veřejných kanálech nebo karanténě sdílené infrastruktury bez pochopení dosahu dopadu. Provozní a forenzní runbooky se mohou překrývat, ale jejich pořadí se může lišit.
Návrh workflow a řídicí rovina
Modelujte runbook jako explicitní stavy s předpodmínkami a koncovými výsledky. Každá akce by měla hlásit spuštění, úspěch, selhání, časový limit nebo přeskočení, spolu s neměnným identifikátorem provedení. Centrální orchestrátor může koordinovat kroky, ale služby v downstreamu by měly samostatně vynucovat vlastní autorizaci a nezávisle ověřovat vstupy.
Používejte omezené, krátkodobé přihlašovací údaje a omezte síťové cesty od automatizačního enginu. Oddělte vývojové, testovací a produkční běžce. Tajemství nesmí být obsažena v chatových přepisech nebo logech. Pro akce s vysokým dopadem vyžadujte schválení dvěma osobami nebo roli break‑glass, jejíž použití vytvoří okamžitý auditní záznam.
Navrhněte pro částečné selhání. Ticket může být vytvořen, zatímco vyvolání selže; přesměrování provozu může uspět v jedné oblasti a časově vypršet v jiné. Kompenzační akce, úkoly pro sladění a jasné vlastnictví zabraňují tomu, aby workflow hlásilo úspěch jen proto, že proces orchestraci skončil.
Příklady, testování a zralost
Zralým prvním příkladem použití je vyčerpání databázových spojení: sbírejte metriky poolu, nedávná nasazení, pomalé dotazy a informace o vlastníkovi; otevřete incident; navrhněte reverzibilní škálování nebo akci přesměrování provozu; vyžadujte schválení; poté ověřte chybovost a latenci. Stejný vzor může sloužit pro vypršení certifikátu, tlak na disk, selhané úlohy nebo podezřelou aktivitu účtu.
Testujte runbooky pomocí unit testů, mockovaných API, testovacích incidentů, cvičných dnů a řízených produkčních cvičení. Vpravte zastaralá data, odmítnutí oprávnění, pomalé závislosti, duplicitní události a konfliktní incidenty. Potvrďte, že opakování jsou bezpečná a že respondenti mohou převzít manuální kontrolu, aniž by bojovali s automatizací.
Zralost postupuje od upozornění, přes obohacení, k vedeným akcím, až po omezenou automatickou nápravu. Pokrok by měl záviset na důkazech: stabilní diagnostika, nízká míra neúspěšných akcí, ověřený rollback a jasný uživatelský přínos. Autonomní uzavření by mělo být výjimečné, dokud systém nedokáže prokázat obnovu a zachovat dostatek důkazů pro následné učení.
Praktický příklad: automatizace incidentu produkční služby
Uvažujme platební API, jehož chybovost stoupá po nasazení. Monitorování vydává strukturované upozornění obsahující službu, prostředí, region, verzi, rozpočet chyb a odkaz na runbook. Automatizace jej obohatí o záznam změny, stav závislostí, nedávné logy a vlastnictví, a poté seskupí duplicitní upozornění do jednoho incidentu. Deterministická politika může okamžitě pozastavit další nasazení; rollback by měl vyžadovat důkazy, že nová verze je příčinou a že rollback je bezpečný.
Workflow přiřadí velitele incidentu, otevře komunikační kanály, zaznamená časovou osu a navrhne diagnostické kroky. Automatizovaná náprava začíná nízkorizikovými reverzibilními akcemi, jako je přesměrování provozu na zdravou instanci. Každá akce potřebuje autorizaci, limity souběžnosti, časový limit, ověřené následné podmínky a rollback. Generativní souhrny mohou pomoci respondentům, ale zdrojová telemetrie a příkazy zůstávají viditelné, aby tým mohl zpochybnit nesprávný příběh.
Měřte čas k detekci, potvrzení, zmírnění a obnově; objem upozornění; potlačení duplicit; úspěšnost nápravy; opakování; a škody způsobené automatizací. Provádějte cvičné dny pro vypršené přihlašovací údaje, částečné regiony, zavádějící upozornění a selhání rollbacku. Po obnově zachovejte faktickou časovou osu, identifikujte přispívající technické a organizační podmínky, aktualizujte runbooky a testy a sledujte opravy až do dokončení místo toho, aby se rychlé zmírnění považovalo za konec práce na spolehlivosti.
Praktický kontrolní seznam implementace
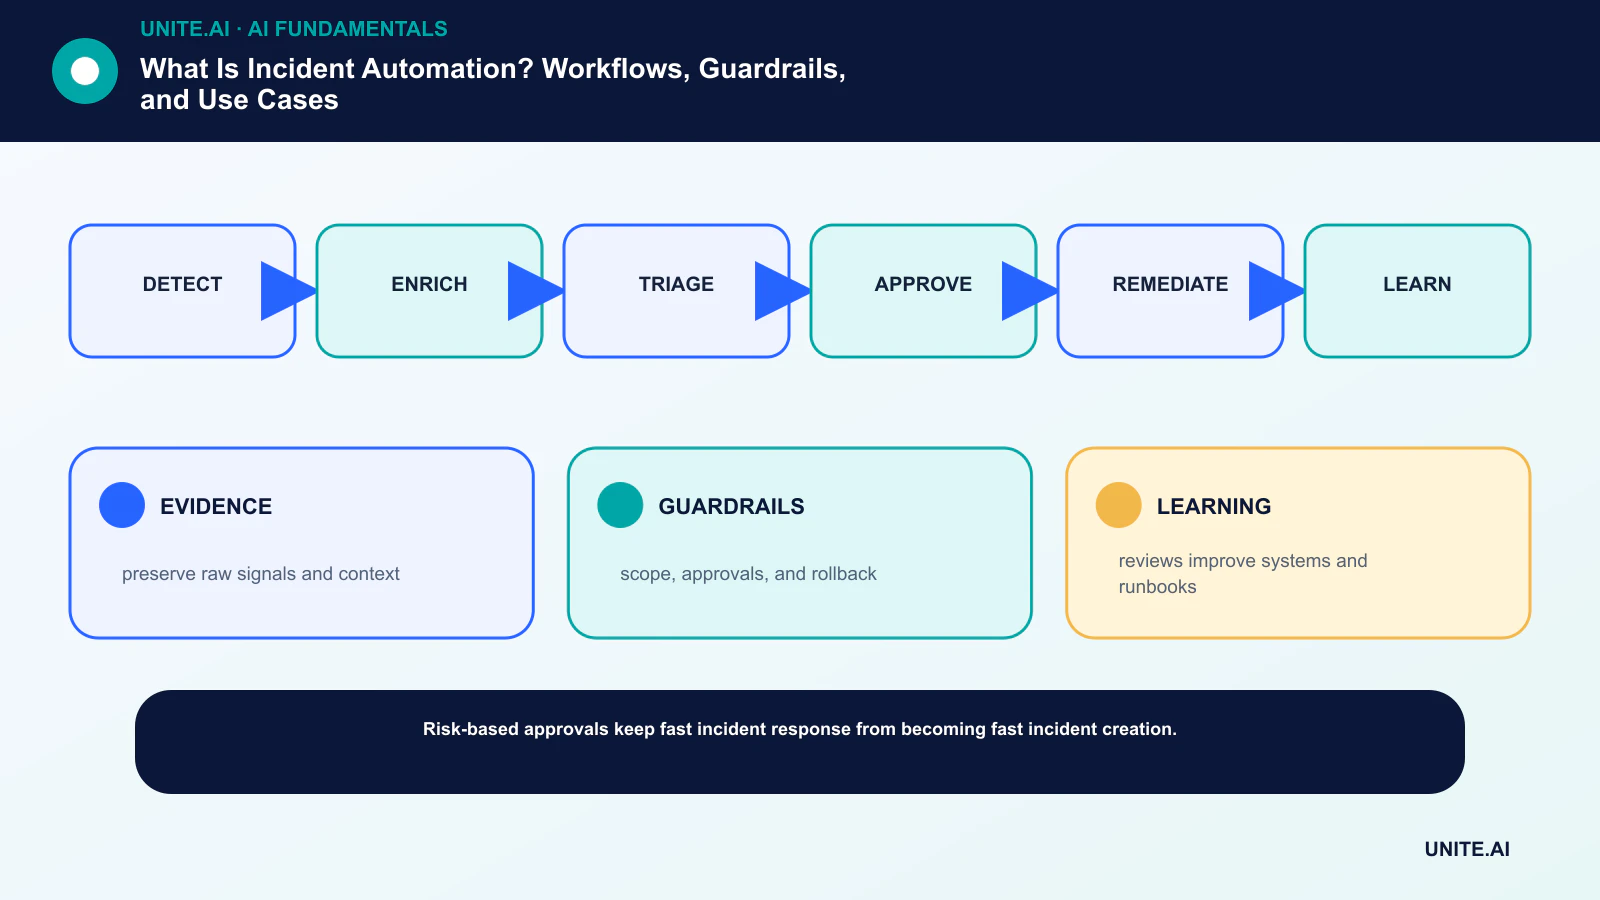
Přeměňte koncept na omezený, testovatelný workflow: detekce → obohacení → třídění → schválení → náprava → učení. Určete odpovědného vlastníka, zdokumentujte data a závislosti, vytvořte jednoduchý výchozí stav, stanovte kritéria přijetí a zastavení, otestujte reprezentativní selhání a definujte monitorování, rollback a revizi před rozšířením rozsahu. Zaznamenejte verze a předpoklady, aby jiný tým mohl výsledek reprodukovat a pochopit, co se změnilo.
Před nasazením proveďte zdokumentovanou revizi připravenosti s lidmi, kteří systém staví, provozují, zabezpečují a jsou jím ovlivněni. Testujte běžné případy, hraniční podmínky, selhání závislostí a zneužití; zachovejte důkazy a nevyřešená rizika. Definujte, kdo může schválit vydání, změnit práh, přepsat výstup nebo zastavit provoz. Rozhodnutí přehodnoťte po příchodu reálných dat, protože technicky úspěšný pilot nezaručuje spolehlivý výkon v širším měřítku.
- DŮKAZY: zachovejte surové signály a kontext.
- OPRAVNÉ PRVKY: rozsah, schválení a rollback.
- UČENÍ: revize zlepšují systémy a runbooky.
Často kladené otázky
Je automatizace incidentů totéž jako AIOps?
Ne. AIOps aplikuje analytiku nebo strojové učení na provozní data. Automatizace incidentů je širší vrstva provádění a koordinace; může využívat jednoduchá pravidla, výstupy AIOps nebo obojí.
Co by mělo být automatizováno jako první?
Začněte s vysoce frekventovanými, nízkorizikovými a dobře pochopenými kroky, jako je obohacování, vyhledání vlastníka, zachycení důkazů, aktualizace stavu a reverzibilní diagnostika.
Primární reference











