
Andersonův úhel
Sejde z očí, sejde z mysli: řešení největšího problému AI videa

 Přidejte Unite.AI mezi své preferované zdroje na Google
Klíčové bodyNový hybridní paměťový systém řeší chronickou amnézii AI videí tím, že udržuje…
Zobrazit více
- Nový hybridní paměťový systém řeší chronickou amnézii AI videí tím, že udržuje konzistenci postav mimo záběr.
- Metoda využívá tokenizaci paměti a dynamické vyhledávání k zachování vzhledu a pohybu během opuštění scény.
- HyDRA překonává předchozí přístupy oddělením dynamických subjektů od statického pozadí v latentním prostoru.
Největším problémem i těch nejlepších generátorů AI videa je chronická ztráta paměti – výzva, kterou nyní řeší nový výzkum z Číny.
Největší problém i těch nejlepších a nejmodernějších systémů generování AI videa spočívá v tom, že všechny trpí chronickou ztrátou paměti: Pokud se kamera odvrátí od sledovaného motivu a potom se vrátí, už nenajde to, co tam bylo na začátku. Postavy zmizí nebo změní vzhled či způsob pohybu a pravděpodobně se změní také pozadí.
Důvodem je omezené posuvné okno pozornosti difuzního generativního systému a skutečnost, že se systém vždy zabývá pouze tím, co právě vidí. Jde o skutečné ztělesnění solipsismu: To, co je mimo obraz, pro generativní AI neexistuje – doslova se to vyhodí z paměti.
To nikdy nebyl problém tradičního CGI, které může kdykoli využít referenci a přesně znovu vytvořit motiv včetně vzhledu a pohybu, a to v kterémkoli místě renderovaného videa, kde je znovu potřeba:

Tradiční CGI sítě a bitmapové textury lze vždy znovu použít při renderování, a zachovat tak konzistentní vzhled. U AI metod je to podstatně obtížnější, protože neexistuje odpovídající samostatný referenční soubor ani soubor souvisejících podkladů.
Jednotlivé součásti CGI, například síť a textury (viz obrázek výše), stejně jako pohybové soubory a další dynamické chování, mohou být uloženy samostatně na disku a kdykoli vloženy do kompozice.
Generativní video AI takové samostatné úložiště podkladů nemá. Nejblíže se této funkci dostávají LoRA – speciálně trénované doplňkové soubory, které lze trénovat na běžném spotřebitelském vybavení a s jejichž pomocí lze nové postavy a konkrétní oblečení „vnutit“ do videa:
Kliknutím přehrajete. Problém solipsismu v AI videu lze pomocí LoRA do jisté míry zmírnit, výsledky však mohou být přehnaně výrazné.
Nejde ovšem o ideální řešení. LoRA jsou jednak vázány na přesnou konkrétní verzi základního modelu, například Wan2+ nebo Hunyuan Video, a při každé změně základního modelu je nutné vytvořit je znovu. Jednak mají LoRA sklon zkreslovat váhy základního modelu, takže se identita natrénovaná pomocí LoRA vnucuje všem postavám ve scéně. Metody jemného ladění tohoto typu jsou navíc velmi citlivé na špatně připravené datové soubory.
Přesné návraty
Nová spolupráce akademické a průmyslové sféry z Číny nyní nabízí první významné řešení, které jsem během více než tří let psaní o tomto problému zaznamenal. Metoda využívá to, co výzkumníci označují jako hybridní paměť, aby postava mimo obraz a její bezprostřední okolí zůstávaly aktivní a přesně zachované v latentním prostoru modelu. Když se k nim pohled vrátí, výsledek je proto konzistentní:
Kliknutím přehrajete. Dva příklady z webu nového projektu ukazují postavy generované pomocí AI (WAN), které opouštějí obraz a přesně se do něj vracejí. Zdroj
Je nutné zdůraznit, že to není totéž jako dosažení konzistence postav napříč různými záběry. To údajně dokázala verze Gen 4 od Runway uvedená před rokem a ve výzkumné literatuře zůstává nadále aktivně sledovaným cílem.
Zde se naopak řeší něco, co žádný komerční ani experimentální systém, který jsem viděl, nedokázal: vizuálně konzistentní opětovné objevení původního vzhledu, pohybu a okolí postavy, jež byla mimo obraz:
Kliknutím přehrajete. Další dva hlavní příklady uvedené na webu nového projektu.
Stejné principy lze zjevně využít i v jiných oblastech, například při průzkumu městského prostředí, jízdě z pohledu řidiče nebo jiných typech renderování bez postav.
Je také třeba zdůraznit, že tento přístup neřeší ani nezpracovává problém, který Runway Gen4 a jiné uzavřené platformy údajně vyřešily opětovným vytvářením postav napříč různými záběry. Místo toho dělá to, co se žádné z nich dosud nepodařilo: uchovává postavu a prostředí v paměti bez nutnosti, aby byly neustále viditelné pro diváka.
Nová práce zahrnuje vlastní datový soubor vytvořený pomocí Unreal Engine, vlastní metriky problému solipsismu* a generativní systém na míru postavený nad WAN. V testech proti několika dostupným obdobným systémům autoři tvrdí, že dosahují špičkových výsledků, a uvádějí:
„Paměťové mechanismy se staly zásadní oblastí rozvoje světových modelů, protože kapacita paměti určuje prostorovou a časovou konzistenci generovaného obsahu.
„Paměť je konkrétně kognitivní kotvou, která modelu umožňuje uchovávat historický kontext při změnách pohledu nebo dlouhodobé extrapolaci.
„Bez robustní paměti se simulovaný svět rychle rozpadá na nesouvislé, chaotické snímky.“
Tato nová práce nese název Mimo dohled, nikoli však mimo mysl: hybridní paměť pro dynamické video modely světa a pochází od sedmi výzkumníků z Huazhong University of Science and Technology a týmu Kling společnosti Kuaishou Technology.
Metoda
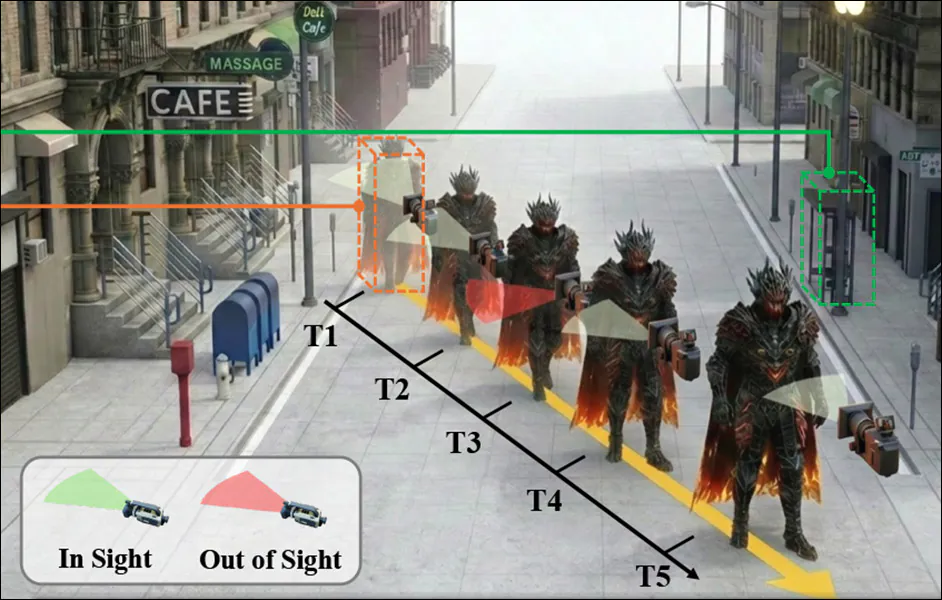
Ústředním prvkem nové práce je hybridní paměť, která umožňuje extrapolaci mimo zorné pole – uchování postav a jejich kontextu, když se divák dívá jinam nebo když postava sama opustí obraz. Systém v takové situaci musí provádět prostorově-časové oddělení, při němž současně sleduje generování viditelné divákovi i existenci postavy mimo obraz, přestože už není vidět.

Příklady pohybu kamery vedoucího ke vstupu do obrazu a jeho opuštění. Zde postava opouští obraz kvůli pohybu kamery, ale v jiných ukázkách lze vidět i to, jak se postava sama dočasně přesune mimo obraz. Zdroj
Autoři poznamenávají, že v latentních embeddings difuzního modelu jsou příznaky, které je třeba extrahovat a využít, silně provázané s dalšími příznaky a vlastnostmi. Pokus o jejich extrakci často způsobí, že motiv „zamrzne“ v pozadí. Proto vytvořili a připravili datový soubor HM-World**, určený přímo k trénování hybridní paměti:

Ukázky čtyř kategorií datového souboru HM-World převzaté z práce.
Soubor je vystavěn ve čtyřech dimenzích: trajektorie motivů, trajektorie kamer, scény a motivy.
Syntetická data v HM-World obsahují 17 scén a 49 motivů, včetně lidí různého vzhledu i zvířat několika druhů. Jejich kombinace jsou procedurálně umísťovány do scény pomocí Unreal Engine, každá s vlastní pohybovou animací, a poté nastaveny na náhodně vybranou trajektorii.
Autoři uvádějí, že datový soubor zachycuje rozmanité události opuštění a návratu do obrazu. Zahrnuje 28 různých trajektorií kamer, každou s více počátečními body.
Výsledný soubor má 59 225 videoklipů, z nichž každý anotoval multimodální velký jazykový model MiniCPM-V (MLLM).
Výzkumníci poukazují na statistické výhody své kolekce oproti dřívějším datovým souborům WorldScore, Context-As-Memory, Multi-Cam Video a 360° Motion:

Srovnání existujících datových souborů a HM-World. „Dynamic Subject“ označuje přítomnost pohyblivých entit, „Subject Exit-Enter“ klipy, v nichž motivy opouštějí obraz a vracejí se do něj, a „Subject Pose“ zahrnutí anotovaných 3D póz.
Méně prošlapaná cesta
Z několika předchozích snímků a známé trajektorie kamery je třeba předpovědět budoucí pohledy při změnách divákovy perspektivy. Zároveň je nutné zohlednit motivy, které se pohybují nezávisle a mohou před návratem opustit obraz. Nestačí tedy zachovat stabilní pozadí: model musí mít souvislý vnitřní záznam vzhledu a chování každého pohyblivého motivu, a to i po dobu, kdy není vidět.
Metoda Hybrid Dynamic Retrieval Attention (HyDRA) autorů řeší tuto úlohu zavedením vlastní paměťové cesty, která odděluje dynamické motivy od statické reprezentace scény. Mohou tak přetrvávat v čase a znovu se objevit s konzistentním vzhledem i pohybem:

Koncepční schéma modelu HyDRA.
HyDRA je postavena nad Wan2.1-T2V-1.3B. Jádro difuzního procesu zůstává z velké části nezměněné, ale doplňuje ho upravený transformer blok s dynamickou pozorností při vyhledávání v paměti. Model tak dokáže výběrově vybavovat pohybové a vzhledové podněty z minulých snímků místo spoléhání na pevný nebo lokální kontext.
Proces využívá upravený trénovací cíl Flow Matching namísto standardní difuzní ztráty.
Aby scény odpovídaly pohybu kamery, vkládají se trajektorie kamer jako explicitní podmiňovací signál. Póza každého snímku se definuje rotací a translací a poté převádí na kompaktní reprezentaci vývoje pohledu v čase.
Podobně jako u předchozího projektu týmu Kling ReCamMaster pak výsledek zpracuje kamerový kodér implementovaný jako vícevrstvý perceptron. Jeho výstup se rozšíří a přidá k příznakům Diffusion Transformeru, takže model může udržovat konzistentní polohu objektů při pohybu kamery.
Tokenizace
Surové difuzní latentní reprezentace spojují pohyb motivu, vzhled a pozadí do jediného provázaného celku. Přímé vyhledávání v tomto prostoru může přinést nesouvisející kontext nebo způsobit, že se pohyblivé motivy „slijí“ s okolím.
HyDRA problém řeší pomocí Memory Tokenizeru založeného na 3D konvoluci, který zpracovává prostor a čas současně. Nepředává úplnou historii latentních reprezentací, ale komprimuje ji do kompaktních paměťových tokenů zohledňujících pohyb a zachovávajících vzhled i pohyb motivů:

Přehled HyDRA. Vlevo Memory Tokenizer převádí předchozí snímky na kompaktní paměťové tokeny zohledňující pohyb. Vpravo Dynamic Retrieval Attention porovnává aktuální dotaz s tokeny, vyhledává ty nejrelevantnější a využívá je k obnovení konzistentního vzhledu a pohybu v generovaném snímku.
Tokeny tvoří strukturovanou hybridní paměť, která filtruje šum a zachovává dlouhodobou dynamiku. Po předání modulu Dynamic Retrieval Attention umožňují modelu výběrově vybavovat motivy mimo obraz, aby se vracely s konzistentním vzhledem, pohybem a kontextem.
Dynamická pozornost při vyhledávání v paměti
Duální paměťový mechanismus HyDRA využívá také dynamickou pozornost při vyhledávání v paměti v samostatné, ale doplňující roli.
Paměťová tokenizace komprimuje minulé latentní reprezentace do strukturovaných tokenů zohledňujících pohyb. Oddělují dynamické motivy od statického obsahu scény a snižují provázanost, která často způsobuje splývání motivů s pozadím. Tvoří trvalou paměťovou banku místo úplné historie snímků.
Dynamická pozornost při vyhledávání pak během generování pracuje nad touto bankou, porovnává aktuální dotaz s uloženými tokeny a výběrově vybavuje ty nejdůležitější pro vznikající snímek. Motivy mimo obraz tak mohou pokračovat ve svém latentním vývoji, například dál kráčet nebo běžet, i když nejsou vidět, a po návratu se objevit s konzistentním vzhledem a pohybem místo resetování či degradace.
Data a testy
V testech systém HyDRA založený na Wan zakódoval a zmenšil rozlišení 77 kontextových snímků před jejich zpracováním pomocí 3D variačního autoenkodéru (VAE), zatímco zmíněný paměťový tokenizér používal 3D konvoluci s velikostí jádra 2 × 4 × 4.
Model se trénoval na HW-World po 10 000 iterací na 32 GPU neuvedeného typu s velikostí dávky 32.
Testy využily nezvykle mnoho metrik: kromě běžného Peak Signal-to-Noise Ratio (PSNR), Structural Similarity Index (SSIM) a Learned Perceptual Similarity Metrics (LPIPS) autoři použili také konzistenci motivů a konzistenci pozadí ze sady VBench pro hodnocení soudržnosti na úrovni snímků.
Vyvinuli také vlastní metriku nazvanou Dynamic Subject Consistency (DSC). Ta využívá ohraničující rámečky z YOLO V11 k vytvoření výřezů obsahujících pohyblivé motivy, ze kterých se extrahují sémantické příznaky a následně počítá jejich podobnost.
HyDRA se porovnávala s Diffusion Forcing Transformerem (DFoT) a Context-As-Memory, a to nad základním modelem Wan2.1-T2V-1.3B vybaveným kamerovým kodérem pro reprezentaci subjektivního pohledu společného všem klipům. Všechny modely se trénovaly na HW-World a WorldPlay sloužil také jako druhá testovací kolekce v režimu zero-shot, tedy bez specifického trénování na dané úloze:
V prvních kvantitativních srovnáních HyDRA překonala všechny základní modely, zvýšila PSNR z 18,696 na 20,357 a SSIM z 0,517 na 0,606. Dosáhla také nejvyššího Dice skóre vůči kontextu a vůči skutečným referenčním datům, 0,827 a 0,849. Konzistence motivů a pozadí dosáhla 0,926 a 0,932:

Výsledky prvního kvantitativního porovnání s dřívějšími metodami.
DFoT dosáhl PSNR 17,693 a Context-As-Memory 18,921. Zlepšení se připisuje kombinaci paměťové tokenizace a dynamické pozornosti při vyhledávání:

Kvantitativní srovnání HyDRA se současnými špičkovými metodami.
K testům proti WorldPlay autoři uvádějí:
„Naše metoda překonává WorldPlay ve všech metrikách s výrazným rozdílem PSNR 5,502. Ačkoli má WorldPlay nižší výsledky v metrikách vůči skutečným referenčním datům, například PSNR 14,855 a DSCGT 0,832, kvůli rozdílu v distribuci domén a chybějícímu specifickému jemnému ladění, vykazuje značnou robustnost v metrikách vůči kontextu s DSCctx 0,822.
„Toto pozorování nejen potvrzuje, že důkladně trénované modely mají přiměřenou hybridní konzistenci, ale také nepřímo podporuje smysluplnost našich navržených metrik DSC jako ukazatelů dynamické konzistence motivů.
„Tyto působivé výsledky nakonec zdůrazňují výjimečné schopnosti našeho modelu a ukazují jeho převahu i nad zavedenými komerčními modely.“
Práce nabízí statické zobrazení kvalitativních srovnání provedených v testech:

Kvalitativní srovnání opuštění obrazu a návratu při pohybu kamery. Autoři tvrdí, že HyDRA po odchodu a návratu zachovává identitu, pózu a kontinuitu pohybu motivu a těsně odpovídá skutečné referenci. Konkurenční metody vykazují drift, nesoudržný pohyb nebo degradaci motivu, zvýrazněné červeně; konzistentní obnovení jsou označena zeleně.
K těmto výsledkům autoři poznamenávají:
„U složitých událostí opuštění a návratu vykazují základní model a Context-as-Memory vážné zkreslení motivů a nesoudržný pohyb. DFoT nedokáže zachovat integritu motivu, který proto zcela zmizí. WorldPlay sice zachová konzistenci vzhledu motivu, ale trpí trhanými pohyby a nepřirozenými činnostmi.
„Naše metoda naopak úspěšně zachovává hybridní konzistenci, tedy identitu motivu i soudržnost pohybu po jeho návratu do obrazu.“
Další výsledky ve formě videí jsou dostupné na doplňkovém webu, z něhož jsme první čtyři příklady sestavili do následujícího videa:
Kliknutím přehrajete. Čtyři ze šesti testovacích výsledků uvedených na webu projektu. Zdroj
Závěr
Každý pokus řešit jeden z největších problémů generování AI videa je vítán. Připadá mi však nevyhnutelné, že optimálním řešením těchto situací opuštění a návratu budou stejně jako u CGI samostatné referenční materiály, které lze odděleně upravovat a vkládat do kompozičního prostoru.
Snaha udržet embedding naživu způsobem ad hoc a za běhu působí vyčerpávajícím dojmem. Nenabízí ani jasnou cestu ke konzistenci uvnitř jednoho záběru, kterou již poskytují některé uzavřené služby, například Runway. Jestliže následný záběr potřebuje přístup k latentnímu prostoru předchozího záběru, proč by obě instance nemohly ukládat vlastní samostatný embedding postavy?
* Nikdo jiný tento problém nepojmenoval a bez společných termínů je obtížné o něm diskutovat.
** Na stránce projektu je momentálně uvedeno „již brzy“.
Poprvé zveřejněno v pátek 27. března 2026.


