
Modely a platformy AI
Úplný průvodce jemným laděním velkých jazykových modelů

By
Aayush Mittal Mittal Přidejte Unite.AI mezi své preferované zdroje na Google

Velké jazykové modely (LLM) jako GPT-4, LaMDA, PaLM a další získaly velkou pozornost díky své schopnosti rozumět a generovat text podobný lidskému na široké škále témat. Tyto modely jsou předtrénovány na obrovských datech složených z miliard slov z internetu, knih a dalších zdrojů.
Tato fáze předtrénování vybavuje modely rozsáhlými znalostmi o jazyku, tématech, schopnostech rozumění a dokonce i určitými předpojatostmi přítomnými v trénovacích datech. Nicméně, navzdory jejich úžasné šíři, tyto předtrénované LLM postrádají specializované znalosti pro konkrétní domény nebo úkoly.
Zde přichází jemné ladění – proces přizpůsobení předtrénovaného LLM pro konkrétní aplikaci nebo případ použití. Další trénování modelu na menší, úkolově specifické datové sadě umožňuje upravit jeho schopnosti tak, aby odpovídaly nuancím a požadavkům dané domény.
Jemné ladění je analogické k přenosu široce zaměřených znalostí vysoce vzdělaného generalisty na vytvoření odborníka specializovaného na určitou oblast. V tomto průvodci prozkoumáme co, proč a jak jemného ladění LLM.

Jemné ladění velkých jazykových modelů
Co je jemné ladění?
V jeho jádru, jemné ladění zahrnuje převzetí velkého předtrénovaného modelu a aktualizaci jeho parametrů pomocí druhé fáze trénování na datové sadě přizpůsobené vašemu cílovému úkolu nebo doméně. To umožňuje modelu naučit se a internalizovat nuance, vzorce a cíle specifické pro tužší oblast.
Zatímco předtrénování zachycuje široké jazykové porozumění z obrovské a rozmanité textové sbírky, jemné ladění specializuje tuto obecnou kompetenci. Je to podobné jako převzetí renesančního člověka a vytvoření z něj odborníka v oboru.
Předtrénované modelové váhy, které kódují jeho obecné znalosti, se používají jako výchozí bod nebo inicializace pro proces jemného ladění. Model je poté trénován dále, ale tentokrát na příkladech přímo relevantních pro koncovou aplikaci.
Exponováním modelu této specializované datové distribuci a laděním modelových parametrů podle toho, činíme LLM více přesným a účinným pro cílový případ použití, zatímco stále profitujeme z široce předtrénovaných schopností jako základny.
Proč jemně ladit LLM?
Existuje několik klíčových důvodů, proč byste mohli chtít jemně ladit velký jazykový model:
- Doménová přizpůsobení: Každé pole, od právního po medicínské a softwarové inženýrství, má své vlastní nuancované jazykové konvence, žargony a kontexty. Jemné ladění umožňuje přizpůsobit obecný model tak, aby rozuměl a generoval text přizpůsobený konkrétní doméně.
- Úkolová specializace: LLM lze jemně ladit pro různé úkoly zpracování přirozeného jazyka, jako je shrnutí textu, strojový překlad, zodpovězení otázek a tak dále. Tato specializace zvyšuje výkon na cílovém úkolu.
- Dodržování předpisů: Vysoce regulované odvětví, jako je zdravotnictví a finance, mají přísné požadavky na ochranu dat. Jemné ladění umožňuje trénovat LLM na proprietárních organizacích dat, zatímco chrání citlivé informace.
- Omezená označená data: Získání velkých označených dat pro trénování modelů od začátku může být náročné. Jemné ladění umožňuje dosáhnout silného výkonu na úkolu z omezených dohlížených příkladů tím, že využívá předtrénované modelové schopnosti.
- Aktualizace modelu: Jakmile jsou k dispozici nová data v doméně, můžete jemně ladit modely dále, aby zahrnuly nejnovější znalosti a schopnosti.
- Mitigace předpojatostí: LLM mohou zachytit společenské předpojatosti z široce předtrénovaných dat. Jemné ladění na kurátorovaných datech může pomoci snížit a opravit tyto nežádoucí předpojatosti.
V podstatě, jemné ladění mostí mezeru mezi obecným, široce zaměřeným modelem a zaměřenými požadavky specializované aplikace. Zvyšuje přesnost, bezpečnost a relevanci modelových výstupů pro cílové případy použití.
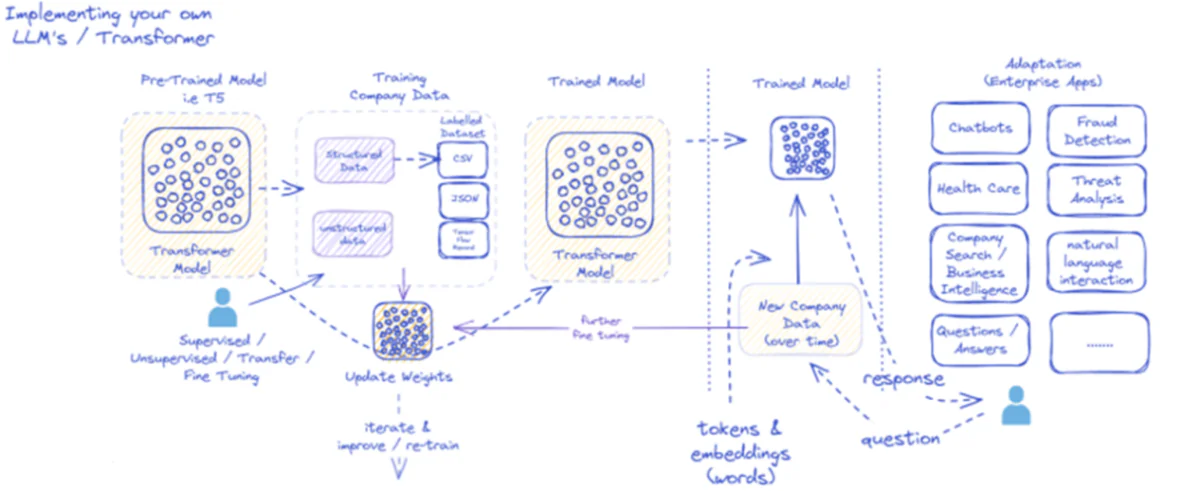
Jemné ladění velkých jazykových modelů
Přiložený diagram znázorňuje proces implementace a využití velkých jazykových modelů (LLM), zejména pro podnikové aplikace. Zpočátku je předtrénovaný model, jako je T5, krmen strukturovanými a nestrukturovanými firemními daty, která mohou pocházet z různých formátů, jako je CSV nebo JSON. Tato data procházejí dohlíženou, nedohlíženou nebo přenositelnou fine-tuning procesy, které vylepšují modelovu relevanci pro konkrétní firemní potřeby.
Jakmile je model jemně laděn s firemními daty, jeho váhy jsou aktualizovány podle toho. Trénovaný model poté iteruje přes další trénovací cykly, neustále zlepšuje své odpovědi s novými firemními daty. Proces je iterativní a dynamický, s modelem, který se učí a retrénuje, aby se přizpůsobil měnícím se datovým vzorcům.
Výstup tohoto trénovaného modelu – tokeny a vložené reprezentace představující slova – je poté nasazen pro různé podnikové aplikace. Tyto aplikace mohou sahát od chatbotů po zdravotnictví, každá vyžadující, aby model rozuměl a reagoval na dotazy specifické pro obor.
Schopnost trénovaného modelu zpracovávat a reagovat na nová firemní data v čase zajišťuje, že jeho užitná hodnota je udržitelná a roste. Jako výsledek, podnikoví uživatelé mohou interagovat s modelem prostřednictvím aplikací, klást otázky a dostávat informované odpovědi, které odrážejí modelovu trénink a jemné ladění na doménově specifická data.
Tato infrastruktura podporuje širokou škálu podnikových aplikací, demonstrující flexibilitu a přizpůsobivost LLM, když jsou správně implementovány a udržovány v podnikovém kontextu.
Jemné ladění přístupů
Existují dvě primární strategie, pokud jde o jemné ladění velkých jazykových modelů:
1) Úplné jemné ladění modelu
V přístupu úplného jemného ladění jsou všechny parametry (váhy a předpojatosti) předtrénovaného modelu aktualizovány během druhé fáze trénování. Model je vystaven úkolově specifické označené datové sadě a standardní trénovací proces optimalizuje celý model pro tuto datovou distribuci.
To umožňuje modelu provést komplexnější úpravy a přizpůsobit se holisticky cílovému úkolu nebo doméně. Nicméně, úplné jemné ladění má některé nevýhody:
- Vyžaduje významné výpočetní zdroje a čas na trénování, podobně jako fáze předtrénování.
- Požadavky na úložiště jsou vysoké, protože je třeba udržovat samostatnou jemně laděnou kopii modelu pro každou úlohu.
- Existuje riziko “katastrofického zapomínání”, kdy jemné ladění způsobí, že model ztratí některé obecné schopnosti získané během předtrénování.
Navzdory těmto limitacím zůstává úplné jemné ladění silnou a široce používanou technikou, když jsou zdroje povoleny a cílový úkol se výrazně liší od obecného jazyka.
2) Efektivní jemné ladění metody
Abyste překonali výpočetní výzvy úplného jemného ladění, výzkumníci vyvinuli efektivní strategie, které aktualizují pouze malou podmnožinu modelových parametrů během jemného ladění. Tyto parametricky efektivní techniky nacházejí rovnováhu mezi specializací a snížením požadavků na zdroje.
Některé populární efektivní jemné ladění metody zahrnují:
Prefix-Tuning: Zde je zavedena malá část úkolově specifických vektorů nebo “prefixů” a trénována, aby podmínily předtrénovaného modelova pozornost pro cílový úkol. Pouze tyto prefixy jsou aktualizovány během jemného ladění.
LoRA (Low-Rank Adaptation): LoRA injektuje trénovatelné nízkorozměrové matice do každé vrstvy předtrénovaného modelu během jemného ladění. Tyto malé rankové úpravy pomáhají specializovat model s mnohem méně trénovatelnými parametry než úplné jemné ladění.
Samozřejmě, mohu poskytnout podrobné vysvětlení LoRA (Low-Rank Adaptation) spolu s matematickým formulováním a příklady kódu. LoRA je populární parametricky efektivní jemné ladění (PEFT) technika, která získala významnou pozornost v oblasti adaptace velkých jazykových modelů (LLM).
Co je LoRA?
LoRA je jemné ladění metoda, která zavádí malou část trénovatelných parametrů do předtrénovaného LLM, umožňující efektivní adaptaci na downstream úkoly, zatímco zachovává většinu původního modelového poznání. Místo jemného ladění všech parametrů LLM, LoRA injektuje úkolově specifické nízkorozměrové matice do modelových vrstev, umožňující významné výpočetní a paměťové úspory během jemného ladění procesu.
Matematické formulování
LoRA (Low-Rank Adaptation) je jemné ladění metoda pro velké jazykové modely (LLM), která zavádí nízkorozměrovou aktualizaci do hmotnostních matic. Pro hmotnostní matici 0∈W0∈Rd×k, LoRA přidává nízkorozměrovou matici BA, s A∈Rr×k a B∈Rd×r, kde r je rank. Tento přístup významně snižuje počet trénovatelných parametrů, umožňující efektivní adaptaci na downstream úkoly s minimálními výpočetními zdroji. Aktualizovaná hmotnostní matice je dána W=W0+B⋅A.
Tato nízkorozměrová aktualizace může být interpretována jako modifikace původní hmotnostní matice $W_{0}$ přidáním nízkorozměrové matice $BA$. Klíčová výhoda tohoto formulování je, že místo aktualizace všech $d \times k$ parametrů v $W_{0}$, LoRA potřebuje pouze optimalizovat $r \times (d + k)$ parametry v $A$ a $B$, což významně snižuje počet trénovatelných parametrů.
Zde je příklad v Pythonu pomocí knihovny peft pro aplikaci LoRA na předtrénovaný LLM pro klasifikaci textu:
</div>
<div>
<div class="code-block__code !my-0 !rounded-t-lg !text-sm !leading-relaxed" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><span class="token" data-darkreader-inline-color="">from</span> transformers <span class="token" data-darkreader-inline-color="">import</span> AutoModelForSequenceClassification
</code></div>
<div class="code-block__code !my-0 !rounded-t-lg !text-sm !leading-relaxed" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><span class="token" data-darkreader-inline-color="">from</span> peft <span class="token" data-darkreader-inline-color="">import</span> get_peft_model<span class="token" data-darkreader-inline-color="">,</span> LoraConfig<span class="token" data-darkreader-inline-color="">,</span> TaskType
</code></div>
<div data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""></div>
<div class="code-block__code !my-0 !rounded-t-lg !text-sm !leading-relaxed" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><span class="token" data-darkreader-inline-color=""># Načtení předtrénovaného modelu</span>
</code></div>
<div class="code-block__code !my-0 !rounded-t-lg !text-sm !leading-relaxed" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color="">model <span class="token" data-darkreader-inline-color="">=</span> AutoModelForSequenceClassification<span class="token" data-darkreader-inline-color="">.</span>from_pretrained<span class="token" data-darkreader-inline-color="">(</span><span class="token" data-darkreader-inline-color="">"bert-base-uncased"</span><span class="token" data-darkreader-inline-color="">,</span> num_labels<span class="token" data-darkreader-inline-color="">=</span><span class="token" data-darkreader-inline-color="">2</span><span class="token" data-darkreader-inline-color="">)</span>
</code></div>
<div data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""></div>
<div class="code-block__code !my-0 !rounded-t-lg !text-sm !leading-relaxed" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><span class="token" data-darkreader-inline-color=""># Definice konfigurace LoRA</span>
</code></div>
<div class="code-block__code !my-0 !rounded-t-lg !text-sm !leading-relaxed" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color="">peft_config <span class="token" data-darkreader-inline-color="">=</span> LoraConfig<span class="token" data-darkreader-inline-color="">(</span>task_type<span class="token" data-darkreader-inline-color="">=</span>TaskType<span class="token" data-darkreader-inline-color="">.</span>SEQ_CLS<span class="token" data-darkreader-inline-color="">, </span>r<span class="token" data-darkreader-inline-color="">=</span><span class="token" data-darkreader-inline-color="">8</span><span class="token" data-darkreader-inline-color="">,</span> <span class="token" data-darkreader-inline-color=""># Rank nízkorozměrové aktualizace</span>
lora_alpha<span class="token" data-darkreader-inline-color="">=</span><span class="token" data-darkreader-inline-color="">16</span><span class="token" data-darkreader-inline-color="">,</span></code><code class="language-python" data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color=""><span class="token" data-darkreader-inline-color=""># Měřítko nízkorozměrové aktualizace</span>
</code></div>
<div data-darkreader-inline-bgimage="" data-darkreader-inline-bgcolor="" data-darkreader-inline-color="">
V tomto příkladu načteme předtrénovaný BERT model pro klasifikaci textu a definujeme konfiguraci LoRA. Parametr r specifikuje rank nízkorozměrové aktualizace a lora_alpha je měřítko pro aktualizaci. Parametr target_modules indikuje, které vrstvy modelu by měly obdržet nízkorozměrové aktualizace. Poté, co je vytvořen LoRA-povolený model, můžeme pokračovat v jemném ladění procesu pomocí standardního trénovacího postupu.
Adapter Layers: Podobně jako LoRA, ale místo nízkorozměrových aktualizací, jsou vloženy tenké “adapter” vrstvy do každé transformátorové bloku předtrénovaného modelu. Pouze parametry těchto několika nových kompaktních vrstev jsou trénovány.
Prompt Tuning: Tento přístup udržuje předtrénovaný model zcela zmrazený. Místo toho jsou zavedeny trénovatelné “prompt” vložené reprezentace jako vstup, aby aktivovaly modelovo předtrénované poznání pro cílový úkol.
Tyto efektivní metody mohou poskytnout až 100x výpočetní redukce ve srovnání s úplným jemným laděním, zatímco stále dosahují konkurenceschopného výkonu na mnoha úkolech. Také snižují požadavky na úložiště, vyhýbají se úplné duplikaci modelu.
Jejich výkon může však zaostávat za úplným jemným laděním pro úkoly, které jsou výrazně odlišné od obecného jazyka nebo vyžadují více holistické specializace.
Jemné ladění proces
Nezависle na jemné ladění strategie, celkový proces pro specializaci LLM následuje obecný rámec:
- Příprava datové sady: Budete potřebovat získat nebo vytvořit označenou datovou sadu, která mapuje vstupy (prompt) na požadované výstupy pro váš cílový úkol. Pro úkoly generování textu, jako je shrnutí, by to bylo vstupní text na shrnutý výstupní pár.
- Rozdělení datové sady: Podle nejlepších postupů rozdělte svou označenou datovou sadu na trénovací, validační a testovací sady. To odděluje data pro modelové trénování, ladění hyperparametrů a konečnou evaluaci.
- Ladění hyperparametrů: Parametry, jako je rychlost učení, velikost dávky a trénovací harmonogram, potřebují být naladěny pro nejúčinnější jemné ladění na vašich datech. To obvykle zahrnuje malou validační sadu.
- Trénování modelu: Používající naladěné hyperparametry, spusťte jemné ladění optimalizační proces na plné trénovací sadě, dokud modelův výkon na validační sadě nezastaví zlepšování (časná zastavení).
- Evaluace: Ohodnoťte jemně laděného modelového výkon na držené testovací sadě, ideálně složené z reálných světových příkladů pro cílový případ použití, aby odhadl reálný světový účinek.
- Nasazení a monitorování: Jakmile je uspokojivý, jemně laděný model může být nasazen pro inferenci na nových vstupech. Je důležité monitorovat jeho výkon a přesnost v čase pro koncept drift.
Zatímco tento obecný rámec, mnoho nuancí může ovlivnit úspěch jemného ladění pro konkrétní LLM nebo úkol. Strategie, jako je curriculum učení, multi-úkolové jemné ladění a few-shot prompting, mohou dále zvýšit výkon.
Kromě toho, efektivní jemné ladění metody zahrnují další úvahy. Například LoRA vyžaduje techniky, jako je kondicionování předtrénovaných modelových výstupů prostřednictvím kombinující vrstvy. Prompt tuning potřebuje pečlivě navržené prompty, aby aktivovaly správné chování.
Pokročilé jemné ladění: Začlenění lidské zpětné vazby
Zatímco standardní dohlížené jemné ladění pomocí označených dat je efektivní, zajímavou hranicí je trénování LLM přímo pomocí lidských preferencí a zpětné vazby. Tento lidský-v-smyčce přístup využívá techniky z učení s posilováním:
PPO (Proximální politika optimalizace): Zde je LLM považován za agenta učení s posilováním, s jeho výstupy jako “akcemi”. Odměnový model je trénován, aby předpovídal lidské hodnocení nebo kvalitativní skóre pro tyto výstupy. PPO poté optimalizuje LLM, aby generoval výstupy, které maximalizují odměnového modelového skóre.
RLHF (Učení s posilováním z lidské zpětné vazby): Tento přístup rozšiřuje PPO tím, že přímo začleňuje lidskou zpětnou vazbu do učení procesu. Místo pevného odměnového modelu, odměny pocházejí z iterativních lidských evaluací na LLM výstupech během jemného ladění.
Zatímco výpočetně náročné, tyto metody umožňují formovat LLM chování přesněji na základě požadovaných charakteristik hodnocených lidmi, za hranice toho, co lze zachytit v statické datové sadě.
Společnosti, jako je Anthropic, použily RLHF k vdechnutí svým jazykovým modelům, jako je Claude, vylepšené pravdivosti, etiky a bezpečnostní povědomí za hranice pouhé úkolvé kompetence.
Potenciální rizika a omezení
Zatímco enormně mocný, jemné ladění LLM není bez rizik, která musí být pečlivě spravována:
Zesílení předpojatostí: Pokud jemné ladění dat obsahuje společenské předpojatosti kolem pohlaví, rasy, věku nebo jiných atributů, model může zesílit tyto nežádoucí předpojatosti. Kurátorování reprezentativních a de-biased dat je zásadní.
Faktický drift: I po jemném ladění na vysoce kvalitních datech, jazykové modely mohou “hallucinovat” nesprávné fakty nebo výstupy nekonzistentní s trénovacími příklady přes delší konverzace nebo prompty. Metody faktické retroniky mohou být potřebné.
Škálovací výzvy: Úplné jemné ladění obrovských modelů, jako je GPT-3, vyžaduje enormní výpočetní zdroje, které mohou být nedosažitelné pro mnoho organizací. Efektivní jemné ladění částečně zmírňuje tuto výzvu, ale má kompromisy.
Katastrofické zapomínání: Během úplného jemného ladění, modely mohou prožít katastrofické zapomínání, kde ztratí některé obecné schopnosti získané během předtrénování. Víceúkolové učení může být nutné.
Rizika IP a ochrany soukromí: Proprietární data použité pro jemné ladění mohou uniknout do veřejně vydaných jazykových modelových výstupů, představujících rizika. Diferenciální soukromí a informační hazardní zmírnění techniky jsou aktivními oblastmi výzkumu.
Celkově, zatímco výjimečně užitečné, jemné ladění je nuancovaným procesem, který vyžaduje péči kolem datové kvality, identifikační úvahy, zmírňování rizik a vyvažování výkonu-efektivních obchodních rozhodnutí na základě požadavků případu použití.
Budoucnost: Customizace jazykových modelů ve velkém měřítku
Pohledem do budoucna, pokroky v jemném ladění a modelové adaptaci technikách budou zásadní pro odemknutí plného potenciálu velkých jazykových modelů napříč různými aplikacemi a doménami.
Více efektivní metody umožňující jemné ladění ještě větších modelů, jako je PaLM, s omezenými zdroji, by mohly demokratizovat přístup. Automatizace datových vytváření pipeline a prompt inženýrství by mohly zjednodušit specializaci.
Samoučící se techniky pro jemné ladění z nepojmenovaných dat bez labelů by mohly otevřít nové hranice. A kompoziční přístupy ke kombinování jemně laděných sub-modelů trénovaných na různých úkolech nebo datech by mohly umožnit konstrukci vysoce přizpůsobených modelů na vyžádání.
Nakonec, jak se LLM stávají více všudypřítomnými, schopnost přizpůsobit a specializovat je snadno pro každý myslitelný případ použití bude kritická. Jemné ladění a související modelové adaptace strategie jsou zásadními kroky v realizaci vize velkých jazykových modelů jako flexibilních, bezpečných a mocných AI asistentů, které zvyšují lidské schopnosti napříč každým doménou a úsilím.
Já pět let se ponořím do fascinujícího světa strojového učení a hlubokého učení. Mé vášně a odborné znalosti mě vedly k tomu, abych se podílel na více než 50 různých projektech softwarového inženýrství, se zvláštním zaměřením na AI/ML. Mé pokračující zvědavosti mě také přivedly k přirozenému jazykovému zpracování, oblasti, kterou jsem ochoten prozkoumat dále.

Objevte více


Laboratoře právě prokázaly, že pískoviště vašeho agenta je pouze návrh


New York právě udělal skutečnou látku AI – pozemní boj


Proč agenti AI procházejí QA a přesto selhávají ve výrobě


Nejlepší model OpenAI právě vyšel za bránou vlády


AI Delikvence kvůli Přepřetrénování, ne Jemnému Ladění, Zjistila Výzkum

Thinking Machines Lab Spustí První Model S Reálným Časem Interakce 200ms


