
Modely a platformy AI
LoRA, QLoRA a QA-LoRA: Efektivní adaptace velkých jazykových modelů pomocí faktorizace matic s nízkou hodností

 Přidejte Unite.AI mezi své preferované zdroje na Google

Klíčové bodyLoRA snižuje počet trénovatelných parametrů tím, že zmrazí základní váhy a přidá malé…
Zobrazit více
- LoRA snižuje počet trénovatelných parametrů tím, že zmrazí základní váhy a přidá malé adaptabilní matice.
- QLoRA kombinuje 4bitovou kvantizaci s LoRA, čímž drasticky snižuje nároky na paměť GPU.
- Tyto metody umožňují jemné doladění modelů s miliardami parametrů na standardním hardwaru.
Velké jazykové modely (LLM) si vytvořily jedinečné místo, nabízející nevídané schopnosti v porozumění a generování lidského textu. Síla LLM lze vysledovat zpět k jejich enormní velikosti, často s miliardami parametrů. Zatímco tato obrovská velikost pohání jejich výkon, zároveň vytváří výzvy, zejména při přizpůsobení modelu pro konkrétní úkoly nebo domény. Konvenční cesty pro řízení LLM, jako je jemné ladění všech parametrů, představují vysoké výpočetní a finanční náklady, a tím vytvářejí významnou bariéru pro jejich široké přijetí v reálných aplikacích.
V předchozím článku jsme se zabývali jemným laděním velkých jazykových modelů (LLM) pro přizpůsobení specifickým požadavkům. Prozkoumali jsme různé metody jemného ladění, jako je ladění založené na instrukcích, jednoúčelové ladění a efektivní ladění parametrů (PEFT), každá se svou jedinečnou strategií pro optimalizaci LLM pro rozdílné úkoly. Centrálním tématem diskuze byla architektura transformátoru, základem LLM, a výzvy, které představuje výpočetní a paměťová náročnost při zpracování obrovského množství parametrů během jemného ladění.

https://huggingface.co/blog/hf-bitsandbytes-integration
Obrázek výše znázorňuje rozsah různých velkých jazykových modelů, seřazených podle počtu parametrů. Pozoruhodné jsou PaLM, BLOOM atd.
V tomto roce došlo k pokrokům, které vedly k vývoji ještě větších modelů. Nicméně, ladění takových obřích, open-source modelů na standardních systémech je nemožné bez specializovaných optimalizačních technik.
Vstoupila adaptace s nízkou hodností (LoRA), která byla představena společností Microsoft (MSFT ) v tomto článku, s cílem zmírnit tyto výzvy a učinit LLM více přístupnými a přizpůsobitelnými.
Jádrem LoRA je její přístup k přizpůsobení modelu bez nutnosti re-trénovat celý model. Na rozdíl od tradičního jemného ladění, kde se mění každý parametr, LoRA volí inteligentnější cestu. Zamrzne předtrénované váhy modelu a zavádí trénovatelné matice nízké hodnosti do každé vrstvy architektury transformátoru. Tento přístup dramaticky snižuje počet trénovatelných parametrů, zajišťuje efektivnější proces přizpůsobení.
Vývoj strategií ladění LLM
Ohlédnutím se za cestou LLM ladění, lze identifikovat několik strategií, které byly použity praktiky v průběhu let. Zpočátku se zaměřilo na jemné ladění předtrénovaných modelů, strategie, která zahrnuje komplexní změnu modelových parametrů pro konkrétní úkol. Nicméně, jak modely rostly ve velikosti a složitosti, tak i výpočetní nároky tohoto přístupu.
Další strategií, která získala popularitu, bylo podmnožinové jemné ladění, více omezující verze svého předchůdce. Zde se pouze podmnožina modelových parametrů jemně ladí, snižuje se tak výpočetní zátěž do jisté míry. Navzdory svým výhodám, podmnožinové jemné ladění stále nebylo schopno držet krok s tempem růstu velikosti LLM.
Jak praktici zkoumali efektivnější cesty, plné jemné ladění se objevilo jako důkladný, ale odměňující přístup.
Úvod do LoRA
Hodnost matice je počet jejích lineárně nezávislých řádků nebo sloupců. Poznámka k anglickému zdroji: nestačí, aby byly řádky či sloupce pouze různé; rozhodující je lineární nezávislost.
- Matice plné hodnosti: Její hodnost odpovídá menšímu z počtů řádků a sloupců.
- Matice nízké hodnosti: Její hodnost je výrazně menší než počet řádků i sloupců, takže zachycuje menší počet nezávislých směrů.
Velké modely chápou široké pochopení své domény, jako je jazyk v jazykových modelech. Ale jemné ladění pro konkrétní úkoly často vyžaduje pouze zvýraznění malé části tohoto pochopení. Zde LoRA vyniká. Navrhuje, že matice zobrazující tyto váhové úpravy může být mající nízkou hodnost, a tak zachycuje méně funkcí.
LoRA inteligentně omezuje hodnost aktualizační matice vyjádřením jako součinu dvou menších matic. Takže místo změny celé váhové matice se mění pouze část z ní, což činí proces jemného ladění efektivnějším.
Použití LoRA u transformátorů
LoRA pomáhá minimalizovat trénovací zátěž v neuronových sítích, zaměřujíc se na konkrétní váhové matice. V architektuře transformátoru jsou některé váhové matice spojeny se samo-pozorností, jmenovitě Wq, Wk, Wv a Wo, kromě dvou dalších v modulu Multi-Layer Perceptron (MLP).

Architektura transformátorů

Hlavy pozornosti transformátoru
Matematické vysvětlení LoRA
Rozložme matematiku za LoRA:
- Předtrénovaná váhová matice :
- Začíná s předtrénovanou váhovou maticí rozměrů . To znamená, že matice má řádků a sloupců.
- Nízkorozměrová dekompozice:
- Místo přímé úpravy celé matice , která může být výpočetně nákladná, metoda navrhuje přístup rozkladu s nízkou hodností.
- Aktualizace k může být reprezentována jako produkt dvou matic: a .
- má rozměry
- má rozměry
- Klíčovým bodem je, že hodnost je mnohem menší než obě a , což umožňuje výpočetně efektivnější reprezentaci.
- Trénování:
- Během trénovacího procesu zůstává nezměněna. To se nazývá “zamrznutí” vah.
- Naproti tomu a jsou trénovatelné parametry. To znamená, že během trénování se provádějí úpravy matic a pro zlepšení modelové výkonnosti.
- Násobení a přidání:
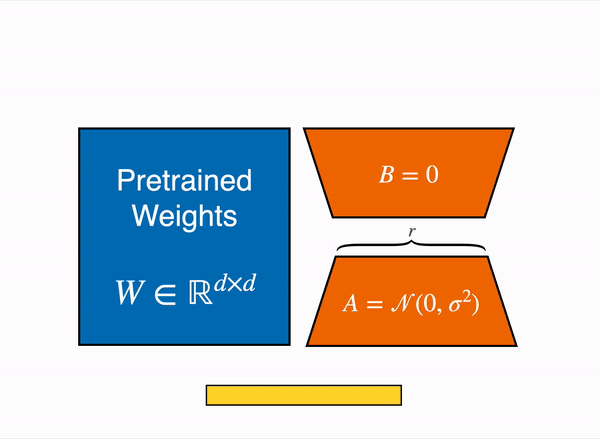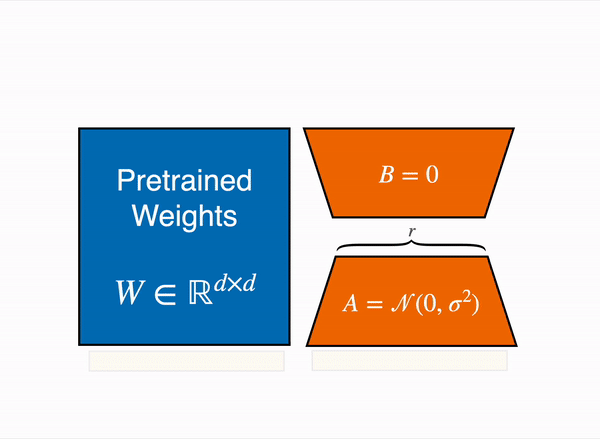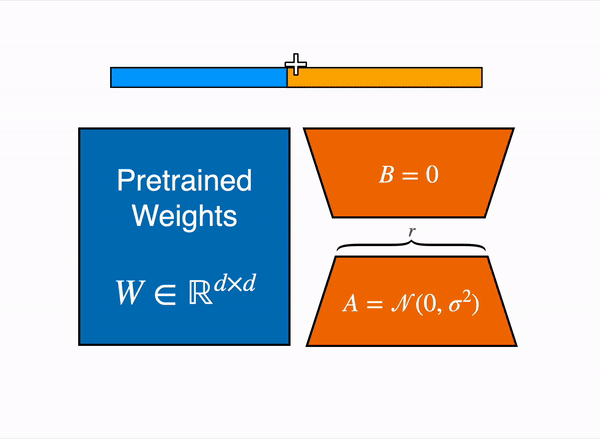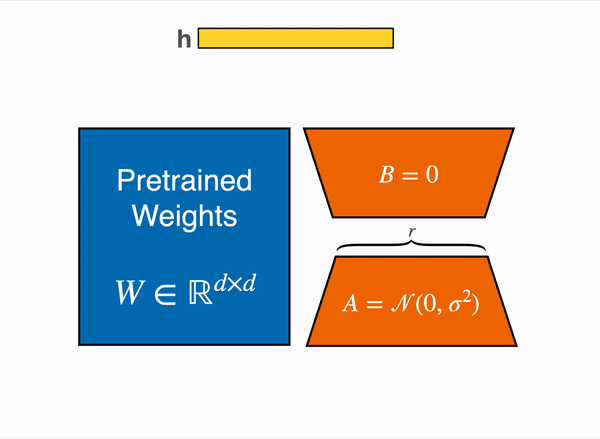
- Oba a aktualizace (která je produktem a ) jsou násobeny stejným vstupem (označeným jako ).
- Výstupy těchto násobení jsou poté přidány dohromady.
- Tento proces je shrnut v rovnici: Zde reprezentuje konečný výstup po aplikaci aktualizací na vstup .
Stručně řečeno, tato metoda umožňuje efektivnější způsob aktualizace velké váhové matice reprezentací aktualizací pomocí dekompozice s nízkou hodností, což může být prospěšné z hlediska výpočetní efektivnosti a paměťového využití.
LoRA
Inicializace a škálování:
Při trénování modelů může způsob inicializace parametrů výrazně ovlivnit efektivitu a účinnost učícího procesu. V kontextu naší aktualizace váhové matice pomocí a :
- Inicializace matic a :
- Matice : Tato matice je inicializována náhodnými gaussovskými hodnotami, také známými jako normální distribuce. Důvodem použití gaussovské inicializace je prolomení symetrie: různé neurony ve stejné vrstvě se naučí různé funkce, když mají různé počáteční váhy.
- Matice : Tato matice je inicializována nulami. Tímto způsobem aktualizace začíná jako nula na začátku trénování. To zajišťuje, že není žádný náhlý změna v chování modelu na začátku, což umožňuje modelu postupně se přizpůsobit, jak se učí vhodné hodnoty během trénování.
- Škálování výstupu z :
- Po výpočtu aktualizace , její výstup je škálován faktorem kde je konstanta. Škálováním se řídí velikost aktualizací.
- Škálování je zvláště důležité, když se mění hodnost . Například, pokud se rozhodnete zvýšit hodnost pro vyšší přesnost (za cenu výpočtu), škálování zajišťuje, že nemusíte měnit mnoho dalších hyperparametrů v procesu. To poskytuje jistou stabilitu modelu.
Praktický dopad LoRA
Komunita AI používá LoRA také k přizpůsobování obrazových modelů uměleckým stylům. Upřesnění anglického zdroje: níže uvedený příklad je adaptér pro obrazový model SDXL, nikoli pro jazykový model. To bylo zřetelně demonstrováno v adaptaci modelu pro napodobení uměleckého stylu Grega Rutkowského.
Jako zdůrazněno v článku s GPT-3 175B jako příkladem. Mít jednotlivé instance jemně laděných modelů s 175B parametry každý je poměrně nákladné. Ale s LoRA, trénovatelné parametry klesají o 10 000krát a využití paměti GPU je sníženo na třetinu.

Dopad LoRA na jemné ladění GPT-3
Metodologie LoRA nejen představuje významný krok směrem k tomu, aby LLM byly více přístupné, ale také zdůrazňuje potenciál mostu mezi teoretickými pokroky a praktickými aplikacemi v oblasti AI. Snížení výpočetních překážek a usnadnění procesu modelové adaptace LoRA je připravena hrát zásadní roli v širším přijetí a nasazení LLM v reálných scénářích.
QLoRA (Kvantizovaná)
Zatímco LoRA je revoluční v redukci potřebného úložiště, stále vyžaduje robustní GPU pro načtení modelu pro trénování. Zde vstupuje QLoRA, nebo kvantizovaná LoRA, která kombinuje LoRA s kvantizací pro inteligentnější přístup.

Kvantizace
Obvykle jsou váhové parametry uloženy ve formátu 32-bit (FP32), což znamená, že každý prvek v matici zabírá 32 bitů prostoru. Představte si, že bychom mohli stlačit stejné informace do pouhých 8 nebo dokonce 4 bitů. To je základní myšlenka za QLoRA. Kvantizace odkazuje na proces mapování spojitých nekonečných hodnot na menší sadu diskrétních konečných hodnot. V kontextu LLM se jedná o proces převodu vah modelu z vyšších přesností datových typů na nižší přesnosti.

Kvantizace v LLM
Zde je jednodušší rozbor QLoRA:
- Počáteční kvantizace: Nejprve je velký jazykový model (LLM) kvantizován na 4 bity, což výrazně snižuje paměťový otisk.
- Trénování LoRA: Poté se trénují adaptéry LoRA ve vyšší výpočetní přesnosti. Anglický článek zde uvádí FP32; původní práce QLoRA však standardně používá BF16 při výpočtech i pro parametry adaptérů.
Upřesnění zdroje: anglický článek popisuje návrat vah do FP32. Původní QLoRA rozlišuje uložení zmrazených vah ve 4 bitech a výpočet obvykle v BF16. Potřebné tenzory se pro výpočet dekvantizují; gradienty vah se počítají pouze pro adaptéry LoRA. Nejde o opětovné trénování všech základních vah.
LoRA nachází praktické uplatnění v knihovně Hugging Face Parameter Efficient Fine-Tuning (PEFT), zjednodušujícím její použití. Pro ty, kteří chtějí použít QLoRA, je dostupná prostřednictvím kombinace knihoven bitsandbytes a PEFT. Kromě toho knihovna HuggingFace Transformer Reinforcement Learning (TRL) usnadňuje dohledované jemné ladění s integrovanou podporou LoRA. Společně tyto tři knihovny poskytují základní nástroj pro jemné ladění vybraného předtrénovaného modelu, umožňující generovat přesvědčivé a koherentní produktové popisy při zadání specifických atributových instrukcí.
Anglický zdroj zde upozorňuje na komplikace převodu a slučování adaptérů po QLoRA; neznamená to však, že každý způsob nasazení QLoRA vyžaduje trvale ukládat všechny váhy ve vysoké přesnosti. Následující QA-LoRA řeší společnou kvantizaci a adaptaci pomocí operací po skupinách a umožňuje výsledné váhy spojit do kvantizovaného modelu.
Navržené řešení spočívá ve skupinování váhové matice do menších segmentů a aplikaci kvantizace a adaptace s nízkou hodností na každý segment individuálně. Nová metoda, nazvaná QA-LoRA, se snaží spojit výhody kvantizace a adaptace s nízkou hodností, zatímco zachovává proces efektivním a model účinným pro požadované úkoly.
Závěr
V tomto článku jsme se dotkli výzev, které představuje enormní velikost parametrů. Prozkoumali jsme tradiční postupy jemného ladění a jejich spojené výpočetní a finanční nároky. Jádrem LoRA je její schopnost modifikovat předtrénované modely bez nutnosti je kompletně re-trénovat, snižuje tak počet trénovatelných parametrů a činí proces adaptace nákladově efektivnějším.
Dále jsme se krátce dotkli Kvantizované LoRA (QLoRA), která kombinuje LoRA s kvantizací, snižuje tak paměťový otisk modelu, zatímco zachovává základní přesnost pro trénování. Díky těmto pokročilým technikám jsou praktici nyní vybaveni robustními knihovnami, usnadňujícími širší přijetí a nasazení LLM v širokém spektru reálných scénářů.

Matrix
Tyto strategie jsou navrženy tak, aby vyvažovaly mezi tím, aby LLM byly přizpůsobitelné pro specifické úkoly, a zajišťovaly, že procesy jemného ladění a nasazení nejsou příliš náročné z hlediska výpočtu a úložných zdrojů.


