Základy AI
Generativní vs. diskriminační modely strojového učení

 Přidejte Unite.AI mezi své preferované zdroje na Google
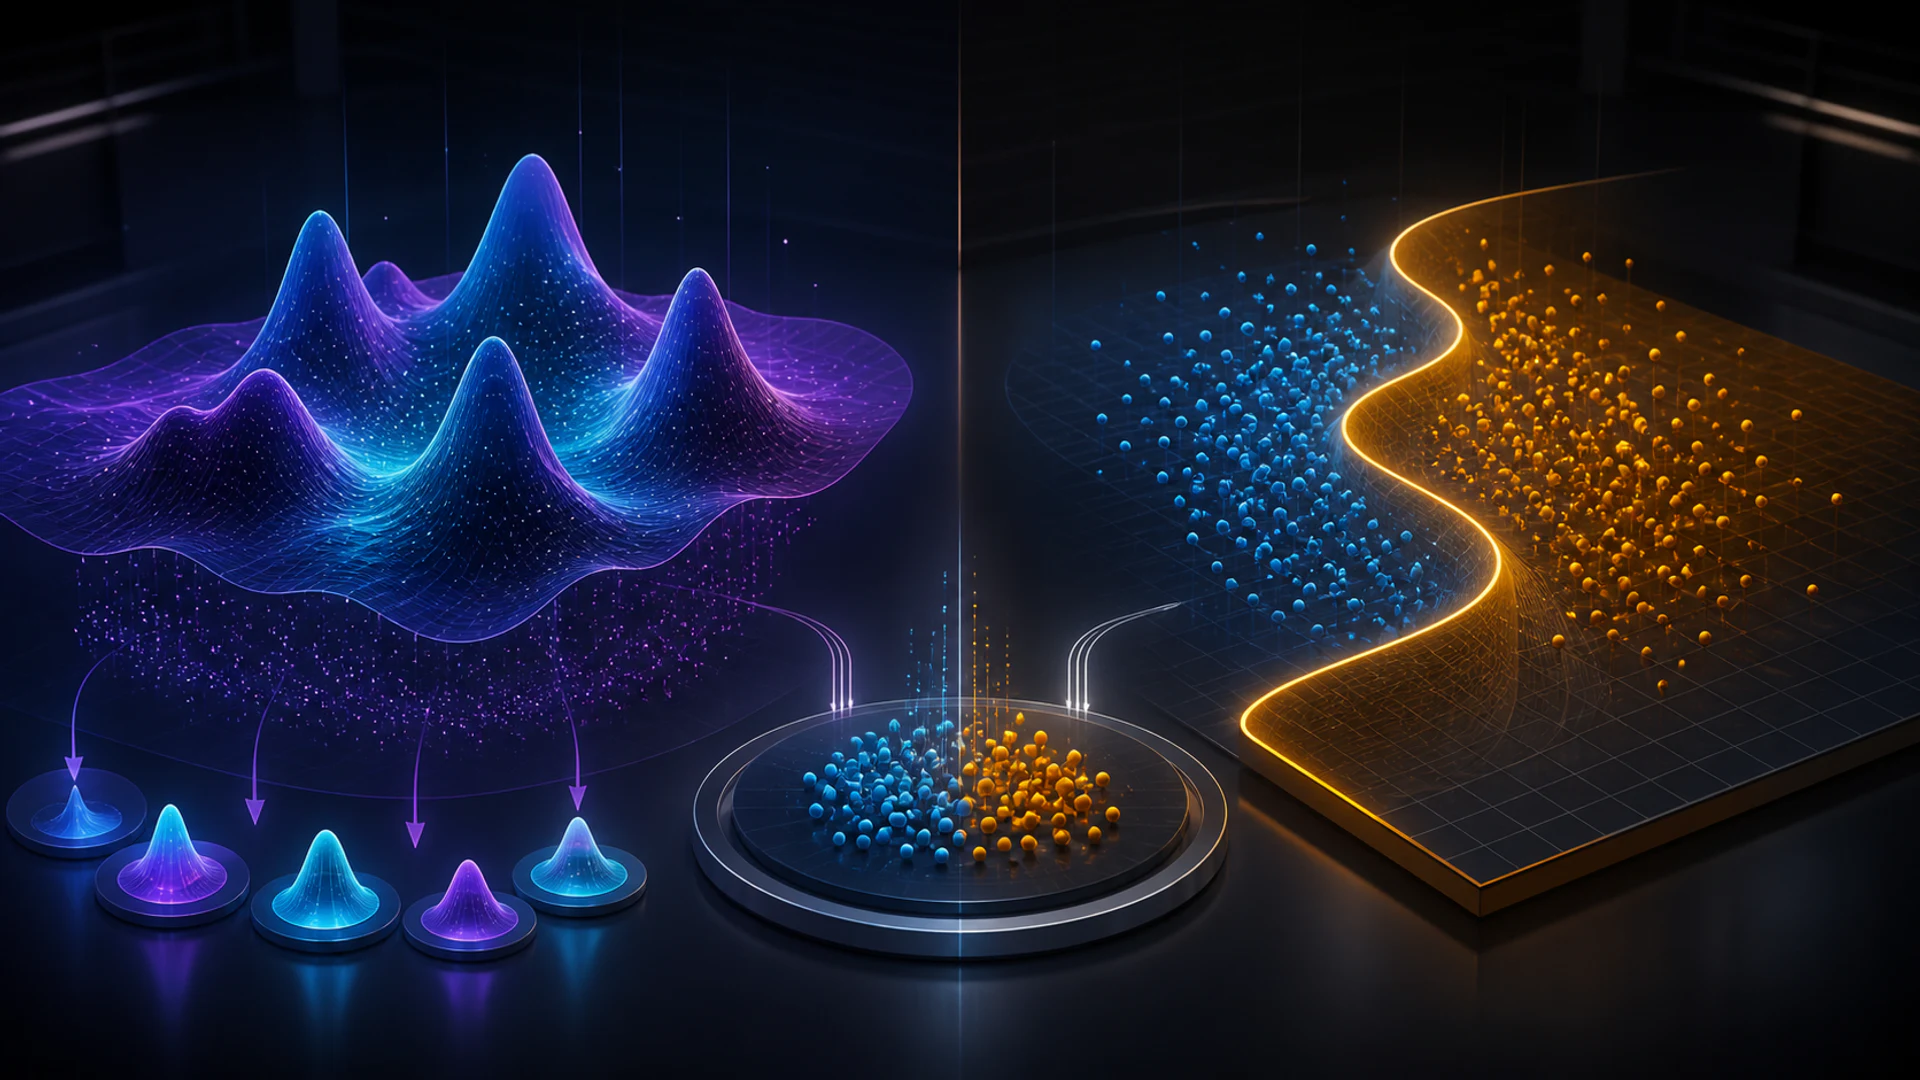
Generativní a diskriminační popisují, co se model učí o datech a cílech. V klasické supervizované klasifikaci se generativní model učí společnou distribuci, například P(x, y) nebo podmíněnou distribuci třídy P(x|y), zatímco diskriminační model se učí P(y|x) nebo přímou rozhodovací hranici.
Rozlišení je užitečné, ale moderní systémy často kombinují cíle. Model může získat generativní reprezentace a později být doladěn pro diskriminační predikci, nebo sdílet jeden základ mezi generací a klasifikací.
Klíčové poznatky
- Generativní klasifikátory modelují, jak vznikají vstupy a štítky; diskriminační klasifikátory modelují štítek vzhledem ke vstupu nebo hranici.
- Generativní předpoklady mohou pomoci při omezeném množství označených dat, ale mohou být také nesprávné.
- Diskriminační metody často soustředí kapacitu na úlohu predikce a mohou dosáhnout nižší asymptotické chybovosti klasifikace.
- GAN, VAE a jazykové modely jsou generativní systémy, ale „generativní“ neznamená, že každá součást je generativní klasifikátor.
Faktorizace pravděpodobnosti
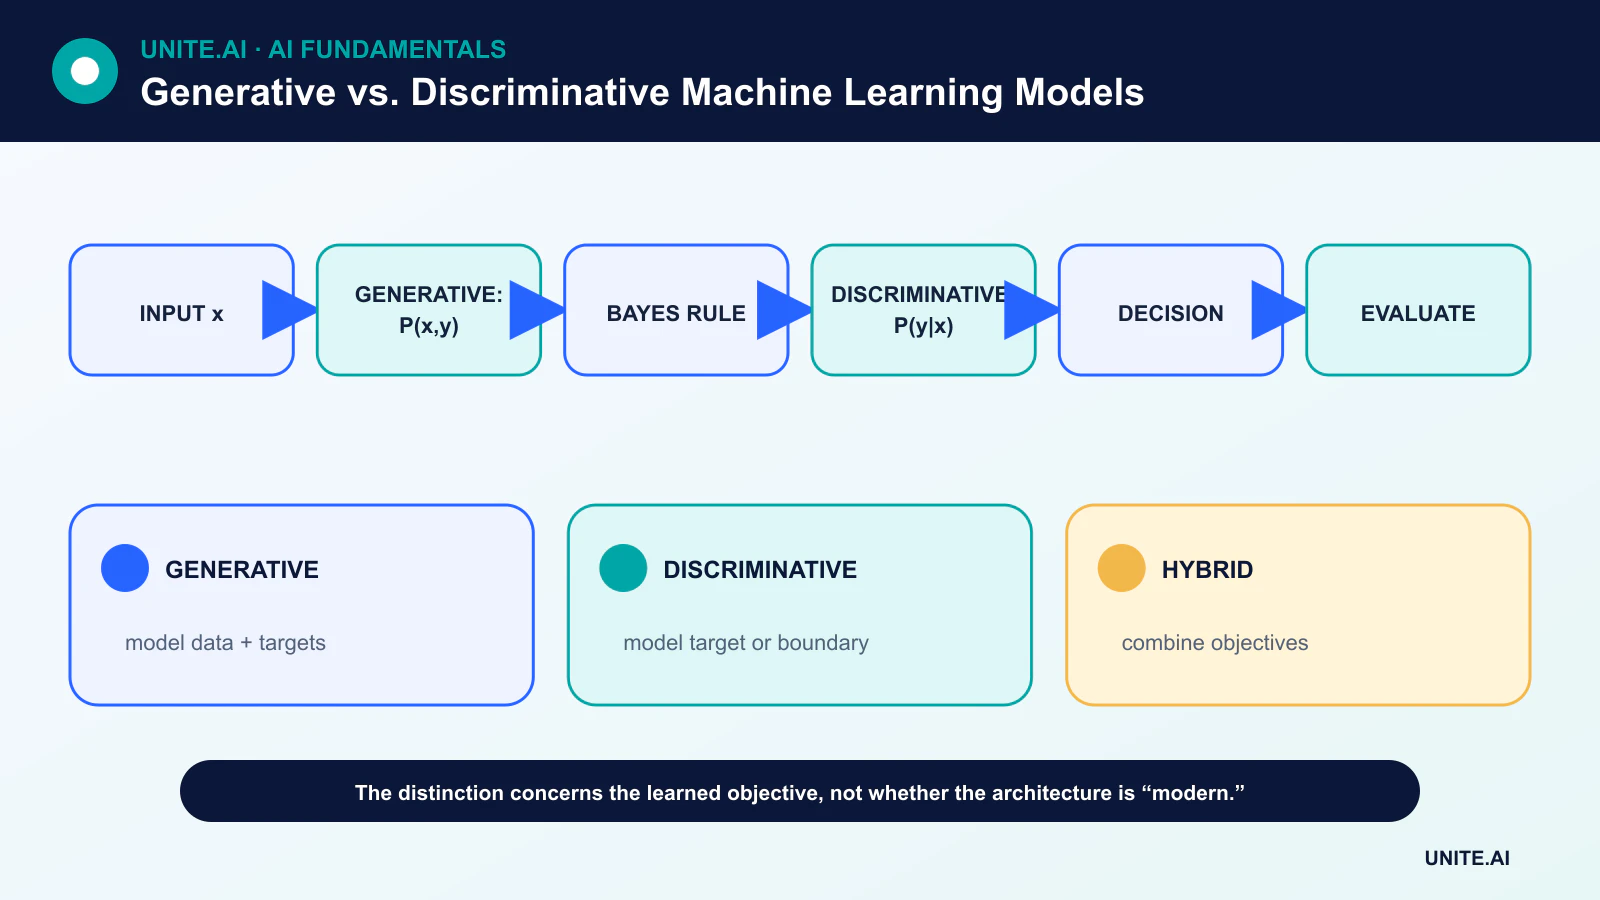
Generativní klasifikátor může odhadnout P(x|y) a P(y) a poté pomocí Bayesova věta odvodit P(y|x). Naivní Bayes je klasickým příkladem. Diskriminační klasifikátor, jako je logistická regrese, odhaduje P(y|x) přímo; SVM se učí oddělující hranici.
Modelování P(x,y) je širší úloha než predikce y ze x. Tato dodatečná struktura může podpořit generování vzorků nebo uvažování o chybějících datech, ale také vyžaduje předpoklady o distribuci vstupů.
Účinnost dat a asymptotické chování
Porovnání Ng a Jordana mezi naivním Bayesem a logistickou regresí ukázalo užitečnou výměnu: za jejich předpokladů může generativní model dosáhnout svého limitního výkonu s méně příklady, zatímco diskriminační model může dosáhnout nižší asymptotické chyby.
Nejedná se o univerzální pořadí. Výsledky závisí na tom, zda modelová rodina odpovídá datům, na dimenzi, regularizaci, optimalizaci a kvalitě štítků. Empirické srovnání na reprezentativním validačním designu zůstává nezbytné.
Reprezentativní rodiny modelů
Generativní modely zahrnují podmíněné distribuce tříd, skryté Markovovy modely, smíšené modely, variacionální autoenkodéry, autoregresivní jazykové modely, difúzní modely a GAN.
Diskriminační modely zahrnují logistickou regresi, rozhodovací stromy, podmíněná náhodná pole, podpůrné vektorové stroje a neuronové klasifikátory. Stejná neuronová kostra může patřit do kterékoliv kategorie v závislosti na cíli tréninku a výstupu.
Hybridní a samoučící se systémy
Předtrénovaný jazykový nebo vizuální model se může učit z neoznačených dat s generativním nebo samoučícím se cílem, poté získat diskriminační hlavu pro cílový úkol. Polosupervizované metody mohou optimalizovat označenou klasifikaci a cíl neoznačených dat současně.
Hybridizace činí popisky architektury méně informativními než celý tréninkový řetězec. Dokumentace by měla uvádět cíl, data, výstupy a zamýšlenou inferenci – ne jen označovat model jako generativní.
Volba mezi přístupy
Rozhodněte podle úlohy. Pokud je cílem kalibrovaná hranice s bohatým množstvím štítků, diskriminační model je přirozeným výchozím bodem. Pokud jsou středobodem generování vzorků, odhad hustoty, struktura chybějících dat nebo neoznačená data, může pomoci generativní komponenta.
Porovnejte robustnost, efektivitu vzorkování, výpočetní náročnost, pravděpodobnost nebo kalibraci podle potřeby. Dobře vygenerovaný vzorek neprokazuje dobrý klasifikátor a klasifikátor s vysokou přesností neimplikuje realistický model vstupní distribuce.
Směry pravděpodobnosti a cíle modelování
Diskriminační model se učí hranici nebo podmíněnou distribuci P(y|x): na základě vlastností x předpoví štítek y. Logistická regrese, podpůrné vektorové stroje, podmíněná náhodná pole a mnoho dalších klasifikátorů jsou diskriminační. Generativní model se učí společnou distribuci P(x,y), podmíněnou distribuci třídy P(x|y) nebo bezpodmínečnou datovou distribuci, což umožňuje generování vzorků nebo úlohy související s pravděpodobností. Naivní Bayes a lineární diskriminační analýza jsou generativní klasifikátory; GAN, variacionální autoenkodéry, difúzní modely a autoregresivní modely generují data pomocí různých cílů.
Rozlišení se týká toho, jaká distribuce nebo rozhodovací pravidlo je modelováno, nikoli toho, zda je použita neuronová síť. Generativní jazykový model může být vyzván k klasifikaci, zatímco diskriminační přehodnocovač může řídit generování. Generativní předpoklady mohou zlepšit efektivitu dat nebo řešit chybějící proměnné, ale přinášejí riziko nesprávné specifikace modelu. Diskriminační metody často vynikají při bohatých označených datech, protože se soustředí přímo na hranici predikce. Porovnávejte rodiny za stejných podmínek – vlastnosti, data, ladění i výpočetní zdroje – místo toho, abyste jednu kategorii považovali za univerzálně nadřazenou.
Trénink a hodnocení podle případu použití
Hodnocení klasifikace používá přesnost, odvolání, kalibraci, robustnost a náklady na chybu. Hodnocení generativních modelů musí řešit věrnost, rozmanitost, pokrytí, pravděpodobnost nebo užitečnost úlohy, memorování a bezpečnost. Model může vytvářet atraktivní vzorky a přitom ztrácet módy, nebo dosáhnout dobré pravděpodobnosti při špatném percepčním výstupu. Užitek syntetických dat by měl být testován trénováním a hodnocením následných modelů na nezávislých reálných datech, včetně vzácných skupin. Testová data neumisťujte do výzev pro generování ani do výběru.
V polosupervizovaném učení může generativní model využít strukturu neoznačených dat; při detekci anomálií může pravděpodobnost selhat, když data mimo distribuci získají vysokou hustotu z irelevantních důvodů. V generování doplněném o vyhledávání tvoří hybrid generativní model odpovědí a diskriminační vyhledávač nebo přehodnocovač. Diagnostikujte fáze odděleně, aby plynulý výstup nezakryl selhání vyhledávání. Zvolte dekompozici, která umožní sledovat důkazy a kontrolu.
Nasazení a správa
Generativní systémy přinášejí rizika provenance obsahu, duševního vlastnictví, napodobování, vkládání výzev a moderace výstupu; diskriminační systémy přidávají rizika prahových hodnot, odmítnutí a nerovnoměrných chyb. Oba vyžadují práva k datům, zabezpečené artefakty, verzování, reprezentativní testy, monitorování a lidskou autoritu úměrnou důsledkům. V dokumentaci sledujte přesný cíl a sémantiku výstupu. Rozlišení generativní versus diskriminační je užitečné statistické rozlišení, ale reálné systémy je často kombinují a spolehlivost závisí na celém datovém a rozhodovacím řetězci.
Praktický příklad: klasifikace a generování odpovědí podpory
Platforma podpory používá diskriminační klasifikátor k identifikaci typu problému a naléhavosti a generativní model k vytvoření návrhu odpovědi podle schválených politik. Klasifikátor je hodnocen pomocí specifické odvolání pro třídu a kalibrace; vyhledávač pomocí odvolání důkazů; generátor pomocí zakotvení, správnosti a odmítnutí. Každá fáze má neznámý výsledek a generativní model nemůže měnit klasifikaci ani nárok zákazníka pomocí přesvědčivého textu.
Agenti vidí předpovězenou cestu, zdroje a návrh a před odesláním jej schválí nebo opraví. Filtry oprávnění se aplikují před vyhledáváním a vkládání výzev v textu zákazníka nemohou autorizovat nástroje. Monitorování odděluje chyby směrování, mezery ve vyhledávání, nepodporované výroky a úpravy agentů. Změna politiky okamžitě aktualizuje zdroje a spouští regresní testy; ladění je vyhrazeno pro stabilní chování. Hybridní design využívá diskriminační a generativní silné stránky při zachování důkazů a lidské autority.
Důkazy o implementaci a provozní připravenost
Rozhodnutí o nasazení do produkce vyžaduje více než úspěšnou demonstraci. Definujte zamýšlené uživatele, provozní prostředí, vstupy, výstupy, závislosti, vlastníka a důsledky každého důležitého selhání. Zaveďte reprodukovatelnou základní úroveň a verzovanou evaluační sadu před laděním. Testujte běžné případy, okrajové podmínky, poškozené nebo chybějící vstupy, posun distribuce, výpadky závislostí, zneužití a skupiny nebo prostředí, která jsou nejvíce nedostatečně obsloužena. Měřte kvalitu úlohy společně s kalibrací nebo nejistotou, latencí, propustností, náklady na zdroje, přístupností, soukromím a bezpečností. Zaznamenejte každou transformaci a prahovou hodnotu, aby nezávislý recenzent mohl výsledek reprodukovat a odlišit důkazy od atraktivního prototypu.
Před spuštěním přiřaďte pravomoc pro vydání, výjimky, změny, návrat k předchozímu stavu a ukončení. Použijte postupné nasazení, zachovejte bezpečnou záložní možnost a ověřte monitorování pomocí úmyslně vložených selhání. Provozní telemetrie by měla odhalovat kvalitu vstupů, chování výstupů, verzi modelu nebo pravidla, stav závislostí, lidské zásahy a potvrzené výsledky bez sběru zbytečných citlivých dat. Definujte prahové hodnoty výstrah a odpovědného, poté po nasazení přezkoumejte reálné důkazy místo předpokladu, že offline výkon přetrvá. Přehodnoťte vždy, když se změní zdroje dat, uživatelé, modely, dodavatelé, politiky, hardware nebo cíle. Udržovaný systém také vyžaduje zdokumentované postupy obnovy, učení z incidentů, mazání a uchovávání a jasný bod, kdy má být deaktivován nebo nahrazen.
Často kladené otázky
Je diskriminátor GAN diskriminační model?
Provádí diskriminaci během tréninku, ale celkový GAN je generativní rámec, jehož výstup je produkován generátorem.
Je diskriminační učení vždy supervizované?
Ne. Termín popisuje modelovaný vztah nebo hranici, zatímco supervize popisuje tréninkový signál. Moderní cíle mohou rozostřovat kategorie.
Primární reference