
Інтерв’ю
Емі Стайер, провідна дослідниця машинного навчання в Gretel.ai – Серія інтерв’ю

 Додайте Unite.AI до бажаних джерел у Google
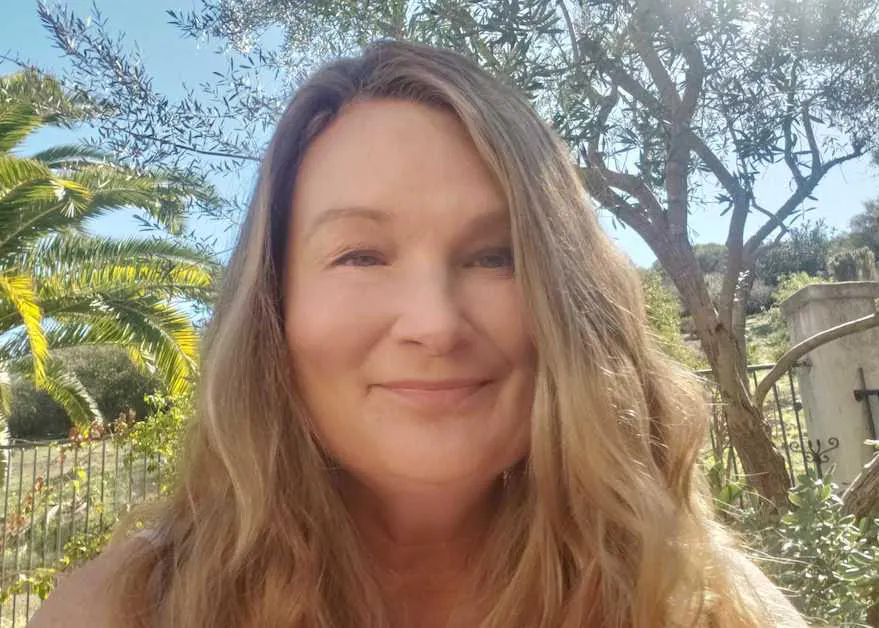
Емі Стайер – провідна дослідниця машинного навчання в Gretel.ai, найпередовішій у світі платформі технологій захисту приватності. Gretel спрощує впровадження захисту приватності від самого проєктування в технології, що спираються на дані. Її бібліотеки, засновані на штучному інтелекті, мають відкритий код і призначені для перетворення, анонімізації та синтезу конфіденційних даних.
Емі – висококваліфікована дослідниця машинного навчання та науки про дані з більш ніж 20-річним досвідом. Її пристрасть – великі дані та відкриття прихованих інтелектів за допомогою методів машинного навчання, інтелектуального аналізу даних, штучного інтелекту та статистики. Вона висококваліфікована у прогнозуванні моделей, класифікації, кластеризації, виявленні аномалій, візуалізації даних, ансамблевих методах, інформаційному пошуку, кібербезпеці, NLP, моделях рекомендацій та аналізі поведінки користувачів.
Що спочатку привернуло вас до кар’єри в галузі комп’ютерних наук та машинного навчання?
Моя чиста, беззастережна, тривала любов до даних. Потужність, загадка, інтрига та потенціал даних завжди мене приваблювали. Комп’ютерні науки та машинне навчання – це інструменти для використання цього потенціалу. Це також дуже весело працювати в галузі, де найсучасніші технології розвиваються так швидко. Мені подобається перехрестя досліджень та продукту. Це дуже задовольняє взяти передові ідеї, трохи їх розширити та потім пристосувати їх до наявних, конкретних потреб продукту.
Для читачів, які незнайомі, можете пояснити, що таке синтетичні дані?
Синтетичні дані – це дані, які виглядають і діють як оригінальні дані, але також достатньо різні, щоб задовольнити певний випадок використання. Найпоширеніший випадок використання – це потреба захистити приватність інформації в оригінальних даних. Інший випадок використання – це потреба створити додаткові дані для збільшення розміру оригінального набору даних. Ще одним випадком використання є допомога у вирішенні проблеми дисбалансу класів або демографічної упередженості в оригінальному наборі даних.
Синтетичні дані дозволяють нам продовжувати розробляти нові та інноваційні продукти та рішення, коли дані, необхідні для цього, інакше не були б присутні чи доступні.
Як платформа Gretel працює для створення синтетичних даних через API?
API технологій захисту приватності Gretel дозволяють вам імпортувати дані в Gretel та дослідити дані, які ми можемо витягнути. Це ті самі API, які використовуються нашою консоллю. Відкриваючи API через інтуїтивний інтерфейс, ми сподіваємося надати розробникам та вченим-інженерам можливість будувати свої власні робочі процеси навколо Gretel.
Хоча консоль робить створення синтетичних даних дуже простим, API дозволяють вам інтегрувати створення синтетичних даних у ваш робочий процес. Мені подобається використовувати API, оскільки це дозволяє мені налаштувати створення синтетичних даних для дуже конкретного випадку використання.
Можете обговорити деякі інструменти, які пропонуються Gretel для оцінки якості синтетичних даних?
Після створення синтетичних даних Gretel генерує звіт про синтетичні дані. У цьому звіті ви можете побачити бал якості синтетичних даних (SQS), а також оцінку рівня захисту приватності (PPL).
Бал SQS – це оцінка того, наскільки добре згенеровані синтетичні дані зберігають ті самі статистичні властивості, що й оригінальний набір даних. У цьому сенсі бал SQS можна розглядати як бал корисності або довіри до того, що наукові висновки, зроблені на основі синтетичних даних, будуть такими самими, якби ви використовували оригінальний набір даних.
Бал якості синтетичних даних обчислюється шляхом поєднання окремих показників якості: стабільності розподілу полів, стабільності кореляції полів та стабільності глибокої структури.
Стабільність розподілу полів – це міра того, наскільки добре синтетичні дані зберігають той самий розподіл полів, що й у оригінальних даних. Стабільність кореляції полів – це міра того, наскільки добре зберігаються кореляції між полями у синтетичних даних. І, нарешті, стабільність глибокої структури вимірює статистичну цілісність глибших, багатопольових розподілів та кореляцій. Для оцінки цього Gretel порівнює аналіз головних компонентів (PCA), спочатку розрахований для оригінальних даних, а потім знову для синтетичних даних.
Як працюють фільтри приватності Gretel?
Фільтри приватності Gretel були результатом великих досліджень щодо природи атак на синтетичні дані. Фільтри приватності запобігають створенню синтетичних даних з слабкостями, які часто використовуються атаками. У нас є два фільтри приватності: перший – фільтр подібності, а другий – фільтр викидів. Фільтр подібності запобігає створенню синтетичних записів, які надто схожі на записи навчання. Це перші цілі атак, які намагаються отримати інформацію про оригінальні дані. Другий фільтр приватності – фільтр викидів. Це запобігає створенню синтетичних записів, які будуть вважатися викидами у просторі, визначеному даними навчання. Викиди, виявлені у синтетичних даних, можуть бути використані атаками з виведення належності до навчальної вибірки, виведення атрибутів та різними іншими атаками. Вони становлять серйозний ризик для приватності.
Як синтетичні дані можуть допомогти у зменшенні упередженості штучного інтелекту?
Найпоширеніший метод – це вирішення представницької упередженості даних, які подаються до системи штучного інтелекту. Наприклад, якщо у ваших даних є сильна нерівновага класів або демографічна упередженість, Gretel пропонує інструменти для вимірювання та вирішення цих проблем у синтетичних даних. Видаливши упередженість у даних, ви часто видаляєте упередженість у системі штучного інтелекту, побудованому на цих даних.
Ви явно любите дізнаватися про нові технології машинного навчання, як ви особисто слідкуєте за всіма цими змінами?
Читайте, читайте та ще раз читайте, lol! Мені подобається починати свій день з читання про нові технології машинного навчання. Medium дуже добре мене знає. Мені подобається читати статті на Towards Data Science, Analytics Vidhya та новини, такі як The Sequence. Facebook (META ) AI, Google (GOOGL ) AI та OpenMined мають хороші блоги. Є багато хороших конференцій, яких слід слідкувати, таких як NeurIPS, ICML, ICLR, AISTATS.
Мені також подобаються інструменти, які відстежують цитатні сліди, допомагають вам знайти статті, подібні до тих, які вам подобаються, та які дізнаються про ваші конкретні інтереси та завжди слідкують за статтями, які можуть вас зацікавити. Zeta Alpha – один з таких інструментів, який я часто використовую.
Нарешті, ви не можете недооцінювати вигоду від того, що у вас є колеги з подібними інтересами. У Gretel команда машинного навчання відстежує дослідження, пов’язані з областями, які ми досліджуємо, та часто збирається для обговорення цікавих статей.
Яке ваше бачення майбутнього машинного навчання?
Легкий доступ до даних запустить велику еру інновацій у машинному навчанні, яке потім прискорить інновації у широкому спектрі галузей, таких як охорона здоров’я, фінанси, виробництво та біонауки. Історично багато революційних досягнень у машинному навчанні можна віднести до великої кількості багатих даних. Однак історично багато досліджень було ускладнено через неможливість доступу або обміну даними через проблеми приватності. Коли інструменти, такі як Gretel, усувають цей бар’єр, доступ до даних буде демократизований. Уся спільнота машинного навчання буде користуватися доступом до багатих, великих наборів даних, а не лише кілька елітних мегакомпаній.
Є щось ще, що ви хотіли б поділитися про Gretel?
Якщо ви любите дані, вам сподобається Gretel (так само, як мені!). Легкий доступ до даних був колючкою в боці кожного вченого-інженера з даних, якого я коли-небудь знала. У Gretel ми з гордістю створили консоль та набір API, які роблять створення даних із захистом приватності, якими можна ділитися так просто, як це можливо. Ми глибоко віримо, що дані більш цінні, коли ними діляться.
Дякую за велике інтерв’ю та за те, що поділилися своїми знаннями. Читачам, які бажають дізнатися більше, слід відвідати Gretel.ai.






