
En İyiler
10 En İyi Makine Öğrenimi Algoritmaları

 Unite.AI sitesini Google'daki tercih ettiğiniz kaynaklara ekleyin
Biz, GPU hızlandırmalı makine öğreniminin olağanüstü bir yenilik döneminde yaşıyor olsak da, son araştırma makaleleri sık sık (ve belirgin bir şekilde) onlarca yıl, belirli durumlarda 70 yıl önce ortaya çıkan algoritmaları içeriyor.
Bazıları, bu eski yöntemlerin çoğunun makine öğreniminden ziyade “istatistiksel analiz” kapsamına girdiğini iddia edebilir ve sektörün başlangıcını 1957’ye, Perceptron’un icadına kadar geri götürebilir.
Bu eski algoritmaların, son trendlere ve makine öğrenimindeki başlıca gelişmelere nasıl destek olduğunu ve iç içe geçtiğini göz önünde bulundurarak, bu görüş tartışılabilir. Bu nedenle, son yeniliklerin temelini oluşturan bazı “klasik” yapı taşlarına bir göz atalım, ayrıca bazı yeni girişimlere de bakalım.
1: Transformers
2017’de Google Research, Attention Is All You Need başlıklı makaleyle sonuçlanan bir araştırma işbirliğine öncülük etti. Çalışma, dikkat mekanizmalarını kodlayıcı/kod çözücü ve yinelemeli ağ modellerindeki yardımcı bileşenler olmaktan çıkarıp kendi başına merkezi bir dönüşüm teknolojisine dönüştüren yeni bir mimariyi tanımlıyordu.
Yaklaşım Transformer olarak adlandırıldı ve Doğal Dil İşleme (NLP) alanında devrim niteliğinde bir metodoloji haline geldi, örneğin otoregresif dil modeli ve AI’nin gözbebeği GPT-3’ü güçlendiriyor.

Transformer, ‘dönüşüm’ olarak da adlandırılan dizi transdüksiyonu problemini, yani girdi dizilerini çıktı dizilerine dönüştürme işini zarif biçimde çözdü. Bir transformer ayrıca sürekli bir şekilde veri alır ve yönetir, değil de sıralı partiler halinde, RNN mimarilerinin elde edemediği “hafıza sürekliliği” sağlar. Transformer hakkında daha ayrıntılı bir bakış için referans makalemize bakabilirsiniz.
CUDA döneminde makine öğrenimi araştırmalarına hâkim olmaya başlayan yinelemeli sinir ağlarıyla (RNN) karşılaştırıldığında, Transformer mimarisi kolayca paralelleştirilebilirdi, bu da RNN’lerden daha büyük bir veri kümesini verimli bir şekilde ele almasına olanak tanıdı.
Popüler Kullanım
Transformer, 2020’de OpenAI’nin GPT-3’ünün yayınlanmasıyla kamu hayal gücünü ele geçirdi, bu da o zamanlar rekor kıran 175 milyar parametre sunuyordu. Görünüşte şaşırtıcı olan bu başarı, daha sonraki projelerle gölgede kaldı, örneğin 2021’de Microsoft’un Megatron-Turing NLG 530B yayınlandı, adından da anlaşılacağı gibi 530 milyar parametre içeriyor.

Hyperscale Transformer NLP projelerinin zaman çizelgesi. Kaynak: Microsoft
Transformer mimarisi, NLP’den görsel işleme geçmiş, OpenAI’nin yeni bir görsel sentez çerçevesi olan CLIP ve DALL-E gibi metin>görsel alan eşlemesi kullanarak eksik görselleri tamamlamak ve eğitimli alanlardan yeni görseller sentezlemek için kullanılan bir dizi uygulamaya güç sağlıyor.
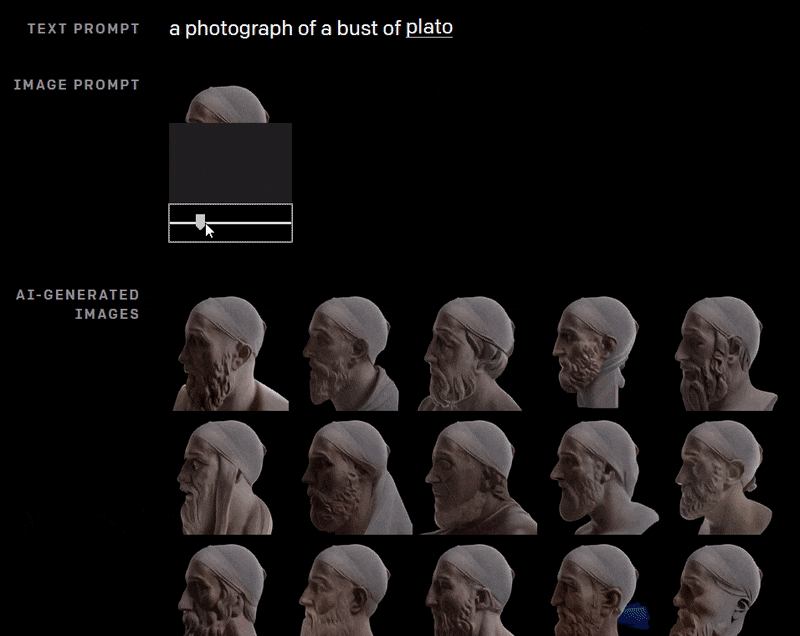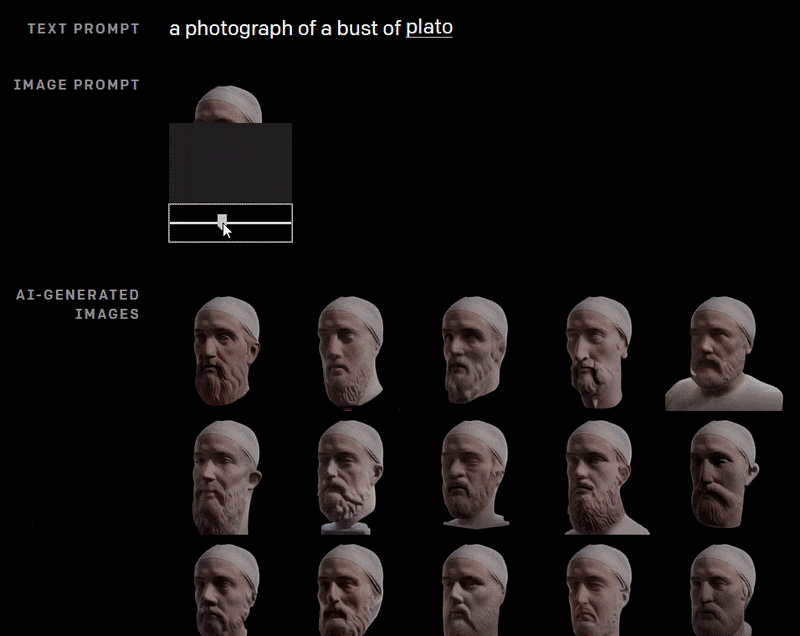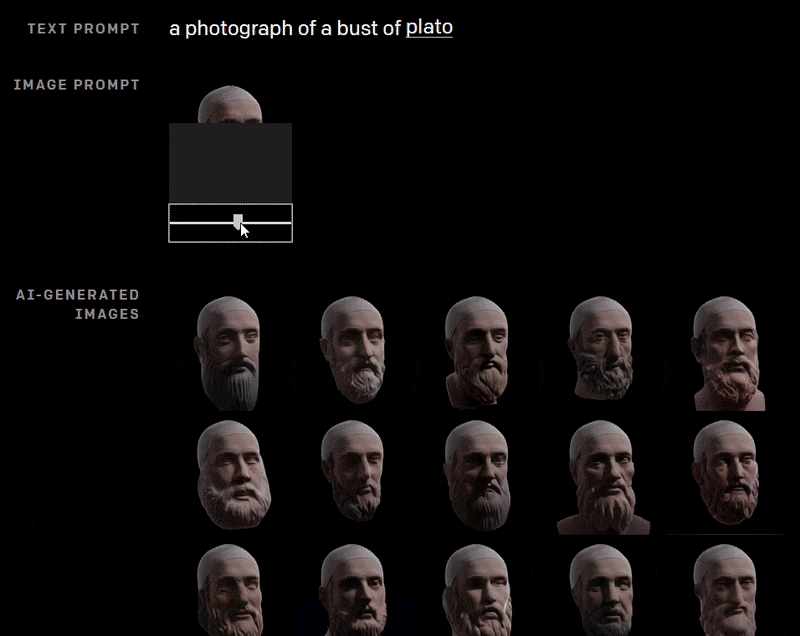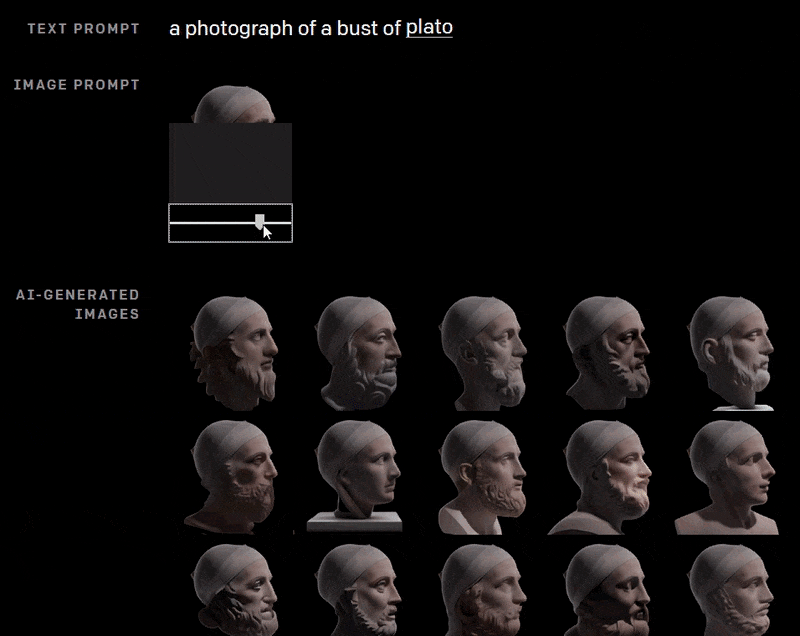
DALL-E, Platon’un bir büstünün eksik bir görselini tamamlamaya çalışıyor. Kaynak: https://openai.com/blog/dall-e/
2: Generative Adversarial Networks (GANs)
Transformer’lar, GPT-3’ün yayınlanması ve benimsenmesiyle olağanüstü medya kapsamı kazanmış olsa da, Generative Adversarial Network (GAN) kendi başına tanınabilir bir marka haline geldi ve sonunda deepfake ile birlikte bir fiil olabilir.
İlk olarak 2014’te önerilen ve esas olarak görsel sentez için kullanılan bir GAN mimari, bir Generator ve bir Discriminatorden oluşur. Generator, bir veri kümesindeki binlerce görseli döner ve bunları yeniden inşa etmeye çalışır. Her denemede, Discriminator, Generator’un işini değerlendirir ve Generator’a geri gönderir, ancak önceki yeniden inşa hatasının nasıl olduğunu açıklamaz.

Kaynak: https://developers.google.com/machine-learning/gan/gan_structure
Bu, Generator’un çok çeşitli yolları keşfetmesini sağlar, Discriminator’un nerede yanlış gittiğini söylemesi halinde oluşabilecek potansiyel çıkmazları takip etmemesini sağlar (aşağıdaki #8’e bakınız). Eğitim bitince, Generator, veri kümesindeki noktalar arasındaki ilişkilerin ayrıntılı ve kapsamlı bir haritasına sahiptir.
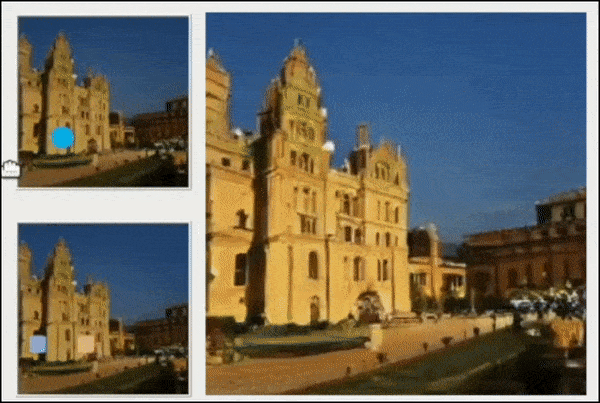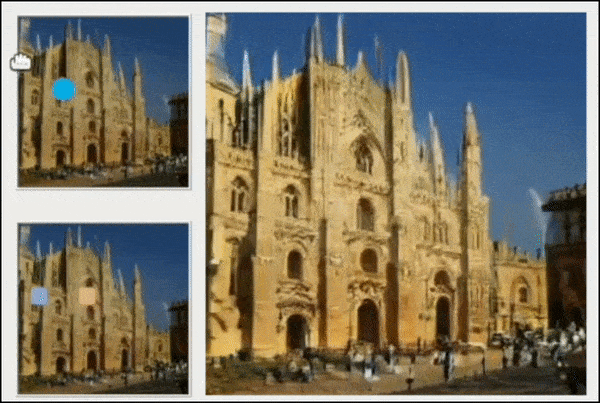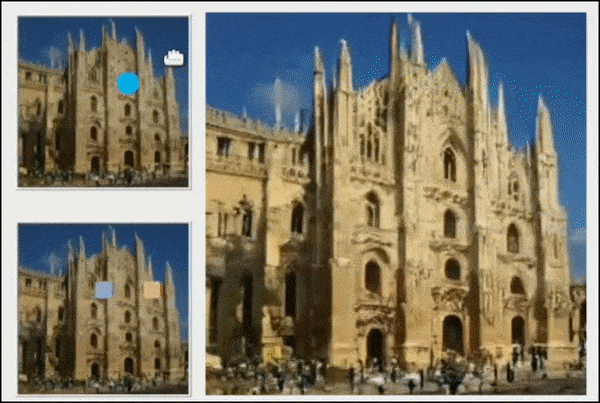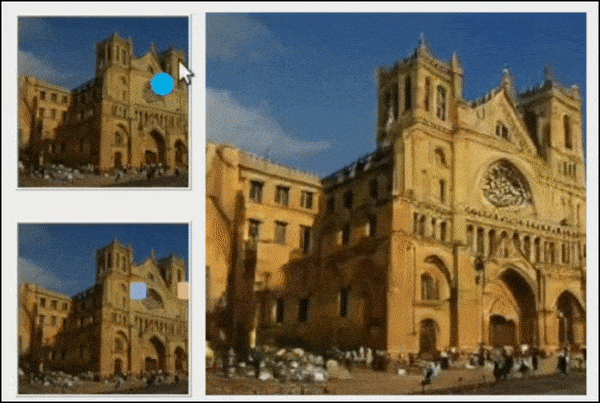
Şu makaleden: Improving GAN Equilibrium by Raising Spatial Awareness: Yeni bir çerçeve, bir GAN’ın zaman zaman gizemli olan gizli uzayını tarayarak görüntü sentezi mimarisi için etkileşimli kontrol sağlar. Kaynak: https://genforce.github.io/eqgan/
Bir benzetmeyle, bu durum Londra merkezine giden tek bir sıkıcı işe gidip gelme güzergâhını öğrenmek ile Londra taksi şoförlerinden beklenen kapsamlı sokak bilgisini, yani The Knowledge‘ı büyük emekle edinmek arasındaki farktır. Sonuç, eğitilmiş modelin gizli uzayındaki yüksek düzeyli özellikler koleksiyonudur. Bir yüksek düzeyli özelliğin semantik göstergesi ‘kişi’ olabilir, özellikler ‘erkek’ ve ‘kadın’ gibi özgüllüğe bağlı olarak daha düşük seviyelerde ortaya çıkabilir. Daha düşük seviyelerde, alt özellikler ‘sarışın’, ‘Beyaz’ gibi ayrıntılara bölünebilir.
GAN’lar ve kodlayıcı/decodlayıcı çerçevelerinin Latent uzayında özelliklerin iç içe geçmesi önemli bir sorun teşkil eder: Bir GAN tarafından üretilen bir kadın yüzündeki gülümseme, Latent uzayındaki ‘kimlik’ özelliğiyle iç içe geçmiş bir özellik mi, yoksa paralel bir dal mı?

GAN tarafından üretilen yüzler. Kaynak: https://this-person-does-not-exist.com/en
Son birkaç yıl, bu konuda yeni araştırma girişimlerini getirdi, belki de bir GAN’ın Latent uzayında özellikler düzeyinde, Photoshop tarzı düzenleme için yol açıyor, ancak şimdilik birçok dönüşüm etkili olarak ‘tüm veya hiç’ paketleridir. Özellikle, NVIDIA’nın 2021’in sonlarında yayınlanan EditGAN’ı, gizli uzayda semantik segmentasyon maskeleri kullanarak yüksek düzeyde yorumlanabilirlik elde eder.
Popüler Kullanım
Popüler deepfake videolarındaki sınırlı katılımının ötesinde, görsel/video odaklı GAN’lar son dört yıl içinde yaygınlaştı, araştırmacıları ve kamuoyunu büyüledi. Yeni sürümlerin hızlı ve sık yayınlanmasını takip etmek bir zorluk teşkil ediyor, ancak Harika GAN Uygulamaları GitHub deposu, kapsamlı bir liste sağlamayı amaçlıyor.
GAN’lar teoride, iyi tanımlanmış herhangi bir alandan özellikler türetebilir, metin dahil.
3: SVM
1963’te ortaya çıkan Destek Vektör Makinesi (SVM), yeni araştırmalarda sıkça ortaya çıkan temel bir algoritmadır. SVM altında, vektörler, bir veri kümesindeki veri noktalarının göreli konumunu haritalar, buna karşılık destek vektörleri, farklı gruplar, özellikler veya özellikler arasındaki sınırları belirler.

Destek vektörleri, gruplar arasındaki sınırları tanımlar. Kaynak: https://www.kdnuggets.com/2016/07/support-vector-machines-simple-explanation.html
Elde edilen sınır, bir hiperdüzlem olarak adlandırılır.
Düşük özellik seviyelerinde, SVM iki boyutlu (yukarıdaki resim), ancak daha yüksek sayıda grup veya tür olduğunda üç boyutlu olur.

Daha derin bir nokta ve grup dizisi, üç boyutlu bir SVM gerektirir. Kaynak: https://cml.rhul.ac.uk/svm.html
Popüler Kullanım
Destek Vektör Makineleri, çeşitli türlerde yüksek boyutlu verileri etkili ve tarafsız bir şekilde ele alabildiği için, derin sahtecilik tespiti, görsel sınıflandırma, nefret söylemi sınıflandırması, DNA analizi ve popülasyon yapısı tahmini dahil olmak üzere çeşitli makine öğrenimi sektörlerinde yaygın olarak ortaya çıkar.
4: K-Means Clustering
Genel olarak, kümeleme, gözetimsiz öğrenme yaklaşımı, veri noktalarını yoğunluk tahmini yoluyla kategorilere ayırarak incelenen verilerin dağılım haritasını oluşturur.

K-Means kümeleme, veride segmentler, gruplar ve topluluklar keşfeder. Kaynak: https://aws.amazon.com/blogs/machine-learning/k-means-clustering-with-amazon-sagemaker/
K-Means Clustering, bu yaklaşımın en popüler uygulaması haline geldi, veri noktalarını ayırt edici ‘K Gruplara’ yönlendirerek, bu gruplar demografik sektörleri, online toplulukları veya ham istatistiksel veride keşfedilmeyi bekleyen diğer herhangi bir gizli birleşmeyi gösterebilir.

K-Means analizinde kümeleme oluşur. Kaynak: https://www.geeksforgeeks.org/ml-determine-the-optimal-value-of-k-in-k-means-clustering/
K değeri, işlemin faydasını ve bir küme için optimal bir değeri belirlemede belirleyici faktördür. İlk olarak, K değeri rastgele atanır ve özellikleri ve vektör özelliklerine komşularıyla karşılaştırılır. En çok benzeyen komşular, K değerinin atanmasına göre yinelemeli olarak atanır, veri tüm izin verilen gruplamaları verir.
Farklı değerler arasındaki kare hataların veya ‘maliyetin’ grafiği, veride bir dirsek noktası gösterecektir:

Küme grafiğinde dirsek noktası. Kaynak: https://www.scikit-yb.org/en/latest/api/cluster/elbow.html
Dirsek noktası, bir eğitim oturumunun sonunda kaybın düzleştiği şekilde benzer bir kavramdır. Gruplar arasındaki daha fazla ayrımın görünmeyeceği noktayı temsil eder, bu da veri boru hattındaki sonraki aşamalara geçmek veya bulguları raporlamak için zamanın geldiğini gösterir.
Popüler Kullanım
K-Means Clustering, müşteri analizi için birincil bir teknolojidir, çünkü büyük ticari kayıtları demografik bilgiler ve ‘potansiyel müşteriler’ olarak çevirmek için net ve açıklanabilir bir metodoloji sunar.
Bu uygulamaların dışında, K-Means Clustering, heyelan tahmini, tıbbi görüntü segmentasyonu, GAN’lar ile görüntü sentezi, belge sınıflandırması ve şehir planlaması dahil olmak üzere birçok başka potansiyel ve gerçek kullanım için de kullanılır.
5: Rastgele Orman
Rastgele Orman, bir dizi topluluk öğrenmesi yaklaşımı kapsamında karar ağacının sonuçlarını ortalayarak genel bir sonuç tahmini oluşturan yöntemdir.

Kaynak: https://www.tutorialandexample.com/wp-content/uploads/2019/10/Decision-Trees-Root-Node.png
Eğer sadece Back to the Future üçlemesini araştırdıysanız bile, bir karar ağacı oldukça kolay kavramak için: önünüzde birçok yol var ve her yol yeni bir sonuçla dallanıp budaklanıyor.
Pekiştirmeli öğrenmede bir yoldan geri dönüp önceki bir konumdan yeniden başlayabilirsiniz; karar ağaçları ise seçtikleri yolculuğa bağlı kalır.
Dolayısıyla Rastgele Orman algoritması esasen kararlar arasında riski dağıtır. Algoritmaya ‘rastgele’ denir; çünkü karar ağacı dizisinin sonuçlarının medyan toplamını anlamak üzere ad hoc seçimler ve gözlemler yapar.
Bu, karar ağaçlarının kolayca grafikleştirilebileceği, ancak Rastgele Orman yaklaşımının çok faktörlü olduğu için daha zor olabileceği anlamına gelir, ancak daha üretken olma ihtimali daha yüksektir.
Karar ağaçları, elde edilen sonuçların veri spesifik olduğu ve genelleştirilemeyeceği anlamına gelen aşırı uyum eğilimindedir. Rastgele Orman’ın rasgele veri noktası seçimlerinin bu eğilimle mücadele ettiği söylenebilir.

Karar ağacı regresyonu. Kaynak: https://scikit-learn.org/stable/auto_examples/tree/plot_tree_regression.html
Popüler Kullanım
Rastgele Orman, genellikle yeni araştırma makalelerinde ortaya çıkan bir ‘erken’ veri sıralayıcı ve filtreleyicisi olarak çalışır. Rastgele Orman kullanımının bazı örnekleri arasında Manyetik Rezonans Görüntü Sentezi, Bitcoin fiyat tahmini, nüfus segmentasyonu, metin sınıflandırması ve kredi kartı sahteciliği tespiti bulunur.
Rastgele Orman, makine öğrenimi mimarilerinde düşük seviyeli bir algoritma olduğu için, diğer düşük seviyeli yöntemlerin ve görselleştirme algoritmalarının performansına da katkıda bulunabilir, bunlar arasında Endüktif Kümeleme, Özellik Dönüşümleri, seyrek özellikler kullanarak metin belge sınıflandırması ve Pipelineri görüntüleme bulunur.
6: Naive Bayes
Yoğunluk tahmini ile birlikte (yukarıdaki 4‘e bakınız), bir Naive Bayes sınıflandırıcı, veri özelliklerine dayalı olasılıkları tahmin edebilen, ancak nispeten hafif bir algoritmadır.

Naive Bayes sınıflandırıcıdaki özellik ilişkileri. Kaynak: https://www.sciencedirect.com/topics/computer-science/naive-bayes-model
‘Naive’ terimi, Bayes teoremindeki özelliklerin ilişkisiz olduğu varsayımına atıfta bulunur, yani koşullu bağımsızlık. Bu bakış açısını benimsersek, bir ördeğin yürümesi ve konuşması, bir ördekle uğraştığımızı kanıtlamak için yeterli değildir ve hiçbir ‘açık’ varsayım önceden alınmaz.
Bu düzeyde akademik ve araştırma titizliği, ‘ortak akıl’ mevcut olduğunda fazla olabilir, ancak makine öğrenimi veri kümesindeki birçok belirsizlik ve potansiyel olarak ilişkisiz korelasyonları geçerken değerli bir standarttır.
Asıl bir Bayes ağındaki özellikler, skorlama fonksiyonları dahil olmak üzere, minimal açıklama uzunluğu ve Bayes skorlaması gibi kısıtlamalara tabidir, bu da veri noktaları arasındaki tahmin edilen bağlantılar ve bu bağlantılar akış yönü açısından veri üzerinde kısıtlamalar getirebilir.
Bir Naive Bayes sınıflandırıcı, bunun yerine, bir nesnenin özelliklerinin bağımsız olduğunu varsayar ve Bayes teoremini kullanarak, özelliklerine dayalı bir nesnenin olasılığını hesaplar.
Popüler Kullanım
Naive Bayes filtreleri, hastalık tahmini ve belge kategorizasyonu, spam filtreleme, duygu sınıflandırması, öneri sistemleri ve sahtecilik tespiti dahil olmak üzere birçok uygulamada temsil edilmektedir.
7: K-En Yakın Komşular (KNN)
ABD Hava Kuvvetleri Havacılık Tıp Okulu tarafından ilk olarak 1951’de önerilen ve 20. yüzyılın ortalarındaki bilgisayar donanımının durumuna uyum sağlamak zorunda kalan K-En Yakın Komşular (KNN), akademik makalelerde ve özel sektörün makine öğrenimi araştırmalarında hâlâ öne çıkan yalın bir algoritmadır.
KNN, ‘tembel öğrenen’ olarak adlandırılır, çünkü tam teşekküllü bir makine öğrenimi modelinin eğitilmesini gerektirmek yerine, veri noktaları arasındaki ilişkileri değerlendirmek üzere veri kümesini kapsamlı biçimde tarar.

KNN grubu. Kaynak: https://scikit-learn.org/stable/modules/neighbors.html
KNN, mimari olarak ince olmasına rağmen, okuma/yazma işlemlerine önemli bir talep getirir ve büyük veri kümeleriyle kullanımı, ilave teknolojiler olmadan sorunlu olabilir, örneğin Temel Bileşen Analizi (PCA), karmaşık ve yüksek hacimli veri kümelerini KNN’nin daha az çaba harcayarak geçebileceği temsilci gruplara dönüştürebilir.
Yakın tarihli bir çalışma, bir çalışanın bir şirketten ayrılacağına dair tahmini görevi verilen bir dizi algoritmanın etkinliğini ve ekonomisini değerlendirdi ve yetmiş yaşındaki KNN’nin, modern rakiplerine kıyasla doğruluk ve öngörülebilirlik açısından üstün olduğunu buldu.
Popüler Kullanım
KNN, kavram ve uygulama bakımından basit olmasına rağmen 1950’lerde kalmamıştır: Pennsylvania Eyalet Üniversitesinin 2018 tarihli önerisinde DNN odaklı bir yaklaşıma uyarlanmıştır. Çok daha karmaşık birçok makine öğrenimi çerçevesinde erken aşamada çalışan merkezi bir süreç veya sonradan işleme yönelik analitik araç olmayı sürdürmektedir.
Çeşitli yapılandırmalarda KNN; çevrimiçi imza doğrulama, görsel sınıflandırma, metin madenciliği, ürün verimi tahmini ve yüz tanıma dahil olmak üzere birçok farklı uygulamada ve entegrasyonda kullanılır.

Eğitimde bir KNN tabanlı yüz tanıma sistemi. Kaynak: https://pdfs.semanticscholar.org/6f3d/d4c5ffeb3ce74bf57342861686944490f513.pdf
8: Markov Karar Süreci (MDP)
Amerikalı matematikçi Richard Bellman tarafından 1957’de tanıtılan Markov Karar Süreci (MDP), pekiştirme öğrenimi mimarilerinin en temel yapı taşlarından biridir. Kendi başına kavramsal bir algoritmadır ve birçok diğer algoritmaya uyarlanmıştır ve güncel AI/ML araştırmalarında sıkça ortaya çıkar.
MDP, veri ortamını, mevcut durumunun (yani veride ‘nerede’ olduğu) değerlendirmesini kullanarak, hangi veri düğümünü sonraki olarak keşfedeceğine karar verir.

Kaynak: https://www.sciencedirect.com/science/article/abs/pii/S0888613X18304420
Temel bir Markov Karar Süreci, uzun vadeli hedeflerden ziyade kısa vadeli avantajı önceliklendirecektir. Bu nedenle, pekiştirme öğreniminde genellikle daha kapsamlı bir politika mimarisine yerleştirilir ve genellikle indirgenmiş ödül, diğer değiştirici çevresel değişkenler gibi sınırlayıcı faktörlerle sınırlıdır, bu da kısa vadeli bir hedefe, daha geniş istenilen sonuç dikkate alınmadan ulaşmasını engellemek için kullanılır.
Popüler Kullanım
MDP’nin düşük seviyeli kavramı, hem araştırmada hem de makine öğreniminin aktif dağıtımlarında yaygındır. IoT güvenlik savunma sistemleri, balık avı ve pazar tahmini için önerilmiştir.
Bunun satranç ve diğer sıralı oyunlara olan açık uygulamasının yanı sıra, MDP, robotik sistemlerin prosedürel eğitimine de doğal bir adaydır, aşağıdaki videoda görüldüğü gibi.
9: Terim Sıklığı-Ters Belge Sıklığı
Terim Sıklığı (TF), bir kelimenin bir belgede görülme sayısını o belgedeki toplam kelime sayısına böler. Böylece bin kelimelik bir makalede bir kez görünen fok kelimesinin terim sıklığı 0,001’dir. Kendi başına TF, anlamsal içerik taşımayan işlev kelimeleri, örneğin İngilizce a, and, the ve it baskın olduğu için terim önemini gösteren bir ölçüt olarak büyük ölçüde işe yaramaz.
Terim önemini anlamlı bir değer elde etmek için, Ters Belge Sıklığı (IDF) bir kelimenin bir veri kümesindeki birden fazla belgedeki TF’sini hesaplar, çok yüksek frekanslı durma kelimelerine düşük puanlar verir. Elde edilen özellik vektörleri tam değerlere normalleştirilir ve her kelimeye uygun bir ağırlık atanır.

TF-IDF, terimlerin alaka düzeyini, birden fazla belgedeki sıklığına göre ağırlıklandırır, nadir oluş, önemli bir göstergedir. Kaynak: https://moz.com/blog/inverse-document-frequency-and-the-importance-of-uniqueness
Bu yaklaşım, anlamlı kelimelerin aykırı değerler olarak kaybolmasını önler, ancak sıklık ağırlığını tersine çevirmek, otomatik olarak düşük sıklıklı bir terimin aykırı değer olmadığı anlamına gelmez, çünkü bazı şeyler nadir ve değersizdir. Bu nedenle, bir düşük sıklıklı terim, daha geniş mimari bağlamında değerini kanıtlamak için, veri kümesindeki birden fazla belgede (her belge başına düşük sıklıkla) ortaya çıkmalıdır.
Yaşına rağmen, TF-IDF, Doğal Dil İşleme çerçevelerinde ilk filtre geçişleri için güçlü ve popüler bir yöntemdir.
Popüler Kullanım
TF-IDF, son yirmi yılda Google’ın büyük ölçüde gizli PageRank algoritmasının geliştirilmesinde en azından bir ölçüde rol oynadığından, John Mueller’in 2019’da arama sonuçları açısından çok yaygın biçimde benimsenen bu yaklaşımın önemini reddetmesine rağmen manipülatif bir SEO taktiği olarak kullanılmaktadır.
PageRank’ın gizliliği nedeniyle TF-IDF’nin şu anda Google sıralamalarında yükselmek için etkili bir taktik olmadığına dair açık bir kanıt yoktur. BT uzmanları arasındaki son hararetli tartışma, doğru olsun ya da olmasın, terimlerin kötüye kullanımının hâlâ SEO konumunu iyileştirebileceğine dair yaygın bir anlayışı gösteriyor; ancak ek tekel suistimali iddiaları ve aşırı reklamcılık bu teoriyi bulanıklaştırıyor.
10: Rastgele Gradyan İnişi
Rastgele Gradyan İnişi (SGD), makine öğrenimi modellerinin eğitimini optimize etmek için giderek daha popüler bir yöntem haline geldi.
Gradyan İnişi kendisi, bir modelin eğitim sırasında yaptığı ilerlemeyi optimize etme ve nicelendirme yöntemidir.
Bu anlamda ‘gradyan’, renge dayalı bir derecelendirme yerine aşağı doğru bir eğimi ifade eder (aşağıdaki resme bakın). Soldaki ‘tepenin’ en yüksek noktası eğitim sürecinin başlangıcını temsil eder. Bu aşamada model tüm verileri henüz bir kez bile görmemiştir ve etkili dönüşümler üretecek kadar veri ilişkisi öğrenmemiştir.

Bir FaceSwap eğitim oturumunda gradyan inişi. Eğitim, bir süre için ikinci yarıda plato yapmış, ancak sonunda gradyan boyunca kabul edilebilir bir yakınsama için yolunu bulmuştur.
En düşük nokta, sağ tarafta, yakınsamayı (modelin, uygulanan kısıtlamalar ve ayarlarla, mümkün olduğu kadar etkili hale geldiği nokta) temsil eder.
Gradyan, hata oranları (modelin şu anda veri ilişkilerini nasıl eşleştirdiği) ile ağırlıklar (modelin öğrenmesini etkileyen ayarlar) arasındaki uyumsuzluğu kaydeder ve öngörür.
Bu ilerleme kaydı, bir öğrenme oranı zamanlaması bilgilendirmek için kullanılabilir, bu, mimarinin, erken belirsiz ayrıntıların net ilişkiler ve eşleştirmelere dönüşmesiyle birlikte, daha granüler ve kesin olması için otomatik bir işlemdir. Aslında, gradyan kaybı, eğitim nereye gideceğini ve nasıl ilerleyeceğini gösteren bir anlık harita sağlar.
Rastgele Gradyan İnişinin yeniliği, model parametrelerini her bir eğitim örneğinde güncellemesidir, bu da genellikle yakınsama yolculuğunu hızlandırır. Son yıllarda ortaya çıkan hiperscale veri kümeleri nedeniyle, SGD son zamanlarda lojistik sorunları ele almak için bir yöntem olarak popülerlik kazandı.
Öte yandan, SGD, özellik ölçeklendirme için olumsuz etkileri vardır ve aynı sonucu elde etmek için daha fazla iterasyon gerektirebilir, bu da daha fazla planlama ve parametre gerektirir, düzenli Gradyan İnişi ile karşılaştırıldığında.
Popüler Kullanım
Esnekliğine ve eksikliklerine rağmen, SGD, sinir ağlarını uyarlama için en popüler optimizasyon algoritması haline geldi. SGD’nin yeni AI/ML araştırma makalelerinde baskın bir seçim olan bir konfigürasyonu, 2015’te girişilen Adaptif Moment Tahmini (ADAM) optimize edicisidir.
ADAM, her parametrenin öğrenme oranını dinamik olarak uyarlar (‘adaptif öğrenme oranı’) ve ayrıca önceki güncellemelerden sonuçları sonraki konfigürasyona dahil eder (‘momentum’). Ayrıca, daha sonraki yenilikleri kullanmak için yapılandırılabilir, örneğin Nesterov momentumu.
Bununla birlikte, bazıları, momentum kullanımının ADAM’ı (ve benzer algoritmaları) alt-optimum bir sonuca sürükleyebileceğini iddia ediyor. Makine öğrenimi araştırma sektörünün kanatlarında olduğu gibi, SGD bir çalışma halinde.
İlk olarak 10 Şubat 2022’de yayınlandı. 10 Şubat 20:05 EET – biçimlendirme.


