
Anderson’un Açısı
Video İçerisinden Nesneleri Daha Verimli Bir Şekilde Kaldırma İle Makine Öğrenimi

 Unite.AI sitesini Google'daki tercih ettiğiniz kaynaklara ekleyin
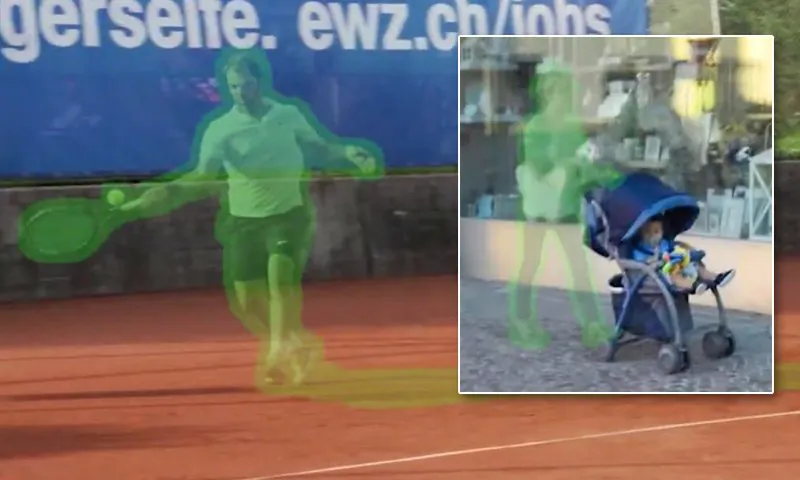
Çin’den yapılan yeni bir araştırmada, video inpainting sistemi için devlet-sanatlı sonuçlar raporlandı – aynı zamanda video inpainting sisteminin videodan nesneleri kaldırma verimliliğinde etkileyici bir iyileşme de görüldü.
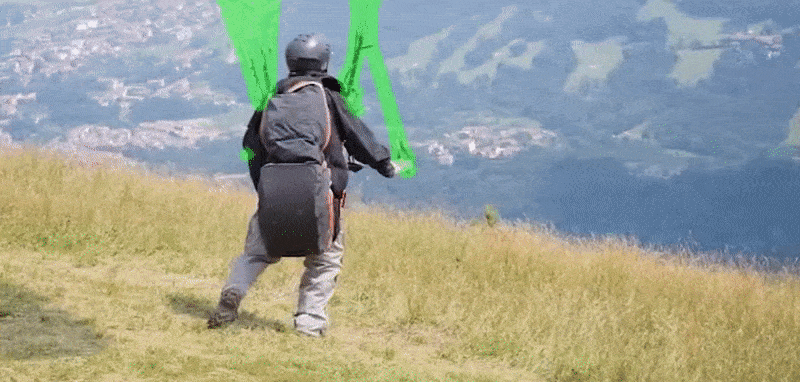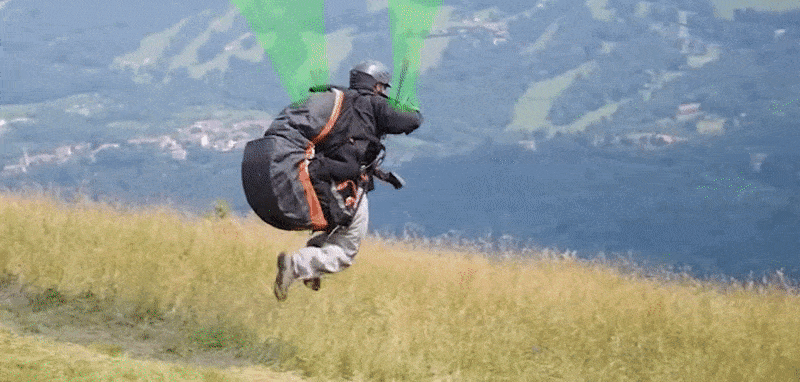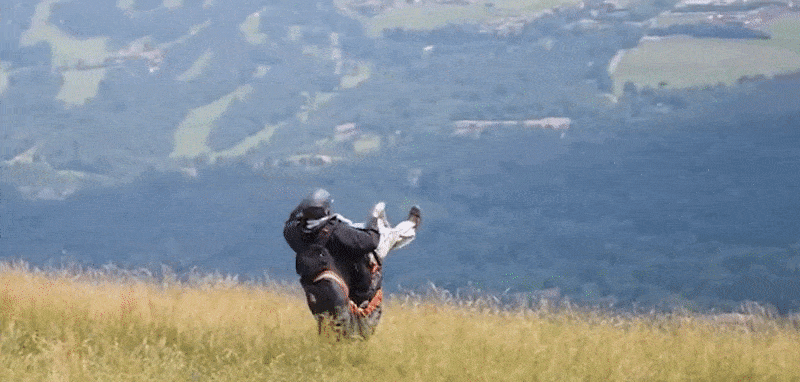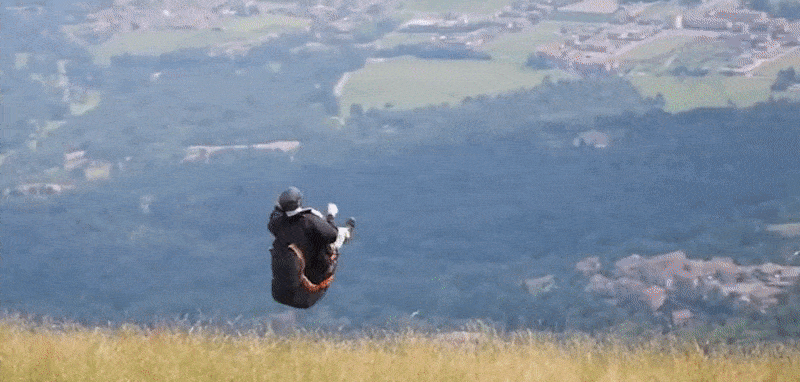
Yeni prosedür, bir yamaşırın harnessını boyuyor. Daha iyi çözünürlük ve daha fazla örnek için bu makalenin sonunda gömülü olan kaynak videosunu görün. Kaynak: https://www.youtube.com/watch?v=N–qC3T2wc4
End-to-End framework for Flow-Guided video Inpainting (E2FGVI) olarak adlandırılan teknik, ayrıca video içerisinden su işaretlerini ve diğer çeşitli türdeki engelleri kaldırma yeteneğine de sahiptir.
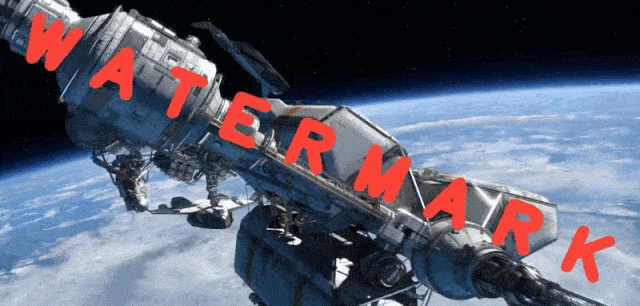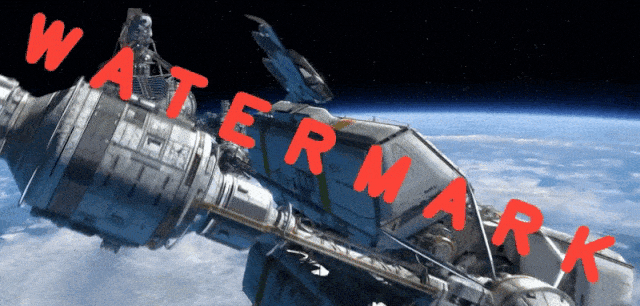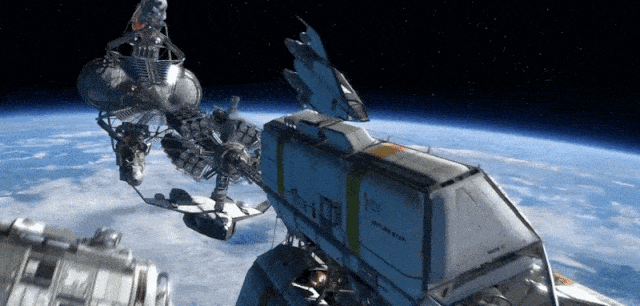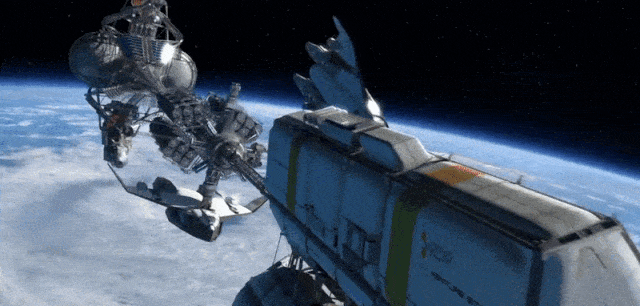
E2FGVI, engellerin arkasındaki içeriğin tahminlerini hesaplar ve böylece even önemli ve çözülmesi zor su işaretlerinin kaldırılmasını sağlar. Kaynak: https://github.com/MCG-NKU/E2FGVI
(Daha iyi çözünürlükte daha fazla örnek görmek için videoyu kontrol edin)
Model, 432px x 240px videolarda (ortak düşük girdi boyutları, mevcut GPU alanı ile optimal batch boyutları ve diğer faktörler tarafından kısıtlanmıştır) eğitim görmüş olsa da, yazarlar daha sonra E2FGVI-HQ‘yi yayınladılar, bu da任意 bir çözünürlükte video işleyebilir.
Mevcut sürümün kodu GitHub‘da mevcuttur, HQ sürümü ise geçen pazar yayımlandı ve Google Drive ve Baidu Disk‘ten indirilebilir.

Çocuk resimde kalıyor.
E2FGVI, 432×240 videoyu 0.12 saniyede bir Titan XP GPU (12GB VRAM) ile işleyebilir ve yazarlar, sistemin önceki devlet-sanatlı yöntemlerden on beş kat daha hızlı çalıştığını raporladı.
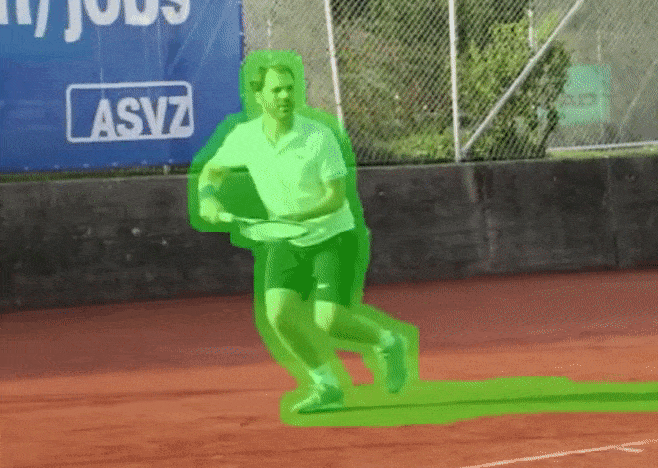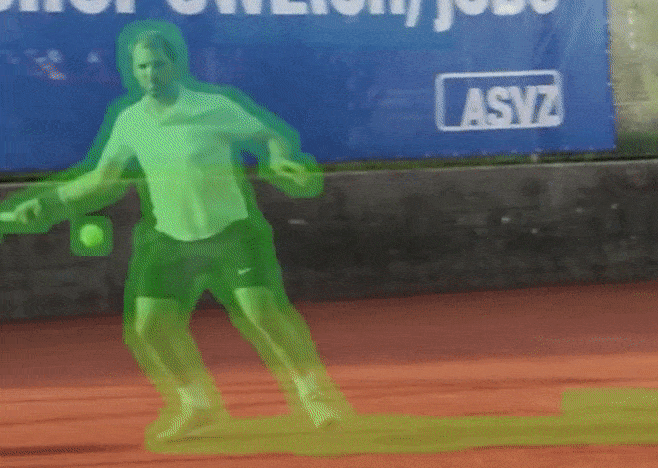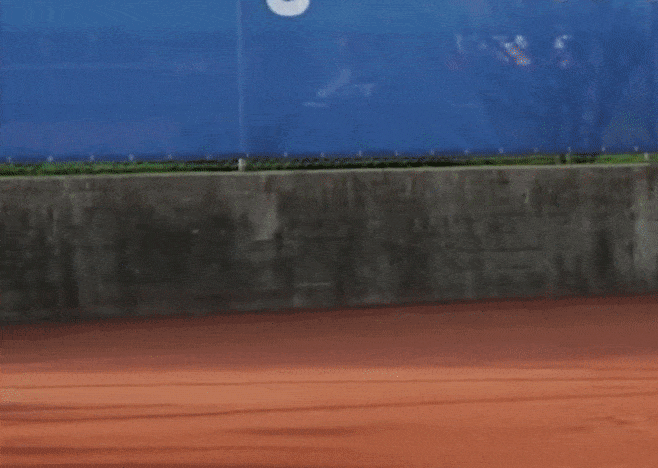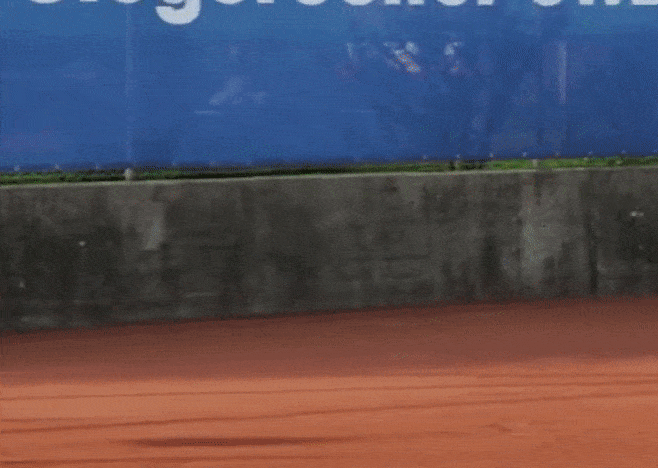
Tenis oyuncusu beklenmedik bir çıkış yapıyor.
Testler, standardlaştırılmış veri setlerinde yapıldı ve yeni yöntem, hem nitel hem de nicel değerlendirme turunda rakiplerini geride bıraktı.

Önceki yaklaşımlarla yapılan testler. Source: https://arxiv.org/pdf/2204.02663.pdf
Makale başlıklı Towards An End-to-End Framework for Flow-Guided Video Inpainting, Nankai Üniversitesi’nden dört araştırmacı ile Hisilicon Technologies’den bir araştırmacı arasındaki bir işbirliğidir.
Bu Resimde Ne Eksiktir
Görünür efektler için obvious uygulamalarının yanı sıra, yüksek kaliteli video inpainting, yeni AI tabanlı görüntü sentezi ve görüntü değiştirme teknolojilerinin temel bir özelliği haline gelecektir.
Bu, özellikle vücut değiştirme modası uygulamaları ve sahneleri ‘zayıflatmak’ veya görüntülerde ve videolarda başka şekilde değiştirmeyi amaçlayan diğer çerçeveler için geçerlidir. Bu durumlarda, sentez tarafından ortaya çıkarılan ek arka planı ikna edici bir şekilde ‘doldurmak’ gerekir.

Bir vücut ‘yeniden şekillendirme’ algoritması, bir konunun yeniden boyutlandırılması sırasında ortaya çıkan yeni ortaya çıkan arka planı boyamakla görevlendirilir. Kaynak materyalden https://arxiv.org/pdf/2203.10496.pdf
Uyumlu Optik Akış
Optik akış (OF), video nesne kaldırma geliştirilmesinde temel bir teknoloji haline gelmiştir. Bir atlas gibi, OF, bir zaman dizisinin haritasını sağlar. Bilgisayarlı görme girişimlerinde hız ölçmek için sıkça kullanılan OF, ayrıca zamanla tutarlı bir şekilde boyama sağlar, burada görevin toplamı tek bir geçişte dikkate alınabilir, Disney tarzı ‘her çerçeve’ dikkat yerine, bu da zamanla tutarlılığı kaçınılmaz olarak engeller.
Video inpainting yöntemleri bugüne kadar üç aşamalı bir sürece odaklandı: akış tamamlama, video esasen bir harita çıkarılır ve keşfedilebilir bir varlık haline gelir; pixel propagasyonu, ‘bozuk’ videolardaki delikler çift yönlü olarak propagasyon yoluyla doldurulur; ve içerik hayal etme (pixel ‘icat’ deepfakes ve metin-görsel çerçeveler gibi DALL-E serisi gibi çoğumuza aşina olan), tahmini ‘eksik’ içerik icat edilir ve görüntüye eklenir.
E2FGVI’nin merkezi yeniliği, bu üç aşama bir uçtan uca sisteme birleştirmektir, bu da içerik veya işlem üzerinde manuel operasyonlar yapılma ihtiyacını ortadan kaldırır.

Makale, daha önceki işlemlerin manuel müdahale ihtiyacı nedeniyle GPU’dan yararlanamadığını, bu da oldukça zaman alıcı olduğunu belirtiyor. Makaledeki alıntı:
‘Örneğin, DFVI gibi, 432 × 240 boyutundaki bir videoyu, DAVIS veri setinden yaklaşık 70 karelik bir videoyu tamamlamak yaklaşık 4 dakika sürer, bu da çoğu gerçek dünya uygulamasında kabul edilemez. Ayrıca, yukarıda belirtilen eksikliklerin yanı sıra, yalnızca içeriğin hallucinasyon aşamasında önceden eğitilmiş bir görüntü inpainting ağı kullanmak, zamanla komşular arasındaki içerik ilişkilerini görmezden gelir, bu da videolarda tutarlı içeriğin üretilmesini engeller.’
Video inpainting’in üç aşamasını birleştiren E2FGVI, ikinci aşama olan pixel propagasyonunu, özellik propagasyonu ile değiştirir. Önceki çalışmaların daha segmentli süreçlerinde, özellikler bu kadar yaygın olarak mevcut değildir, çünkü her aşama nispeten kapalıdır ve iş akışı yalnızca yarı otomatiktir.
Araştırmacılar, içerik hayal etme aşaması için bir zamansal odaklı transformer de tasarladılar, bu, yalnızca geçerli karedeki piksellerin doğrudan komşularını (yani önceki veya sonraki görüntüdeki o karedeki ne oluyor) değil, aynı zamanda uzak komşuları da dikkate alır, bunlar birçok kare uzakta olabilir, ancak video üzerindeki herhangi bir operasyonun bütüncül etkisini etkileyecektir.

E2FGVI mimarisi.
E2FGVI’nin yeni özelliklere dayalı merkezi bölümü, daha fazla özellik düzeyinde işlemlerden ve öğrenilebilir örneklem ofsetlerinden yararlanabilir, projenin yeni odaklı transformeri, yazarlara göre, odak penceresinin boyutunu ‘2D’den 3D’ye’ genişletir.
Testler ve Veriler
E2FGVI’yi test etmek için, araştırmacılar sistemi iki popüler video nesne segmentasyonu veri setlerine karşı değerlendirdiler: YouTube-VOS ve DAVIS. YouTube-VOS, 3741 eğitim video klip, 474 doğrulama klip ve 508 test klip içerir, DAVIS ise 60 eğitim video klip ve 90 test klip içerir.
E2FGVI, YouTube-VOS’da eğitildi ve her iki veri setinde değerlendirildi. Eğitim sırasında, nesne maskeleri (yukarıdaki resimlerdeki yeşil alanlar ve eşlik eden YouTube videosu) video tamamlama simülasyonu için oluşturuldu.
Metrikler için, araştırmacılar Piksel Sinyal-Gürültü Oranını (PSNR), Yapısal Benzerlik (SSIM), Video Tabanlı Fréchet Inception Mesafesi (VFID) ve Akış Saptırma Hatasını (Flow Warping Error) – sonuncusu, etkilenen videodaki zamanla tutarlılığı ölçmek için – benimseyerek, adopted.
Karşılaştırıldığı önceki mimariler VINet, DFVI, LGTSM, CAP, FGVC, STTN ve FuseFormer idi.

Makaledeki nicel sonuçlar bölümünden. Yukarı ve aşağı oklar, daha yüksek veya daha düşük numaraların daha iyi olduğunu gösterir. E2FGVI, tüm panellerde en iyi puanları alır. Yöntemler FuseFormer’a göre değerlendirilir, ancak DFVI, VINet ve FGVC, uçtan uca sistemler olmadıkları için FLOPs’lerini tahmin etmek mümkün değildir.
Diğer tüm sistemlere karşı en iyi puanları almasının yanı sıra, araştırmacılar beş temsilci yöntemle dönüştürülen videoları bireysel olarak yirmi gönüllüye göstererek bir nitel kullanıcı çalışması da gerçekleştirdiler, katılımcılardan bunları görsel kalite açısından değerlendirmeleri istendi.

Dikey eksen, E2FGVI çıkışının görsel kalitesi açısından tercih edilen katılımcıların yüzdesini temsil eder.
Yazarlar, yöntemlerine karşı oybirliğiyle bir tercih olduğunu belirtirler, ancak sonuçlardan biri, FGVC, nicel sonuçları yansıtmaz ve bu, E2FGVI’nin ‘daha görsel olarak hoş sonuçlar’ üretiyor olabileceğini gösterir.
Verimlilik açısından, yazarlar, sistemin DAVIS veri setinde bir Titan GPU’da kayan nokta işlemlerini (FLOPs) ve çıkarım süresini büyük ölçüde azalttığını belirtirler ve sonuçların E2FGVI’nin akış tabanlı yöntemlerden x15 daha hızlı çalıştığını gösterir.
Onlar yorumlar:
‘[E2FGVI] tüm diğer yöntemlere kıyasla en düşük FLOPs değerine sahiptir. Bu, önerilen yöntemin video inpainting için son derece verimli olduğunu gösterir.’
*Yazarların satır içi alıntılarını hyperlink’e dönüştürmemin bir sonucu.
İlk olarak 19 Mayıs 2022’de yayımlandı.
28 Ekim 2025 Salı günü, hatalı video gömme öğesini kaldırmak ve makale gövdesindeki gömülü videoya yapılan referansları değiştirmek için düzeltilmiştir.


