

Yapay zeka modelleri ve platformları
DynamiCrafter: Açık Alan Görsellerinin Animasyonu için Video Diffusion Öncülleri

 Unite.AI sitesini Google'daki tercih ettiğiniz kaynaklara ekleyin
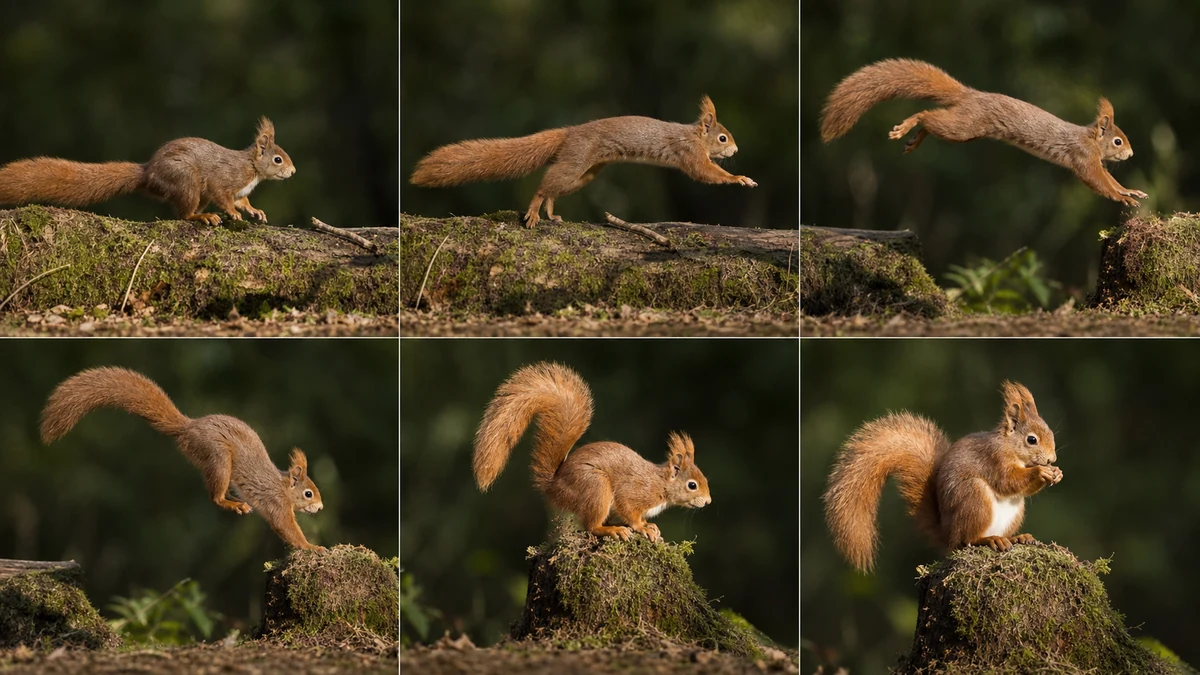
Bilgisayar görüntüsü bugün yapay zeka topluluğu içinde en heyecan verici ve iyi araştırılmış alanlardan biridir ve bilgisayar görüntüsü modellerinin hızlı şekilde geliştirilmesine rağmen, geliştiricileri hala zorlayan uzun süredir devam eden bir zorluk, görüntü animasyonudur. Bugün bile, görüntü animasyon çerçeveleri, doğal dinamikleri korurken orijinal görüntülerin görünümünü koruyarak statik görüntüleri karşılık gelen video karşılıklarına dönüştürmekte zorlanmaktadır. Geleneksel olarak, görüntü animasyon çerçeveleri, doğal sahneleri, insan saçları veya vücut hareketleri gibi alan özel hareketlerle veya sıvılar ve bulutlar gibi stokastik dinamikler gibi hareketlerle canlandırmaya odaklanmaktadır. Bu yaklaşım belirli bir ölçüde işe yarasa da, bu animasyon çerçevelerinin uygulanabilirliğini daha genel görsel içeriğe sınırlar.
Ayrıca, geleneksel görüntü animasyon yaklaşımları, osilasyonlu ve stokastik hareketlerin sentezlenmesine veya belirli nesne kategorileri için özelleştirilmeye odaklanmaktadır. Ancak, bu yaklaşımda, bu yöntemlere dayatılan güçlü varsayımların bir sonucu olarak, özellikle açık alan görüntü animasyonu gibi genel senaryolarda uygulanabilirliklerini sınırlayan önemli bir eksiklik vardır. Geçtiğimiz birkaç yıl içinde, Metinden Videoya veya T2V modelleri, metinsel promtlar kullanarak canlı ve çeşitli videolar oluşturmada önemli bir başarı göstermiştir ve bu, DynamiCrafter çerçevesinin temelini oluşturmaktadır.
DynamiCrafter çerçevesi, mevcut görüntü animasyon modellerinin sınırlamalarını aşmaya ve uygulanabilirliklerini açık dünya görüntüleri gibi genel senaryolara genişletmeye yönelik bir girişimdir. DynamiCrafter çerçevesi, açık alan görüntülerine dinamik içerik sentezlemeye ve bunları canlandırılmış videolara dönüştürmeye çalışır. DynamiCrafter’ın arkasındaki temel fikir, görüntü animasyonuna rehberlik etmek için önceden var olan metinden videoya difüzyon modellerinin hareket öncüllerini kullanmaya çalışmaktır. Verilen bir görüntü için, DynamiCrafter modeli önce bir sorgu dönüştürücüsünü uygular ve görüntüyü metinle uyumlu zengin bir bağlam temsil alanı içine projeler, böylece video modelinin görüntüdeki içeriği uyumlu bir şekilde sindirmesine olanak tanır. Ancak, DynamiCrafter modeli, sonuçta oluşan videolarda bazı görsel ayrıntıları korumakta hala zorlanmaktadır, bu sorun, DynamiCrafter modelinin, görüntüyü difüzyon modeline, başlangıç gürültüsüne ekleyerek ve modeli daha precisa görüntü bilgisi ile takviye ederek aşmaktadır.
Bu makale, DynamiCrafter çerçevesini derinlemesine ele almayı amaçlamaktadır ve mekanizmayı, metodolojiyi, mimarisi ve mevcut görüntü ve video oluşturma çerçeveleri ile karşılaştırmasını keşfedeceğiz. Şimdi başlayalım.
DynamiCrafter: Açık Alan Görsellerinin Animasyonu
Bir durağan görüntüyü canlandırmak, izleyici için ilgi çekici bir görsel deneyim sunar, çünkü durağan görüntüyü canlandırır. Geçtiğimiz yıllarda, birçok çerçevesi çeşitli yöntemler kullanarak durağan görüntüleri canlandırmaya çalışmıştır. İlk animasyon çerçeveleri, belirli nesnelerin hareketini simüle etmeye odaklanan fiziksel simülasyon tabanlı yaklaşımları uygulamıştır. Ancak, her nesne kategorisinin bağımsız olarak modellenmesi nedeniyle, bu yaklaşımlar ne etkili ne de genelgeçerdi. Daha gerçekçi hareketleri taklit etmek için, referans tabanlı yöntemler ortaya çıktı ve hareket veya görünüm bilgilerini, sentez过程ine aktardı. Referans tabanlı yaklaşımlar, simülasyon tabanlı yaklaşımlara kıyasla daha iyi sonuçlar verdi, ancak pratik uygulamalarını sınırlayan ek rehberlik gerektirdi.
Son yıllarda, çoğu animasyon çerçevesi, doğal sahneleri, stokastik, alan özel veya osilasyonlu hareketlerle canlandırmaya odaklanmaktadır. Bu yaklaşım belirli bir ölçüde işe yarasa da, bu çerçeveler tarafından üretilen sonuçlar tatmin edici değildir ve önemli ölçüde geliştirme alanı vardır. Geçtiğimiz birkaç yıl içinde, Metinden Videya veya T2V oluşturma modelleri, metinsel promtlar kullanarak canlı ve çeşitli videolar oluşturmada önemli bir başarı göstermiştir ve bu, DynamiCrafter çerçevesinin temelini oluşturmaktadır.
DynamiCrafter çerçevesinin temel fikri, Metinden Videya veya T2V difüzyon modellerinin video oluşturma sürecini yönetmek için koşullu bir görüntü dahil etmektir. Ancak, görüntü animasyonu hala zorlu bir görevdir, çünkü görüntü animasyonu, hem ayrıntı korunmasını hem de görsel bağlamların anlaşılmasını gerektirir. DynamiCrafter çerçevesi, video oluşturma sürecine görsel rehberlik sağlamak için bir çift akış enjeksiyon yaklaşımı önerir. Bu çift akış enjeksiyon yaklaşımı, DynamiCrafter çerçevesinin, video difüzyon modelinin, ayrıntı korunmuş dinamik içerik sentezlemesine olanak tanır.

Verilen bir görüntü için, DynamiCrafter çerçevesi önce görüntüyü, özel olarak tasarlanmış bir bağlam öğrenme ağı kullanarak, metinle uyumlu bir bağlam temsil alanı içine projeler. Daha spesifik olarak, bağlam temsil alanı, difüzyon modellerine adapte olmasını teşvik etmek için öğrenilebilen bir sorgu dönüştürücüsüne ve önceden eğitilmiş bir CLIP görüntü kodlayıcısına sahiptir. Model, sonra zengin bağlam özelliklerini, çapraz dikkat katmanları kullanarak kullanır ve metin özelliklerini, kapısal birleştirme kullanarak birleştirir. Bu yaklaşım, öğrenilen bağlam temsilini, metinle uyumlu görsel ayrıntılar ile takas eder, bu da görsel bağlamın anlaşılarak makul ve canlı dinamiklerin sentezlenmesine olanak tanır. Ayrıca, görsel ayrıntıları takviye etmek için, çerçevesi, görüntüyü, başlangıç gürültüsüne ekleyerek difüzyon modeline besler. Sonuç olarak, DynamiCrafter çerçevesinin çift enjeksiyon yaklaşımı, görsel uyumun yanı sıra inandırıcı dinamik içeriğin garantilenmesini sağlar.
Devam ederek, difüzyon modelleri veya DM’ler, Metinden Görüntüye veya T2I oluşturma görevinde önemli bir performans ve oluşturma yeteneği göstermiştir. T2I modellerinin başarısını video oluşturmaya aktarmak için, VDM veya Video Difüzyon Modelleri önerilmiştir ve bunlar, piksel uzayında düşük çözünürlüklü videoları modellemek için faktörleştirilmiş bir U-Yeni mimarisi kullanır. T2I çerçevelerinin öğrenimlerini T2V çerçevelerine aktarmak, eğitim maliyetlerini azaltmaya yardımcı olur. VDM veya Video Difüzyon Modelleri, yüksek kaliteli videolar oluşturabilir, ancak yalnızca metinsel promtları tek başına anlamsal rehberlik olarak kabul eder, bu da kullanıcıların gerçek niyetlerini yansıtmayabilir veya belirsiz olabilir. Ancak, çoğu VDM modelinin sonuçları, girişimdeki görüntüye nadiren uyumludur ve gerçekçi olmayan zamanlı varyasyon sorunuyla karşılaşmaktadır. DynamiCrafter yaklaşımı, metin koşullu Video Difüzyon Modelleri üzerine inşa edilmiştir ve görüntü animasyonu için zengin dinamik öncüllerini kullanır. Bunu, daha iyi anlamsal anlayış ve girişimdeki görüntüye uyum için özel tasarımlarla gerçekleştirir.
DynamiCrafter: Yöntem ve Mimarisi
Verilen bir durağan görüntü için, DynamiCrafter çerçevesi, görüntüyü videoya dönüştürmeye çalışır, yani kısa bir video klip üretir. Video klip, görüntünün görsel içeriğini miras alır ve doğal dinamikleri sergiler. Ancak, görüntü, resulting kare dizisinin任意 bir konumunda görünebilir. Bir görüntünün任意 bir konumda görünmesi, yüksek görsel uyum gereksinimleri olan görüntü koşullu video oluşturma görevlerinde özel bir zorluktur. DynamiCrafter çerçevesi, bu zorluğu, önceden eğitilmiş video difüzyon modellerinin oluşturma öncüllerini kullanarak aşar.
Video Difüzyon Öncülleri ile Görüntü Dinamikleri
Genel olarak, açık alan metinden videoya difüzyon modelleri, metin açıklamalarına bağlı olarak dinamik görsel içerikler sergiler. Bir durağan görüntüyü, Metinden Videya oluşturma öncüllerini kullanarak canlandırmak için, çerçeveler, video oluşturma sürecine görsel bilgilerin eksiksiz bir şekilde enjekte edilmesini sağlamalıdır. Ayrıca, dinamik sentez için, T2V modelinin görüntüyü bağlam anlaşılması için sindirmesi ve oluşturulan videolarda görsel ayrıntıları korumayı başarması gerekir.

Metinle Uyumlu Bağlam Temsili
Görüntü bağlamını video oluşturma sürecine rehberlik etmek için, DynamiCrafter çerçevesi, görüntüyü, video modelinin görüntü bilgilerini uyumlu bir şekilde kullanabileceği bir hizalanmış gömme uzayına projeler. Bunu takiben, DynamiCrafter çerçevesi, görüntü kodlayıcısını, girişimdeki görüntüden görüntü özelliklerini çıkarmak için kullanır, çünkü metin gömme, önceden eğitilmiş bir CLIP metin kodlayıcısı tarafından üretilir. Ancak, CLIP görüntü kodlayıcısından gelen global anlamsal tokenler, görüntü açıklamalarıyla hizalanmıştır, ancak esas olarak görsel içeriği anlamsal düzeyde temsil eder ve görüntünün tam kapsamını yakalamakta başarısız olur. DynamiCrafter çerçevesi, koşullu görüntü oluşturma görevlerinde yüksek sadakat gösteren görsel tokenleri, CLIP kodlayıcısının son katmanından alır. Ayrıca, çerçevesi, bağlam ve metin gömme arasındaki etkileşimi, çift çapraz dikkat katmanları kullanarak sağlar. Bu bileşenin tasarımı, modelin, katman bağımlı bir şekilde görüntü koşullarını emme yeteneğini sağlar. Ayrıca, U-Net mimarisinin ara katmanlarının, nesne duruşları veya şekilleri ile daha çok ilişkili olduğu dikkate alınarak, görüntü özelliklerinin, videonun görünümünü özellikle etkileyeceği beklenmektedir.
Görsel Ayrıntı Rehberliği
DynamiCrafter çerçevesi, video difüzyon modelinin, girişimdeki görüntüye benzeyen videolar üretmesine olanak tanıyan zengin-bilgilendirici bir bağlam temsilini kullanır. Ancak, aşağıdaki görüntüde gösterildiği gibi, oluşturulan içerik, önceden eğitilmiş CLIP kodlayıcısının, girişimdeki bilgileri tamamen koruma yeteneğinin sınırlı olması nedeniyle bazı tutarsızlıklar gösterebilir, çünkü dil ve görsel özellikler arasındaki uyumu sağlamak için tasarlanmıştır.

Görsel uyumu tăngtmak için, DynamiCrafter çerçevesi, video difüzyon modeline, girişimdeki görüntüden çıkarılan ek görsel ayrıntılar sağlamak önerir. Bunu başarmak için, DynamiCrafter modeli, koşullu görüntüyü, kare başına başlangıç gürültüsüne ekleyerek ve bunları difüzyon modelinin gürültü giderme U-Net bileşenine besleyerek, rehberlik sağlar.
Eğitim Paradigması
DynamiCrafter çerçevesi, koşullu görüntüyü, ayrıntı rehberliği ve bağlam kontrolü için tamamlayıcı iki akış aracılığıyla entegre eder. Bunu sağlamak için, DynamiCrafter modeli, üç adımlı bir eğitim süreci kullanır
- İlk adımda, model, görüntü bağlam temsil ağını eğitir.
- İkinci adımda, model, görüntü bağlam temsil ağını, Metinden Videya modeline adapte eder.
- Üçüncü ve son adımda, model, görüntü bağlam temsil ağını, Görsel Ayrıntı Rehberliği bileşeni ile birlikte iyileştirir.
Metinle uyumlu görsel ayrıntıları öğrenmek için, DynamiCrafter çerçevesi, görüntü bağlamını, Metinden Videya modeline uyumlu hale getirmek için bir bağlam temsil ağı geliştirmeyi önerir. Bu ağın, birçok optimizasyon adımına ihtiyacı olduğunu kabul ederek, yaklaşım, önce bağlam temsil ağını, daha basit bir Metinden Görüntüye veya T2I modeli kullanarak eğitmeyi içerir. Bu strateji, bağlam temsil ağına, Metinden Videya modeliyle birleştirilmeden önce görüntü bağlamı hakkında öğrenmeye odaklanmasını sağlar. DynamiCrafter çerçevesi, Metinden Videya modelinin mevcut zamanlı bilgilerini bozmadan performansını bozmadan ve ana hedefinden sapmadan, T2V modelinin uzaysal katmanlarıyla birlikte bağlam temsil ağını ve Görsel Ayrıntı Rehberliği bileşenini, girişimdeki görüntüyü kare başına gürültüye ekleyerek iyileştirir. Bu yöntem, T2V modelinin zamanlı bilgilerinin bütünlüğünü korur ve yoğun görüntü birleştirmesinin performansını bozmaktan kaçınır.
DynamiCrafter: Deneyler ve Sonuçlar
DynamiCrafter çerçevesi, önce bağlam temsil ağını ve görüntü çapraz dikkat katmanlarını Stable Diffusion üzerinde eğitir. Çerçevesi, sonra Stable Diffusion bileşenini VideoCrafter ile değiştirir ve bağlam temsil ağını ve uzaysal katmanları, uyarlama ve görüntü birleştirmesi için daha da iyileştirir. Çıktıda, çerçevesi, DDIM örnekleyiciyi, çoklu koşullu sınıfsız rehberlik ile benimser. Ayrıca, sentezlenen videoların zamanlı tutarlılığını ve kalitesini, hem zamanlı hem de uzaysal alanlarda değerlendirmek için, çerçevesi, FVD veya Frechet Video Mesafesi ve KVD veya Çekirdek Video Mesafesi raporlar ve MSR-VTT ve UCF-101 benchmarklerinin tüm yöntemlerinde sıfır-shot performansı değerlendirir. Oluşturulan sonuçların, girişimdeki görüntüye algısal uyumu araştırmak için, çerçevesi, PIC veya Algısal Girişim Uyumunu tanıtır ve algısal mesafe ölçütü DreamSim’i, mesafe fonksiyonu olarak benimser.
Aşağıdaki şekil, farklı stiller ve içeriklerle oluşturulan canlandırılmış içeriğin görsel karşılaştırmasını gösterir.

Görüldüğü gibi, farklı yöntemler arasında, DynamiCrafter çerçevesi, girişimdeki görüntüye iyi uyumluluk gösterir ve zamanlı olarak tutarlı videolar üretir. Aşağıdaki tablo, 49 katılımcılı bir kullanıcı çalışmasının, Zamanlı Tutarlılık (T.C), Hareket Kalitesi (M.C) ve Görsel Uyum (I.C) için tercih oranının istatistiklerini içerir. Görüldüğü gibi, DynamiCrafter çerçevesi, mevcut yöntemleri önemli bir marj ile aşmaktadır.

Aşağıdaki şekil, çift akış enjeksiyon yöntemi ve eğitim paradigması ile elde edilen sonuçları gösterir.

Son Düşünceler
Bu makalede, DynamiCrafter’i, mevcut görüntü animasyon modellerinin sınırlamalarını aşmaya ve uygulanabilirliklerini açık dünya görüntüleri gibi genel senaryolara genişletmeye yönelik bir girişim olarak ele aldık. DynamiCrafter çerçevesi, açık alan görüntülerine dinamik içerik sentezlemeye ve bunları canlandırılmış videolara dönüştürmeye çalışır. DynamiCrafter’ın arkasındaki temel fikir, görüntü animasyonuna rehberlik etmek için önceden var olan metinden videya difüzyon modellerinin hareket öncüllerini kullanmaya çalışmaktır. Verilen bir görüntü için, DynamiCrafter modeli önce bir sorgu dönüştürücüsünü uygular ve görüntüyü metinle uyumlu zengin bir bağlam temsil alanı içine projeler, böylece video modelinin görüntüdeki içeriği uyumlu bir şekilde sindirmesine olanak tanır. Ancak, DynamiCrafter modeli, sonuçta oluşan videolarda bazı görsel ayrıntıları korumakta hala zorlanmaktadır, bu sorun, DynamiCrafter modelinin, görüntüyü difüzyon modeline, başlangıç gürültüsüne ekleyerek ve modeli daha precisa görüntü bilgisi ile takviye ederek aşmaktadır.


