
Tankeledare
Tre sekretessbevarande maskinlärningstekniker som löser detta årtions viktigaste fråga

 Lägg till Unite.AI bland dina föredragna källor på Google
Av Amogh Tarcar, maskinlärnings- och AI-forskare, Persistent Systems. (PERSISTENT.BO )
Datasekretess, enligt experter inom en bred range av områden, kommer att vara det viktigaste ämnet under detta årtionde. Detta är särskilt sant för maskinlärning (ML) där algoritmer matas med stora mängder data.
Traditionellt har ML-modelleringstekniker förlitat sig på att centralisera data från flera källor till ett enda datacenter. Efter allt, ML-modeller är som mest kraftfulla när de har tillgång till stora mängder data. Men, det finns en mängd sekretessutmaningar som följer med denna teknik. Att samla in diversifierad data från flera källor är mindre möjligt idag på grund av regulatoriska problem som HIPAA, GDPR och CCPA. Dessutom ökar centraliseringen av data omfattningen och omfattningen av datamissbruk och säkerhetshot i form av dataläckor.
För att övervinna dessa utmaningar har flera pelare för sekretessbevarande maskinlärning (PPML) utvecklats med specifika tekniker som minskar sekretessrisken och säkerställer att data förblir rimligt säkra. Här är några av de viktigaste:
1. Federerad inlärning
Federerad inlärning är en ML-träningsmetod som vänder den traditionella dataaggregeringsproblematiken på huvudet. Istället för att aggregera data för att skapa en enda ML-modell, aggregerar federerad inlärning själva ML-modellerna. Detta säkerställer att data aldrig lämnar sin källplats, och det tillåter flera parter att samarbeta och bygga en gemensam ML-modell utan att direkt dela känslig data.
Det fungerar så här. Du börjar med en bas-ML-modell som sedan delas med varje klientnod. Dessa noder kör sedan lokal träning på denna modell med hjälp av sin egen data. Modelluppdateringar delas periodiskt med koordinatornoden, som bearbetar dessa uppdateringar och fusionerar dem för att få en ny global modell. På detta sätt får du insikter från diversifierade datamängder utan att behöva dela dessa datamängder.

Källa: Persistent Systems
I sjukvårdssammanhang är detta ett otroligt kraftfullt och sekretessmedvetet verktyg för att hålla patientdata säkra samtidigt som forskare får insikt i massan. Genom att inte aggregera data skapar federerad inlärning en extra säkerhetslager. Men modellerna och modelluppdateringarna i sig presenterar fortfarande ett säkerhetsrisk om de lämnas sårbara.
2. Differensialsekretess
ML-modeller är ofta måltavlor för medlemsinferencesattacker. Säg att du delade din hälsoinformation med ett sjukhus för att hjälpa till att utveckla ett vaccin mot cancer. Sjukhuset håller din information säker, men använder federerad inlärning för att träna en offentligt tillgänglig ML-modell. Några månader senare använder hackare en medlemsinferencesattack för att avgöra om din data användes i modellens träning eller inte. De delar sedan insikter med ett försäkringsbolag, som, baserat på din cancerrisk, kan höja dina premier.
Differensialsekretess säkerställer att motståndarattacker på ML-modeller inte kan identifiera specifika datapunkter som användes under träningen, vilket minskar risken för att exponera känslig träningsdata i maskinlärning. Detta görs genom att applicera “statistiskt brus” för att störa data eller ML-modellparametrarna under träning, vilket gör det svårt att köra attacker och avgöra om en specifik persons data användes för att träna modellen.
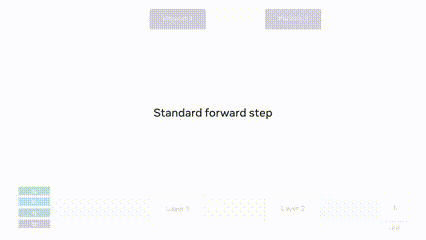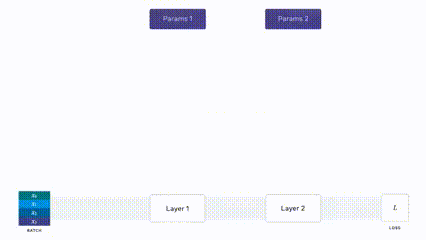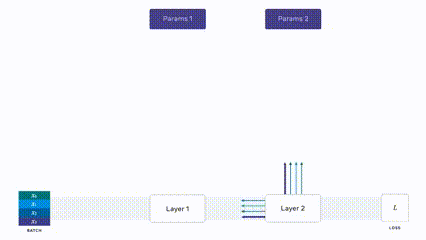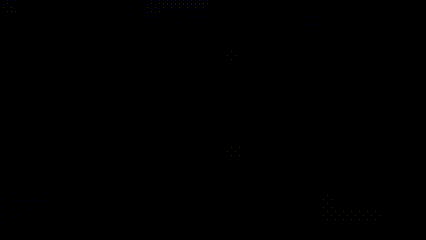
Till exempel släppte Facebook nyligen Opacus, en höghastighetsbibliotek för att träna PyTorch-modeller med hjälp av en differensialsekretessbaserad maskinlärningsalgoritm som kallas Differentially Private Stochastic Gradient Descent (DP-SGD). Gifen nedan visar hur det använder brus för att maskera data.
Källa: Facebooks Opacus-blogg
Detta brus styrs av en parameter som kallas Epsilon. Om Epsilon-värdet är lågt, har modellen perfekt datasekretess men dålig nytta och precision. Omvänt, om du har ett högt Epsilon-värde, kommer din datasekretess att minska medan din precision ökar. Knepet är att hitta en balans för att optimera för båda.
3. Homomorft krypterings
Standardkryptering är traditionellt oförenlig med maskinlärning eftersom data inte längre kan förstås av ML-algoritmen när den är krypterad. Men homomorft krypterings är en speciell krypteringsschema som tillåter oss att fortsätta att göra vissa typer av beräkningar.

Källa: OpenMined
Kraften i detta är att träningen kan ske i ett helt krypterat utrymme. Det skyddar inte bara dataägare, utan också modellägare. Modellägaren kan köra inferens på krypterad data utan att någonsin se den eller missbruka den.
När det appliceras på federerad inlärning kan fusionen av modelluppdateringar ske säkert eftersom de sker i ett helt krypterat miljö, vilket drastiskt minskar risken för medlemsinferencesattacker.
Årtiondet för sekretess
När vi går in i 2021 är sekretessbevarande maskinlärning ett nytt och aktivt forskningsområde. Om det senaste årtiondet handlade om att bryta ner dataisolering, kommer detta årtionde att handla om att bryta ner ML-modeller samtidigt som sekretessen för den underliggande data skyddas via federerad inlärning, differensialsekretess och homomorft krypterings. Dessa presenterar ett lovande nytt sätt att främja maskinlärningslösningar på ett sekretessmedvetet sätt. Det senaste årtiondet handlade om att bryta ner dataisolering, men detta årtionde kommer att handla om att bryta ner ML-modeller samtidigt som sekretessen för den underliggande data skyddas via federerad inlärning, differensialsekretess och homomorft krypterings. Dessa presenterar ett lovande nytt sätt att främja maskinlärningslösningar på ett sekretessmedvetet sätt.


