
Andersons vinkel
Tre utmaningar framför Stable Diffusion

 Lägg till Unite.AI bland dina föredragna källor på Google
Släppandet av stability.ai:s Stable Diffusion latent diffusion bildsynthesmodell för ett par veckor sedan kan vara en av de mest betydande tekniska avslöjandena sedan DeCSS 1999; det är definitivt den största händelsen inom AI-genererad bild sedan 2017 deepfakes-kod kopierades till GitHub och grenades till vad som skulle bli DeepFaceLab och FaceSwap, samt realtidsströmmande deepfake-mjukvara DeepFaceLive.
Med ett slag försvann användarirritation över innehållsbegränsningar i DALL-E 2:s bildsynthes-API, eftersom det visade sig att Stable Diffusions NSFW-filter kunde inaktiveras genom att ändra en endaste kodrad. Pornocentrerade Stable Diffusion-Reddit-grupper uppstod nästan omedelbart, och avskaffades lika snabbt, medan utvecklare och användare delade upp sig i Discord i officiella och NSFW-samhällen, och Twitter började fyllas med fantastiska Stable Diffusion-skapelser.
För tillfället verkar varje dag bringa någon otrolig innovation från utvecklare som har antagit systemet, med tillägg och tredjeparts-tillägg som hastigt skrivs för Krita, Photoshop, Cinema4D, Blender och många andra applikationsplattformar.
Under tiden har promptcraft – den nu professionella konsten att “viska till AI”, som kan bli den kortaste karriärvalmöjligheten sedan “Filofax-bindare” – redan börjat kommersialiseras, medan tidig monetisering av Stable Diffusion sker på Patreon-nivå, med säkerhet för mer avancerade erbjudanden som kommer, för de som inte vill navigera Conda-baserade installationer av källkoden, eller de proskriptiva NSFW-filtrarna i webbaserade implementationer.
Utvecklingstakten och den fria känslan av utforskning från användare sker i sådan snabb takt att det är svårt att se långt framåt. I princip vet vi inte riktigt vad vi har att göra med ännu, eller vad alla begränsningar eller möjligheter kan vara.
Ändå, låt oss ta en titt på tre av vad som kan vara de mest intressanta och utmanande hinder för den snabbt bildade och snabbt växande Stable Diffusion-gemenskapen att möta och, hoppas vi, övervinna.
1: Optimering av tile-baserade rörledningar
När de presenteras med begränsade hårdvaruresurser och hårda gränser för upplösningen av träningsbilder, verkar det troligt att utvecklare kommer att hitta lösningar för att förbättra både kvaliteten och upplösningen av Stable Diffusions utdata. Många av dessa projekt kommer att involvera att utnyttja begränsningarna i systemet, som dess ursprungliga upplösning på endast 512×512 pixlar.
Som alltid är fallet med datorseende och bildsynthes-initiativ, tränades Stable Diffusion på kvadratiska förhållanden, i detta fall omproverade till 512×512, så att källbilderna kunde regulariseras och anpassas till begränsningarna i GPU:erna som tränade modellen.
Därför “tänker” (om den tänker alls) Stable Diffusion i 512×512-termer, och definitivt i kvadratiska termer. Många användare som för närvarande provar gränserna för systemet rapporterar att Stable Diffusion producerar de mest tillförlitliga och minst glittriga resultaten vid denna ganska begränsade aspektförhållande (se “adressering av extremiteter” nedan).
Även om olika implementationer har uppskalning via RealESRGAN (och kan fixa dåligt renderade ansikten via GFPGAN) utvecklar flera användare metoder för att dela upp bilder i 512x512px-sektioner och sy ihop bilderna för att bilda större sammansatta verk.

Denna 1024×576-rendering, en upplösning som vanligtvis är omöjlig i en enda Stable Diffusion-rendering, skapades genom att kopiera och klistra in attention.py Python-filen från DoggettX-grenen av Stable Diffusion (en version som implementerar tile-baserad uppskalning) till en annan gren. Källa: https://old.reddit.com/r/StableDiffusion/comments/x6yeam/1024x576_with_6gb_nice/
Även om vissa initiativ av detta slag använder ursprunglig kod eller andra bibliotek, kommer txt2imghd-porten av GOBIG (en läge i VRAM-hungriga ProgRockDiffusion) att tillhandahålla denna funktion till huvudgrenen snart. Medan txt2imghd är en dedikerad port av GOBIG, involverar andra ansträngningar från community-utvecklare olika implementationer av GOBIG.

En bekvämt abstrakt bild i den ursprungliga 512x512px-renderingen (vänster och andra från vänster); uppskalad med ESGRAN, som nu är mer eller mindre införd i alla Stable Diffusion-distributioner; och gavs ‘särskild uppmärksamhet’ via en implementation av GOBIG, som producerar detaljer som, åtminstone inom ramen för bildsektionen, verkar bättre uppskalade. Källa: https://old.reddit.com/r/StableDiffusion/comments/x72460/stable_diffusion_gobig_txt2imghd_easy_mode_colab/
Denna typ av abstrakt exempel som visas ovan har många “lilla kungariken” av detaljer som passar denna solipsistiska tillvägagångssätt för uppskalning, men som kan kräva mer utmanande koddrivna lösningar för att producera icke-repetitiv, sammanhängande uppskalning som inte ser ut som om den satts samman från många delar. Inte minst i fallet med mänskliga ansikten, där vi är ovanligt känsliga för avvikelser eller “störande” artefakter. Därför kan ansikten så småningom behöva en dedikerad lösning.
Stable Diffusion har för närvarande inget mekanism för att fokusera uppmärksamhet på ansiktet under en rendering på samma sätt som människor prioriterar ansiktsinformation. Även om vissa utvecklare i Discord-samhällena överväger metoder för att implementera denna typ av “förbättrad uppmärksamhet”, är det för närvarande mycket enklare att manuellt (och, så småningom, automatiskt) förbättra ansiktet efter att den ursprungliga renderingen har ägt rum.
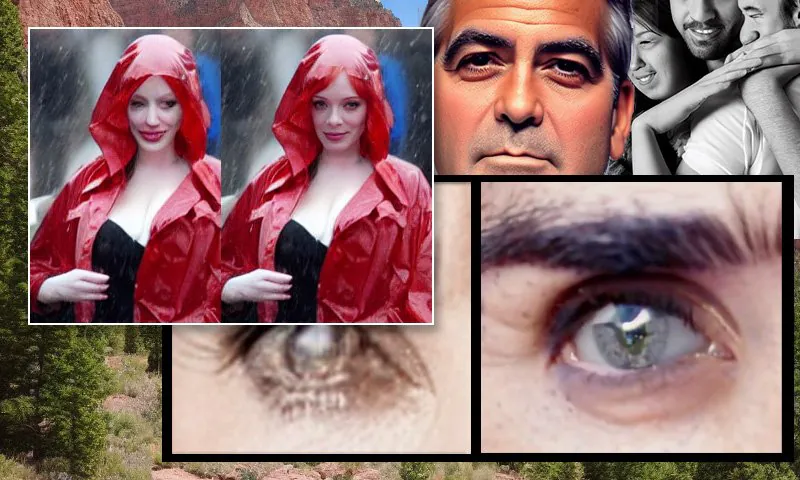
Ett mänskligt ansikte har en inre och fullständig semantisk logik som inte kommer att hittas i en “tile” av bottenhörnet av (till exempel) en byggnad, och därför är det för närvarande möjligt att mycket effektivt “zooma in” och återge ett “skissartat” ansikte i Stable Diffusions utdata.

Vänster, Stable Diffusions ursprungliga försök med prompten ‘Full-length färgfoto av Christina Hendricks som går in i en trång plats, bär en regnrock; Canon50, ögonkontakt, hög detalj, hög ansiktsdetalj’. Höger, ett förbättrat ansikte som erhållits genom att mata in det suddiga och skissartade ansiktet från den första renderingen tillbaka till Stable Diffusions fulla uppmärksamhet med hjälp av Img2Img (se animerade bilder nedan).
I avsaknad av en dedikerad Textual Inversion-lösning (se nedan), kommer detta endast att fungera för kändisbilder där personen i fråga redan är väl representerad i LAION-databasen som tränade Stable Diffusion. Därför kommer det att fungera på personer som Tom Cruise, Brad Pitt, Jennifer Lawrence och en begränsad mängd riktiga mediepersonligheter som finns i stora mängder av bilder i källdata.
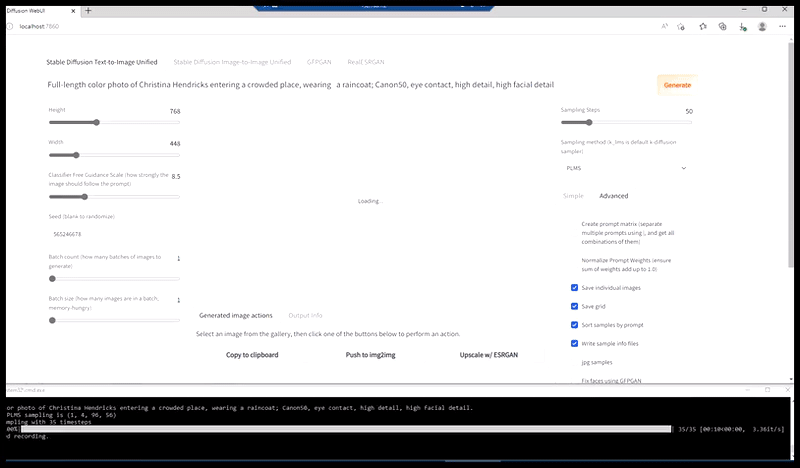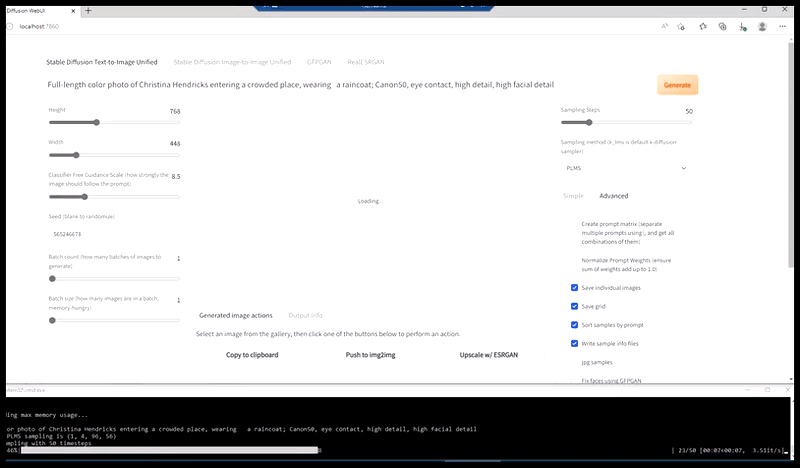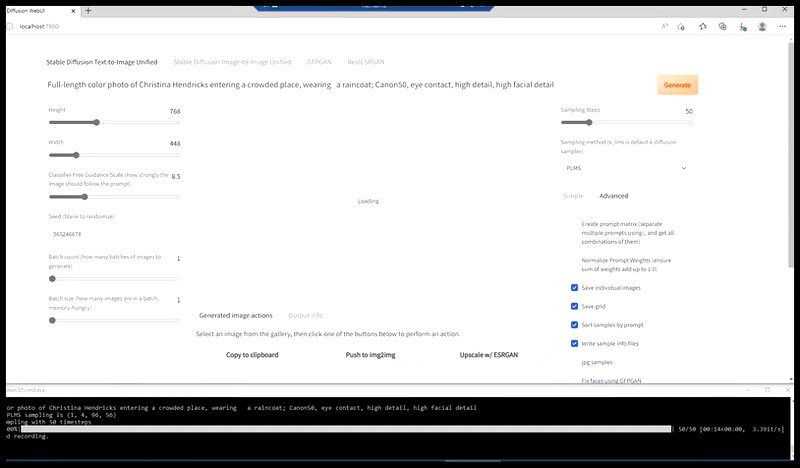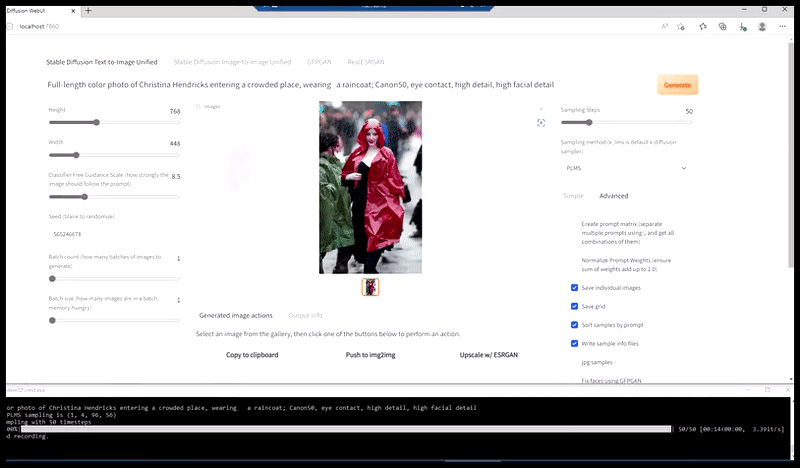
Genererar ett trovärdigt pressfoto med prompten ‘Full-length färgfoto av Christina Hendricks som går in i en trång plats, bär en regnrock; Canon50, ögonkontakt, hög detalj, hög ansiktsdetalj’.
För kändisar med långa och bestående karriärer, kommer Stable Diffusion vanligtvis att generera en bild av personen vid en senare (dvs. äldre) ålder, och det kommer att vara nödvändigt att lägga till prompt-tillägg som ‘ung’ eller ‘under året [ÅR]’ för att producera yngre utseende bilder.

Med en framträdande, väl fotograferad och konsekvent karriär som sträcker sig nästan 40 år, är skådespelerskan Jennifer Connelly en av de få kändisar i LAION som tillåter Stable Diffusion att representera ett urval av åldrar. Källa: prepack Stable Diffusion, lokal, v1.4 checkpoint; åldersrelaterade promptrar.
Detta beror till stor del på spridningen av digital (snarare än dyra, emulsionsbaserade) pressfotografering från mitten av 2000-talet, och den senare tillväxten i volymen av bildutdata på grund av ökade bredbandshastigheter.
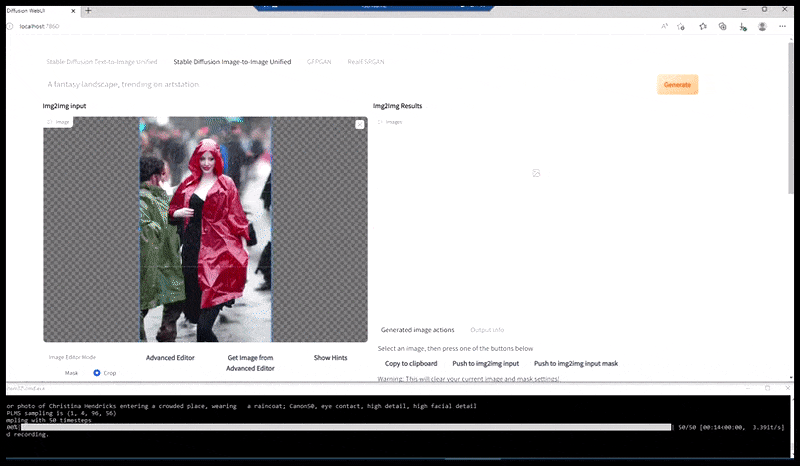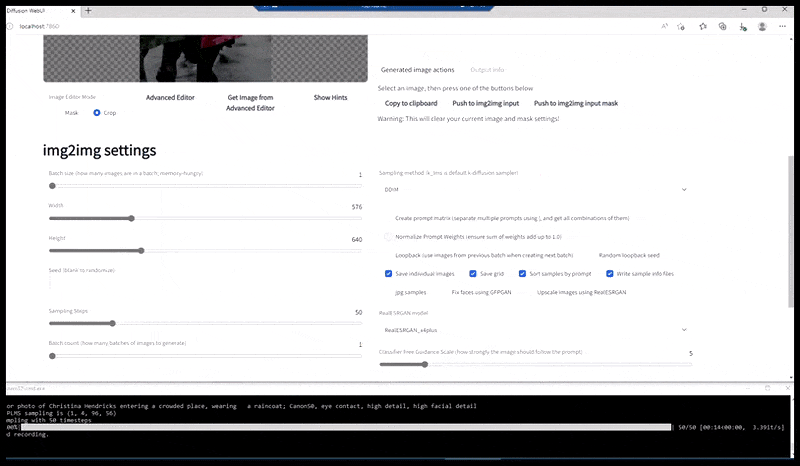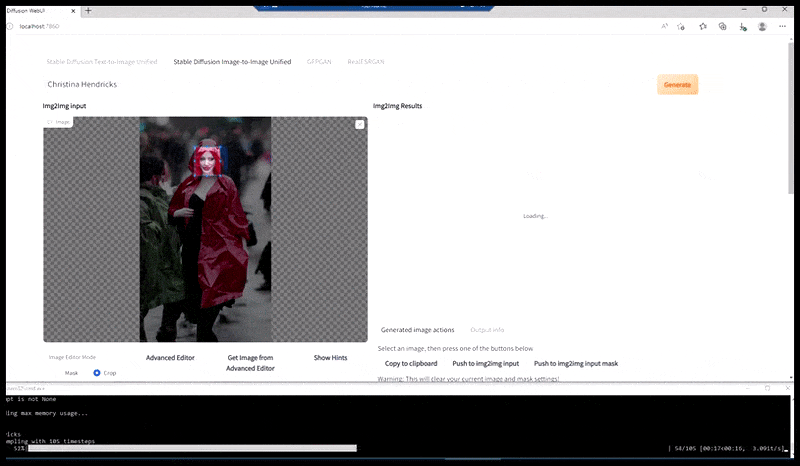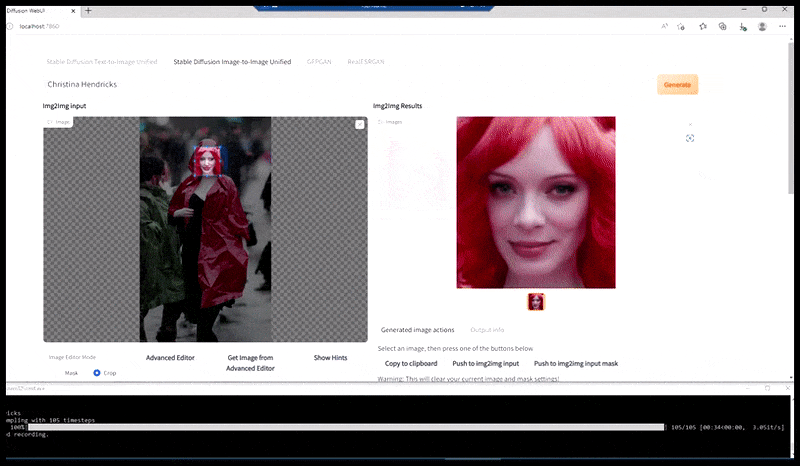
Den renderade bilden skickas vidare till Img2Img i Stable Diffusion, där ett ‘fokusområde’ väljs, och en ny, maximalt stor rendering görs endast av det området, vilket tillåter Stable Diffusion att koncentrera alla tillgängliga resurser på att återskapa ansiktet.
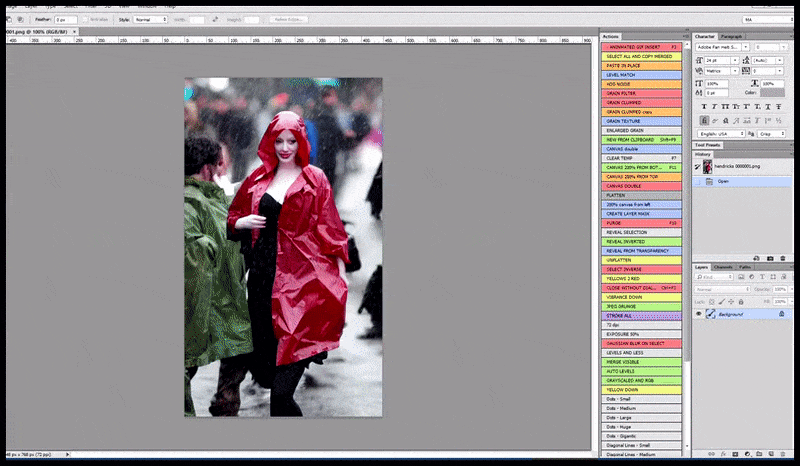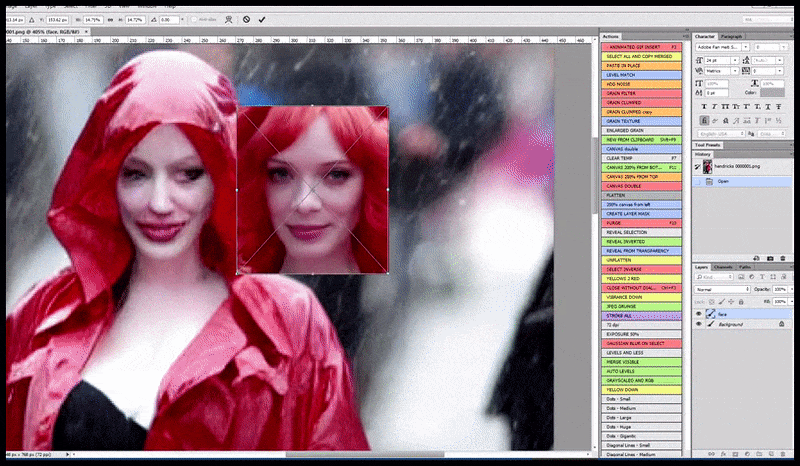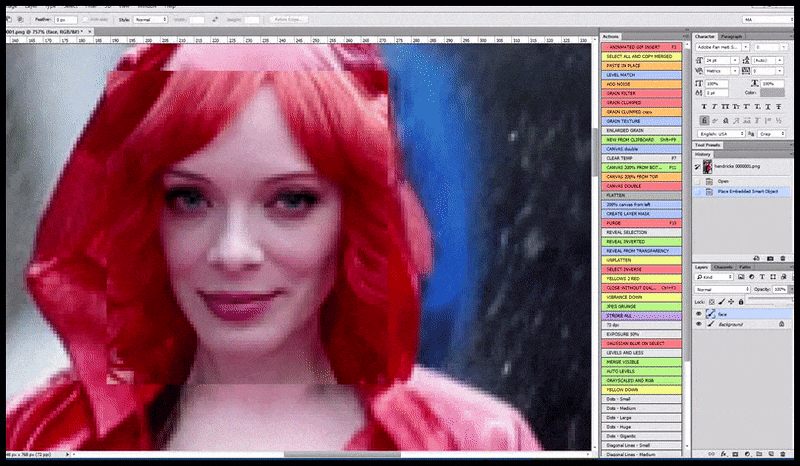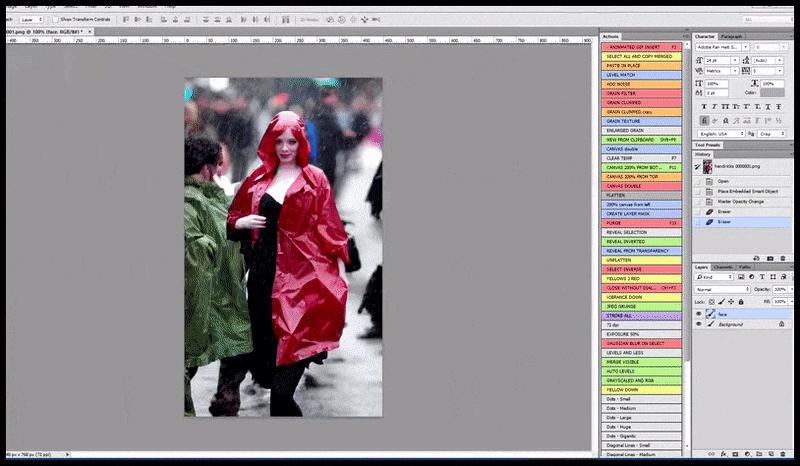
Komponerar ‘hög uppmärksamhet’-ansiktet tillbaka till den ursprungliga renderingen. Förutom ansikten, kommer denna process endast att fungera med entiteter som har en potentiell känd, sammanhängande och integral utseende, såsom en del av den ursprungliga bilden som har ett distinkt föremål, som en klocka eller en bil. Uppskalning av en sektion av – till exempel – en vägg kommer att leda till en mycket konstig utseende återmonterad vägg, eftersom tile-renderingarna inte hade någon bredare kontext för denna ‘pusselbit’ medan de renderades.
Vissa kändisar i databasen kommer ‘förfrusna’ i tiden, antingen för att de dog tidigt (såsom Marilyn Monroe), eller steg upp till bara flyktig mainstream-popularitet, producerande en hög volym av bilder under en begränsad tid. Avläsning av Stable Diffusion ger troligen en sorts ‘nuvarande’ popularitetsindex för moderna och äldre stjärnor. För vissa äldre och nuvarande kändisar, finns det inte tillräckligt med bilder i källdata för att få en mycket bra likhet, medan den bestående populariteten hos vissa långlivade eller utdöda stjärnor säkerställer att deras rimliga likhet kan erhållas från systemet.

Stable Diffusions renderingar avslöjar snabbt vilka kända ansikten som är väl representerade i träningsdata. Trots hennes enorma popularitet som en äldre tonåring vid tidpunkten för skrivande, var Millie Bobby Brown yngre och mindre känd när LAION-käll-databaserna skrapades från webben, vilket gör det problematiskt att få en högkvalitativ likhet med Stable Diffusion för tillfället.
Där data är tillgänglig, kan tile-baserade up-res-lösningar i Stable Diffusion gå längre än att fokusera på ansiktet: de kan potentiellt möjliggöra ännu mer exakta och detaljerade ansikten genom att bryta ner ansiktsdragen och vända hela kraften av lokala GPU-resurser på framträdande funktioner individuellt, före återmontering – en process som för närvarande, igen, är manuell.

Detta är inte begränsat till ansikten, men det är begränsat till delar av föremål som är minst lika förutsägbart placerade i den bredare kontexten av värdobjektet, och som följer högnivå-inbäddningar som man rimligen kan förvänta sig att hitta i en hyperskale-databas.
Den verkliga gränsen är mängden tillgänglig referensdata i databasen, eftersom, till slut, djupt itererad detalj kommer att bli helt “hallucinerad” (dvs. fiktiv) och mindre autentisk.
Sådana högnivå-granulära förstoringar fungerar i fallet med Jennifer Connelly, eftersom hon är väl representerad över ett urval av åldrar i LAION-aesthetics (den primära undermängden av LAION 5B som Stable Diffusion använder), och generellt över LAION; i många andra fall skulle exaktheten lida av brist på data, vilket skulle kräva antingen finjustering (ytterligare utbildning, se “Anpassning” nedan) eller Textual Inversion (se nedan).
Tiles är ett kraftfullt och relativt billigt sätt för Stable Diffusion att kunna producera högupplösta utdata, men algoritmisk tile-uppskalning av detta slag, om den saknar någon form av bredare, högre nivå-uppmärksamhetsmekanism, kan komma att understiga de förväntade standarderna över ett urval av innehållstyper.
2: Att hantera problem med mänskliga lemmar
Stable Diffusion lever inte upp till sitt namn när det gäller att avbilda komplexiteten hos mänskliga extremiteter. Händer kan multipliceras slumpmässigt, fingrar koalescerar, en tredje ben dyker upp oförklarligt, och existerande lemmar försvinner spårlöst. I sin försvar, delar Stable Diffusion problemet med sina stabila medlemmar, och mestadels med DALL-E 2.

Oredigerade resultat från DALL-E 2 och Stable Diffusion (1.4) i slutet av augusti 2022, båda visar problem med lemmar. Prompt är ‘En kvinna omfamnar en man’
Stable Diffusion-entusiaster som hoppas att den kommande 1.5-checkpointen (en mer intensivt tränad version av modellen, med förbättrade parametrar) skulle lösa lemm-konfusionen kommer troligen att bli besvikna. Den nya modellen, som kommer att släppas om ungefär två veckor, visas för närvarande på den kommersiella stability.ai-portalen DreamStudio, där användare kan jämföra den nya utdatan med renderingar från deras lokala eller andra 1.4-system:

Källa: Lokal 1.4 prepack och https://beta.dreamstudio.ai/

Källa: Lokal 1.4 prepack och https://beta.dreamstudio.ai/

Källa: Lokal 1.4 prepack och https://beta.dreamstudio.ai/
Som ofta är fallet, kan datakvalitet vara den primära bidragande orsaken.
De öppna käll-databaserna som bränslar bildsynthes-system som Stable Diffusion och DALL-E 2 kan tillhandahålla många etiketter för både enskilda människor och inter-mänsklig handling. Dessa etiketter tränas in symbiotiskt med deras associerade bilder, eller segment av bilder.

Stable Diffusion-användare kan utforska koncepten som tränats in i modellen genom att fråga LAION-aesthetics-databasen, en undermängd av den större LAION 5B-databasen, som driver systemet. Bilderna är ordnade inte efter deras alfabetiska etiketter, utan efter deras ‘estetiska poäng’. Källa: https://rom1504.github.io/clip-retrieval/
En bra hierarki av individuella etiketter och klasser som bidrar till avbildningen av en mänsklig arm skulle vara något som kropp>arm>hand>fingrar>[underdelar + tumme]> [fingralsegment]>Fingernaglar.

Granulär semantisk segmentering av handens delar. Även denna ovanligt detaljerade dekonstruktion lämnar varje ‘finger’ som en ensam enhet, utan att ta hänsyn till de tre sektionerna av en finger och de två sektionerna av en tumme. Källa: https://athitsos.utasites.cloud/publications/rezaei_petra2021.pdf
I verkligheten är det osannolikt att källbilderna är så konsekvent annoterade över hela databasen, och ostrukturerade etiketteringsalgoritmer kommer troligen att sluta vid den högre nivån – till exempel ‘hand’, och lämna de inre pixlarna (som tekniskt sett innehåller ‘finger’-information) som en oetiketterad massa pixlar, från vilka funktioner kommer att arbiträrt härledas, och som kan manifestera sig i senare renderingar som en störande faktor.

Hur det borde vara (övre höger, om inte övre skuren), och hur det tenderar att vara (nedre höger), på grund av begränsade resurser för etikettering, eller arkitektonisk exploatering av sådana etiketter om de finns i databasen.
Således, om en latent diffusionsmodell kommer så långt som att rendera en arm, kommer den nästan säkert att försöka rendera en hand i slutet av den armen, eftersom arm>hand är den minimala krävda hierarkin, ganska högt upp i vad arkitekturen vet om ‘mänsklig anatomi’.
Efter det kan ‘fingrar’ vara den minsta grupperingen, även om det finns 14 ytterligare finger/tumme-underdelar att överväga när man avbildar mänskliga händer.
Om denna teori håller, finns det ingen verklig lösning, på grund av den sektoriella bristen på budget för manuell etikettering, och bristen på tillräckligt effektiva algoritmer som kunde automatisera etikettering medan de producerar låga felrater. I effekt, kan modellen för närvarande förlita sig på mänsklig anatomisk konsekvens för att täcka över bristerna i databasen den tränades på.
En möjlig anledning till att den inte kan förlita sig på detta, nyligen föreslagen på Stable Diffusion Discord, är att modellen kan bli förvirrad över det korrekta antalet fingrar en (realistisk) mänsklig hand bör ha, eftersom LAION-derivatdatabasen som driver den innehåller tecknade figurer som kan ha färre fingrar (vilket i sig är en arbetsbesparande genväg).

Två av de potentiella bovarna i ‘saknad finger’-syndromet i Stable Diffusion och liknande modeller. Nedan, exempel på tecknade händer från LAION-aesthetics-databasen som driver Stable Diffusion. Källa: https://www.youtube.com/watch?v=0QZFQ3gbd6I
Om detta är sant, då är den enda uppenbara lösningen att omträna modellen, med undantag för icke-realistiskt mänskligt innehåll, för att säkerställa att äkta fall av utelämnande (dvs. amputerade personer) är lämpligt etiketterade som undantag. Från ett datakureringssynpunkt, skulle detta vara en ganska stor utmaning, särskilt för resurs-svaga community-insatser.
Den andra tillvägagångssättet vore att tillämpa filter som utesluter sådant innehåll (t.ex. ‘hand med tre/fem fingrar’) från att manifestera sig vid render-tid, på samma sätt som OpenAI har, till viss del, filtrerat GPT-3 och DALL-E 2, så att deras utdata kunde regleras utan att behöva omträna källmodellerna.

För Stable Diffusion, kan den semantiska distinktionen mellan fingrar och till och med lemmar bli fruktansvärt suddig, och påminner om 1980-talets ‘body horror’-sträng av skräckfilmer från liknande David Cronenberg. Källa: https://old.reddit.com/r/StableDiffusion/comments/x6htf6/a_study_of_stable_diffusions_strange_relationship/
Det kan hävdas att det finns två återstående vägar framåt: att kasta mer data på problemet, och att tillämpa tredjeparts-tolkande system som kan ingripa när fysiska fel av den typ som beskrivs här presenteras för slutanvändaren (åtminstone skulle den senare ge OpenAI en metod för att tillhandahålla återbetalningar för ‘body horror’-renderingar, om företaget var motiverat att göra så).
3: Anpassning
En av de mest spännande möjligheterna för framtiden för Stable Diffusion är utsikten till att användare eller organisationer utvecklar reviderade system; modifieringar som tillåter innehåll utanför den förtränade LAION-sfären att integreras i systemet – idealiskt utan den ohanterliga kostnaden för att träna hela modellen igen, eller risken som är involverad när man tränar en stor mängd nytt innehåll till en befintlig, mogen och kapabel modell.
Genom analogi: om två mindre begåvade studenter ansluter sig till en avancerad klass på trettio studenter, kommer de antingen att assimileras och komma ikapp, eller misslyckas som utbrytare; i båda fallen kommer klassens genomsnittliga prestation troligen inte att påverkas. Om femton mindre begåvade studenter ansluter sig, kommer dock klassens betygs kurva att troligen lida.
På samma sätt kan den synergistiska och ganska ömtåliga nätverken av relationer som byggs upp under långvarig och kostsam modellträning komprometteras, i vissa fall effektivt förstöras, av alltför mycket ny data, vilket sänker modellens utdatakvalitet över hela linjen.
Fallet för att göra detta är primärt där ditt intresse ligger i att helt kidnappa modellens konceptuella förståelse av relationer och saker, och anpassa den för exklusiv produktion av innehåll som liknar det tilläggsmaterial som du lade till.
Således, att träna 500 000 Simpsons-rutor i en befintlig Stable Diffusion-checkpoint är troligen, så småningom, att få en bättre Simpsons-simulator än den ursprungliga byggnaden kunde ha erbjudit, under förutsättning att tillräckligt många breda semantiska relationer överlever processen (t.ex. Homer Simpson äter en hotdog, som kan kräva material om hotdogs som inte fanns i ditt tilläggsmaterial, men som redan fanns i checkpointen), och under förutsättning att du inte plötsligt vill växla från Simpsons-innehåll till att skapa fabulous landscape by Greg Rutkowski – eftersom din post-tränade modell har fått sin uppmärksamhet massivt avled, och inte kommer att vara lika bra på att göra den typen av sak som den använde att vara.
En anmärkningsvärd exempel på detta är waifu-diffusion, som har lyckats post-träna 56 000 anime-bilder i en färdigtränad och tränad Stable Diffusion-checkpoint. Det är ett tufft perspektiv för en hobbyist, eftersom modellen kräver en ögonblicksbild på minst 30 GB VRAM, långt bortom vad som troligen kommer att finnas tillgängligt på konsumentnivån i Nvidias kommande 40XX-serieutgåvor.

Träning av anpassat innehåll i Stable Diffusion via waifu-diffusion: modellen tog två veckor av post-träning för att producera den här nivån av illustration. De sex bilderna till vänster visar modellens framsteg, allteftersom träningen fortskred, i att skapa ämneskoherent utdata baserat på de nya träningsdata. Källa: https://gigazine.net/gsc_news/en/20220121-how-waifu-labs-create/
En stor mängd ansträngning kan läggas på sådana ‘grenar’ av Stable Diffusion-checkpoints, endast för att bli hämmad av teknisk skuld. Utvecklare på den officiella Discord-kanalen har redan indikerat att senare checkpoint-utgåvor inte nödvändigtvis kommer att vara bakåtkompatibla, även med prompt-logik som kan ha fungerat med en tidigare version, eftersom deras primära intresse är att få den bästa modellen möjlig, snarare än att stödja äldre applikationer och processer.
Därför, om en företag eller person bestämmer sig för att grenra en checkpoint till en kommersiell produkt, har de i princip ingen återvändo; deras version av modellen är, vid den punkten, en ‘hard fork’, och kommer inte att kunna dra nytta av uppströmsfördelar från senare utgåvor från stability.ai – vilket är ganska ett åtagande.
Den nuvarande, och större, hoppet för anpassning av Stable Diffusion är Textual Inversion, där användaren tränar in ett litet antal CLIP-justerade bilder.

Ett samarbete mellan Tel Aviv University och NVIDIA, textual inversion tillåter tränandet av diskreta och nya entiteter, utan att förstöra förmågan hos källmodellen. Källa: https://textual-inversion.github.io/
Den primära uppenbara begränsningen av textual inversion är att ett mycket lågt antal bilder rekommenderas – så få som fem. Detta producerar i princip en begränsad entitet som kan vara mer användbar för stilöverföringsuppgifter snarare än införandet av fotorealistiska föremål.
Trots detta pågår experiment inom de olika Stable Diffusion Discords som använder ett mycket större antal träningsbilder, och det återstår att se hur produktiv metoden kan visa sig vara. Återigen kräver tekniken en stor mängd VRAM, tid och tålamod.
På grund av dessa begränsande faktorer, kan vi behöva vänta en stund för att se några av de mer avancerade textual inversion-experimenten från Stable Diffusion-entusiaster – och om detta tillvägagångssätt kan ‘sätta dig i bilden’ på ett sätt som ser bättre ut än en Photoshop-klipp och klistra, samtidigt som den behåller den förbluffande funktionaliteten hos de officiella checkpointerna.
Publicerad första gången den 6 september 2022.


